
把核保系统重写成了 5 个会互相质疑的 agent
 五个 AI Agent 围坐辩论的核保议会
最近把核保系统从 V2 重写成了 V3。这篇讲讲为什么要重写,还有 V3 具体是怎么搭起来的。
先说 V2 哪里不行
V2 画在白板上很干净,整个就是一条线性流水线,长这样:
原始文档 → Gemini 提取 → DealSchema → 11 个 SME 并行评估
→ 确定性聚合 → 单次报告 → 提问
每个阶段只跑一遍,跑完就往下走。没有迭代,没有反馈循环,也没有自我评估。提取这一步要么对了要么错了,反正你也不知道,只能跑一遍然后祈祷。
11 个领域专家(GPU 工程师、财务分析师、法律分析师,再加八个)各评各的,互相看不见对方的结论。要是意见不一致,系统就把所有意见原样拼在一起。给问题去重就更糙了,只比较前 100 个字符。
用了一阵子,问题一个接一个冒出来。SME 会标一句「CapEx 假设过于激进」,但不会链接到具体哪份文档、哪一页、哪个数字,证据根本没法追。法律说 PASS,风控说 FAIL,系统就把两个意见并排摆着,冲突没人解决。提取阶段出来的垃圾会一路悄悄传到下游,中间一个检查点都没有,garbage in, garbage out。LLM 说什么就是什么,也没人去核查。
V3 换成了一组自治 agent
V3 把这条线性流水线整个换掉了,换成一组能自己迭代的 agent。整体流程还是从提取走到提问,但每一环都换成了会自己检查自己的 agent:
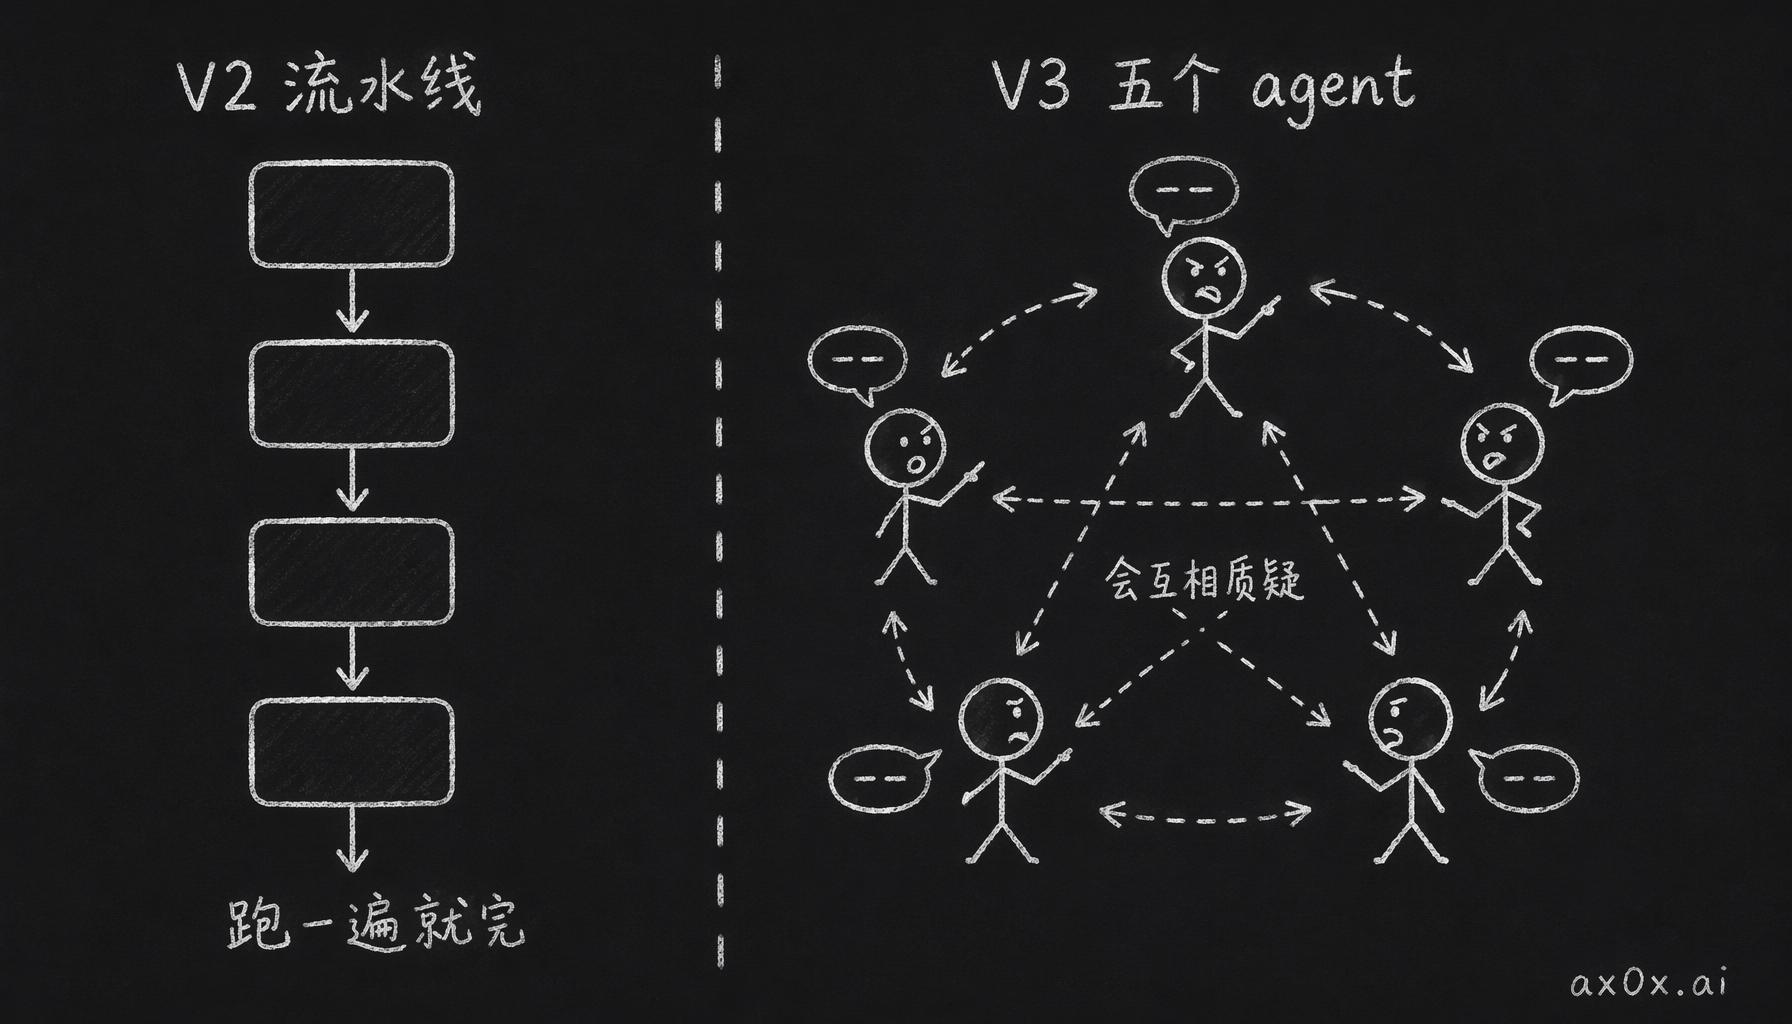 V2 是一条只往下走的线性流水线,V3 换成五个会互相质疑的自治 agent
ExtractionAgent (5 阶段,带反思)
    ↓ DealSchema
11× SMEAgent (4 阶段,工具辅助)
    ↓ 11× SMEEvaluation
ICPanelAgent (5 步:聚合 → 综合 → 辩论 → 质疑 → 问题合成)
    ↓ 增强版 UnderwritingPacket
ReportAgent (3 阶段:草稿 → 自审 → 修改)
QuestionAgent (3 阶段:缺口分析 → 网络过滤 → 优先排序)
每个 agent 都是一个自治的状态机。它不会调一次 LLM、拿到结果就收工,会在自己的几个阶段之间来回迭代。它会反思自己的输出质量,用工具去验证自己的论断,质量过了门槛才交出最终结果,没过就重来。
一个 runtime 循环跑所有 agent
所有 agent 都跑在同一个 AgentRuntime 里。它是个通用的执行引擎,不管业务,核心就一个循环,长这样:
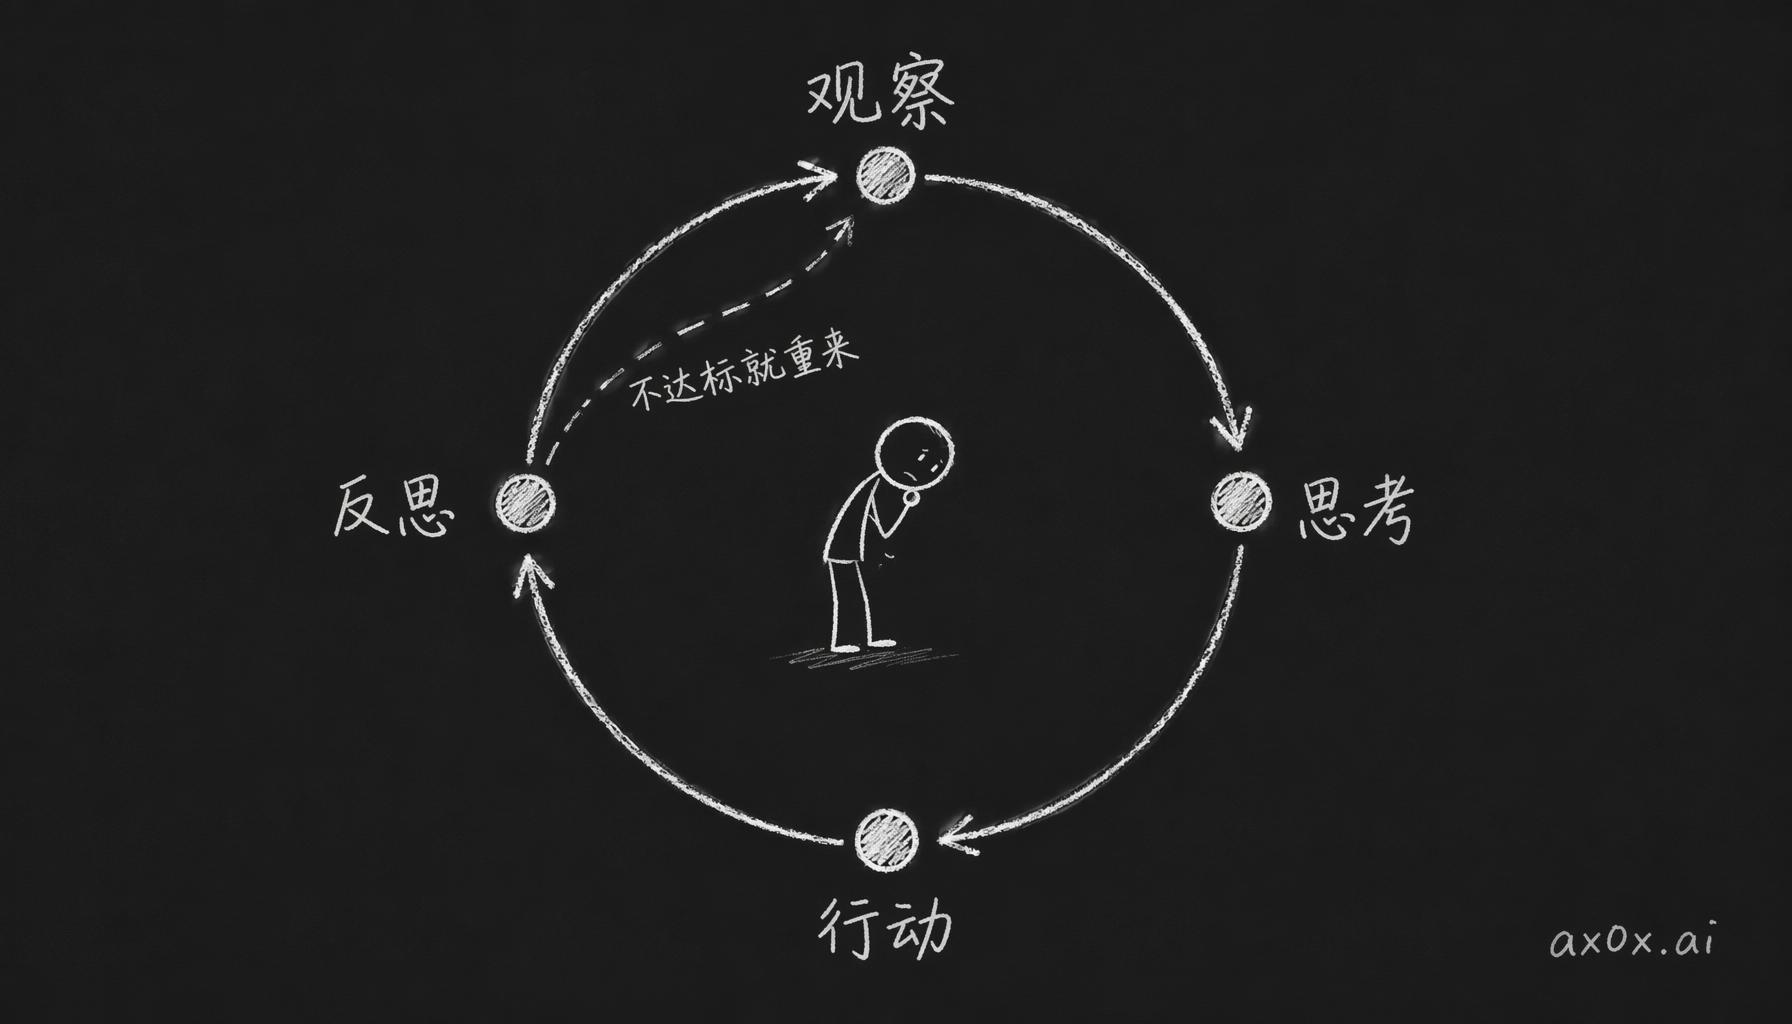 每个 agent 跑一个观察-思考-行动-反思的循环,质量不达标就再跑一圈
for iteration in range(max_iterations):
    action = agent.plan(context)          # 思考:下一步做什么?

    match action.type:
        case DONE:     break
        case TOOL_CALL: 执行工具 → on_tool_result()
        case LLM_CALL:  调用 LLM → on_llm_response()
        case REFLECT:   自我评估 → on_reflection()
        case MESSAGE:   agent 间消息 → on_message_sent()
设计上大概做了三个决定。一是 runtime 和 agent 解耦,任何 BaseAgent 子类都能插进来跑,runtime 不管跑的是提取还是报告。二是 context 不可变,每次调 with_tool_result()、with_llm_response()、with_memory() 都返回一个新实例,这样就没有别名 bug,也不会有意外的 mutation。三是每一步都留 trace,cost、token 数、耗时、工具的输入输出,全记在 AgentTrace 里,事后可以回头审计每一步干了什么、为什么这么干。
五个 agent 各管一段
ExtractionAgent
ExtractionAgent 分五个阶段。1. 批量提取,跑传统的提取管线,拿到初始的 DealSchema。2. 反思,自己评一下全不全,看哪些字段缺了,哪些看着不对。3. 针对性补读,回去重读特定的文档,把最关键的 top-5 缺失字段补上。4. 验证,对高价值字段(运营商名、GPU 型号、总 CapEx)做交叉验证,配合网络搜索和事实核查。5. 最终反思,过了质量门控才放行。模型用的是 gemini-3.1-pro,质量阈值 80/100。
SMEAgent
SMEAgent 每个领域跑四个阶段,V2 里这一步就是调一次 LLM,吐出一段主观评价。1. 初始评估,做结构化分析,strengths 和 concerns 都要带证据链接。2. 反思,检查有证据支撑的比例(目标 80%+)和置信度(目标 0.7+)。3. 工具验证,用 query_schema、web_search、calculate 去佐证论断。4. 最终反思,过质量门控。质量公式的权重大头压在证据上,concerns_backed × 40 + strengths_backed × 30 + confidence × 20 + summary_quality × 10。在这个公式下面,你光给观点不给证据,分数就高不上去。
每个 SME 只对自己的领域下结论(PASS / PASS_WITH_CONDITIONS / NEEDS_CLARIFICATION / FAIL),不对整笔交易给推荐,把自己领域的事管好就行。11 个领域分别是 gpu_engineer、financial_analyst、legal_analyst、risk_underwriting、datacenter_engineer、product_manager、operations_analyst、commercial_analyst、market_analyst、security_compliance、energy_infrastructure。
ICPanelAgent
感觉整个系统里最好玩的就是这个 agent。V2 里这一步只是把 SME 的输出拼在一起,现在 IC Panel 是真的在做裁决,要跑一条 5 步的综合管线:
| 步骤 | 做什么 |
|---|---|
| 聚合 | 跑确定性编译器生成基线包 |
| 综合 | 从 11 个 SME 摘要写出连贯的执行摘要 |
| 辩论 | SME 意见冲突时(法律说 PASS,风控说 FAIL),生成结构化辩论,双方出示证据,给出有理由的裁决 |
| 质疑 | 逐个验证 CRITICAL 级别的担忧——证据不足或有缓解方案则降级 |
| 问题合成 | 语义去重,替代前 100 字符匹配 |
辩论和质疑是按条件触发的,有冲突或者有 CRITICAL 级别的担忧才跑,没有就跳过,不做无用功。它的质量阈值是 90/100,全系统最高,道理也简单,因为 IC Panel 的输出是人真的要读的东西。
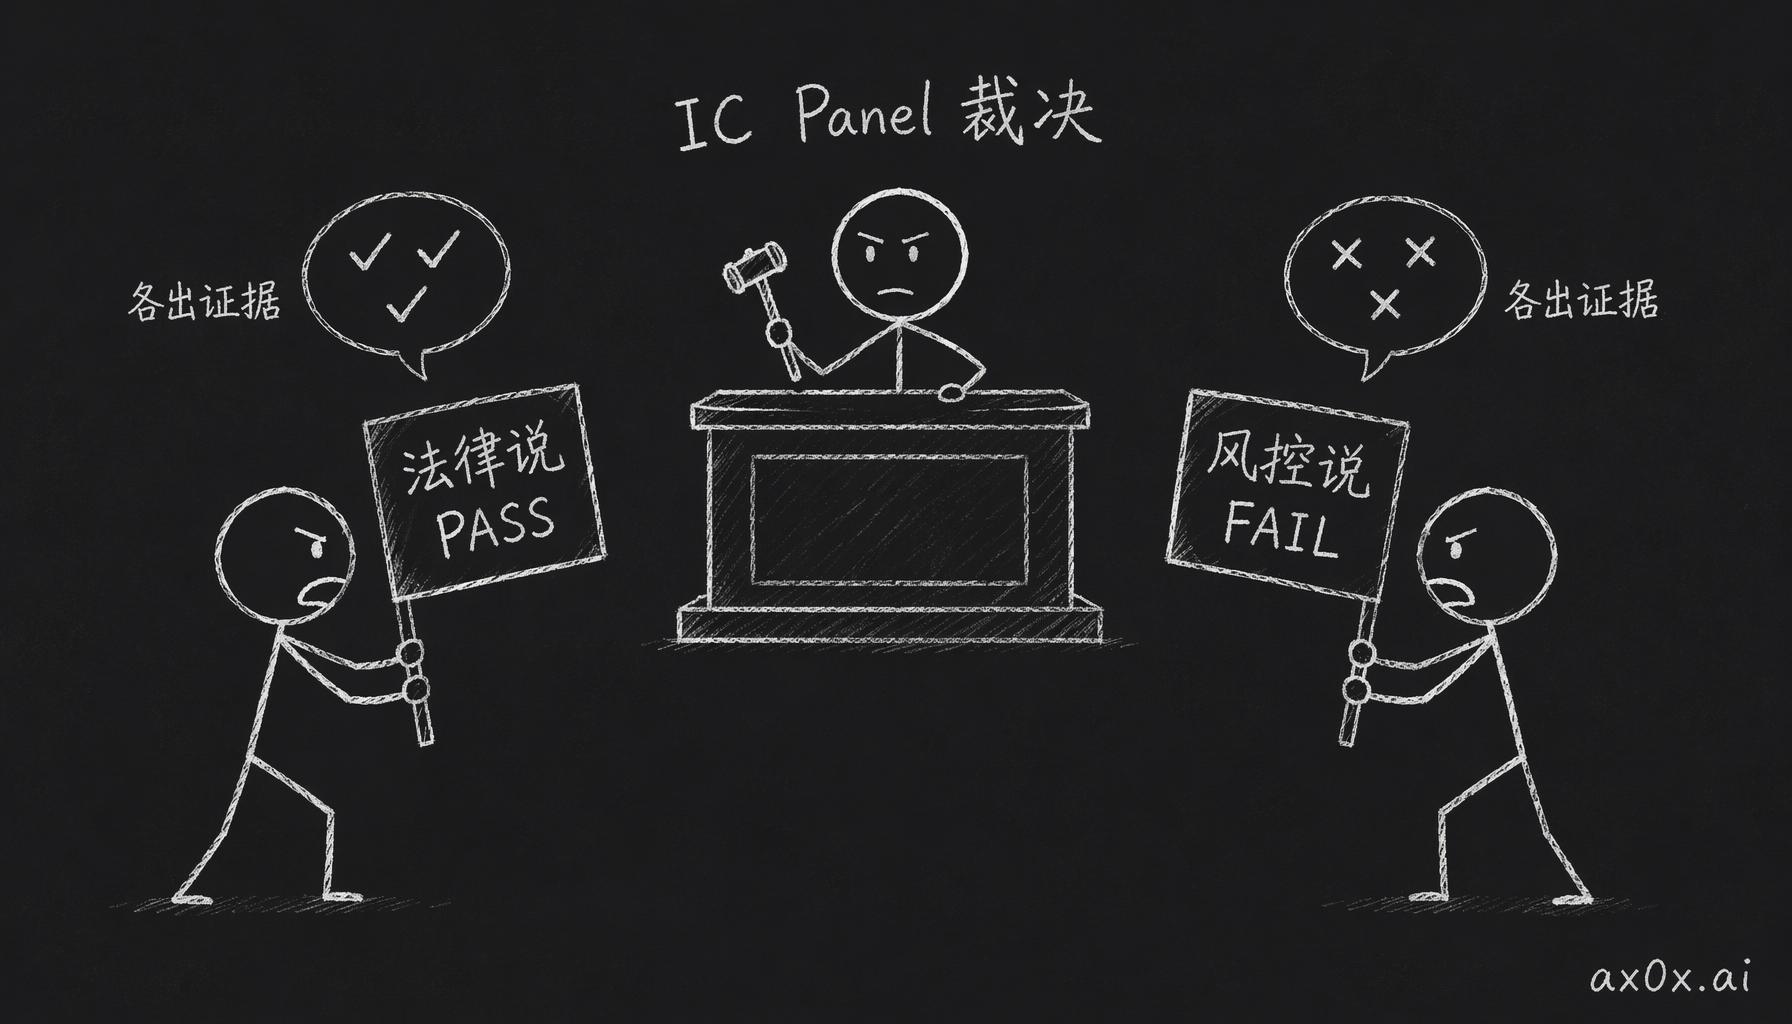 SME 意见冲突时(法律 PASS、风控 FAIL),IC Panel 出面听双方证据后裁决
ReportAgent
ReportAgent 分三个阶段。先出草稿,从 UnderwritingPacket 生成一版初始报告。然后自审,同一个模型回头挑自己草稿的毛病,担忧都回应了吗?数字有出处吗?语气适不适合这类投资者?最后是修改,把改进落实进去,补上引用,把没来源的数字修掉。报告会按投资类型来写,EQUITY 看重 IRR 和上行场景,DEBT_SENIOR 看重信用理由和条款约束。
QuestionAgent
问题生成这一步,V3 主要是加了过滤。先做缺口分析,找出缺了哪些字段、哪里有冲突,把问题起草出来。再过一遍网络过滤,看这个问题网上是不是公开就能查到,能查到的直接去掉,别浪费运营商的时间。最后按对交易的影响排优先级,CRITICAL 排最前。以前是所有问题一股脑生成出来就直接发了。
每个论断都要挂出处
V3 里每个结论都能追到源头,靠的是三样东西,哪份上传的文件(源文档),在文档里的哪个位置,还有支持这个论断的原文片段。担忧的严重程度也改成了 4 级(CRITICAL / HIGH / MEDIUM / LOW),V2 只有赞/弹两档。每个担忧还配了一条缓解建议。
agent 之间不能随便说话
agent 之间靠一个结构化的消息总线通信,消息只有五种,REQUEST、RESPONSE、CHALLENGE、ESCALATION、INFO。这里有个坑,不加限制的话,agent 之间会聊出无限循环,所以按阶段来管:
| 阶段 | 规则 |
|---|---|
| 1 | 禁止消息——SME 独立评估 |
| 2 | 仅 SME 对 SME,每对最多 2 轮 |
| 3 | 禁止消息——IC Panel 读取所有评估 |
| 4 | 仅 IC Panel → SME,每个 SME 最多 1 轮 |
| 5 | 禁止消息——最终聚合 |
一单跑下来多少钱
拿 Arkane Cloud 这个测试案例完整跑了一遍。每个 agent 烧了多少 token、花了多少钱、跑了多久,trace 里全都记着,事后可以一步一步审计。具体数字就不贴了,说个量级,整条流水线只带一个 SME 跑完大概十分钟,跑满 11 个 SME 的话,一单的成本比人工分析师便宜几个数量级。
测试一共写了 63 个,58 个集成测试(mock LLM,0.1 秒跑完),加 5 个端到端测试(真的调 API)。整套测试是在一个 claude code session 里写完的,那是另一个故事了。
回头看这次重写
回头看,V2 和 V3 用的模型其实没差多少,差别主要在流程上。V2 每一步跑完就算数,中间没人检查,提取出来的垃圾就一路漏到报告里。V3 每一环都有 agent 反思自己的输出,agent 之间也可以互相质疑,SME 吵架有 IC Panel 出来裁。反正跑下来的感觉是,这层自我检查比换模型管用,很多质量问题在流程中间就被拦下来了,到不了最终报告。
