豆包 STT 接入手册
 语音转文字处理管线示意图
这个系列是什么:完整的技术 runbook——不讲故事,只讲怎么把一个服务接好。照着步骤走,把占位符换成自己的值就能跑。
豆包 STT:火山引擎 Seed ASR 中文语音转文字接入
我要给一个项目加中文语音识别。一开始用的是 OpenAI 的 Whisper,文档和社区都很成熟,接起来也快。但拿中文录音一测就发现不太行,口语说法认得很差,同音字老是认错,有的句子直接吞掉半截。场合正式一点,Whisper 还能凑合;换成日常聊天、带方言口音、语气词多的录音,差距就很明显了。
后来我换成了火山引擎的 Seed ASR 大模型,也就是豆包背后那套语音识别,准确率一下子上了一个台阶。这篇把整个接入过程理了一遍,控制台怎么配,提交-轮询的异步 API 怎么调,生产环境怎么降级,成本怎么记,还有我实际调试时踩到的 8 个坑。
目录
1. 为什么不用 Whisper
| 维度 | 豆包(Seed ASR) | OpenAI Whisper |
|---|---|---|
| 中文准确率 | 很强——口语、语气词、方言口音都能扛 | 正式场景还行,口语化就拉了 |
| 方言支持 | 覆盖面广 | 有限 |
| 时间戳 | 有——逐句 start/end | 有——按段 |
| 价格 | 比 Whisper 便宜约 2.5 倍(详见火山引擎控制台) | 标准 Whisper 价格 |
| 延迟 | 短音频 2–4 秒(异步轮询) | 实时流式或批量 |
| API 风格 | 异步提交-轮询(REST) | 同步或流式 |
光看价格,豆包就便宜了约 2.5 倍(具体价格看火山引擎控制台)。但真正拉开差距的还是准确率。拿一段日常中文对话去测,豆包转出来的直接能用,Whisper 转出来的只能算凑合,在中文口语上两家差得挺远。
当然豆包也会挂,所以生产上不能只接一家。后面会讲链式降级,豆包失败就自动切到 OpenAI,再不行就切 Gemini。
2. 控制台配置
2.1 注册登录
去 console.volcengine.com,用手机号或邮箱注册、登录就行,这一步没什么特别的。
2.2 找到正确的服务
这一步最容易走错,因为控制台里长得差不多的 ASR 产品有一堆。按这个路径找:
- 在顶部导航里找 豆包语音(或者直接搜)
- 进去以后找 API服务中心
- 选 录音文件识别大模型
千万别选成下面这几个。服务一旦选错,后面所有鉴权都会报错,而且从报错信息里完全看不出是服务选错了。
- 录音文件识别 2.0,这是老版本,鉴权那一套完全不一样
- 流式语音识别,这是流式服务,用的是另一套 resource ID 和 WebSocket 协议
- 任何标着 "旧版" 的东西
2.3 开通服务
还没开通的话,点 开通服务。
2.4 购买时长包
大模型识别是按音频时长收费的。去 时长包 页面买一个够你用的包,这个 API 没有免费额度,不买就跑不起来。
2.5 拿到你的凭证
在豆包语音的产品页里找到 服务接口认证信息,你要拿两样东西:
- APP ID → 对应环境变量
DOUBAO_STT_APP_ID - Access Token → 对应环境变量
DOUBAO_STT_ACCESS_KEY
控制台上还会显示一个 "Secret Key",这个用不着,大模型 v3 API 鉴权只用 APP ID + Access Token。(详见坑 #6。)
3. 环境变量
# 必填
DOUBAO_STT_APP_ID=<控制台里的 APP ID>
DOUBAO_STT_ACCESS_KEY=<控制台里的 Access Token>

# 不需要——只有流式 WebSocket 才用
# DOUBAO_STT_CLUSTER=volcengine_streaming_common
调用之前,先查一下它能不能用:
function isDoubaoAvailable(): boolean {
  return !!(process.env.DOUBAO_STT_APP_ID && process.env.DOUBAO_STT_ACCESS_KEY)
}
这两个变量只要缺一个,就跳过这个 provider,直接走链路里的下一个。降级链路怎么搭,第 6 节再讲。
4. API 详解:提交-轮询流程
大模型文件识别走的是一个 两步异步流程,先提交音频,再轮询等结果。两步用的是同一个 request ID,下面会反复提到这一点。
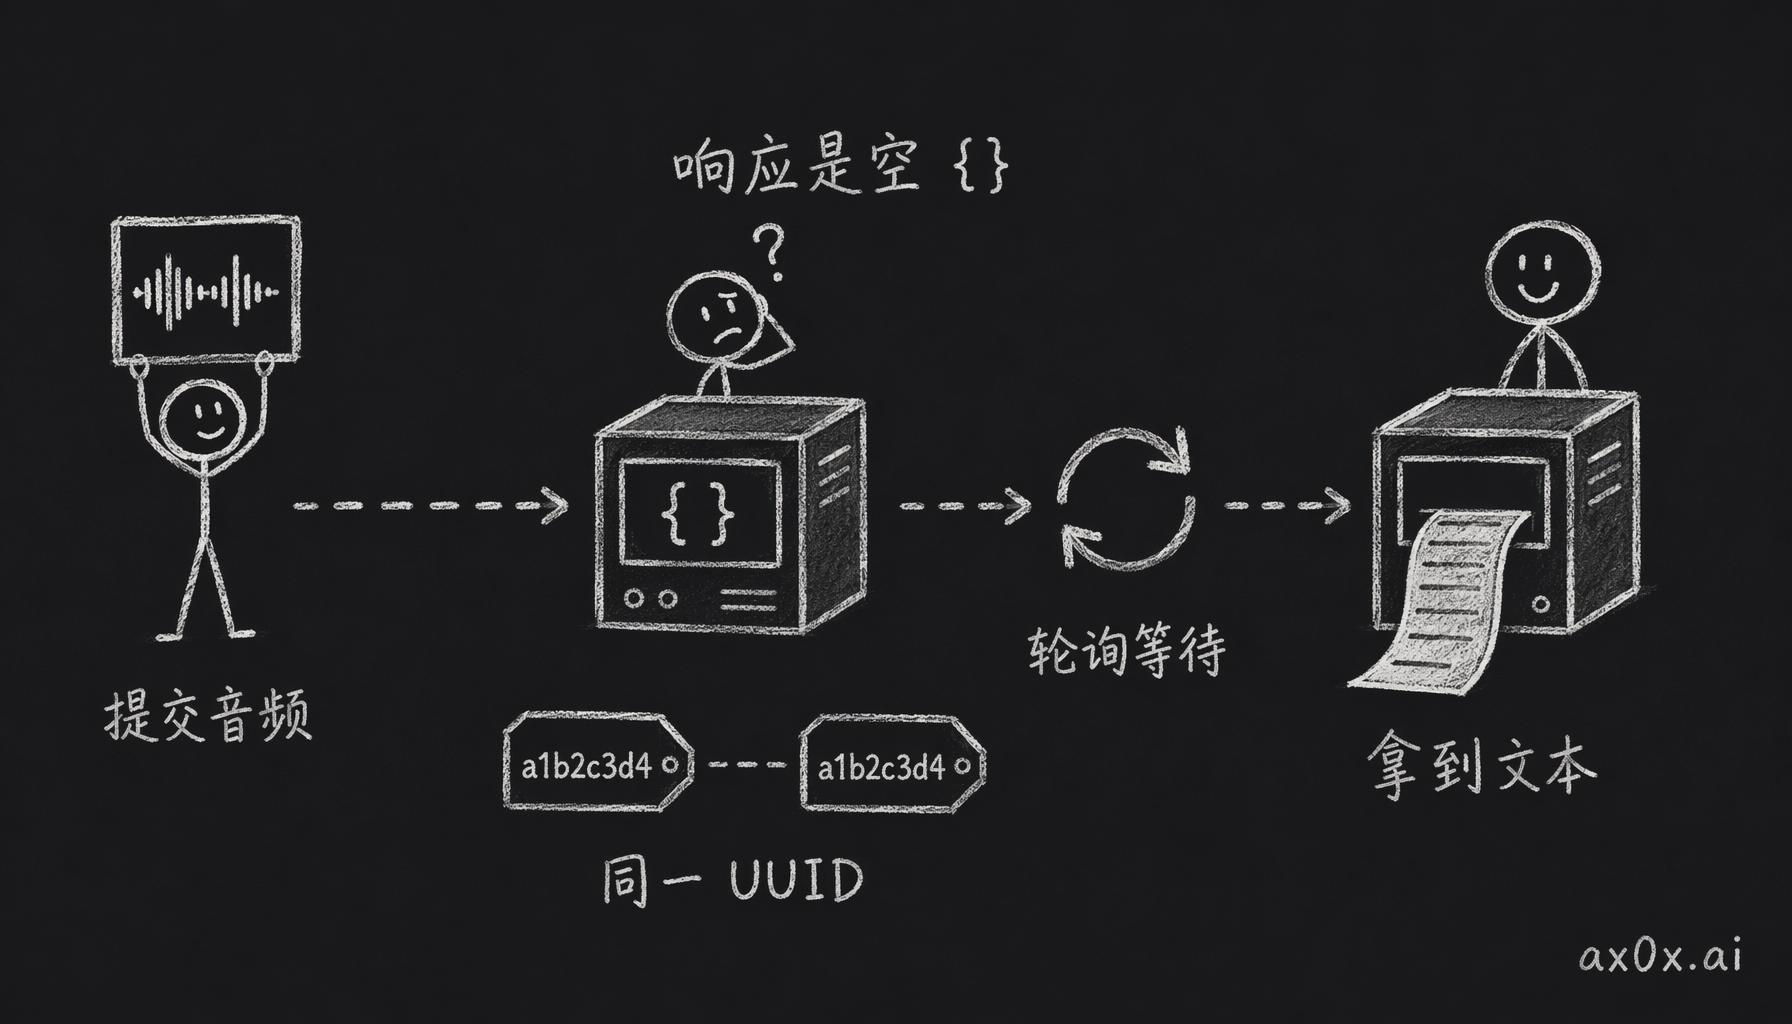 提交-轮询异步流程:提交后只返回空 {},你自己生成的 UUID 既是请求 ID 也是任务 ID,用它反复轮询直到吐出识别文本
接口地址
| 步骤 | 方法 | URL |
|---|---|---|
| 提交 | POST | https://openspeech.bytedance.com/api/v3/auc/bigmodel/submit |
| 查询 | POST | https://openspeech.bytedance.com/api/v3/auc/bigmodel/query |
鉴权 Headers
所有请求(提交和查询)都要带:
X-Api-App-Key:      <DOUBAO_STT_APP_ID>
X-Api-Access-Key:   <DOUBAO_STT_ACCESS_KEY>
X-Api-Resource-Id:  volc.seedasr.auc
X-Api-Request-Id:   <你生成的 UUID>
X-Api-Request-Id 是你自己生成的 UUID。注意它同时也是 任务 ID,提交时发的是它,后面轮询用的还是它。
提交请求体
{
  "user": { "uid": "your-app-name" },
  "audio": {
    "data": "<base64 编码的音频数据>",
    "format": "ogg"
  }
}
提交响应
提交成功会返回 HTTP 200,body 是个空的 {}。响应里没有任务 ID,因为你发出去的 X-Api-Request-Id 就是任务 ID。这个设计挺反直觉的,我一开始还以为提交失败了,来回检查了好几遍。
查询请求体
{}
查询的 body 就是个空的 {}。服务端靠 header 里的 X-Api-Request-Id 找到你的任务,所以要用提交时的那个 UUID。
查询响应
还在处理中的时候返回空的 {},处理完了才给结果:
{
  "audio_info": {
    "duration": 4300
  },
  "result": {
    "text": "你好,今天天气怎么样",
    "utterances": [
      { "text": "你好,今天天气怎么样", "start_time": 0, "end_time": 4300 }
    ]
  }
}
audio_info.duration 的单位是毫秒。utterances 里是逐句的文本加 start/end 时间戳。
5. 完整 TypeScript 实现
下面这份实现单独就能跑,不依赖任何框架,只用 node:crypto 生成 UUID,再加上全局的 fetch。复制出去改改常量就能用。
import { randomUUID } from 'node:crypto'

// ── 常量 ───────────────────────────────────────────────────
const SUBMIT_URL = 'https://openspeech.bytedance.com/api/v3/auc/bigmodel/submit'
const QUERY_URL  = 'https://openspeech.bytedance.com/api/v3/auc/bigmodel/query'
const RESOURCE_ID = 'volc.seedasr.auc'

const MAX_POLLS = 30       // 30 次 × 2s = 最多等 60s
const POLL_INTERVAL = 2000 // 每 2 秒轮询一次

// ── MIME → 豆包格式映射 ────────────────────────────────────
const MIME_TO_FORMAT: Record<string, string> = {
  'audio/ogg':   'ogg',
  'audio/mpeg':  'mp3',
  'audio/mp3':   'mp3',
  'audio/wav':   'wav',
  'audio/x-wav': 'wav',
  'audio/mp4':   'm4a',
  'audio/m4a':   'm4a',
  'audio/x-m4a': 'm4a',
}

function mimeToFormat(mimeType: string): string {
  return MIME_TO_FORMAT[mimeType] ?? 'mp3'
}

function sleep(ms: number): Promise<void> {
  return new Promise(resolve => setTimeout(resolve, ms))
}

// ── 主函数 ─────────────────────────────────────────────────
export async function transcribeWithDoubao(
  audio: Buffer,
  mimeType: string,
  userId?: string,
): Promise<string> {
  const appId     = process.env.DOUBAO_STT_APP_ID
  const accessKey = process.env.DOUBAO_STT_ACCESS_KEY

  if (!appId || !accessKey) {
    throw new Error('Doubao STT credentials not configured')
  }

  const reqId = randomUUID()
  const headers: Record<string, string> = {
    'Content-Type':      'application/json',
    'X-Api-App-Key':     appId,
    'X-Api-Access-Key':  accessKey,
    'X-Api-Resource-Id': RESOURCE_ID,
    'X-Api-Request-Id':  reqId,
  }

  // ── 第一步:提交 ──
  const submitRes = await fetch(SUBMIT_URL, {
    method: 'POST',
    headers,
    body: JSON.stringify({
      user:  { uid: userId ?? 'app' },
      audio: {
        data:   audio.toString('base64'),
        format: mimeToFormat(mimeType),
      },
    }),
  })

  if (!submitRes.ok) {
    const errText = await submitRes.text()
    throw new Error(`Doubao STT submit failed (${submitRes.status}): ${errText}`)
  }
  // submitRes body 是 {} —— 不要从里面找任务 ID

  // ── 第二步:轮询 ──
  for (let i = 0; i < MAX_POLLS; i++) {
    await sleep(POLL_INTERVAL)

    const queryRes = await fetch(QUERY_URL, {
      method: 'POST',
      headers, // 同样的 headers,同样的 reqId
      body: '{}',
    })

    const body = await queryRes.text()
    if (!body || body === '{}') continue // 还在处理中

    const result = JSON.parse(body)
    if (result.result?.text) {
      const audioDurationMs = result.audio_info?.duration ?? 0
      const audioDurationSec = audioDurationMs / 1000
      console.log(`Doubao STT: ${audioDurationSec}s audio transcribed`)
      return result.result.text
    }
  }

  throw new Error(`Doubao STT: no result after ${MAX_POLLS * POLL_INTERVAL / 1000}s`)
}
我实测短语音消息(几秒到十几秒那种),一般第一次或者第二次轮询就能拿到结果,前后一共 2–4 秒。
6. 链式降级模式
生产环境别只接一个 STT 服务,网络抖动、API 故障、限流,这些早晚都会碰上。链式降级就是出了问题让它自己切到备用方案。
思路
每种语言注册一条 provider 优先级链,然后按顺序挨个试。凭证没配的直接跳过,报错的记条日志,接着试下一个,直到有一个返回结果。
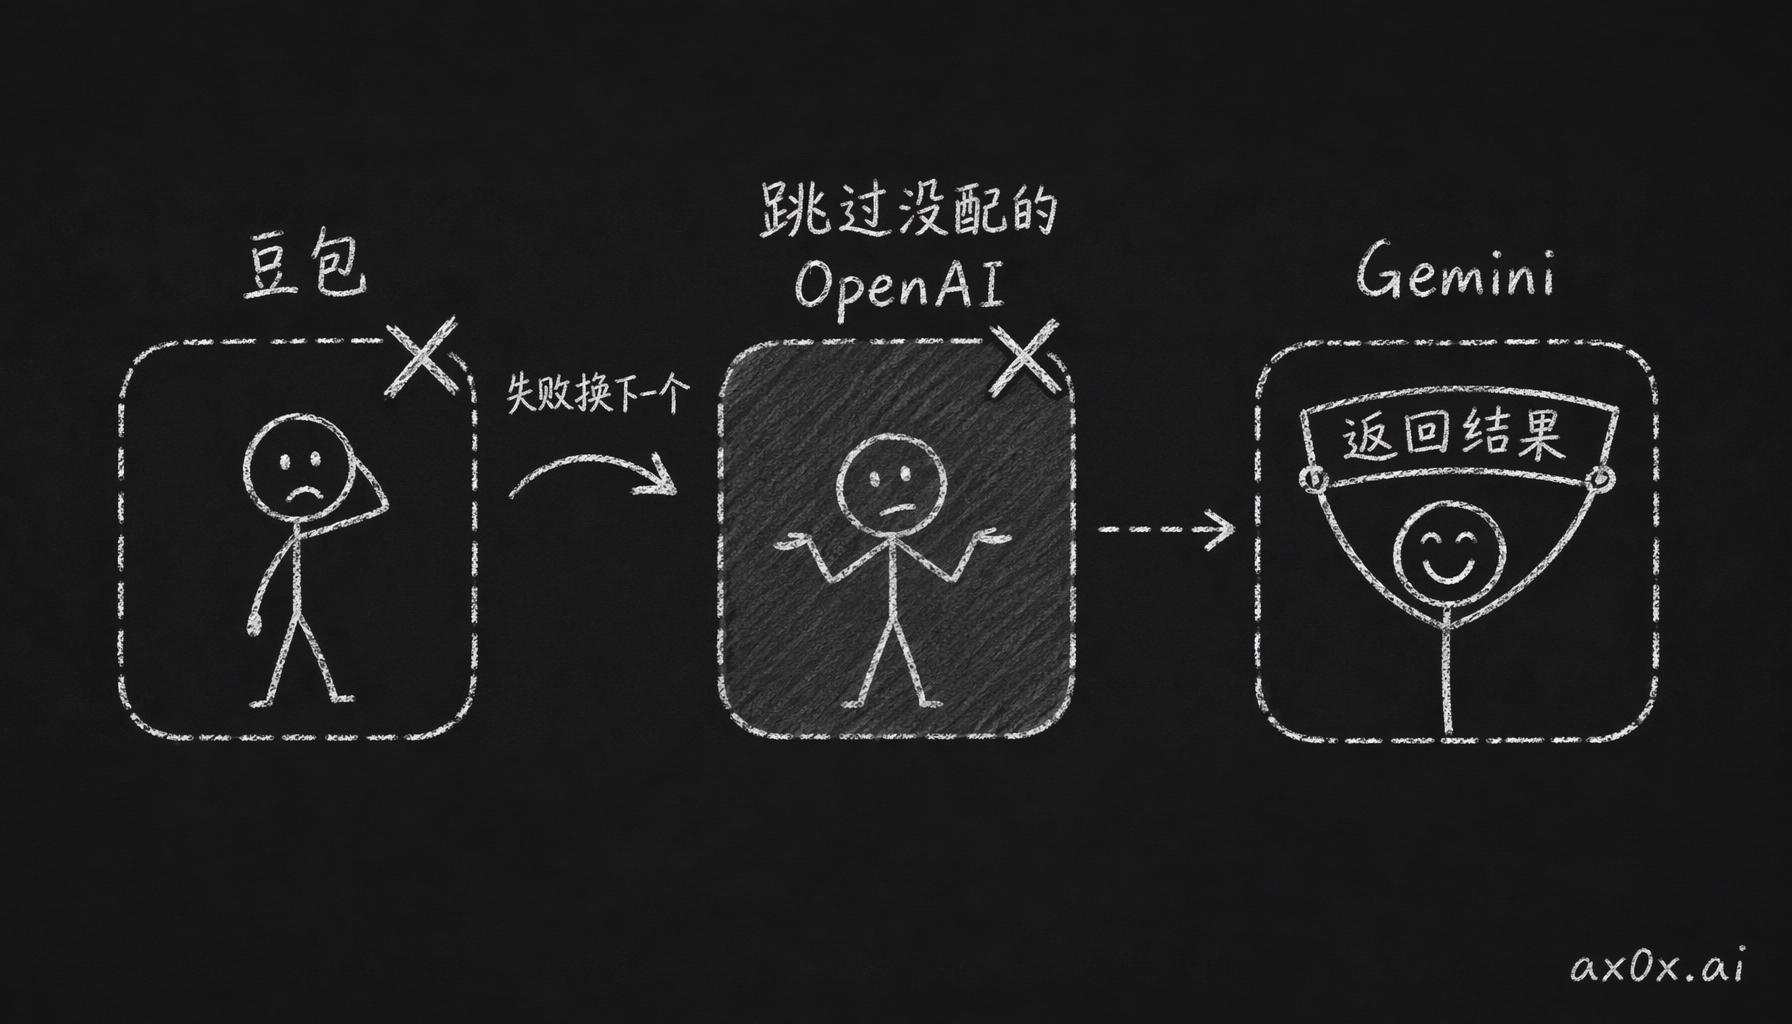 链式降级:按优先级串联多个语音识别供应商,凭证没配的直接跳过、报错的换下一个,直到有一个成功返回
// ── Provider 接口 ──────────────────────────────────────────
interface STTProvider {
  name: string
  isAvailable(): boolean
  transcribe(audio: Buffer, mimeType: string, userId?: string): Promise<string>
}

// ── 链注册 ─────────────────────────────────────────────────
const chains = new Map<string, STTProvider[]>()
let defaultChain: STTProvider[] = []

function registerSTTChain(language: string, providers: STTProvider[]): void {
  chains.set(language, providers)
}

function setDefaultSTTChain(providers: STTProvider[]): void {
  defaultChain = providers
}

// ── 链执行 ─────────────────────────────────────────────────
async function transcribeWithChain(
  language: string,
  audio: Buffer,
  mimeType: string,
  userId?: string,
): Promise<string> {
  const chain = chains.get(language) ?? defaultChain

  for (const provider of chain) {
    if (!provider.isAvailable()) continue
    try {
      const text = await provider.transcribe(audio, mimeType, userId)
      if (text) return text
    } catch (err) {
      console.warn(`STT provider ${provider.name} failed, trying next:`, err)
    }
  }

  return '[语音消息无法识别]'
}
注册示例
// 中文:豆包优先 → OpenAI 备用 → Gemini 兜底
registerSTTChain('zh', [doubaoProvider, openaiProvider, geminiProvider])

// 英文:OpenAI
registerSTTChain('en', [openaiProvider])

// 默认(未知语言):OpenAI → 豆包 → Gemini
setDefaultSTTChain([openaiProvider, doubaoProvider, geminiProvider])
这个模式不光 STT 能用,只要一个服务有好几家供应商,都可以这么搞。关键在于 isAvailable() 是看环境变量来判断的,所以不同环境配不同的凭证,链路自己就跟着变了,代码不用改。
7. 支持的音频格式
提交之前,要先把 MIME 类型换成豆包认的格式字符串:
| MIME 类型 | 豆包格式 | 常见来源 |
|---|---|---|
audio/ogg | ogg | Telegram 语音、WebM 音频 |
audio/mpeg、audio/mp3 | mp3 | 标准音频文件 |
audio/wav、audio/x-wav | wav | 原始录音、浏览器 MediaRecorder |
audio/mp4、audio/m4a、audio/x-m4a | m4a | WhatsApp 音频、iOS 录音 |
| 其他 | mp3(默认兜底) | — |
Telegram 的语音是 audio/ogg,直接能用。WhatsApp 一般是 audio/ogg 或者 audio/mp4,也没问题。
8. 成本追踪
定价
模型 ID:  doubao-seedasr
价格:     具体看火山引擎控制台——比 Whisper 便宜约 2.5 倍
具体价格去控制台查最新的。写这篇的时候,豆包比 Whisper 便宜约 2.5 倍。
Token 估算
API 会返回音频时长(毫秒),把它换成 token 数,计费就能统一算:
// 从音频时长估算 token 数(用于成本追踪)
const estimatedTokens = Math.ceil(audioDurationSec * 200)
  || Math.ceil((audio.length / 32000) * 200) // 兜底:按 buffer 大小估算
- 主路径:
audioDurationSec * 200,用的是 API 返回的实际时长 - 兜底:
(audio.length / 32000) * 200,API 没给时长的时候,按 ~32kbps 码率估
记录成本
// 异步记录,不阻塞转写流程
recordCost({
  userId,
  operationType: 'transcription',
  modelId: 'doubao-seedasr',
  inputTokens: estimatedTokens,
}).catch(err => console.warn('Cost tracking failed:', err))
成本是用 fire-and-forget 的方式异步记的,记失败了就打一条 warn,不影响正常转写。
9. 踩坑记录——先读完再写代码
下面 8 条全是我实际调试时踩出来的。先从头读一遍再动手,大概能省你一天。
1. v2 和 v3 压根不是一个东西
火山引擎有一套老的 ASR API(v2),走 WebSocket,用 cluster 标识符,鉴权靠 Bearer token 加 Secret Key 签名,和 v3 完全是两套东西:
- 鉴权 headers 不一样
- 接口地址不一样
- cluster ID 也不一样(
volcengine_streaming_common、volcengine_input_common等等)
网上能搜到的教程和论坛帖子很多都是 v2 的。看到 cluster 或者 Bearer token 就直接关掉,别跟着走。
2. v3 WebSocket 接口全部返回 400
v3 也有 WebSocket 的版本。凭证和 header 的组合我全试遍了,全都返回 400,能用的只有 REST 文件识别接口。除非火山引擎出了新文档,不然别在 WebSocket 上浪费时间。
3. Resource ID 必须是 volc.seedasr.auc
文档和论坛里常见这几个错的值:
volc.bigasr.auc,错的,会返回鉴权失败volcengine_streaming_common,这是流式的 cluster ID,不是 resource IDvolc.bigasr.sauc,这是流式的版本,接口都对不上
正确的值就是 volc.seedasr.auc,一个字都不能错。
4. 提交成功返回的就是空 {},不是报错
大多数异步 API 提交以后,会在响应体里给你一个任务 ID。这个 API 不给,响应就是空的 {}。任务 ID 就是你请求时自己发的 X-Api-Request-Id,后面轮询也用这同一个 UUID。我一开始以为提交失败了,来回调了好久。
5. 查询也返回 {} 直到处理完成
查询响应只有两种情况:
{},还在排队或者还在处理(接着轮询)- 完整结果,说明处理完了
中间没有别的状态,也没有 "processing"、"in-progress" 这种状态字段,从 {} 一下子就切到完整结果。
6. 你不需要 Secret Key
控制台会显示三个凭证,APP ID、Access Token 和 Secret Key。大模型 v3 REST API 只用 APP ID + Access Token。Secret Key 是火山引擎别的服务做签名用的,这个 API 用不上。
7. 新版旧版控制台,鉴权完全不通用
火山引擎正在把服务往新版控制台搬。新版用 X-Api-* headers,就是这篇讲的这套;旧版用 Authorization: Bearer <token>,凭证也是另一套。论坛帖子或者老文档里只要出现 Authorization: Bearer,就是旧版的写法,大模型接口上用不了。
8. 流式服务和文件识别是两个独立产品
流式 ASR 和文件识别是两个独立的产品,开通和计费都是各管各的。就算你的账号已经开了流式,文件识别也还是用不了,得单独开通 录音文件识别大模型,再单独买时长包。
速查
Headers 模板
X-Api-App-Key:      YOUR_APP_ID
X-Api-Access-Key:   YOUR_ACCESS_TOKEN
X-Api-Resource-Id:  volc.seedasr.auc
X-Api-Request-Id:   <生成的 UUID>
Content-Type:       application/json
接口地址
提交: POST https://openspeech.bytedance.com/api/v3/auc/bigmodel/submit
查询: POST https://openspeech.bytedance.com/api/v3/auc/bigmodel/query
凭证一览
| 凭证 | 在哪找 | 环境变量 |
|---|---|---|
| APP ID | 豆包语音 → API服务中心 → 服务接口认证信息 | DOUBAO_STT_APP_ID |
| Access Token | 同上 | DOUBAO_STT_ACCESS_KEY |
| Secret Key | 同上——不需要 | — |
决策树
需要中文 STT?
├── 是 → 豆包(Seed ASR 大模型)
│   ├── 可用? → 用它
│   └── 不可用/失败? → 降级到 OpenAI → Gemini
└── 否 → OpenAI Whisper(多语言覆盖更好)
This post is also available in English.