我把豆包 TTS 的情感控制测了一遍
 AI 语音情感表达的声波可视化
这段时间在给 AI 伴侣调语音,需求很具体,角色得能哭。不是把语速放慢、多加几个停顿那种,是真的听着在哭,声音里能听出心碎的那种。
之前给 AI 伴侣配嗓子的时候试过 Fish Audio 和火山引擎,当时的结论大概是 Fish 简单,火山的情感表现更好。但说实话那个判断下得很草率。我只是听到了一点情感的苗头,知道有这个能力,就没往下挖。它的边界在哪,文档说的和实际表现差多少,我都没系统测过。
所以这次认真做了一回实验,分三轮,一共 30 个音频样本。预置音色、克隆音色、三种情感控制方法都测了,最后还有个发现,直接改了我写情感提示词的方式。下面所有样本都能直接播放,建议边听边读。
实验一:先把预置音色测一遍
第一个问题很基础,角色该用什么声音。豆包 2.0 系列有几十个预置音色,文档说它们支持 context_texts。这是一个自然语言字段,你用文字写出想要的情感就行。但文档说支持,音色不见得就有反应。有的音色对情感提示反应很强,有的基本没反应,这个不试是不知道的。
具体是这么做的,挑四个音色,每个跑温柔和伤心两种情感。文字一样,情感提示也一样,只换声音,对比着听。
Vivi(zh_female_vv_uranus_bigtts)
Vivi 是基准线。女声,出了名的表现力强。
两个版本差别很明显。Vivi 确实能接住情感提示,起点不错。
刘飞(zh_male_liufei_uranus_bigtts)
这是男声候选,声线温暖、成熟。伤心版能明显听出声音往下沉,有分量,它对情感提示是有反应的。
云舟 / M191(zh_male_m191_uranus_bigtts)
这是角色现在在用的声音。这一轮我主要就是想看看它跟另外几个比起来怎么样。
它的表现力很强。温柔版轻轻的、很小心,伤心版真能听出受了伤。这轮听完我就决定继续用它了。
桃城小天(taocheng-xiaotian)
它的声线更年轻、更轻。情感变化是有的,但幅度没那么大,日常闲聊够用,撑不起心碎的场景。
四个音色听下来,差距比我想的大。Vivi 和云舟反应强,刘飞不错但更含蓄,小天有反应但不够深。所以如果你做的产品需要情感表现力,第一步得把候选音色都拿情感提示测一遍,别从目录里随便挑一个就开始用,因为音色之间差得真的很大。
实验二:克隆音色能不能吃情感提示
这部分是我最想搞清楚的。豆包支持声音克隆,你上传 10-30 秒录音,它会生成一个专属的 speaker id,出来的声音就是那个人。但官方文档写的是,context_texts 适用于「豆包语音合成模型 2.0 音色」。这句话得抠一下字眼,它没说克隆音色也行。
偏偏我的角色用的就是克隆音色,又必须有情感,那只能自己试。同一段文字,试四种条件。
1. 基线(无情感控制)
纯文字,不加 context_texts,也不切特殊模型。克隆音色本来是什么样就是什么样。
2. 仅 context_texts
加上 context_texts 情感提示。模型还是标准的 seed-icl-2.0。
3. context_texts + expressive 模型
同样的 context_texts。模型切到 seed-tts-2.0-expressive。
4. seed-tts-1.1 资源
试一下旧版 seed-tts-1.1 的 resource id,看它处理克隆音色的情感时,跟 2.0 有没有不同。
结果是,从基线到加上 context_texts,差别听得出来,克隆音色确实能响应情感提示。再切到 expressive 模型,音高和节奏的变化更明显,又往前推了一步。1.1 资源听着不太一样,但不见得更好。
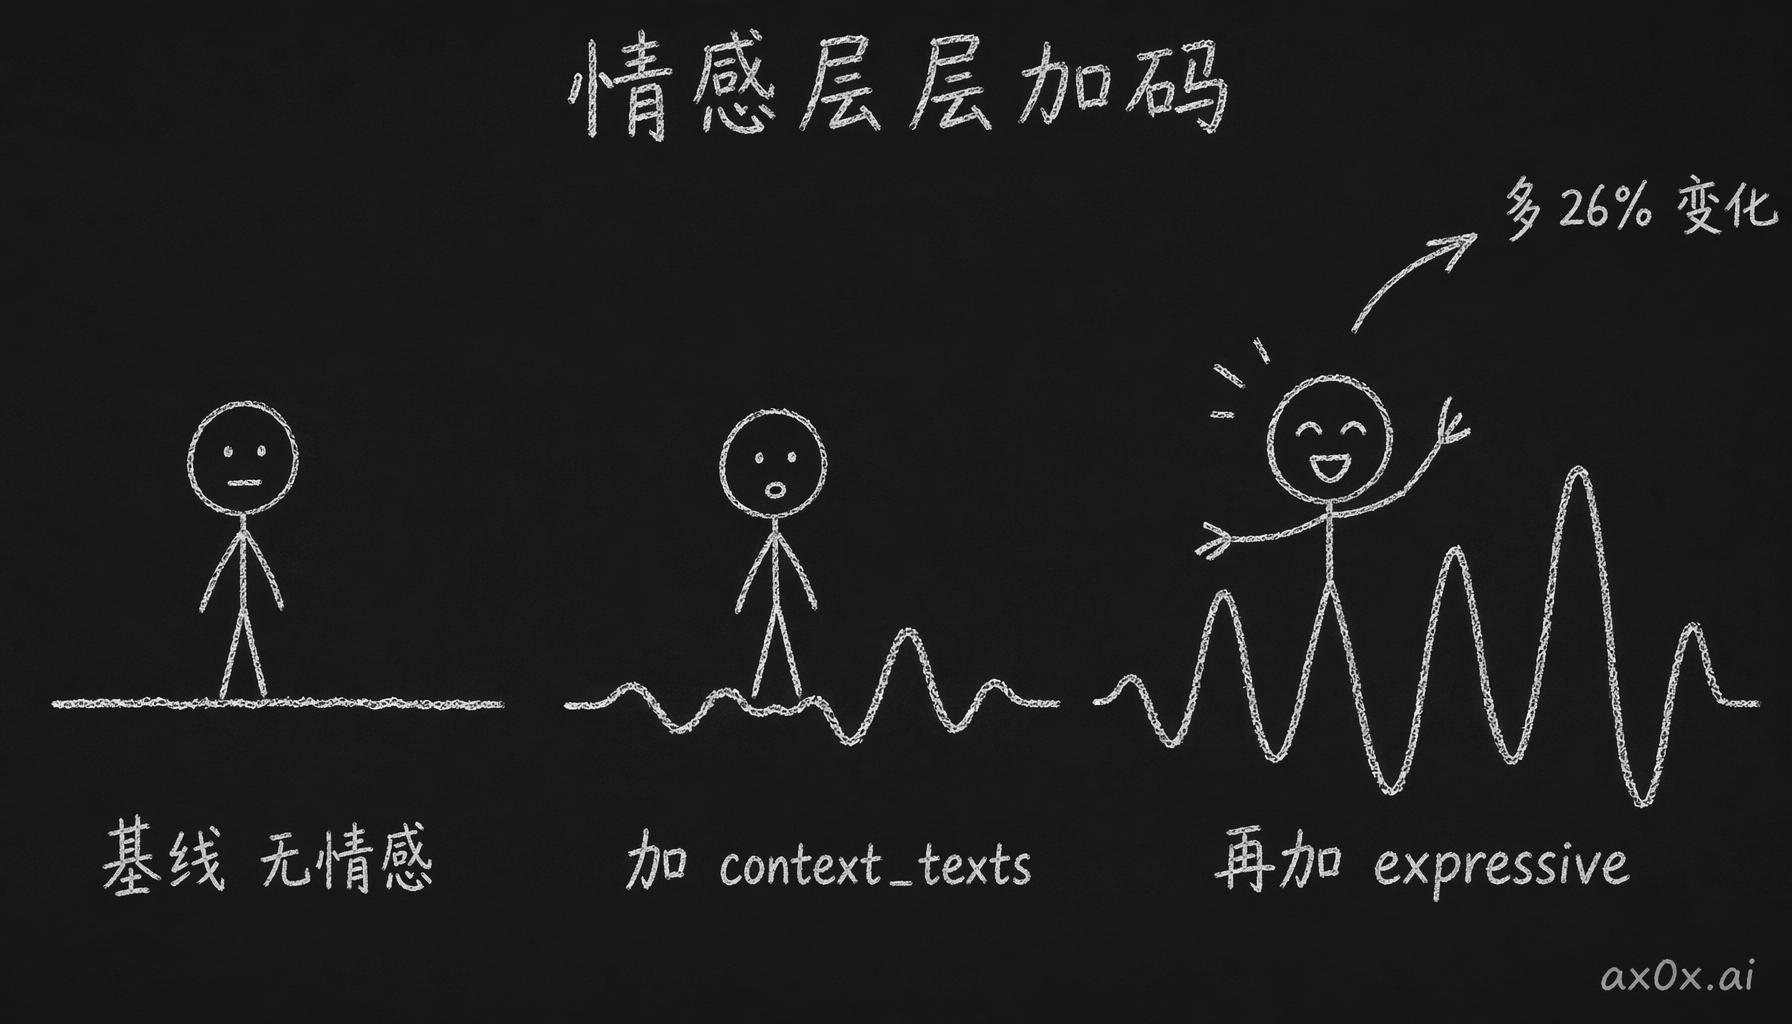 从基线到加 context_texts 再到加 expressive 模型,三层依次叠加,情感表达一层比一层强。
这一轮就收获了一条,context_texts 对克隆音色一样有效。文档没写,也没人告诉我,是我自己试出来的。反正如果你在用豆包的声音克隆做一个要有情感的角色,这个字段可以直接用,克隆音色不是只能出一把平平的声音。
实验三:拉一个 2×3×3 的全量矩阵
实验二证明了它有效,接下来我想知道到底有多有效。这次不猜了,直接拉矩阵:
- 2 个音色:苏柔(女声)和一楠(男声)
- 3 种情感:ASMR(耳语/亲密)、温柔、伤心
- 3 个条件:基线(无情感)、仅 context_texts、context_texts + expressive 模型
2 x 3 x 3,一共 18 个样本。全放在下面。
苏柔(女声)
ASMR
| 条件 | 音频 |
|---|---|
| 基线 | |
context_texts | |
context_texts + expressive |
温柔
| 条件 | 音频 |
|---|---|
| 基线 | |
context_texts | |
context_texts + expressive |
伤心
| 条件 | 音频 |
|---|---|
| 基线 | |
context_texts | |
context_texts + expressive |
一楠(男声)
ASMR
| 条件 | 音频 |
|---|---|
| 基线 | |
context_texts | |
context_texts + expressive |
温柔
| 条件 | 音频 |
|---|---|
| 基线 | |
context_texts | |
context_texts + expressive |
伤心
| 条件 | 音频 |
|---|---|
| 基线 | |
context_texts | |
context_texts + expressive |
18 个样本听完,我有三个结论。第一,光加 context_texts 就有明显效果。两个音色、三种情感,每一组从基线加上 context_texts,都听得出差别。模型确实在响应这个字段,效果是实打实的。
第二,expressive 模型在这个基础上又加了一层。三个条件里,context + expressive 一直是最有感情的。它比只加 context_texts 能强多少要看场景,有时候差一点,有时候差很多,但每次都是往上提的。我拿音频变化量粗算了一下,expressive 大概还能再多 26% 左右,跟听感对得上。
第三,不同音色配不同情感,效果高低不齐。苏柔的伤心特别强,一楠的 ASMR 很有说服力;但苏柔的 ASMR 跟她的温柔差不太多,一楠的伤心也没有苏柔那么到位。每个音色都有自己擅长的,最好拿你自己的场景去测。
提示词怎么写,差别比选音色还大
整轮实验里,最让我改变做法的发现出在提示词的写法上。刚开始我的 context_texts 就写两个字,「伤心」。出来的声音只能算有一点伤心,跟基线差别很小,我一度觉得情感控制这个能力可能就是宣传。
后来我把提示词重写成「用哭泣的声音,边哭边说,很伤心,声音颤抖带着哽咽」,差距一下子就拉开了。上面那些伤心样本,全是用这种带画面的写法生成的。
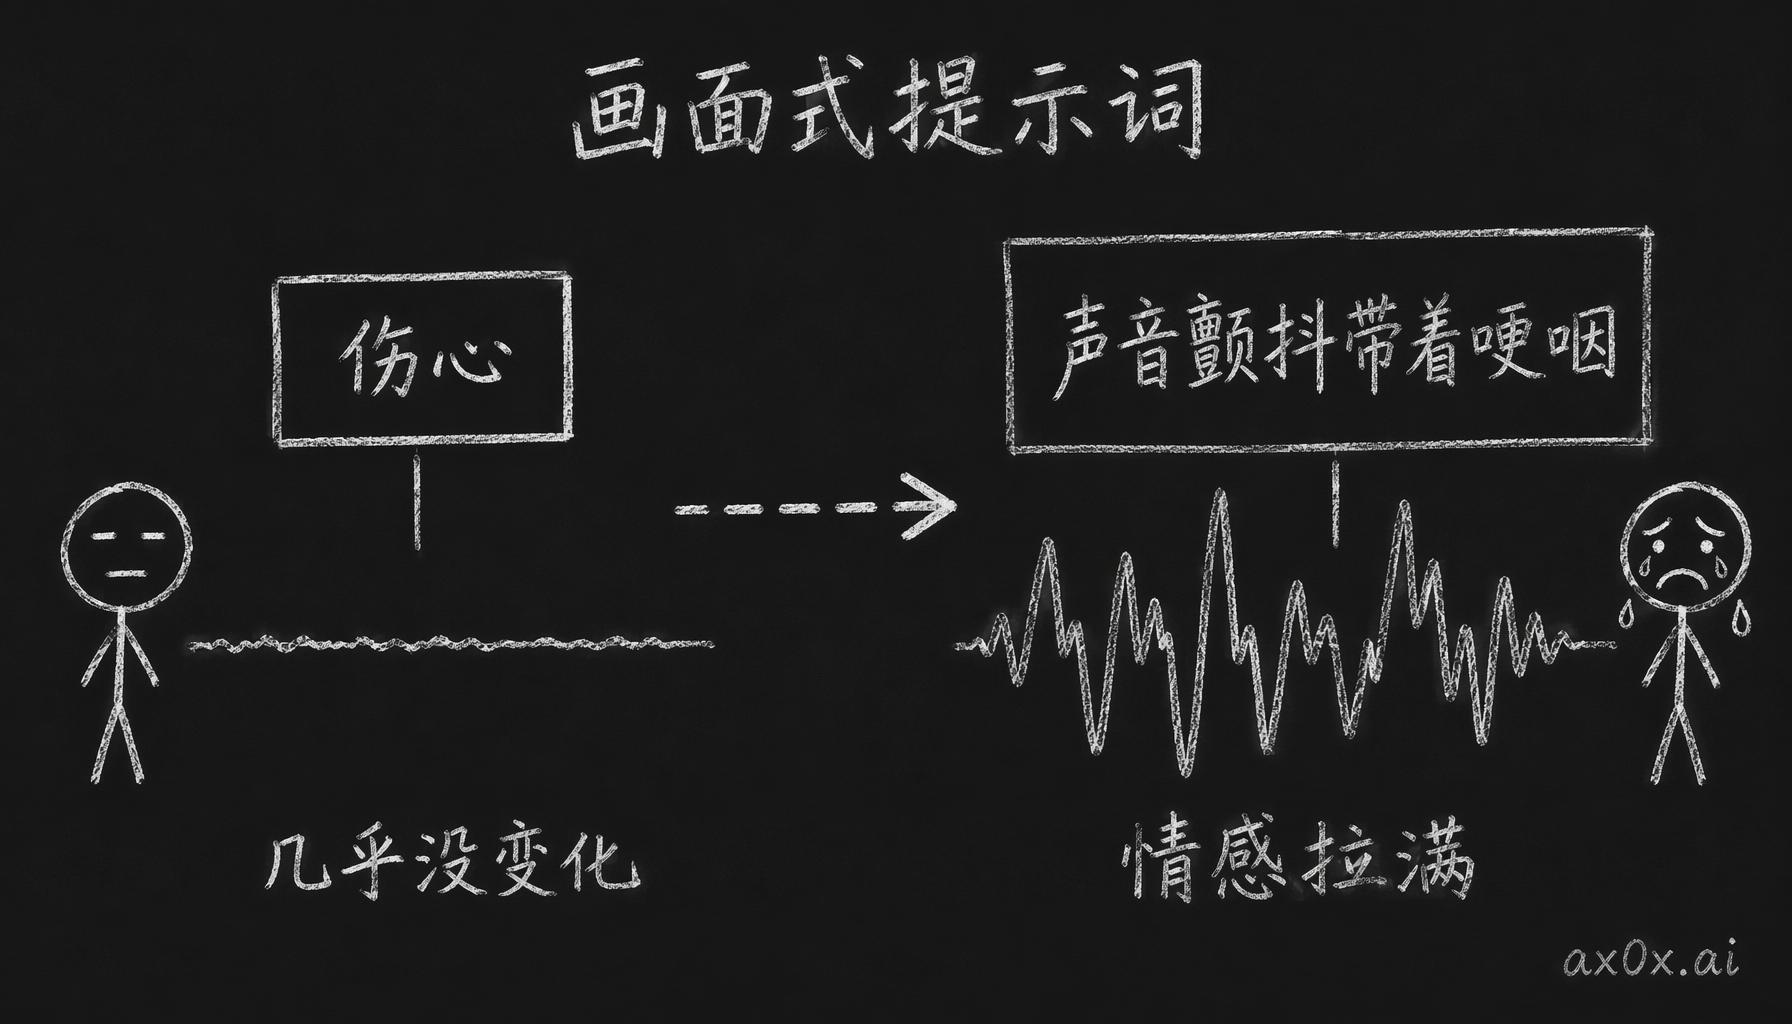 把提示词从「伤心」这个标签改写成「声音颤抖带着哽咽」的画面描述,模型的情感表达从几乎没变化跳到情感拉满。
模型认的不是「伤心」这种分类标签,是具体的描述。这个情感放到声音上是什么样子,你得用文字写出来。下面是现在生产环境在用的整套情感提示词:
| 情感 | 提示词 |
|---|---|
| 撒娇甜蜜 | 用甜蜜撒娇的声音,像在跟男朋友撒娇,语调上扬很开心 |
| 伤心哭泣 | 用哭泣的声音,边哭边说,很伤心,声音颤抖带着哽咽 |
| ASMR 耳语 | 用ASMR悄悄话的声音,非常小声非常轻柔,像在耳边低语 |
| 激动兴奋 | 用非常激动兴奋的语气,开心到快要尖叫了 |
| 愤怒嫌弃 | 用愤怒嫌弃的语气,非常不满在骂人,声音拔高 |
| 慵懒犯困 | 用疲惫慵懒的声音,边打哈欠边撒娇,声音软绵绵的 |
| 沉稳关怀 | 用低沉磁性的声音,表面平淡但充满关心,像大叔在叮嘱 |
| 压抑隐忍 | 用压抑悲伤的声音,故意克制但声音微微颤抖,不想让人看出来 |
这套提示词都是一个路数,动词 + 身体描述 + 场景。「伤心」要写成「声音颤抖带着哽咽」,「开心」要写成「语调上扬、像在跟男朋友撒娇」。写的时候把这个情感在声音上的画面描述出来,别只给一个分类。这个事其实好理解,就跟给演员说戏一样,光喊一句「演伤心」是没用的,得把戏讲具体了人家才演得出来。
如果你也在用豆包 TTS 做要表达情感的产品,我大概有三条建议,都是这轮实验直接换来的:
-
预置音色:用
context_texts配带画面的提示词,想要更多表现力就切到seed-tts-2.0-expressive。你具体要用哪个音色,一定要拿它测一遍,因为每个音色的反应都不一样。 -
克隆音色:
context_texts虽然文档没写,但对克隆音色确实有效,放心用,在 additions 字段里配上model_type: 4。想要控制力最强,就一句一句合成,每句单独调一次 API,各带各的情感提示。 -
情感提示词:别只丢一个关键词,要把画面描述出来。提示词写得好不好,是你手里最能拉开差距的地方,比选音色影响大,也比选模型版本影响大。
完整的技术配置,包括 API 格式、代码片段和各种坑,都写在豆包 TTS 操作手册里了,这篇就不重复贴了。
OpenClaw 实战记录写到第四篇了。想从头看的话,第一篇讲怎么搭这个赛博魅魔,token 成本的坑都在第二篇里,语音这条线是第三篇开的头,这篇接着往下讲情感这部分。上面那张提示词表就是现在生产环境实际在用的版本,拿去直接用就行。
This post is also available in English.