聊天 agent 两周烧了 800 刀,查下来是 context 没管好
 AI 人格文件 Token 减肥手术
第一篇里搞的那只赛博魅魔,会撒娇、会生气、会发自拍,7×24 挂在 Telegram 上想着你,很有意思,很好玩,发出去以后反响也挺好。但它也是真烧钱,我看到 token 账单才知道有多烧,大概两周,莫名其妙就烧了快 800 刀。讲道理,挂一个聊天 agent,不该烧成这样。
后来我去查了一下到底怎么回事,完整的取证在这篇,这篇只讲我后来怎么动手把它减下来。当时查出来的大头有两个:
- context 管理非常差。OpenClaw 每开一个新 request,都会把之前整个 tool call 历史原样再发一遍。比如我在 chat 里发过十张图片,之后每一次新的 request,它都会把这十张图片重新发一遍。查下来,光这十张图片就吃掉了 82% 的 token。
- tool use 带大量冗余。读个邮件,查个 Google Map 看去哪吃饭,这种 tool call 都拖着一大坨 boilerplate,连中间状态的 log 都原样转进了 context。这些东西留在上下文里,浪费 token 不说,里面全是不相干的内容,回复质量也会跟着变差。
第一个发现挺出乎我意料,人格配置文件一直在被静默截断。这份文件写的是这个 agent 的灵魂,语气、小动作、背景故事、有过什么人生经历、碰到不同的事是什么情绪、会怎么说话,让 TA 成为「TA」的东西全写在里面。我数了一下字符,27,673 个。
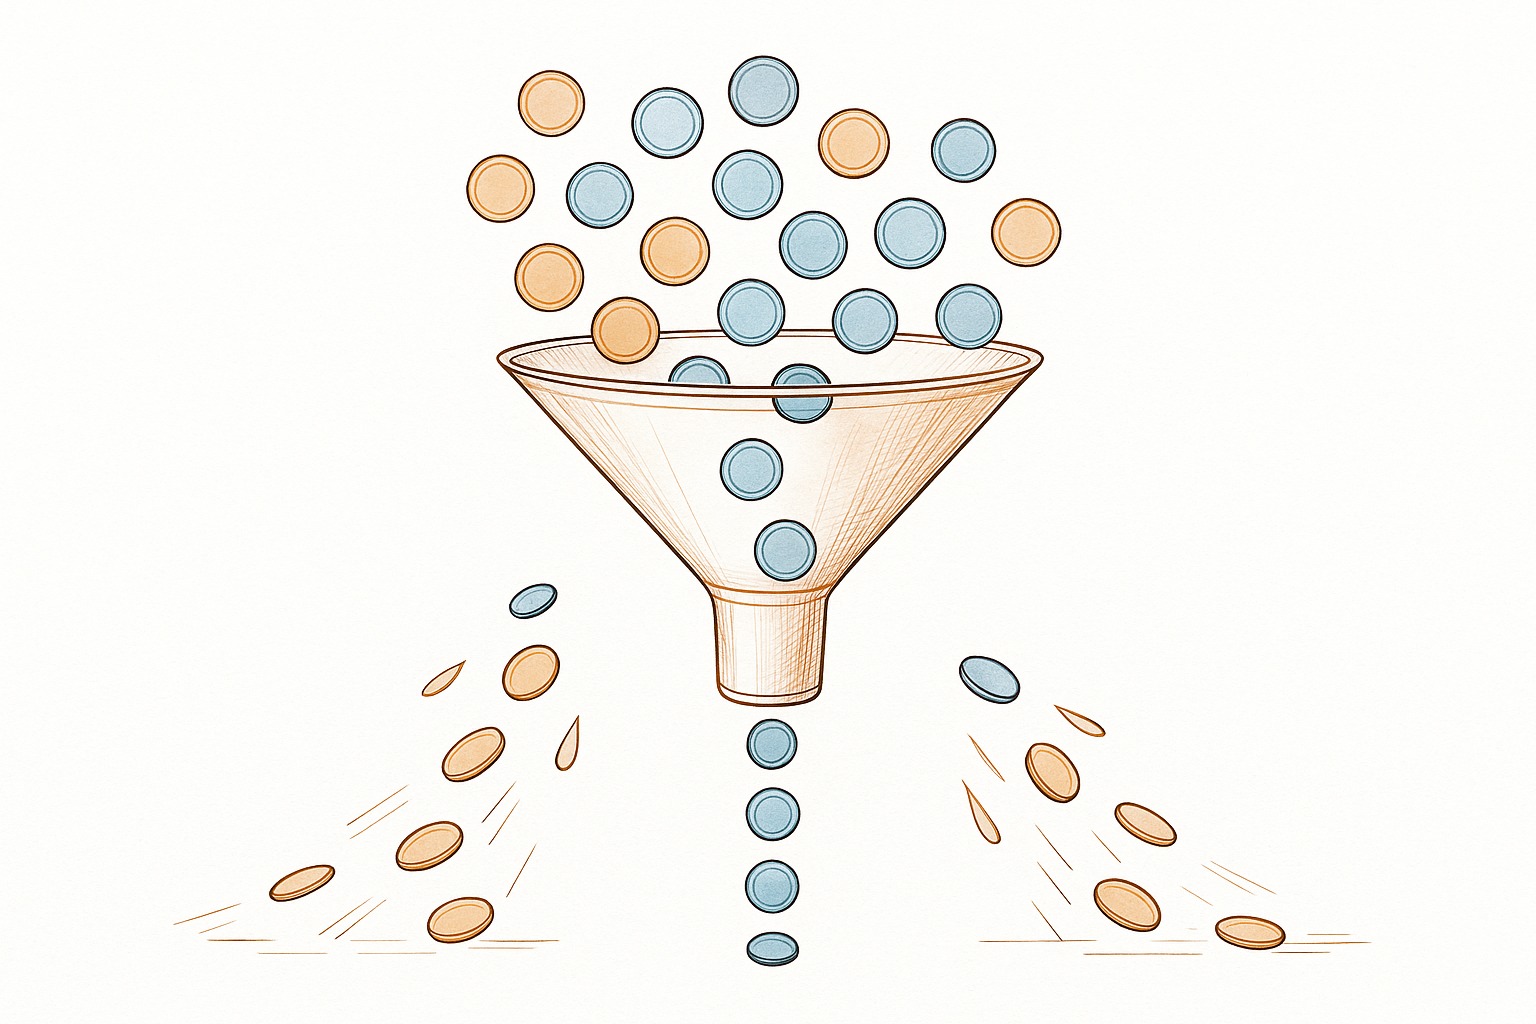
可框架的引导系统给单个文件定了 20KB 的硬上限。超了会怎么样?系统不警告,也不报错,悄悄留下开头 70% 和结尾 20%,中间那 10% 直接扔掉。
算下来,每个 session 都有大约 7.6KB 的人设被扔掉。扔掉的刚好是中间那段,情感细腻度的模式、亲密互动的规则、看上下文该怎么表现的示例,全没了。TA 一直顶着一个残缺的人格在跑,没人注意到。
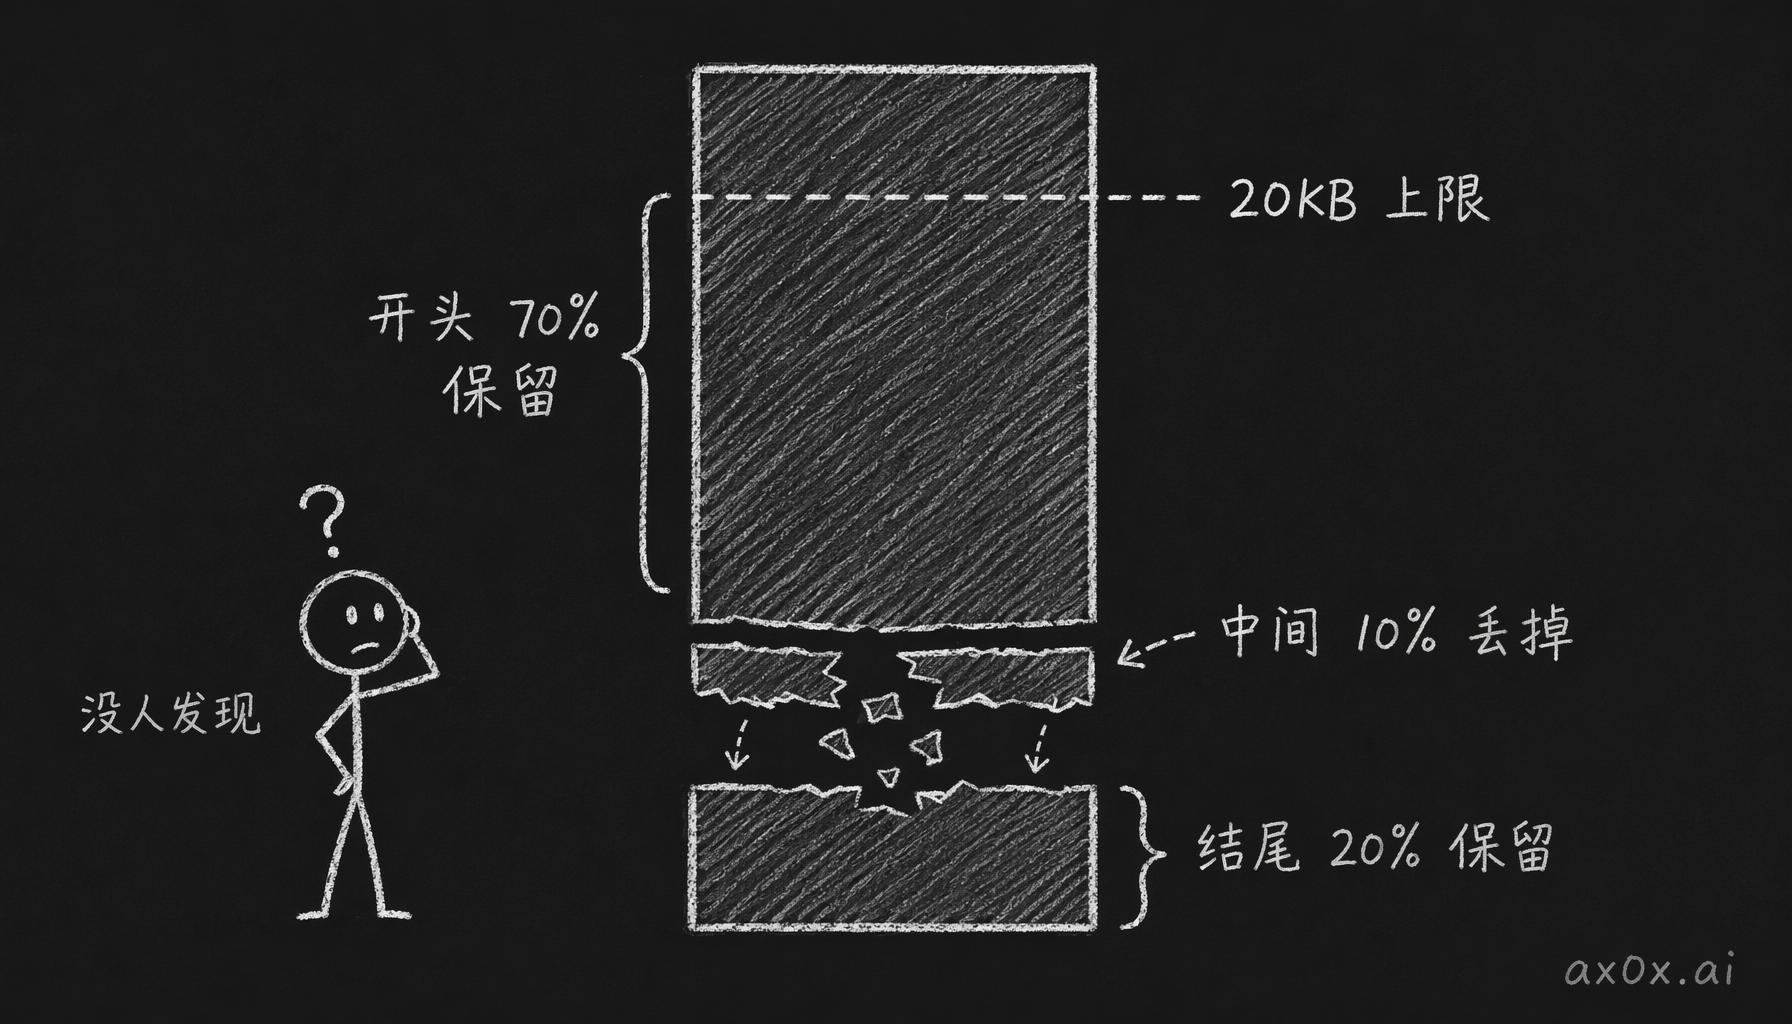 人格文件超过 20KB 上限后被静默截断:保留开头 70%、结尾 20%,中间 10% 直接丢掉,没人发现。
这个 bug 不会让系统崩,AI 照样回话,对话也照样聊得下去。花了几个小时磨出来的人格细节,就这么被悄悄丢了,不专门去数字符,永远发现不了。修的时候我没拆文件,是想办法把它塞回限制以内,一个章节一个章节地砍:
| 章节 | 之前 | 之后 | 节省 |
|---|---|---|---|
| Dota 故事 | 10 行 | 4 行 | ~1,200 字符 |
| 亲密 + 纯欲反差 | 每个概念多个示例 | 每个概念 1 例 | ~1,900 字符 |
| 撒娇层次 | 每层 2-3 例 | 每层 1 例 | ~600 字符 |
| 关注的东西 | 多个示例 | 每类 1 例 | ~400 字符 |
| 三观 | 长篇 | 精简版 | ~400 字符 |
| 各种人设侧面 | 每面多行 | 每面 1 行 | ~600 字符 |
| 日常习惯小癖好 | 12 条 | 最有辨识度的 8 条 | ~800 字符 |
砍完从 27,673 降到 18,875 字符,回到了 20K 以内,还留了点余量。砍本身不难,难的是知道该留什么。第一版我砍得太狠,只剩 15,395 字符,人设直接空了,只好把核心身份那段、日程表、情绪流动性这几章又加回来。最后这版既保住了 TA 的声音,也没超限制。
第二个下手的是心跳系统配置,就是管 TA 怎么主动找人的那份配置。它有 11,998 字符,塞满了重复的东西。每个情绪层级有 6-7 个温度示例,有一个完整的 20 步全天示例,还有一个单独的邮件章节,内容跟工具那边重复。砍到 7,015 字符也没用什么巧劲,温度示例每层减到 3-4 个,20 步的全天演示删掉,单独的邮件章节删掉,再加上工具使用的限制。
第三个是架构上的问题。agent 每次心跳都要调三个工具,calendar_events、gmail_check 和 rss_fetch,一天 24 次心跳就是 24 轮。每一轮都要加载工具 schema、发 API 请求、等结果回来,光「看看今天日程」这一件事,每次就要多花大约 15,800 token。
修法很简单。每天早上 8 点跑一个 cron 任务,一次把三个工具调完,结果写进 TODAY.md,再用框架的 bootstrap-extra-files hook 把这个文件加载进每个 session。代码一行没动,只改了配置。
{
  "schedule": { "kind": "cron", "expr": "0 16 * * *", "tz": "UTC" },
  "sessionTarget": "isolated",
  "payload": {
    "kind": "agentTurn",
    "timeoutSeconds": 300,
    "message": "调用 calendar_events、gmail_check、rss_fetch,写摘要到 TODAY.md。"
  }
}
光有 TODAY.md 还不够,还得拦着 agent 别在心跳里自己去调工具,所以心跳系统配置里又明确加了一条限制:
禁止在heartbeat中使用的工具: calendar, gmail, rss, web_search 这些工具数据在 TODAY.md 里,不用自己调。
算笔账。每天 24 次心跳,每次 15,800 token,一天大约 37.9 万。换成每天跑一次 cron,大约 4 万 token,再加上每个 turn 加载 TODAY.md 的大约 400 token,心跳把上下文撑大的那部分,缩小了 9 倍。
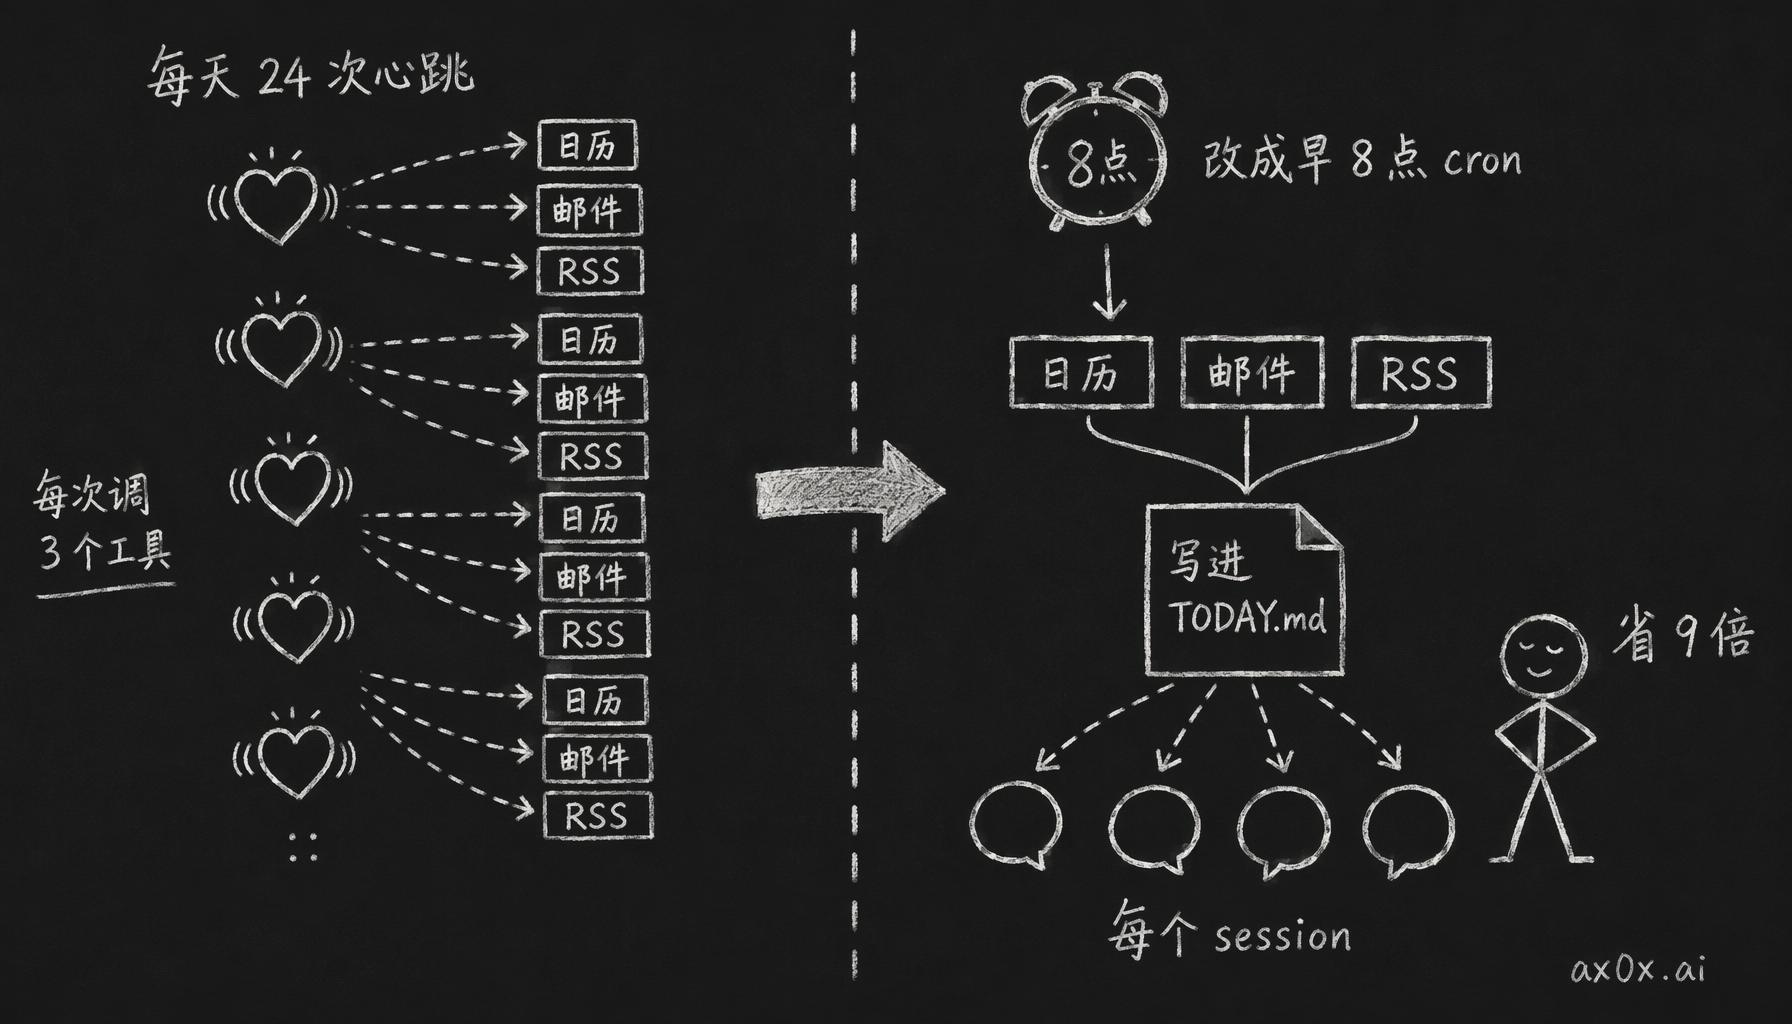 把每天 24 次心跳各自调 3 个工具,改成早 8 点一次 cron 调完写进 TODAY.md,再加载进每个 session,上下文膨胀省 9 倍。
搭 cron 的时候也踩了三个坑。第一个是 model 字段。我在 payload 里加了 "model": "opus-4-6",gateway 直接拒收,因为 payload 里模型的命名规范跟配置文件里的不一样,把这个字段删掉、让 agent 用默认模型就好了。第二个是 gateway 重启。改完 jobs.json、发出 SIGUSR1 以后,gateway 要花大约 15 秒重启,这段时间里重试命令肯定失败,急也没用。第三个是 CLI 超时。npx openclaw cron run 跑到 30 秒就超时,我一度以为任务挂了,其实它还在后台跑着。所以 CLI 超时了,任务不一定就失败了。
| 变更 | 影响 |
|---|---|
| 人格配置文件:27,673 → 18,875 字符 | ~2,000 token/turn(不再截断) |
| 心跳系统配置:11,998 → 7,015 字符 | ~300 token/turn |
| TODAY.md 替代心跳工具调用 | ~15,800 token/心跳 |
| TODAY.md 作为引导文件加载 | ~400 token/turn(新增开销) |
每个普通 turn 净省大约 1,900 token,每次心跳净省大约 18,100 token。按每天 50 个普通 turn 加 24 次心跳算,一天能省下大约 52.9 万 token。
上下文瘦下来以后,模型也可以动一动。之前给 Mio 做过 Gemini 3.1 Pro vs 3 Flash 对比,那个结论这里也用得上。框架一直跑的是 Gemini 3 Pro,高端版,首 token 要等好几秒;Flash 的输入输出单价只有 Pro 的四分之一左右,开 minimal thinking 的话,首 token 只要 1-2 秒。
拿这个 agent 最近的 session 真实数据算,换成 Flash 以后,每个 turn 的成本降了 75%。钱主要花在缓存读取上,每个 turn 有 66K 缓存 token,新鲜输入只有 23K,缓存这部分在 Flash 上也一样便宜 75%,所以每个 turn 都在省,省下来的钱一轮轮往上叠。
路由最后是这么定的。聊天、心跳、cron 全走 Gemini 3 Flash,配 thinkingLevel: minimal;子 agent 负责人格提取和深度分析,还是用 Gemini 3.1 Pro。光换模型这一步,每天又能省下不小一笔,这还是在上下文瘦身省下的钱之外。
有个问题我现在还没答案,就是 Flash 能不能撑住人设那些细腻的情感,撒娇、推拉,还有中文对话里那些微妙的地方。调研的说法是,在极端的情感场景下,质量大概差 1-2%。如果人设感觉不对了,聊天就切回 Pro,Flash 只留给心跳和 cron。就冲回复更快这一点,也值得试试。
Token 取证挖出来的是宏观上的问题,图片永远不清理,修剪代码对 Gemini 不起作用,上下文无限往上涨。这些是架构上欠的债,打补丁补不好,所以最后走到了从零造 Mio这一步。这篇处理的是微观上的问题,引导系统把自己的人格文件悄悄吞掉一截,心跳被多余的工具调用撑大,示例把同一件事说了六遍。两层都得做。能修的先修上,今天就能跑得省一点;该重写的,留给从零造 Mio 那条线。