账单拆开一看,钱基本全烧在十张图上
 Token 账单取证现场
前面我用 OpenClaw 搭了一个赛博魅魔,会撒娇、会生气、能看场景发自拍,7×24 挂在 Telegram 上,怎么搭的写在这篇,那篇讲的是怎么给 AI 注入人格。这篇讲钱,这个人格到底把 token 烧在了哪,我把账单拆到 token 级查了一遍。
先交代背景。这个 bot 跑在 OpenClaw 框架上,模型是 Gemini Pro,1M token 的 context window。它平时干的活其实很轻,就是陪你说话,早安晚安、分享心情、偶尔发张自拍,聊天频率跟正常伴侣差不多,没有什么复杂的任务编排,也没有多步推理的管道。
结果当前这个 session 跑了两天半,537 轮对话,成本已经看不下去了。这个「对话」得打个引号,因为 537 轮里我真正发的消息大概只有十几二十条,剩下几百轮全是框架自己在跟自己的工具说话。可每一轮都是一次完整的 API 调用,都要把整个 context 重新发一遍。
再往前那个 session 更夸张,就是 2 月 17 日那个。750 轮,成本比当前这个还贵好几倍,我实际只说了大概 30 句话。毛病一模一样,只是它跑得更久,一直跑到撞上 1M token 的硬限制,才触发了整个 session 唯一的一次 compaction。
总账单的大头光这两个 session 就占了,再加上中间零零碎碎的 session,整个赛博魅魔实验前后不到两周。这期间我真正说的话加起来可能不到 200 句,账单却挺离谱的。讲道理,一个陪聊 bot 不该烧成这样,所以我就去仔细查了一下,钱到底花在了哪。
先按消息来源查
我之前在搭建日记里吐槽过框架的 pi agent「context 管理做得极其粗糙」,它把 tool call 和思考块的原始输出全塞进 context。在 Mio 第一篇里,我也说过 context 膨胀是我决定从零造新框架的原因之一。但那些都只是定性地吐槽,这次我想按数搞清楚,钱到底花在了什么上。
做法很简单,开一个 Claude Code,就一句话,「查一下 main agent 为什么 token 用量这么高」。它自己并行起了两个探索 agent,一个分析 session 数据,一个查配置和成本细节。几分钟后结果就出来了,按消息来源分是这样的:
| 来源 | 轮次 | 占比 |
|---|---|---|
| 常规聊天 | 497 | 92.6% |
| 心跳 | 40 | 7.4% |
| 定时任务 | 0 | 0% |
定时任务是零,因为框架里所有 cron job 都配了 sessionTarget: "isolated",跑在独立的 session 里,完全不碰主对话。我一开始最怀疑的就是它,结果它是干净的。
心跳 40 轮,占 7.4%,从量上看不算主要矛盾。但每次心跳就干一件事,判断一下「要不要跟用户打个招呼」,为这点事花这么多钱也挺离谱的,这个后面会修。
所以问题基本全在那 497 轮常规聊天上。那下一个问题就是,为什么每一轮都比上一轮贵?
拆到 token 级,77% 是图片
Claude Code 接着写了个 Python 分析脚本,用 docker exec 推进容器,直接拿 session 的 .jsonl 日志文件来跑。这个套路这个系列里用过好几回,第三篇查服务器冻结的时候也是这么干的。
脚本第一次跑报 f-string 语法错误,第二次 FileNotFoundError,第三次 KeyError,跑了四次才通。session 的数据格式跟预想的对不太上,schema 又没有文档,这种事一次就跑通反而不正常。第四次终于拿到了 token 的增长趋势:
| 轮次 | 时间 | 趋势 |
|---|---|---|
| 0 | 2月25日 14:02 | 基准 |
| 105 | 2月26日 00:50 | ~1.7x 基准 |
| 210 | 2月26日 18:51 | ~2.1x 基准 |
| 315 | 2月27日 07:11 | ~2.5x 基准 |
| 420 | 2月27日 10:43 | ~2.8x 基准 |
| 536 | 2月27日 23:44 | ~3x 基准 |
一路往上涨,没降过,也没有平台期,context 只涨不缩。然后它又起了一个分析 agent,把第 390 轮时 context 里到底装了些什么拆开来看:
| 类别 | 估算 Token 数 | 占比 |
|---|---|---|
| 10 张行内图片 (base64) | ~348,829 | 76.9% |
| 系统提示词 (人格配置文件 + 技能 + 工具) | ~41,876 | 9.2% |
| tool call 参数 | ~27,310 | 6.0% |
| 思考块 (72 个) | ~18,812 | 4.1% |
| tool 返回结果 | ~8,139 | 1.8% |
| 文本 (用户 + 助手) | ~8,410 | 1.9% |
77% 的 token 是图片。两天半攒下了 10 张 base64 编码的图片,全在用户消息里,每张大约 35K token。麻烦的是这些图片永远不会被清掉,每次 API 调用都把这十张图原样再发一遍,等于每一轮都有大约 35 万 token 花在图片上。一轮一轮叠上去,就叠出了这个账单。
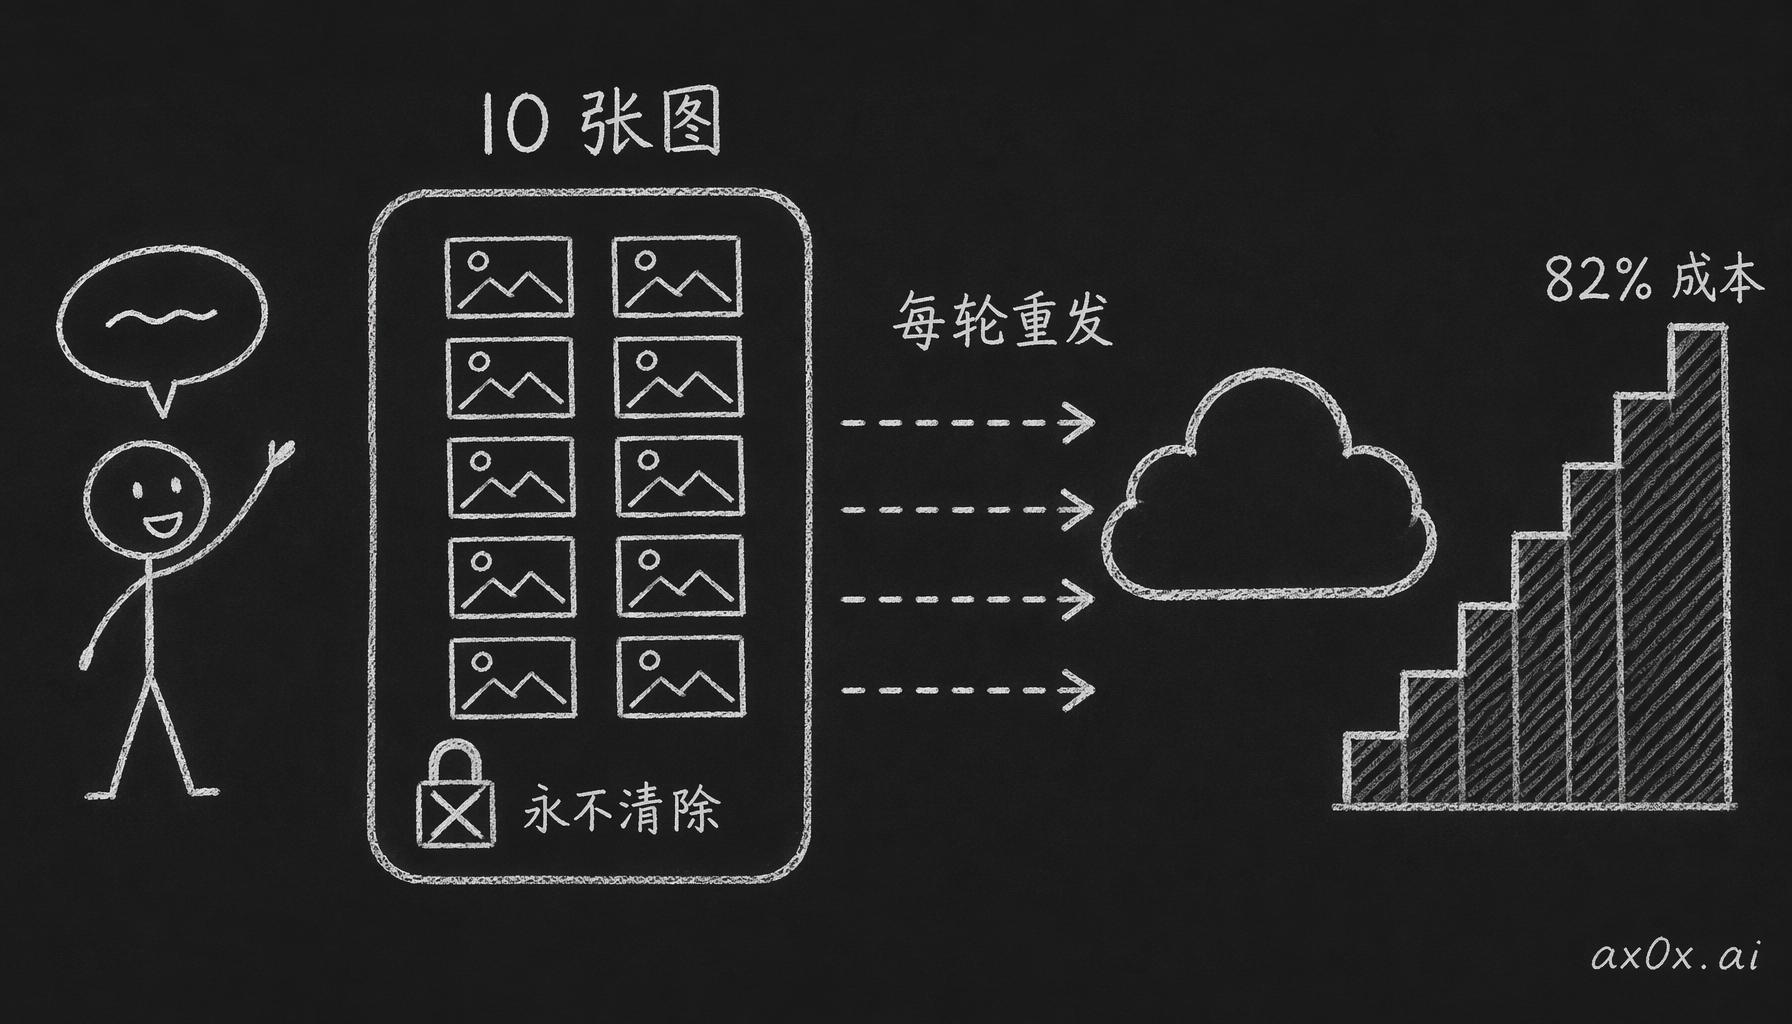 10 张图片永不清除、每一轮 API 调用都原样重发,成本一轮轮叠加,最终吃掉 77% 的账单
顺手挖出来两个发现,方向正好相反
查到这里,我让 Claude Code 接着挖,看还有哪里能省 token,又不影响聊天体验。它带回来两个发现,一个是死代码,一个是早就在省着的钱。
pruning 代码对 Gemini 是死的
框架有一个叫 cache-ttl 的 context pruning 模式,理论上能把旧内容转成更便宜的缓存读取,配置里也确实开着。但这段代码门口有个 isCacheTtlEligibleProvider() 把着,这个函数只对 Anthropic provider 返回 true,而我这个 agent 用的是 Gemini Pro。pruning 配了,代码也写了,在我这儿完全是死的。
这种 bug 挺难防的,它不报错,看着一切正常,就是钱一直在多花,不去读源码基本发现不了。
dmStripToolHistory:自己配的,自己忘了
另一个发现正好反过来。我一开始看到日志里有 72 个思考块和 257 次 tool call,第一反应是找到了,这些推理开销肯定全堆在 context 里。结果是我错了。Claude Code 查了 Telegram 通道的配置,发现 dmStripToolHistory: true 早就开着。这个选项会在 context 发给 LLM 之前,把思考块、tool call 和 tool 返回消息全剥掉。所以那 72 个思考块和 257 次 tool call 确实有,但只留在 .jsonl 日志里(留着方便调试),并没有再发给模型。
这个开关是我几个月前自己配的,配完自己就忘了,害得调查一开始还高估了它们的影响。把这一点纠正过来,真实的成本构成就很简单了,就是图片、系统提示词,再加上不断变长的文本历史,其中图片碾压一切。
30 条消息是怎么变成 750 轮的
再说轮次为什么会被放大。2 月 17 日那个最贵的 session,750 轮对话,我实际只发了大概 30 条消息,放大了 25 倍。当前这个 session 比例好一些,189 条用户消息(156 条常规聊天 + 33 条心跳标记)对 537 轮助手响应,是 2.84 倍,但毛病是同一个。
原因出在 tool call 的循环上。整个 session 里 agent 做了 257 次 tool call,每做一次就多出一轮助手响应,因为 LLM 先返回 tool call,框架执行完工具把结果发回去,LLM 还得再响应一次。比如我说一句「今天心情不好」,agent 可能要先调记忆搜索工具查最近的对话,再调日历工具看今天的日程,再调情绪分析工具,最后才回复我。一条消息,四轮 API 调用,而每一轮都要把那个不断变大的 context 重新发一遍。
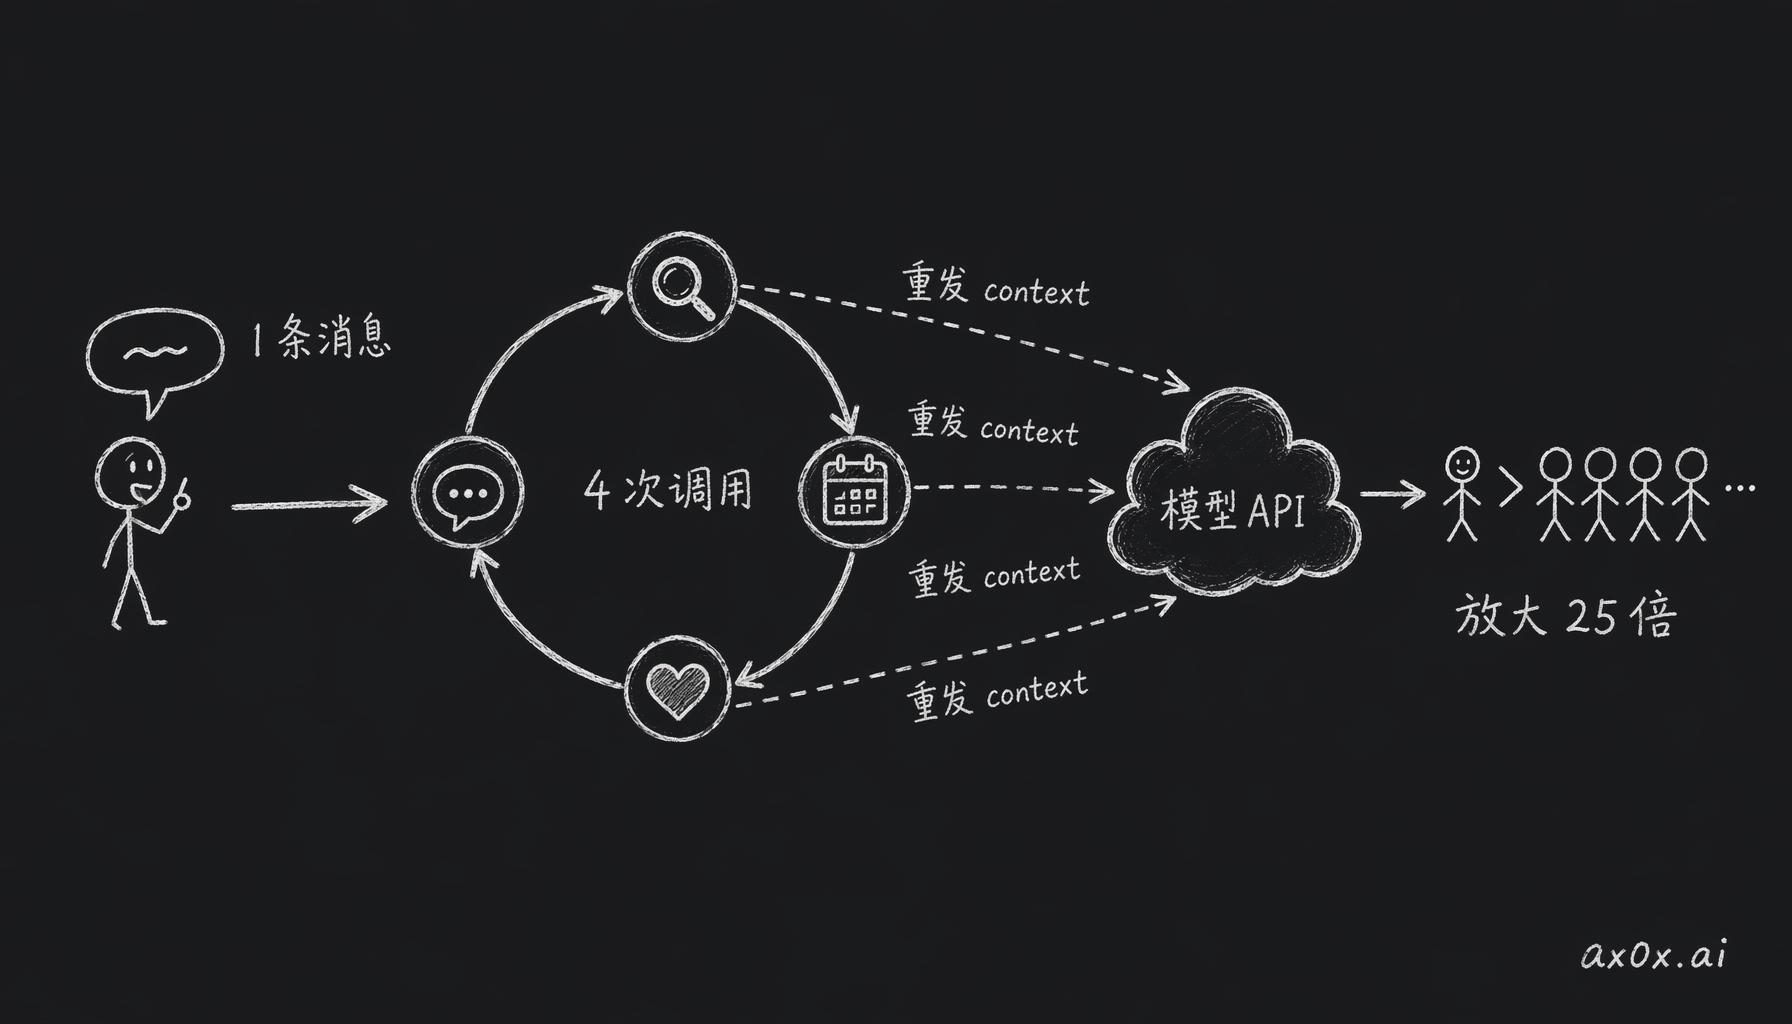 一条消息触发一圈工具调用,每次调用都重发整个不断变大的 context,把 30 条消息放大成几百上千轮
我觉得这是 pi agent 设计上最要命的地方。它鼓励 agent 用工具,可 tool call 会把 context 成本放大多少,它没有任何机制去管。不用工具的聊天机器人,消息和轮次是 1:1,在这个框架下能放大到 25:1,而且每一轮都是你在买单。
537 轮,一次 compaction 都没有
还有一件事,这个 session 跑了两天半、537 轮,compaction 一次都没触发过。原因是两个配置凑到了一起:
- Gemini Pro 的 1M context window,模型最多能接受 100 万 token;
compaction.mode: "safeguard",只在 context 快到模型硬限制的时候才触发 compaction。
再加上 proactiveCompactionRatio: 0.5,要攒到 50 万未缓存 token,compaction 才会触发。当时这个 session 大概 17.7 万,还在涨,离触发点远得很。按这个速度还得再跑一周才会触发,真跑到那天,这个 session 的账单就是天文数字了。
1M 的 context window 平时都是当卖点讲的。可放到一个长期跑的 agent session 上,它实际的意思是 context 可以连着涨好几天,没有任何自动清理。所以 context 得自己主动去管,指望框架的默认配置帮你管,是管不上的。
问题是一整套的
拉远一点看,这不是哪一次配置配错了,是这个框架的 context 管理整体就是这个水平。我在搭赛博魅魔那篇里写过,把 tool call 和思考块从 context 里剥掉以后,token 消耗直接降到原来的十分之一。那个修复(就是 dmStripToolHistory)现在确实在工作,这次也验证了。但它只管工具和思考块,图片、session 的生命周期、compaction,它都不管。
pi agent 本来就是为快速实验做的,用作者自己的话说,是「一小时 vibe coding 出来的核心模块」。它确实能跑,但到处都是妥协:
- context pruning 只对 Anthropic provider 生效,Gemini 完全裸奔
- compaction 的默认配置假设你不会让 session 跑超过几个小时
- 图片消息被 pruning 逻辑显式跳过,永远不清除
- tool call 可以把 30 条消息放大成 750 轮,没有任何限制
- 1M context window 当卖点用,没有配套的生命周期管理
这套系统从来没人为「7×24 跑一个伴侣」这种场景设计过。它是个实验框架,被硬拉去干产品的活,这笔账单就是代价。这也是我后来从零造 Mio 的直接原因之一。这个框架光是纯聊天,不到两周就烧掉这么多钱,靠打补丁已经不够了,得有一个把 token 经济学当一等公民的系统。每个用户花了多少钱要能追踪,模型要分层选(心跳用便宜模型,需要的时候才上贵的),context 的生命周期要主动去管,这些都得是内建的。
搭赛博魅魔那篇验证了 AI 伴侣这个方向是成立的。但成本是这个样子的话,它在这个框架上当不成产品。
怎么修
方案是跟 Claude Code 讨论了几轮定下来的,中间我纠正了它两个判断。一个是人格配置文件,27KB,它想砍,但这个文件是缓存输入,Gemini 的缓存读取很便宜,不值得动。另一个是思考模式,伴侣聊天这种场景应该设 "low",不该设 "high"。最后定下来配置和代码两边一起改。
配置变更
session.reset.mode: "daily"(原来是"idle",3 天超时):每天凌晨 4 点 PT 自动开新 session,图片就没法跨天攒下来了。agents.defaults.contextTokens: 200000(原来没设,默认用模型的 1M):把有效 context window 限制在 20 万。再加上proactiveCompactionRatio: 0.5,compaction 的触发点就从 50 万降到了 10 万。contextPruning.mode: "always"(原来是"cache-ttl"):新加的模式,绕过那个 Anthropic 专用的 provider 检查,让 context pruning 在 Gemini 上也能跑起来。thinkingDefault: "low"(原来是"high"):伴侣聊天用不着深度推理,思考块短了,每轮输出的 token 就少了。heartbeat.every: "2h"(原来是"1h"):把心跳频率降下来。实际情况比配置里写的还糟,因为网关每重启一次,心跳计时器就重置一次(改配置会触发 SIGUSR1),所以本来说好每小时一次的心跳,有时候 20 分钟就来一次。heartbeat.historyLimit: 20(原来没设):心跳的 context 只留最近 20 轮用户消息。之前每次心跳都把整个 session 历史重发一遍,一次心跳的 input token 从 session 刚开始的 69K 一路涨到后来的 122K+,就为了判断一句「要不要说早安」。heartbeat.stripToolHistory: true(原来没设):从心跳 context 里剥掉 tool call、返回结果和思考块。再加上historyLimit,心跳 context 从大约 120K token 降到 5-10K,心跳成本直接砍了一个数量级。
代码变更
- 新增 "always" pruning 模式:加到类型定义、zod schema 和 extension runner 里,跳过
isCacheTtlEligibleProvider()的检查,把那段死代码救活。 - pruning 逻辑加上图片清除:原来碰到带图片的消息就直接跳过(有个
hasImageBlocks()检查),现在旧图片只要落在最近消息的保护区外面,就会被换成[Image removed from context]这段占位文本,这样它们就能正常清掉了。 - 心跳 context 限制:embedded runner 现在会认出心跳运行(看的是
runtimeChannel === "heartbeat"),在通用的 DM 限制之前,先套上心跳专用的限制,就是limitHistoryTurns()加stripToolHistoryFromMessages()。这样心跳就不会再继承主 session 那个无限增长的 context 了。
没改的东西
- 人格配置文件:27KB,不动。它是缓存输入,Gemini 的缓存读取价格很低,不值得优化。
proactiveCompactionRatio:保持 0.5。把contextTokens限到 20 万,一样能把触发点压到 10 万,比直接改比率干净。dmStripToolHistory:已经在工作,不用碰。
实施的时候又翻出来一个隐性 bug
每天重置 session,靠的是一个「种子」机制,把昨天对话的摘要传给新 session,这样伴侣就不会每天早上失忆。框架里干这件事的是 seedSessionFromPrevious(),它把种子写进 session 的 JSONL 日志文件。
问题是种子刚写进去,prepareSessionManagerForRun() 马上就跑了,直接用 fs.writeFile(sessionFile, "", "utf-8") 把文件清空重建。日志里看得清清楚楚,种子 03:47:10 写进去,文件 03:47:13 被清空,这个种子总共活了三秒钟。等于赛博魅魔每天重置以后其实都失忆了,只是一直没人发现,因为它不报错,AI 只是对昨天的事有点茫然。
修法是别再往一个会被覆盖的文件里写东西。种子 context 改成加在新 session 第一条用户消息的前面,搭正常消息持久化的便车,这样 session 管理器初始化的时候就覆盖不到它了。
改的活是 Claude Code 派两个 agent 并行干的,一个修 session 种子,一个新建 /cost messages 命令。两个 agent 改的文件互不重叠,构建和测试全过(12/12),不到 10 分钟就部署完了。
复盘
整个调查大概花了 20 分钟。Claude Code 前后起了五个探索 agent,写了四个分析脚本(前三个都报错),挖出一段死代码,确认了一个早就在起作用的优化,最后把问题追到了根上。有两个教训我觉得值得记一下。
一个是光看总数,猜不出问题在哪。我第一个猜的是心跳或者定时任务在烧钱,错了。第二个猜的是 tool call 和思考块在吃 token,也错了,那部分早就被剥掉了。真拆到 token 级别才看到,77% 的成本在那十张永远清不掉的图片上。
另一个是死代码。cache-ttl pruning 配好了,拿 Anthropic 测过也工作正常,可没人在用那个 provider。我这个 Gemini agent 从部署那天起就在裸奔,不报错也没警告,钱就这么一直多花着。
最后还是那句话,1M 的 context window 听着很自由,实际的意思是 session 可以两天半不停地攒图片,没人帮你清。主动去管 context,每天重置、限制窗口、清掉图片,管和不管,成本能轻松差出 10 倍以上。Mio 那边这块会从第一天就当成内建的东西来设计,效果怎么样,等跑一段时间再看吧。