发个链接过去,它给我编了个胜率出来
 AI 学会阅读互联网的概念插画
它读不了链接,但它会编
用户聊着聊着发个链接过来,是很正常的事,可能是一个游戏战绩页、一篇文章,或者一张有意思的截图。但 v0.0.7 之前,Mio 一个链接都读不了。麻烦在于它不说自己读不了,它会编。
发给它 https://gd.ax0x.ai/?room=0U7VS6,这是一个棋牌游戏的结果页,它会一本正经地给你报数据:"胜率 57.1%,赢了 8 局。"全是编的,没有一个数字有出处。URL 对它来说就是一串字符,它根本没有办法去读页面上真正写了什么,但它照样往下接。
讲道理,这比直接说"我看不了"糟糕得多。说看不了至少是诚实的。编一个用户两秒钟就能拆穿的战绩,拆穿一次,后面人家就很难再信你了。做伴侣类产品,这种事不能发生。
三层管线,先试快的
网页不是一种东西。静态文章是纯 HTML;游戏面板是 JavaScript 渲染出来的,直接抓 HTML 什么都拿不到;还有些页面的主体干脆就是图。一种抓法搞不定所有情况,所以 v0.0.7 做了一个瀑布式的管线,先试便宜的,不够再往上升一层。具体是这样的:
-
Jina Reader。把 URL 发给
r.jina.ai/{url},拿回干净的文本。不用 API key,10 秒超时,截到 3,000 字符。大部分静态页面到这一层就结束了。 -
Browserless 爬取。如果 Jina 拿回来的有效内容不到 100 字符,那这个页面八成是 JS 渲染的,管线就升级到 Browserless。它会起一个 headless browser,把页面真的渲染出来,再从 DOM 里提取文本。SPA 和动态内容靠这一层兜住。
-
截图 + 视觉。如果提取出来的文本还是不到 100 字符,那这个页面的主体大概率是图形,比如仪表盘、信息图、设计稿。这时候 Browserless 截一张 PNG,交给 Mio 已有的
describeImage()视觉模块(跟 v0.0.5 处理图片用的是同一个),让模型描述它看到了什么。
三层全失败的话,也不会悄悄跳过,而是明确告诉 agent:[用户分享了一个链接:{url},但无法读取该网页内容]。agent 知道自己没读到,就不会去编数据了。
100 字符这个阈值挺关键的。低于 100 字符的"成功提取",一般就是一个页面标题加一段 cookie 提示。技术上算成功了,但这点东西拿去当 context 基本没用。所以判断标准不是"请求有没有返回",是拿到的东西够不够当 context 用。请求返回了,拿到的东西也可能根本不够用。
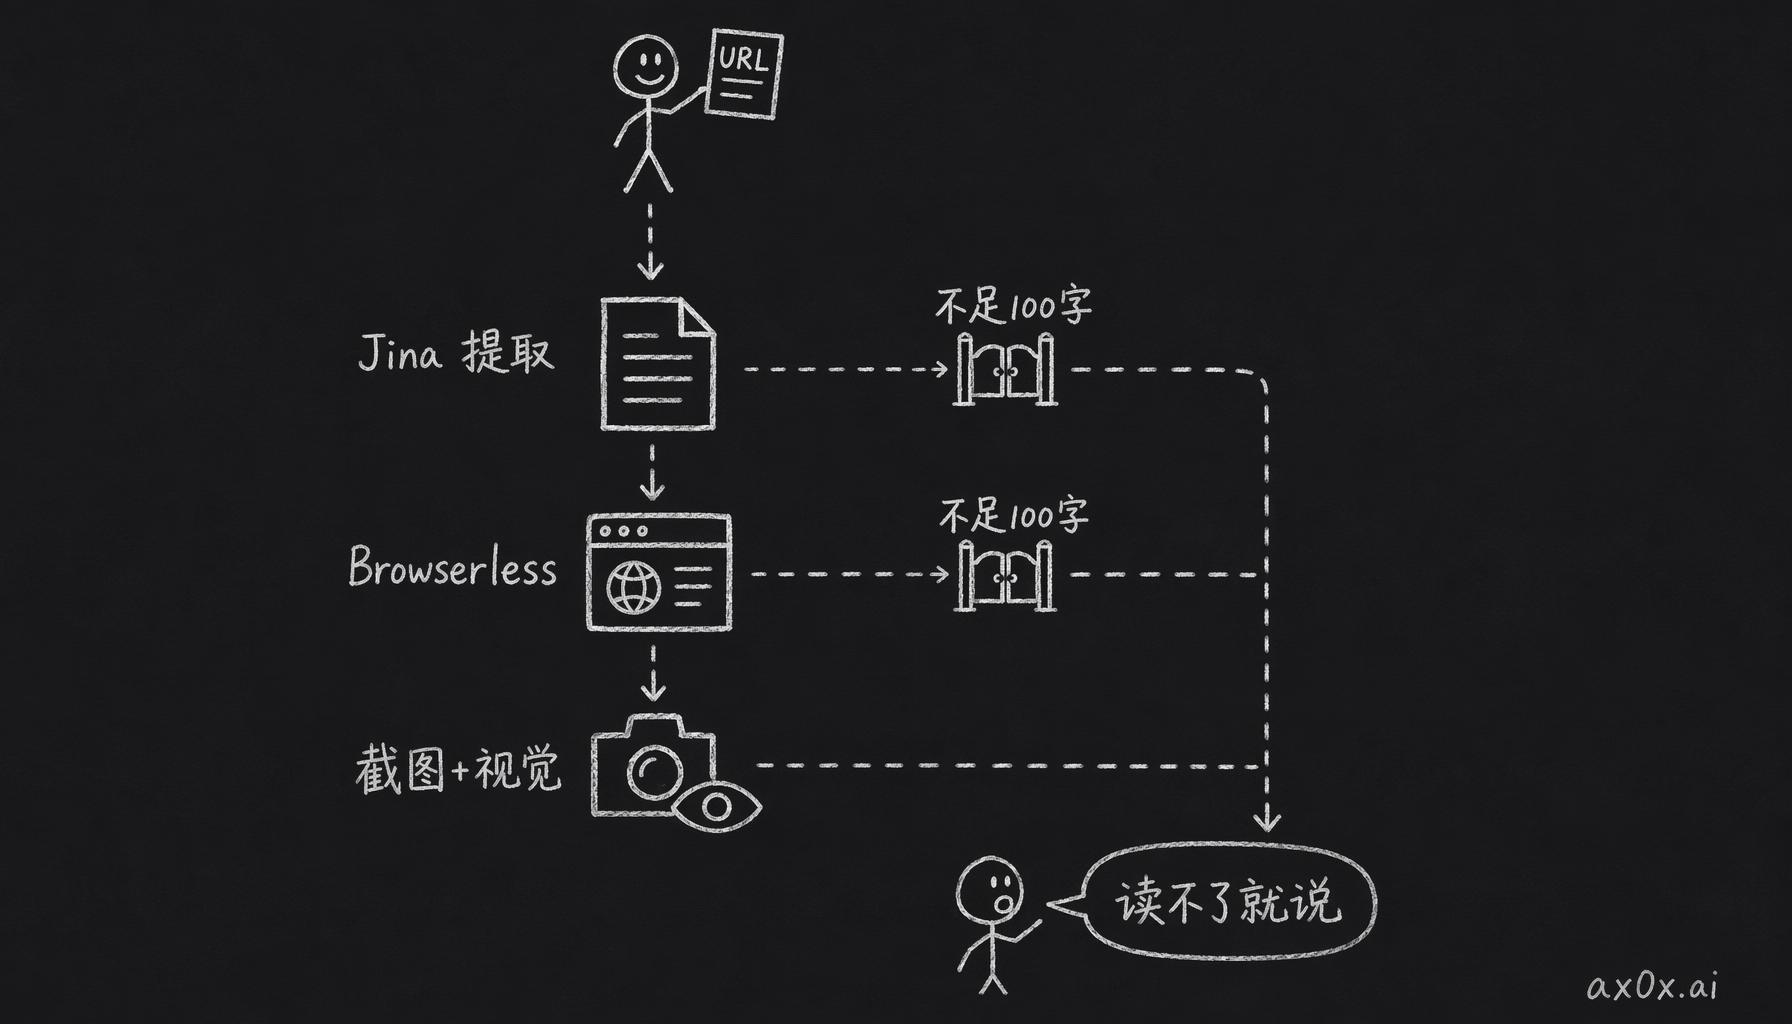 三层瀑布式 URL 浏览管线:先试便宜的 Jina 提取,提取内容不足 100 字符就逐级升级到 Browserless 爬取、截图+视觉,全失败则明确告诉 agent 读不了
Telegram 和 web 聊天都接上了
URL 浏览接在了两条路径上:
- Telegram:在
processBatch()里跑,放在媒体处理之后、routeMessage()之前,负责提取 URL、抓内容,再追加进消息的 context。 - Web 聊天:在
prepareChatContext()里跑,放在resolveMedia()之后。逻辑和 Telegram 那边是同一套,只是入口不一样。
两边共用同一个 browseUrls() 函数。每条消息最多处理 5 个 URL,会去重,也会去掉末尾的标点。几个 URL 用 Promise.allSettled 一起跑,一个挂了不影响其他的。
顺手炸出来一个 Proxy bug
部署 v0.0.7 的时候,生产环境直接挂了,报的是 TypeError: connection is not a function。
packages/shared/src/db/client.ts 导出的数据库 connection 是一个 Proxy,包的是一个空对象。平时访问属性都没问题,connection.query(...) 照常跑,因为 Proxy 的 get trap 会把访问转发到真实的连接上。
但 postgres.js 要用标签模板来写查询:
connection`SELECT * FROM memories WHERE user_id = ${userId}`
这等于把 Proxy 当函数来调用。可如果 Proxy 的目标是个对象,它就没有 apply trap,只有目标是函数的时候才有。目标是什么类型,决定了能用哪些 trap。换句话说,包一个对象就只能当对象用,想被当函数调,目标本身就得是个函数。
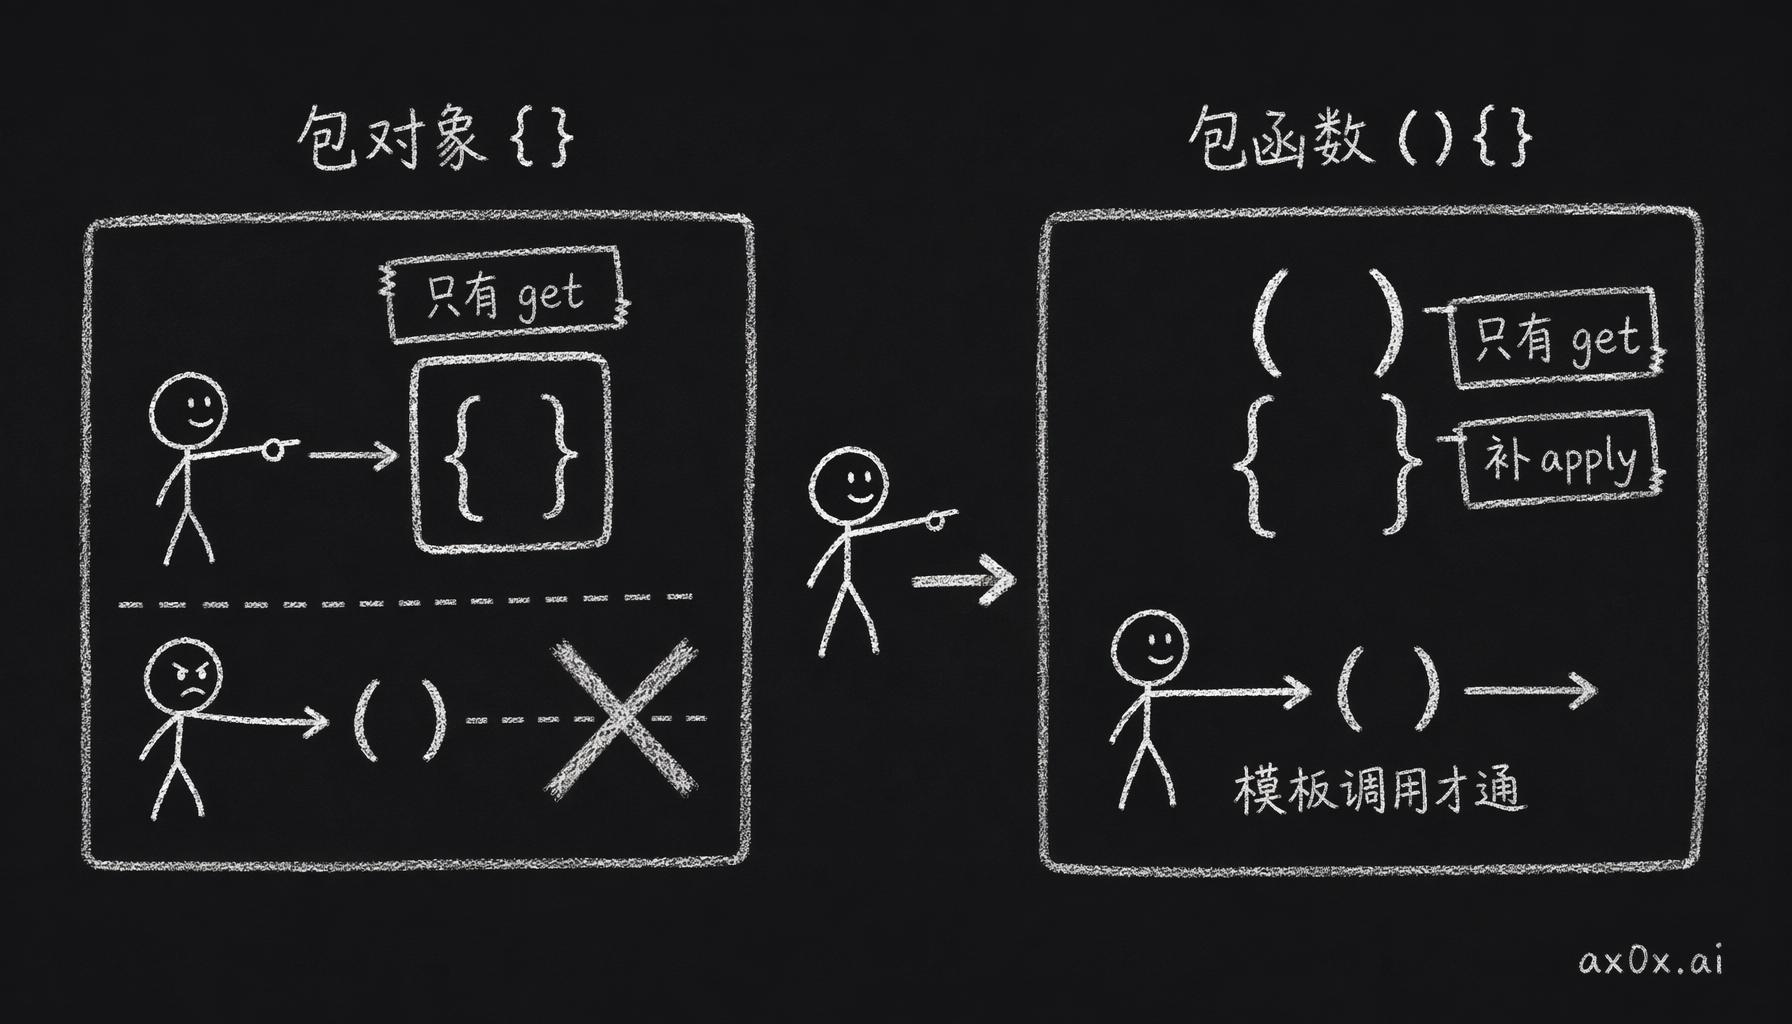 Proxy 目标的类型决定可用的陷阱:包一个空对象只有 get 陷阱,只能点号访问;把目标换成函数才有 apply 陷阱,才能被当函数(标签模板)调用
修法就是把 Proxy 的目标从 {} 换成 function () {},再补一个 apply trap:
export const connection = new Proxy(
  function () {} as unknown as ReturnType<typeof postgres>,
  {
    get(_target, prop, receiver) {
      return Reflect.get(getConnection(), prop, receiver)
    },
    apply(_target, thisArg, args) {
      return Reflect.apply(
        getConnection() as unknown as (...a: unknown[]) => unknown,
        thisArg,
        args,
      )
    },
  }
)
这个 bug 把记忆检索和人格提取全打断了,所有用标签模板写的原始 SQL 查询都挂了。出事之前它完全看不出来,点号访问跑了几个月一点事没有,直到有代码走了模板语法,才炸出来。
还有个部署时序的乌龙
部署完 URL 浏览功能,我马上去测。把那个棋牌链接发过去,agent 还是在编数据。
第一反应是部署没成功?查了日志,部署是正常的。
真正的原因简单得多,也烦人得多。那条 URL 是凌晨 3:03 发的,在部署之前。我跟 agent 说"再试一次",可重试的那条消息里只有"再试一次"这几个字,没有 URL,browseUrls() 当然什么都抓不到。旧消息不会自动获得新能力,这话说出来很显然,但卡在里面的时候真想不到。
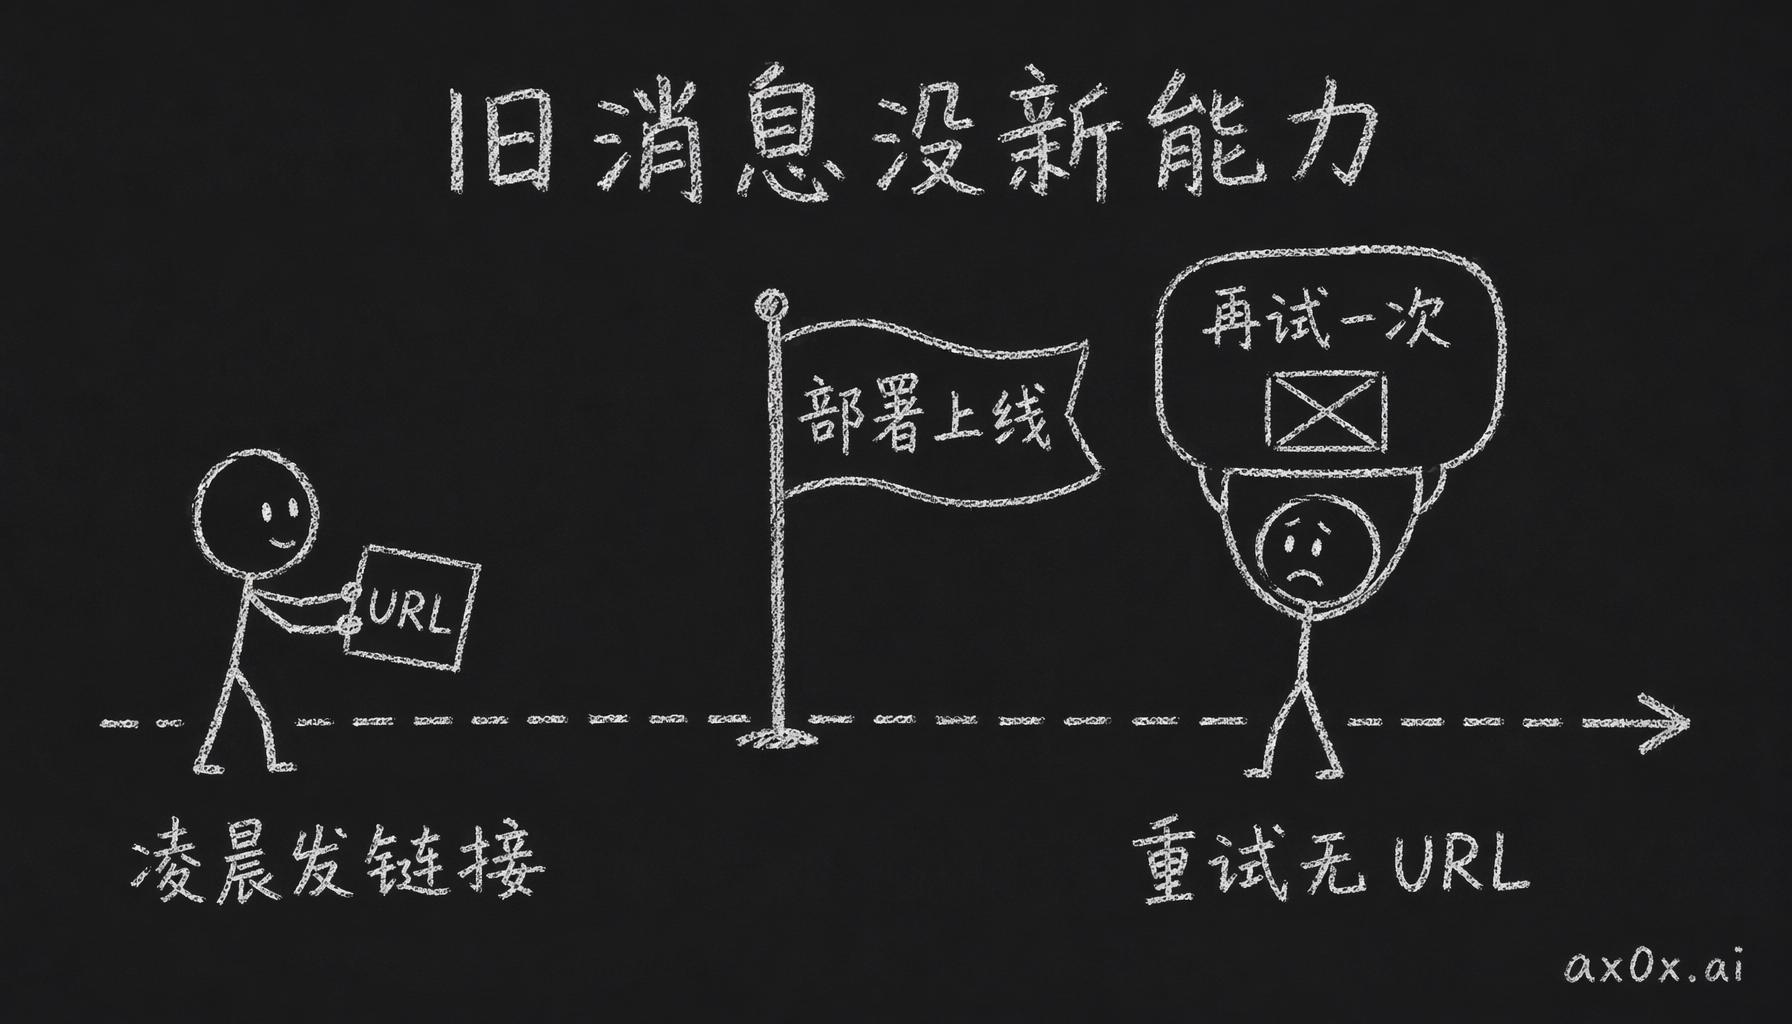 部署时序的乌龙:链接在部署上线之前发出,重试消息里只有'再试一次'没有 URL,所以抓不到——旧消息不会自动获得新能力
我把链接重新发了一遍,Jina 返回了完整的 16 行游戏状态,有玩家名、分数、炸弹序列、赢家,agent 描述得完全准确。功能从头到尾都是好的。
所以以后再碰到"新功能好像不工作",我会先查一件事,就是触发它的那条输入,到底是部署之前来的,还是之后来的。
23 个测试
browse.test.ts 覆盖了下面这些情况,23 个全过,类型检查也是干净的:
- URL 提取:无 URL、单个、多个、去重、去尾部标点、上限 5 个
- Jina 流程:成功、空响应、fetch 失败、非 ok 状态、认证头
- Browserless 回退:Jina 不够 → 爬取成功;Jina 抛异常 → 爬取兜住;没配 API key → 跳过
- 截图 + 视觉:文本太短 → 触发截图;视觉说认不出来 → 给失败通知
- 端到端:文本够了 → 不截图;全失败 → 失败通知
上线之后
再发链接过去,agent 拿到的就是页面上真实的 context 了。战绩页能报出真实的玩家和分数;读不了的页面,它也知道自己没读到,会老老实实讲出来,不会再硬编。编数据这种事,被用户拆穿了会丢信任,没被拆穿的话,拿着错的信息聊下去也好不到哪去,反正怎么都不行。
用户不用知道、也不用关心是哪一层搞定了他们的链接。发个 URL 过来,就能拿到一个真实的回复。
跟朋友聊出来的几个想法
跟朋友聊 Mio 的时候,聊出来几个想法,还没做,但已经在影响设计了,先记下来:
AI 写的人设故事不像人话。Mio 现在所有的人格预设都是 AI 生成的。朋友看了其中一个,马上挑出好几句"听着不太像人话"。恐怖谷不只在脸上,角色表达情感的方式里一样有。修的方向大概是把核心模板换成人写的,AI 负责出数量,人负责出质感。
让用户从零写人格是个坑。我本能的想法是开放自定义,让用户自己写。朋友一句话就把我摁回来了:"99.9% 的人懒得写,写的人也会乱写。"写得差的人格比通用人格更破坏沉浸感,因为一个角色自己跟自己矛盾、信息又不够的话,agent 没法把它一直演下去。更合理的做法是分层:
- 大多数用户用模板,填空式的,比现在这种整套预设再细一档。选一个基础性格,自定义几个关键的关系事件,写几条重要的记忆。结构给得够多,就写不乱;自由度也够,用户会觉得这是自己的。
- 完全自定义留给高级用户,放在最高的付费档。愿意花钱、又愿意花精力写人格的人,大概率真会好好写,投入多少跟质量是挂钩的。
互动叙事。朋友最兴奋的是这个,让 AI 人格去玩剧本杀、跑团这类有结构的叙事游戏,演一个有目标、有秘密、有利害关系的角色。日常聊天里伴侣可以随机应变,剧本杀里的角色不行,它的动机要前后一致,信息要藏得住,演得还要让人信。对人格系统来说,这比日常陪聊难了一个量级。
这些都是 v0.1.0 的事。但它们已经在改变我对人格系统的想法了。光存"性格"大概不够,像剧本杀那样要藏信息、要按目标演的角色,得有一层结构化的叙事状态才撑得住。具体怎么做还没想,先记在这。