关于人的记忆,得单独建一张表
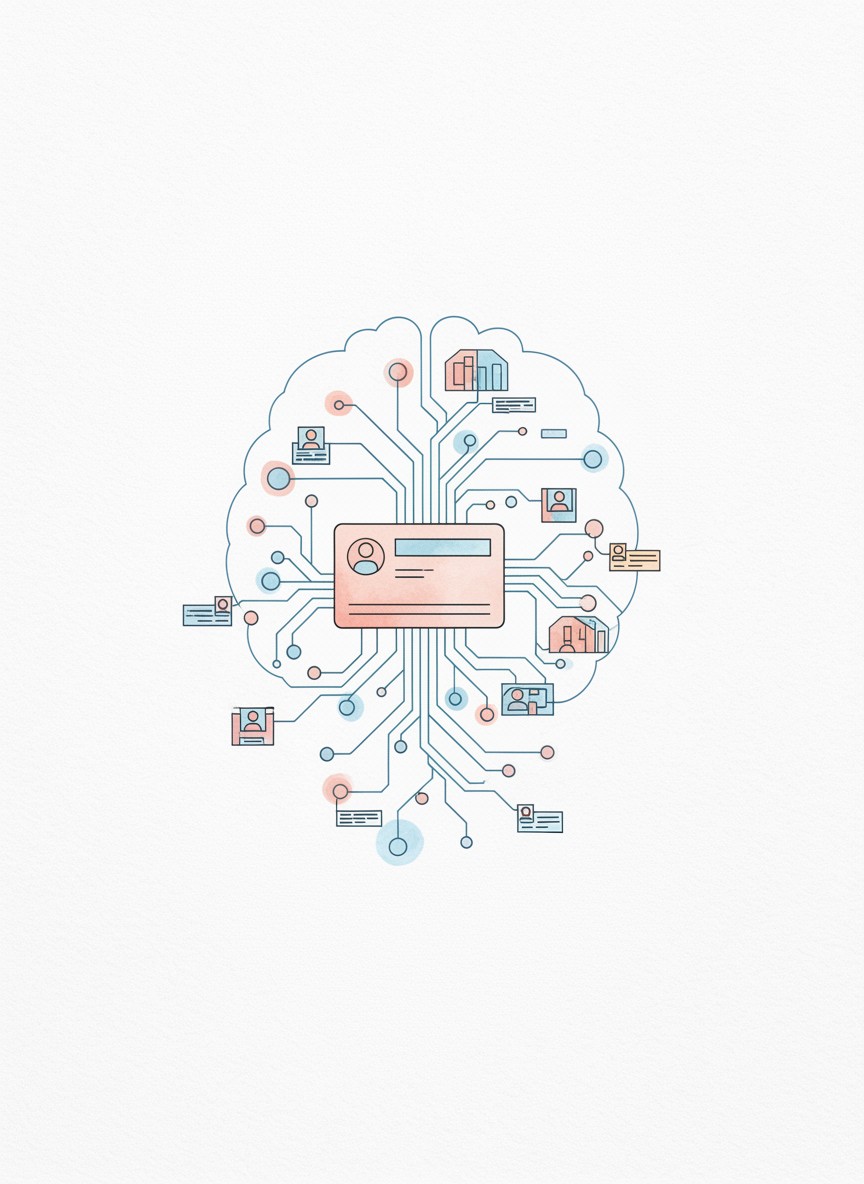 记忆碎片聚合为完整人物档案的概念插画
先讲问题出在哪
第三篇里我说过,记忆系统是 v2 里最值钱的一块,是从 v1 原封不动搬过来的。这话本身没错,但后来发现它有个挺大的盲区。这篇就具体讲讲这个盲区是怎么回事,我们又是怎么修的。
先说旧系统是怎么做的。所有东西都存在一张 memories 表里,每条记忆带一个 768 维的 embedding。用户说「我喜欢吃辣」,就存一条;下次要查「用户口味偏好」,用余弦相似度一搜就搜到了。存偏好这类信息,这套办法是够用的。
但关于「人」的信息就不是这么回事了。比如用户在不同的对话里提过小红的五件事,在腾讯当工程师,养了一只猫,最近加班很多,上周跟男朋友吵架了,下个月来北京。这五条记忆散在表里,互相之间没有任何关联。你想把小红的信息全查出来,只能拿 ILIKE '%小红%' 把全表扫一遍。
更麻烦的是语义上的问题。「小红最近怎么样了」和「小红在腾讯当工程师」这两句话,在 embedding 空间里几乎没有相似度。一句在问近况,一句在说职业,向量方向完全不一样,所以语义搜索根本搜不到。模型明明存过小红的信息,用户问起来它却拿不出来,看上去就跟忘了一样。一个主打记忆的伴侣产品出这种 bug,挺尴尬的。
方案具体是这样的
思路不复杂,给「人」单独建一张 contacts 表,把用户生活里的人变成有索引的实体。这样关于一个人的事,就不用再零零碎碎地散在记忆表里了。
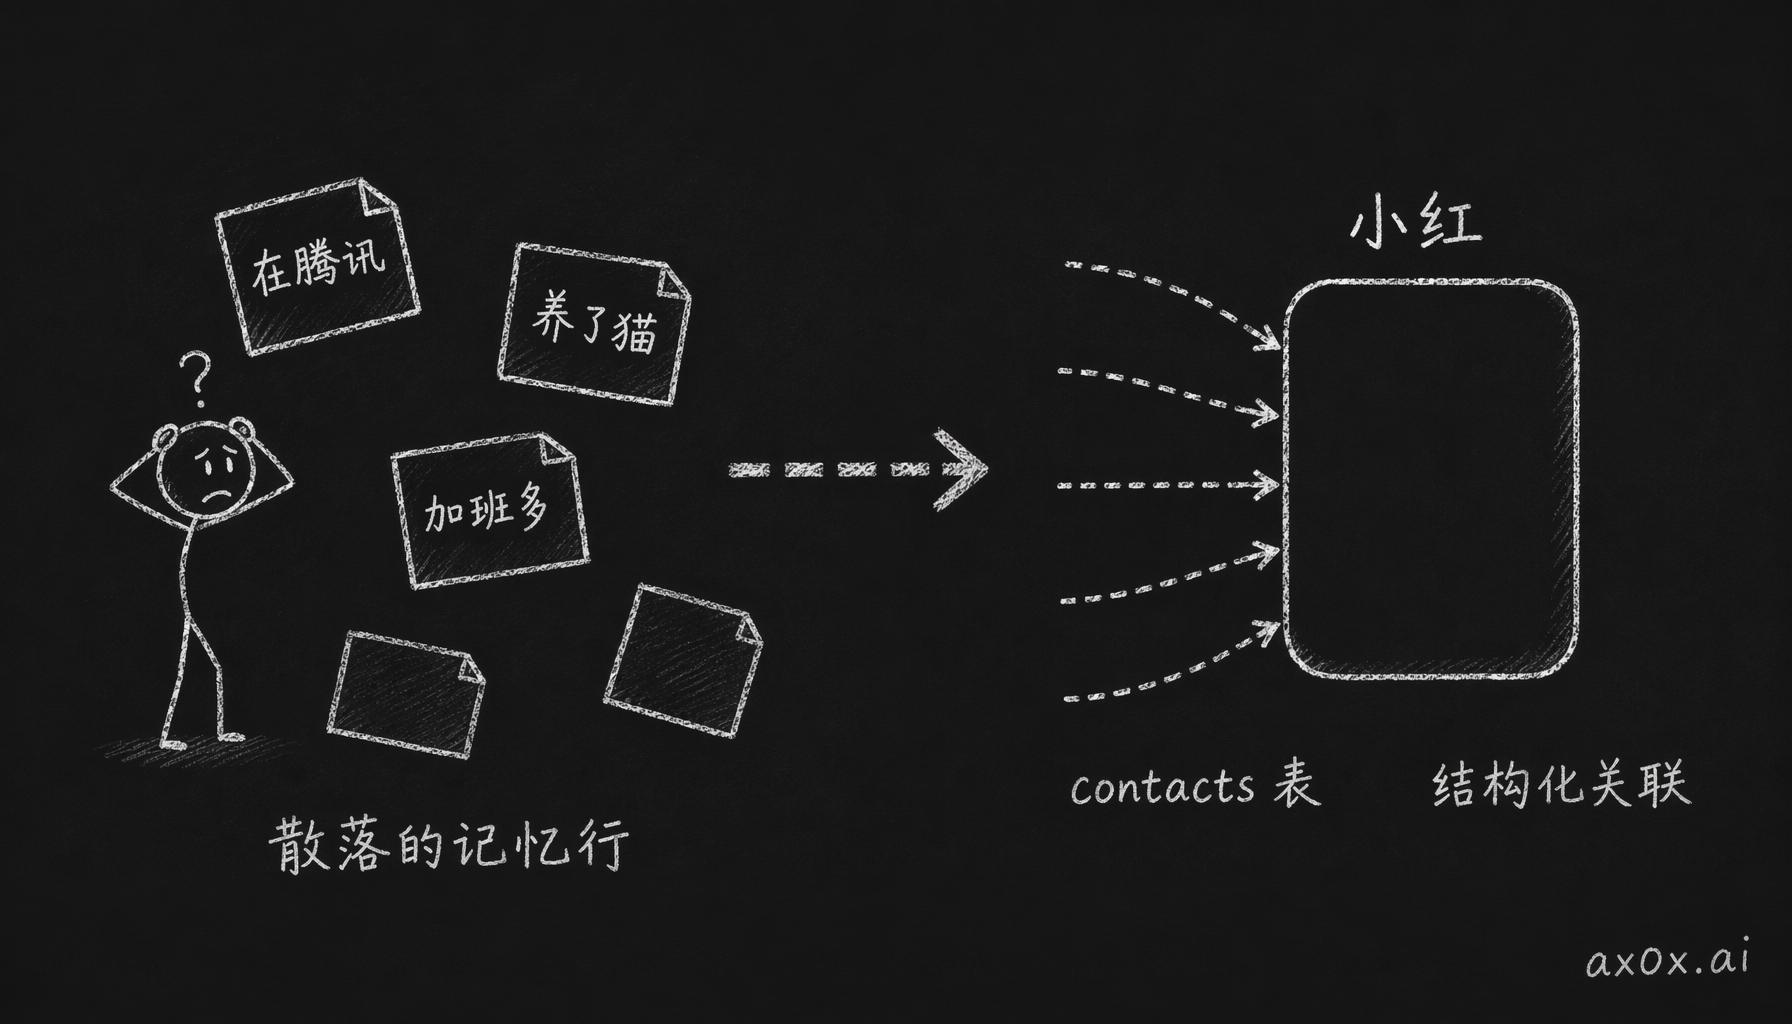 关于一个人的记忆从散落无关联的行,聚合成一个有结构关联的联系人实体
CREATE TABLE contacts (
  id            UUID PRIMARY KEY DEFAULT gen_random_uuid(),
  user_id       UUID NOT NULL REFERENCES users(id),
  name          TEXT NOT NULL,
  relationship  TEXT,           -- "同事", "大学室友", "妈妈"
  description   TEXT,           -- LLM 生成的性格/近况描述
  attributes    JSONB DEFAULT '{}',  -- 结构化数据:职业、城市、生日...
  memory_ids    UUID[] DEFAULT '{}', -- 关联的记忆 ID
  created_at    TIMESTAMPTZ DEFAULT NOW(),
  updated_at    TIMESTAMPTZ DEFAULT NOW()
);
这张表里最关键的是 memory_ids 这个 UUID 数组。它把联系人和相关的记忆直接挂在一起,查的时候按 ID 拿就行,不用再靠 ILIKE 扫全表。attributes 是个 JSONB 字段,存 LLM 从对话里提取出来的结构化信息,比如职业、所在城市。
整条管道分三个阶段
用户说一句「小红最近工作压力很大」,后面会发生三件事:
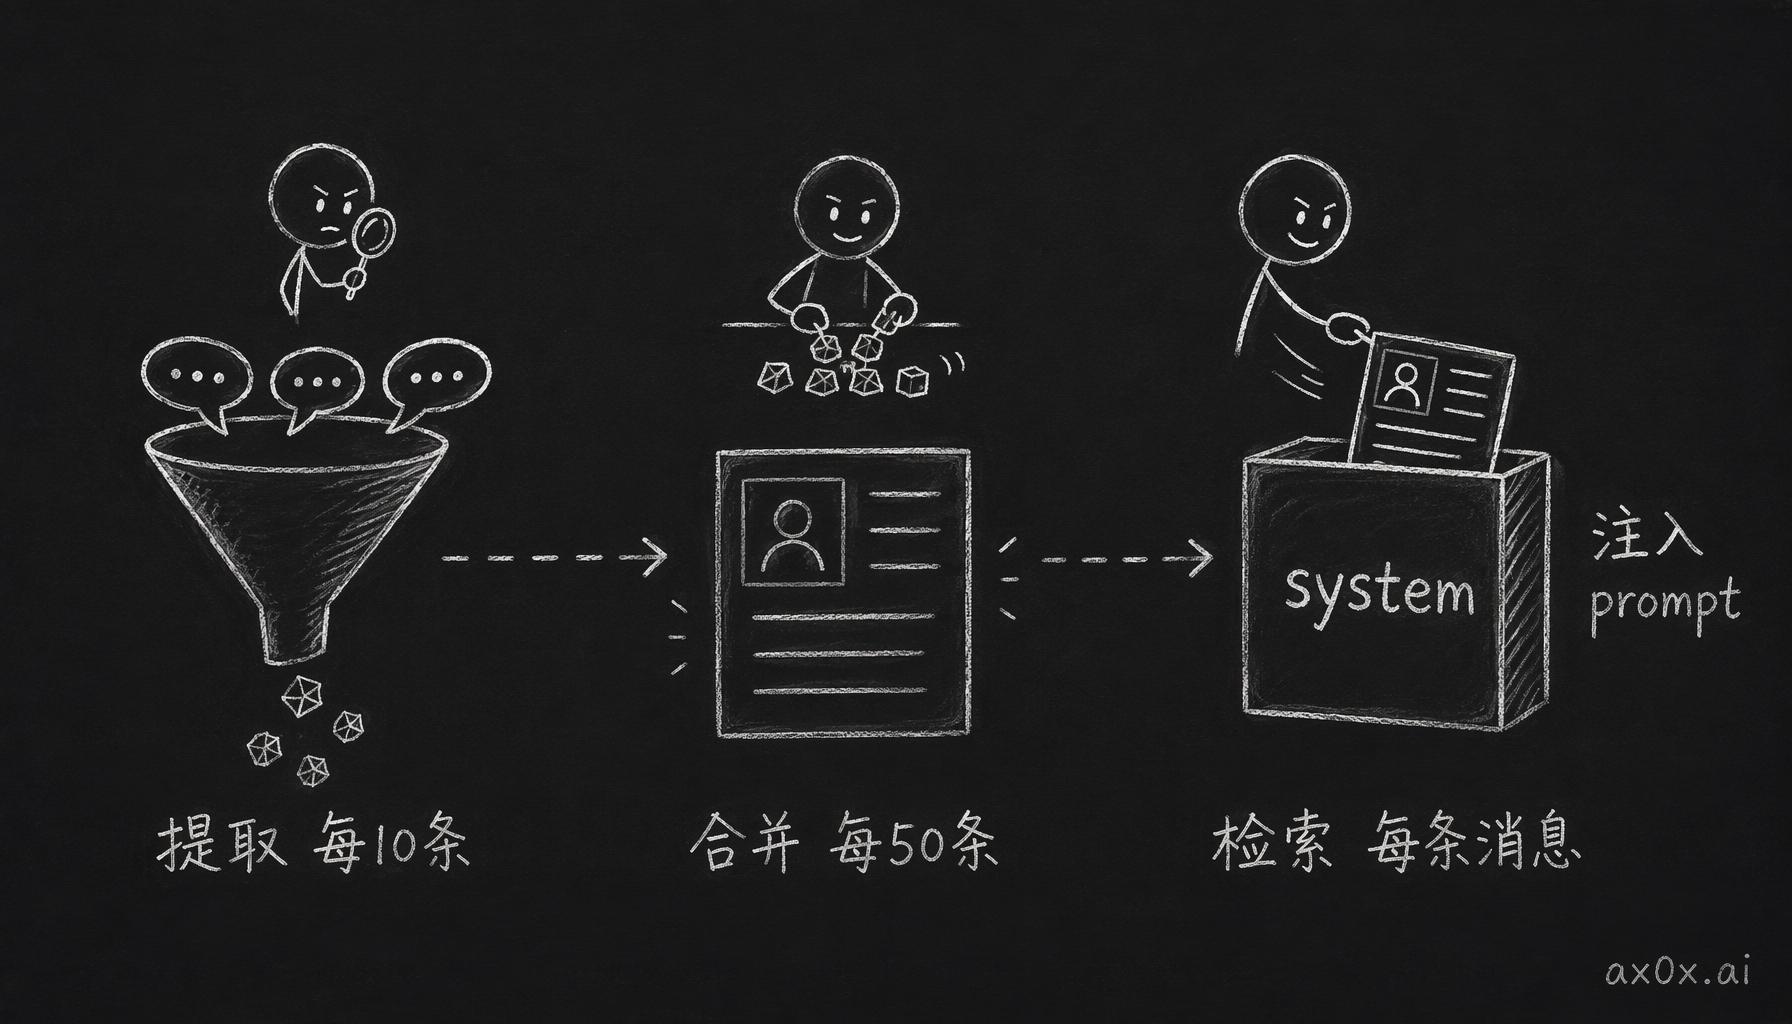 记忆管道分三个阶段,各按不同频率触发:提取、合并、检索
-
提取(大概每 10 条消息触发一次)。MemoryAccumulator 照常提取记忆,但现在多了一步,要检查子类型。如果发现这条记忆跟人有关,就跑
syncContacts(),upsert 一条联系人记录,再把新的 memory ID 挂上去。 -
合并(每 50 条消息触发一次)。PersonConsolidator 把每个联系人名下的所有记忆碎片拉出来,让 LLM 生成一份结构化档案,里面有性格描述、关键属性和时间线。生成完以后,把这些源碎片的重要性降到 0.05,免得它们再跟合并后的档案抢搜索结果。
-
检索(每条消息都跑)。用户消息里提到了某个联系人的名字,aggregator 一匹配上,就拼出一张「联系人卡片」直接塞进 system prompt,完全绕开语义搜索。
联系人卡片长这样:
[联系人: 小红]
关系: 大学室友
描述: 在腾讯当前端工程师,养了一只橘猫叫豆豆。
最近加班多,上周跟男朋友吵了一架。下个月来北京出差。
属性: {职业: "前端工程师", 公司: "腾讯", 城市: "深圳"}
卡片直接塞进 system prompt,模型马上就知道小红是谁。反正信息已经在上下文里了,不用再搜,也就没有「语义搜索搜不搜得到」这个问题了。
检索分两步
实际查的时候分两步:
// 第一步:通过 contacts 表拿关联的 memory ID(O(1) 查找)
const contact = await db.contacts.findByName(userId, mentionedName)
const linkedMemories = await db.memories.findByIds(contact.memory_ids)

// 第二步:ILIKE 兜底,抓未关联的记忆
const unlinkedMemories = await db.memories.findByContent(
  userId, mentionedName,
  { exclude: contact.memory_ids }
)
第一步是精确查,通过联系人表直接拿到关联的 memory ID,O(1)。第二步是兜底,用 ILIKE 扫一遍,把还没关联上的记忆也抓回来。为什么要留这个兜底?因为有些记忆是 syncContacts() 上线之前存的,还有一些是同步失败漏掉的。反正关联对的记忆越来越多,用到这个兜底的次数也会越来越少。
踩过的坑
这块上线的时候踩了不少坑。下面这些都是真出过的 bug,挨个记一下。
数组下标错位,这个最严重。storedIds[i] 和 personMemories[i] 对不上,因为 storedIds 是 ADD 和 UPDATE 混在一起返回的结果,顺序跟输入数组不一样。结果记忆被挂到了错的联系人身上。后来改成从数据库里查 content 到 ID 的映射,不再靠数组下标。
UUID 空数组崩溃。把空的 UUID 数组传给 Postgres 的 ANY() 操作符,会报类型推断错误。后来拆成两个独立的查询,数组为空就直接跳过第一步。
重要性地板设太高。GREATEST(0.1, importance * 0.5) 本来是想给被合并的记忆降权,但 0.1 这个下限还是太高,碎片在搜索结果里老是冒出来,跟合并后的档案抢位置。所以直接改成了 0.05。
CJK 截断。.slice(0, 100) 按 UTF-16 码元截,碰上 emoji、生僻字这种占两个码元的字符,会从中间切开,切出乱码。改成 [...text].slice(0, 100).join(''),按字符截,不按码元截。
重复合并。合并器会反复处理已经合并过的记忆碎片,每处理一次就多出一份新档案。后来加了个 (metadata->>'consolidated_into') IS NULL 的过滤条件,只处理还没被合并过的。
还没解决的问题
还有一堆问题现在没解决,先列在这:
- 联系人是按字符串精确匹配的,没有模糊匹配,「小红」和「红红」不会被认成同一个人
- 代词解析还没做,「她最近怎么样了」里的「她」不会被解析成「小红」。联系人卡片塞进 system prompt 以后模型自己能猜,但前提是用户在同一轮对话里明确提过名字
- 合并器是 O(N²) 的,每一对联系人的记忆集合都要比一遍,记忆到了 500+ 条就开始变慢
- PostgreSQL 自带的分词器对中文基本没用,全文索引碰上中文就是个摆设
- 并发提取有竞态条件,两个并行的提取任务可能同时给同一个人建出重复的联系人记录
可扩展性大概算一下。假设用户每天发 20 条消息,一年能攒下 600 条左右的记忆,三年就是 1800 条。O(N²) 的合并器还没到这个量就会吃力。这个还没解决,先记着。
本文也有 English version。