给 Mio 选语音方案,最后定了 Hume EVI
 声音承载情感色彩的概念插画
第一篇里讲了 Mio v2 的那次转向,把物理形象剥掉,只留人格,从一群变成一个,假人脸换成一团光球,人格从对话里长出来,不靠预写的角色卡。方向定了以后,下一件要解决的事就是声音。这东西得开口说话,而且说出来得带感情。这篇具体讲讲我们是怎么选方案的。
先说之前的状态。v0.1.0 的时候 Mio 就会说话了,用 Fish Audio 的 S1 模型给每个角色克隆声音,听着温暖又自然,成本也极低。什么时候发语音由 LLM 自己决定,一般是情绪浓的时候,安慰、撒娇、说晚安这种。模型在回复里打一个 [VOICE] 标记,后台就去触发 TTS。
这套体验本身是立得住的,用户能听到一个好像很在乎他们的声音。但用久了问题很明显,这个声音本身没有任何感情。Fish Audio 干的就是读字、出音频,它不知道这段文字是开心、难过、讽刺还是心碎,所以每条消息的情绪基调都差不多,好听、中性、清晰。Mio 说「太替你高兴了!」和「真的很心疼你」,听起来是一样的。文字聊天里情绪平淡一点还能忍,一个会开口说话的东西就不行了。
TTS 为什么念不出感情
传统 TTS 是条流水线,文字进去,音频出来。你想要感情,就得自己标,写 SSML 标签、调 style 参数,或者明明白白写一句「这句用悲伤的语气念」。做有声书、导航播报,这就够用了。但一个每天要生成上千条消息的伴侣呢?每条消息都有自己的情感语境,你不可能一条一条去标,TTS 系统自己又完全不懂语境。
2025 到 2026 年,这块有个挺重要的变化,有几家开始把情绪推断直接做进模型里。TTS 会先弄懂这段文字在讲什么,再决定怎么念。做得最突出的两家正好互补,一家做中文,一家做英文。
中文:豆包 TTS 2.0
字节(火山引擎)的豆包 TTS 2.0,升级的地方就是从「读字」变成「理解了再表达」。它拿大模型去分析对话的 context,自己推断该用什么情感、语调和节奏,不用你手动标。他们在技术上管这个叫「3D 情绪空间」,分强度、语义适配、生理特征三个维度,是用 2000 小时专业配音数据训出来的。实际用起来,你把「别担心,有我在呢」送进去,出来的语音真的是在安慰人,更柔、更暖,节奏微微放慢,你什么都不用指定。想精细控制也可以,比如「这句要压着哭腔说」,但这是可选的,中文场景下 90% 以上的情况自动推断都能处理好。
英文:Hume AI Octave
Hume 的 Octave 从另一个角度解决同一个问题。它没走「拿标注好情感的语音数据去训练」那条路,直接建在一个真会「读」文本的 LLM 上,反讽、双关、情绪转折、言外之意它都懂。所以它更像一个有功力的配音演员,先理解再念,不会先跑一遍情感分析,再套到几个预设情绪上。差别在细微的地方。「Sure, I'd love to」这句话可以是热情也可以是讽刺,全看 context。Octave 能判断对,因为它理解的是整段对话,不是孤立的一句。
这两家都是非实时 TTS,文字进,音频出,延迟大概 200ms,正好能接在 v0.1-0.2 的语音消息模式上,伴侣先生成文字,再把它说出来。STT 那边没什么可换的,gpt-4o-mini-transcribe 从 v1 一直用到现在,准、快、便宜,早就集成好了。
从语音消息到实时对话
语音消息只是个过渡。情感 AI 伴侣最后肯定要走到实时语音对话,你说,它听,它回应,可以打断,可以接话,整体流畅得接近跟真人打电话。这是 v1.0 的目标,架构上的决定也是从这里开始真正变难的。
最朴素的做法是把现有的东西串起来。STT 把你的语音转成文字,服务器查记忆、拼 context,LLM 生成回复,TTS 再转回音频。四步串着跑,延迟叠起来就是 1-3 秒。文字聊天里 1-3 秒没什么感觉,但口语对话里沉默 3 秒是很难受的。而且这条流水线还有几个问题压根没碰。一个是轮次检测,怎么知道你说完了没有;一个是打断处理,它回到一半你插话进来怎么办;还有情绪感知,你语气里带的信息,转成纯文字以后就全丢了。所以实时语音平台我们认真评估了三个,比下来结论挺清楚的。
三方对比
| 维度 | Hume EVI 3 | OpenAI Realtime API | 豆包 Realtime |
|---|---|---|---|
| 自定义 LLM | 支持——gemini、claude、任意 | 不支持——只能用 gpt | 不支持——只能用豆包大模型 |
| 语音情感表达 | 业界最强,一等公民 | 弱——官方称"future improvement" | 好——3D 情绪空间 |
| 用户情绪识别 | 支持——从语调分析 | 有限 | 支持 |
| System prompt / context 注入 | 完全支持 | 支持 | 不支持——黑盒 |
| 工具调用 | 支持——可调你的 API | 支持 | 不支持 |
| 打断处理 | 支持——基于语调轮次检测 | 支持 | 支持 |
| 延迟 | 约 500ms 首字节 | 约 300ms | 约 700ms |
| 价格 | 按分钟计费 (Pro) | 按分钟计费 (audio) | 待定 |
表格已经说了大半,但有一点得单独拎出来。OpenAI Realtime 和豆包 Realtime 有同一个致命问题,不能用你自己的 LLM。 OpenAI 锁死 gpt,豆包锁死自家大模型。做通用语音助手这无所谓,但对 Mio 来说这就是死局。
原因是这样的。Mio 跟别家拉开差距,全靠记忆、人格和情绪 context,这些东西存在我们服务器上,每次回复之前要塞进 LLM 的 context window。伴侣得知道你上周提过面试,最近一直挺焦虑,喜欢直说不喜欢绕弯子。有了这些 context,它才是「你的伴侣」,而不是「一个通用 AI」。所以我们的要求很硬,system prompt 和 LLM 本身都得完全攥在自己手里。
豆包这边我们专门验证了三件事,支不支持自定义 system prompt,能不能动态注入 context,能不能换外部 LLM。答案分别是不支持、有限支持(只能塞 RAG 风格的知识片段,做不了行为指令)、不支持。等于是一个说话很好听的黑盒,它只能是豆包,成不了你的伴侣。OpenAI Realtime 至少支持 system prompt,但锁死了 gpt,就用不了 gemini(Mio 靠它的性价比),也用不了 claude。而且语音情感表达在官方那边还是个「future improvement」。一个拿情感当卖点的产品,这个接受不了。
最后选了 Hume EVI 3
整个架构一句话就能讲清楚,LLM 决定说什么,Hume EVI 负责怎么说,有点像编剧和演员的分工。
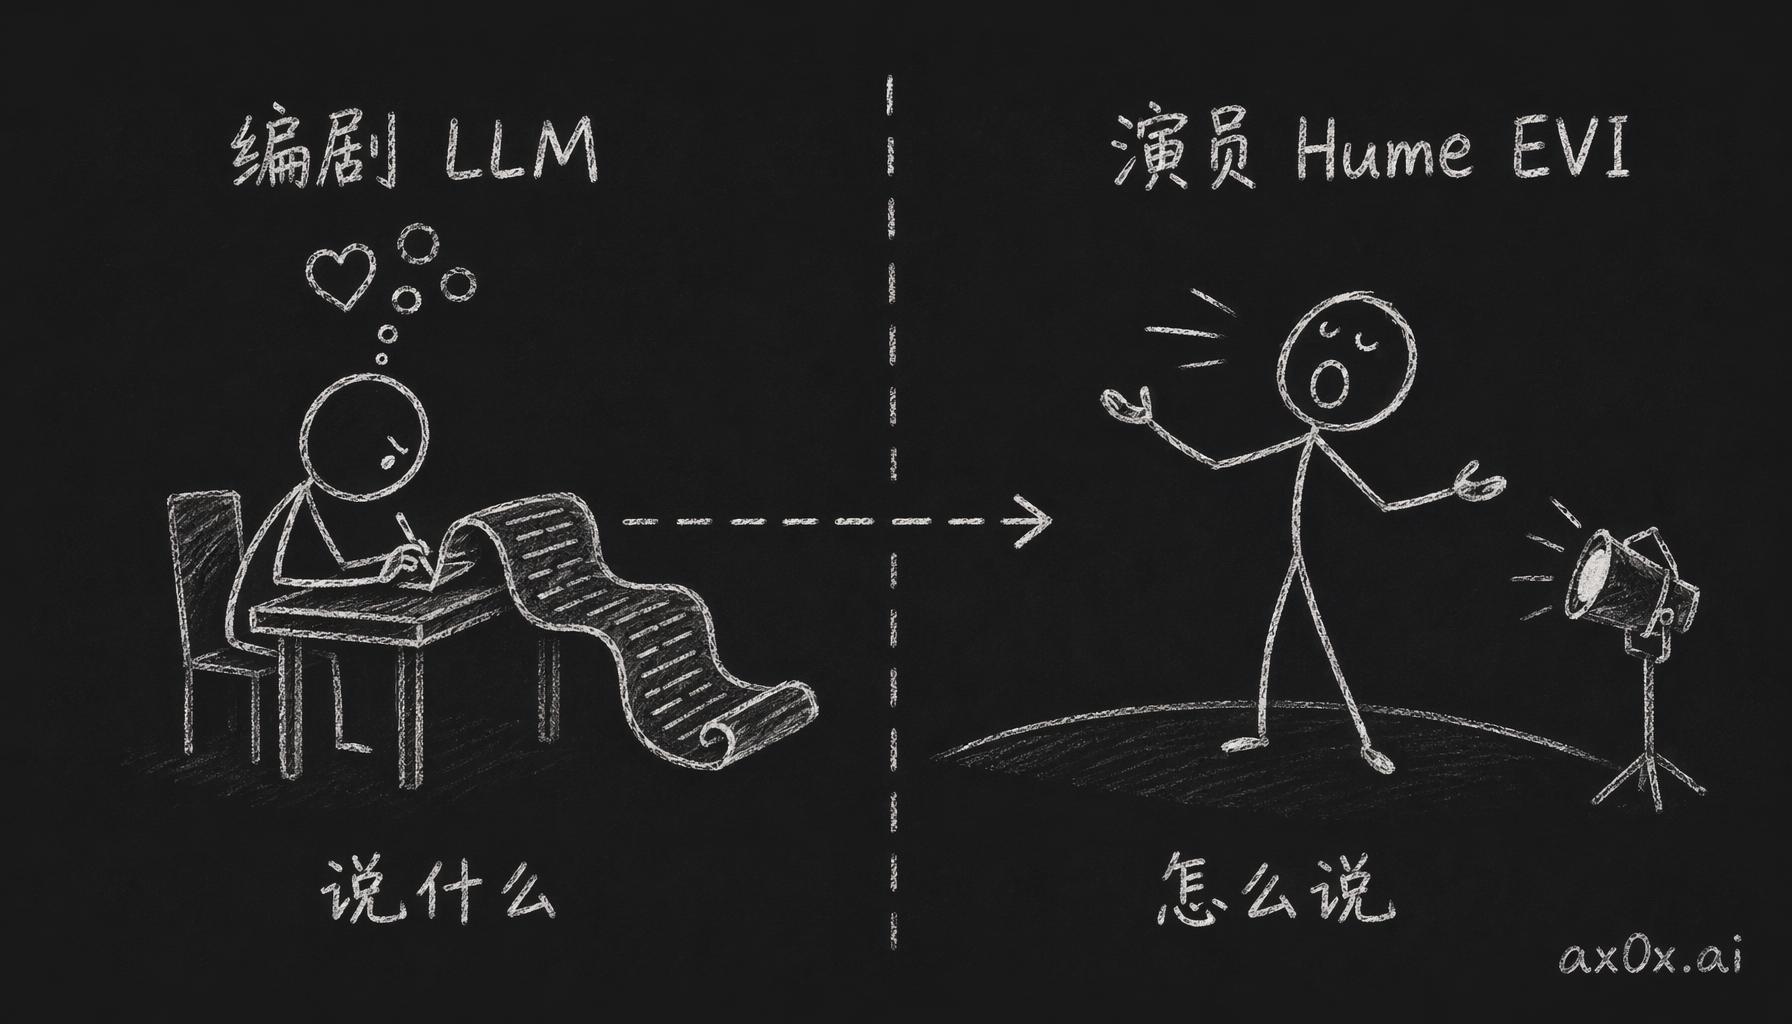 LLM 当编剧决定说什么、Hume EVI 当演员决定怎么说的分工架构
LLM 根据人格、记忆、情绪状态和对话历史生成回复文本。这个角色是谁,这一刻需要什么,它理解得最深。反正它不用管语音层的事,把内容写出来就行。表达层全归 Hume 管,听对方说话(STT 加情绪分析),判断对方什么时候说完(轮次检测),用对的情感语调把回复念出来(Octave TTS),再处理各种意外,比如被打断、被抢话、回复还没回来得先垫一句。一轮对话具体是这么跑的:
-
用户说话。Hume 同时干三件事:把语音转成文字;分析用户语调里的情绪(「听起来用户很焦虑」);判断用户说完了没有。它不是傻等静音超时,是从语调本身听出对话的节拍。
-
Hume 把结果送到我们服务器。我们拿到用户的文本和情绪分析,查记忆、拼 context、调 LLM(gemini 或 claude,随便换),再把回复文本返回去。
-
Hume 把回复说出来。Octave 自动配上对应的情绪合成语音,音频流式返回。
这里面最妙的设计是填充词。Hume 内置了一个叫 eLLM 的快速轻量模型,200ms 内先给一个即时反应,「嗯…」「哦!」这种,把等完整回复的那段空当填上,再无缝接到正式回复。用户感觉到的延迟几乎是零,对话里不会出现干等几秒的情况。你想想真人是怎么接话的,没有人沉默三秒然后突然讲出一段完整的话,都是先「嗯…」一下,边想边说。Hume 学的就是这个,正式回复还没生成完,先用一个即时反应把话接上。
用户:"我没拿到那个 offer。"
                                        [~150ms] Hume eLLM: "啊..."
                                        [~800ms] 你的 LLM 完成生成
                                        Hume: "...真的很遗憾。我知道你多在意
                                         这个机会。"
过渡是无缝的,用户听到的是一个连续的回应。开口很快,后面跟上的正式回复情绪也对,中间没有明显的空档。
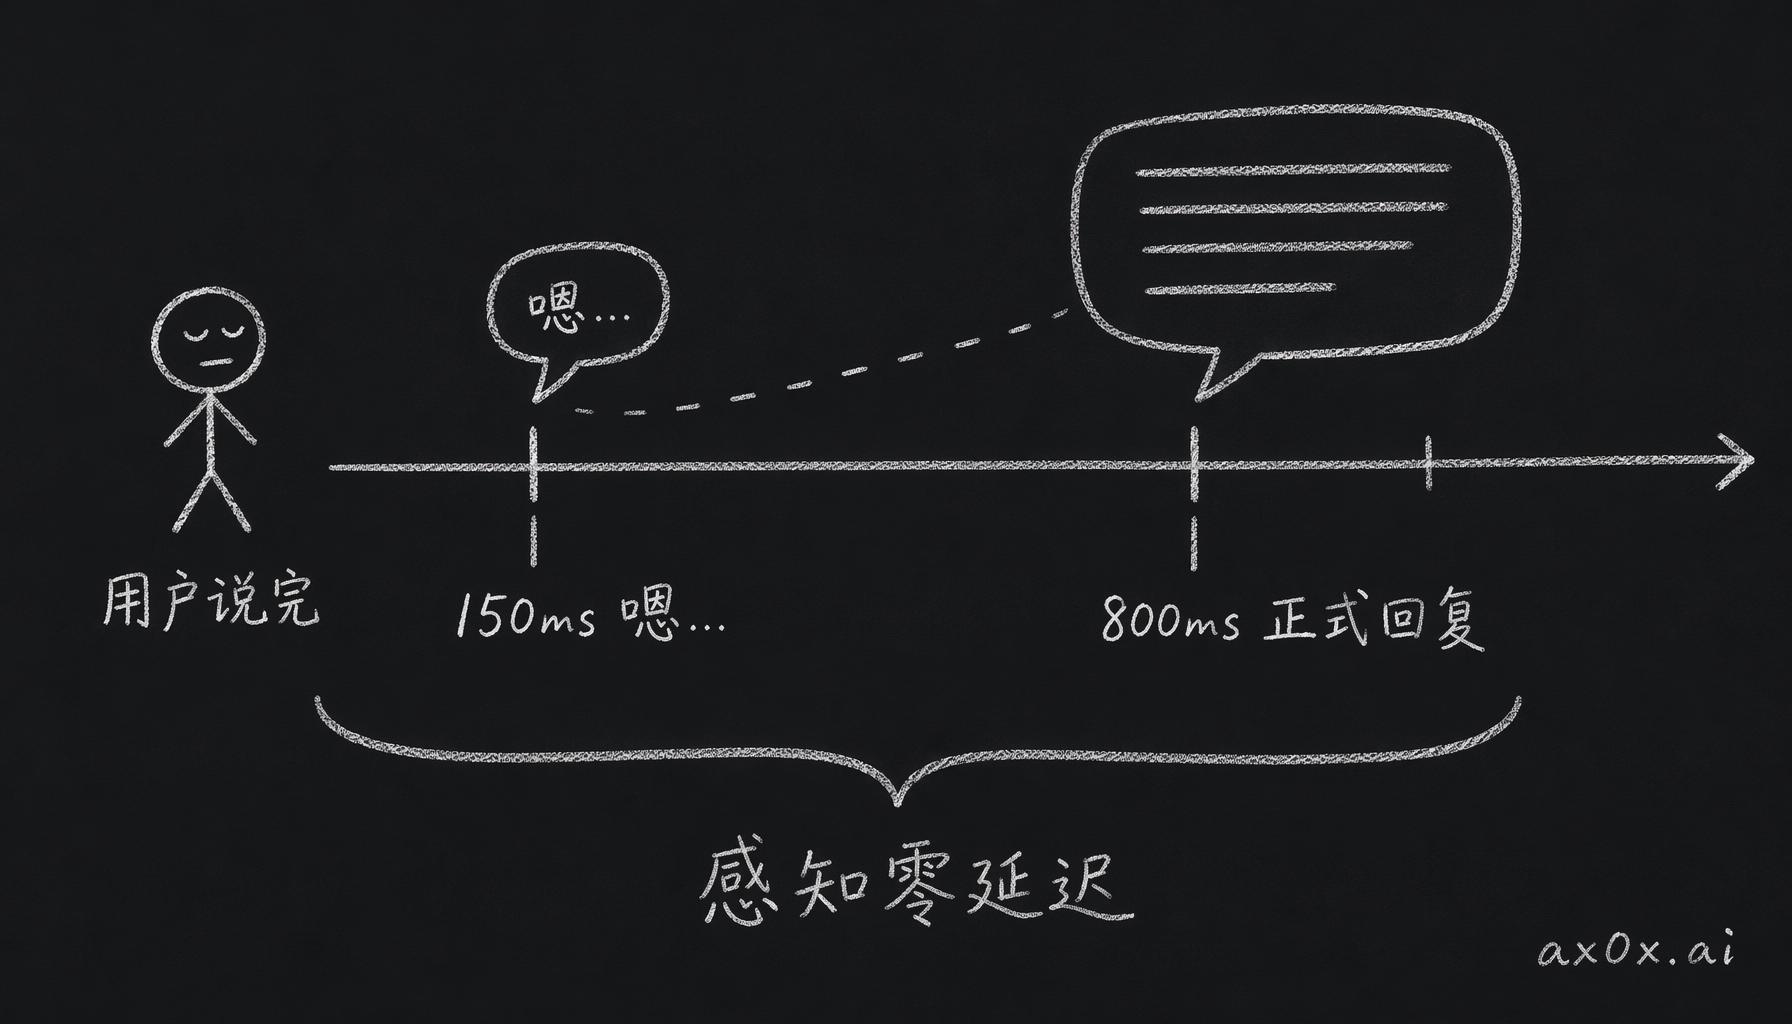 eLLM 在 150ms 内先垫一句嗯…、正式回复 800ms 才到,从而让用户感知零延迟的时序机制
这个分工好在哪
拆开以后,有几件事是一体化方案做不到的。第一是关注点分离。LLM 专心做推理、记忆检索、人格一致性这些内容上的事,Hume 专心做听和说,管表达上的情感和轮次,两边都不用什么都会。
第二,供应商随便换。更好的 LLM 出来了(隔几个月就来一个),换掉 LLM 就行,语音层不用动;Hume 把 Octave 音质升级了,LLM 这边一行都不用改。每一层各自往前走。
第三,情绪成了一等信号。Hume 分析用户的语调,能拿到纯文字系统拿不到的信息,比如用户嘴上说「我没事」,语气可不是这么说的。这个信号再喂回情绪引擎,伴侣对用户状态的理解就丰富很多,这是纯文字分析永远做不到的。
第四,处理延迟的方式合乎人的心理。人不会觉得沉默是「它在快速思考」,只会觉得断线了。一个很快的「嗯…」后面跟一段有分量的回应,比沉默 1.5 秒以后蹦出一个完美回答要好,感觉上更快,也更自然。
实时语音的成本
再说成本,这个躲不掉。实时语音 API 按分钟计费,钱涨得挺吓人。一个用户每天跟伴侣聊 10 分钟,对把 Mio 当日常陪伴的人来说真不算多,可光语音这一项,一个月的成本就超过整个订阅费了。这还没算聊天、记忆、STT 和主动消息。就算谈到更高量级的折扣,数字也好不到哪去。结论很直接,实时语音塞不进基础订阅,光一个重度语音用户的成本,就能把他付的钱花完。解决办法是分层:
| 档位 | 包含内容 |
|---|---|
| Pro | 文字聊天 + 语音消息 (TTS) + 全部功能 |
| Voice | Pro 全部 + 实时双向语音(高级定价) |
语音消息(非实时 TTS,豆包或 Octave)成本低到可以直接放进基础订阅;实时语音的成本结构完全不一样,得单独定价。这也是要分阶段做的原因。v0.1-0.2 先上语音消息,它便宜,已经验证过,换了新 TTS 以后情感表现力提升很大,用户先拿到一个说话带感情的伴侣。v1.0 再把实时语音做成高级升级,给想要完整对话体验的用户。
分阶段计划
v0.1-0.2:语音消息(非实时)
- 中文 TTS:豆包 2.0,能自动推断情绪,中文韵律最好
- 英文 TTS:Hume Octave,靠 LLM 理解情绪,能处理微妙的语境
- STT:gpt-4o-mini-transcribe(从 v1 沿用)
- 两个 TTS 都支持自动推断情绪,不用手动写 SSML 标注
v1.0:实时双向语音
- 中英双语都用 Hume EVI 3
- 自定义 LLM(gemini/claude)当"大脑"
- Hume 负责听、情绪分析、轮次管理、情感语音合成
- 用填充词做到感知上的零延迟
- Voice 档单独定价
v1.x:评估与优化
- 如果 Hume 的中文不够好,中文就退回自己拼的流水线:gpt-4o-mini-transcribe → gemini → 豆包 TTS 2.0
- 如果够好,中英双语就都用 Hume EVI
为什么不等大厂的方案
第一篇里说过一个判断,大厂不会做深度情感伴侣,因为品牌风险摆在那。到语音这层,这个判断照样成立。OpenAI 有 Advanced Voice Mode,技术真的很强,但它永远不会让你接自己的 LLM、注入自己的记忆系统、定制情感人格,那个声音是他们的声音。Google 的 Gemini Live 也一样。这些都是为了完成任务优化的通用语音接口,设计的时候就没冲着情感连接去。
这样拆开以后,Mio 的声音才真正是它自己的。内容从它的人格和记忆里来,语气跟着当下的对话和情绪 context 走。一个能记住你的伴侣,已经超过市面上大部分产品了。再加上带感情的语音,成本和复杂度也确实都上去了,值不值得,接下来几个月开发跑一跑就知道。
This post is also available in English.