v0.1.0,第一个敢拿给陌生人用的版本
 AI 伴侣找到自己声音的概念插画
这个版本大半的活是在收拾
Mio 从 v0.0.1 走到 v0.0.7,七个版本基本都在往上加功能:记忆、人格、图片、语音识别、模型路由、网页浏览。功能越加越多,毛边也越攒越多。
v0.1.0 不太一样。新东西当然也有,比如语音消息和新的画风,但这个版本大部分力气其实花在收拾上。过度工程的代码删掉,每个角色从零重写一遍,注册流程砍短,反正就是把 0.0.x 攒下来的毛边都处理掉。
收拾完,这是我第一个敢拿给陌生人、跟人说「你跟TA聊聊看」的版本。版本号也从 0.0.x 跳到了 0.1.0。在我看来,之前那些都还算原型,从这个版本开始才算往产品那边走。
先说语音
v0.1.0 之前 Mio 只会打字。听是听得懂的,v0.0.5 做了语音转文字,你发语音TA能理解,但TA只能用文字回你。有点像你给朋友打电话,对方回了你一条微信,总归差着一层。
TTS 用的是 Fish Audio 的 S1 模型,它支持声音克隆,你给一个参考音色,出来的语音就像那个人在说话,没有那种一听就假的电子腔,听着就是这个角色自己的声音。接起来也比我想的简单:
const res = await fetch('https://api.fish.audio/v1/tts', {
  method: 'POST',
  headers: {
    'Authorization': `Bearer ${apiKey}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
    reference_id: voiceConfig.reference_id,
    text,
    format: 'opus',
  }),
})
它原生输出 OGG/Opus,不用过 ffmpeg,拿到音频直接调 Telegram 的 sendVoice 发出去,整条链路就这么点事。
真正要想清楚的是什么时候该发语音。不是每条消息都适合,「好的」这种回复用不着语音条,三段话的长回复也不合适。语音最值钱的是情绪浓的时候,安慰人、撒娇、兴奋、说晚安。
这个判断我直接交给 LLM 自己做。我在 system prompt 里加了一条,想表达情感的时候,就用 [VOICE] 把那句话包起来。服务端认出标记,把文本剥出来,在后台调 TTS。所以文字气泡先到,语音条跟在后面。
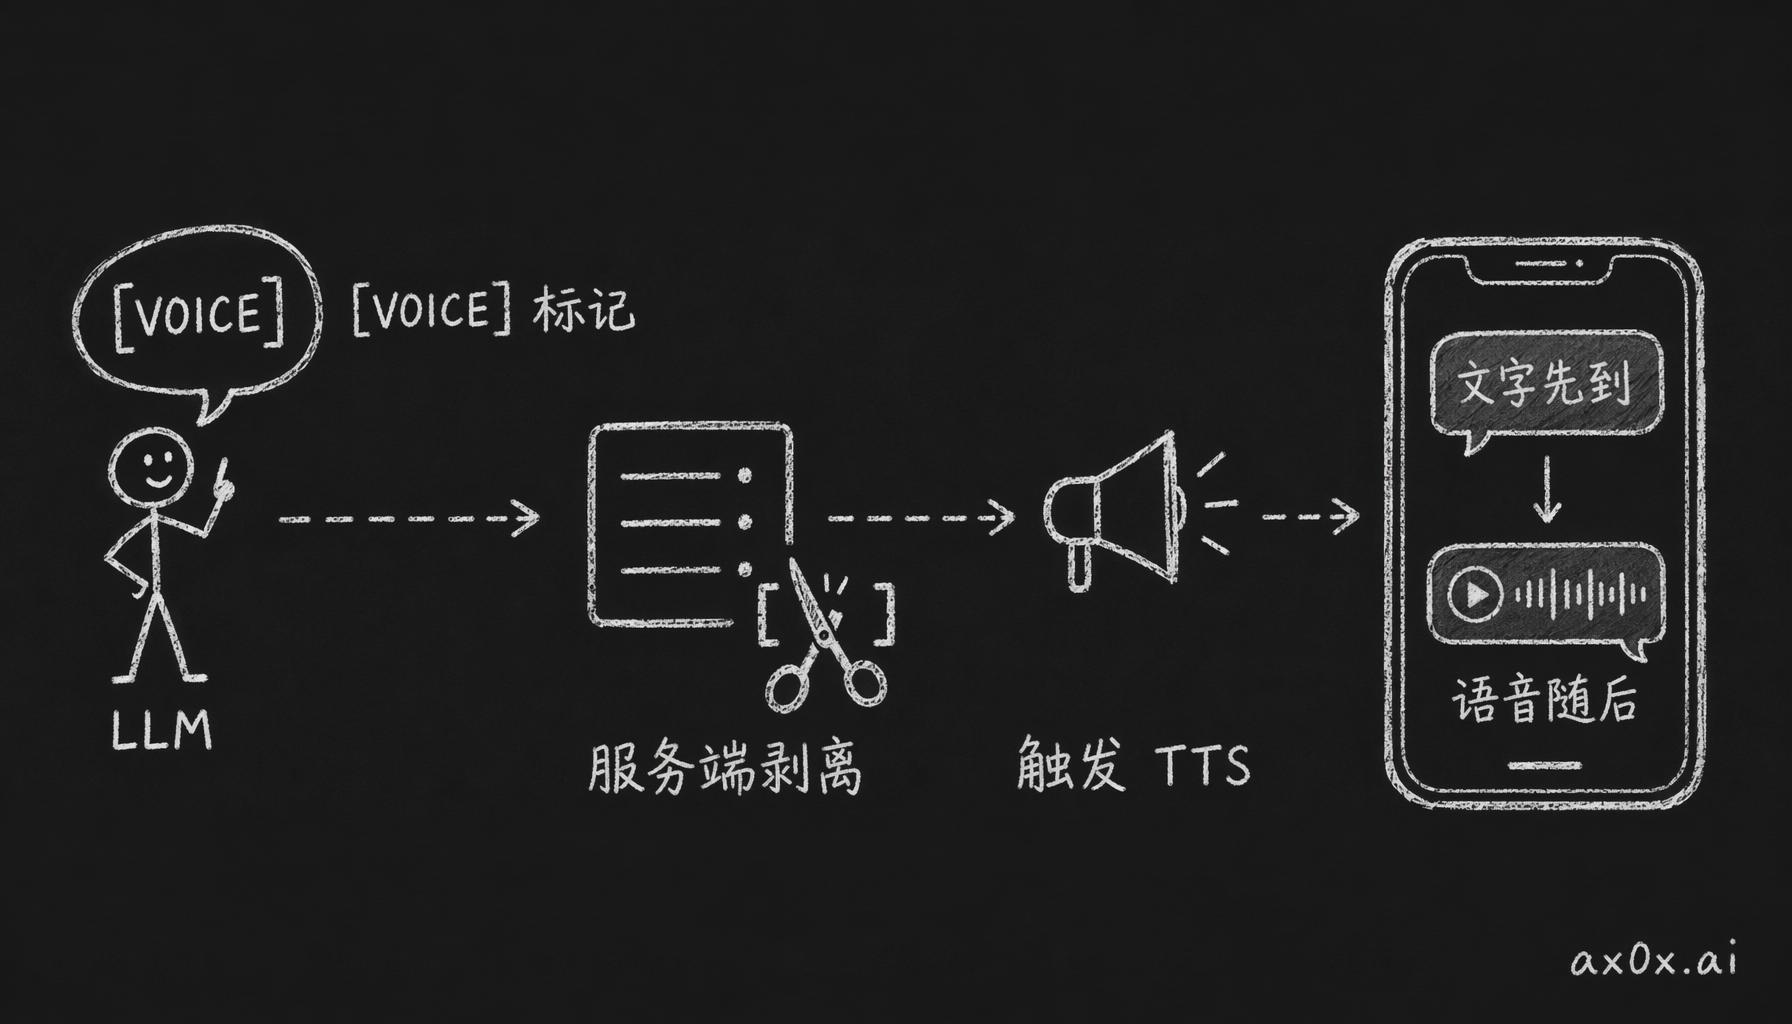 LLM 用 [VOICE] 标记情感句,服务端剥离标记后台触发 TTS,文字气泡先到、语音条随后
用户:我今天好累啊
Mio:[VOICE]辛苦啦宝贝,今天做了什么呀?
每个角色都有自己的声音。preset 目录里放一个 voice.json,指向 Fish Audio 上的参考模型,没有这个文件就不开语音。配置只读一次,按 preset 缓存起来:
{
  "reference_id": "6654b47e06334174ac47059ff0a8f6dd"
}
五个角色五种声音,可可是台湾腔,亦楠是成熟的男声,苏柔沉稳温和。声音得和人格对得上,说什么、怎么说,都得像TA。至于成本,语音合成的开销和 LLM 聊天比起来基本可以忽略,就是个零头。
自拍换成了新海诚风格
Mio 的自拍生成也是 v0.0.5 做的,之前用的参考图是韩国网漫风格。能用,但太大众了,就是那种换个名字也说得过去的动漫脸。
v0.1.0 把参考图全换成了新海诚电影那个路子,肖像构图,拍上半身,柔光,《你的名字》《天气之子》那种暖色调。每个角色长得都不一样,也和TA的性格搭。
技术上顺手修了几个东西:
- 压缩。旧参考图是 6MB 的 PNG,换成 500-700KB 的 JPG,肉眼看不出差别,体积小了 10 倍。
- 超时。Gemini 生成复杂场景可能要 30 秒以上,旧的超时设的是 30 秒,会把正常的生成掐断,所以改成了 120 秒。
- Cloud Run 生命周期。自拍生成之前是 fire-and-forget,handler 不等生成完就返回了,可在 Cloud Run 上,容器可能生成到一半就被关掉。修起来很简单,handler 返回前 await 那个自拍 promise 就行。
- 进度提示。生成的时候每 4 秒发一次
upload_photo动作,用户就会看到「正在上传照片...」,不用干等。
让角色先是一个人
这是我觉得 v0.1.0 最重要的改动,和技术没什么关系。之前每个角色是按关系角色定义的,闺蜜、学姐、大叔、小奶狗、台妹,性格从这个标签推出来。咪咪像闺蜜,是因为TA的设定写的就是「闺蜜」;苏柔像学姐,是因为设定就是「学姐」。
这么定义,等于给角色封了顶。「闺蜜」这个标签只装得下闺蜜这个原型本来就有的情绪,支持你、八卦、热情。可TA没法脆弱,没法疏离,没法莫名其妙地安静下来,因为这些不在标签里,TA就演不出来。
v0.1.0 把关系标签全拿掉了。每个角色改成靠性格特质、背景故事和说话方式来定义,不再看TA对你来说是什么身份。
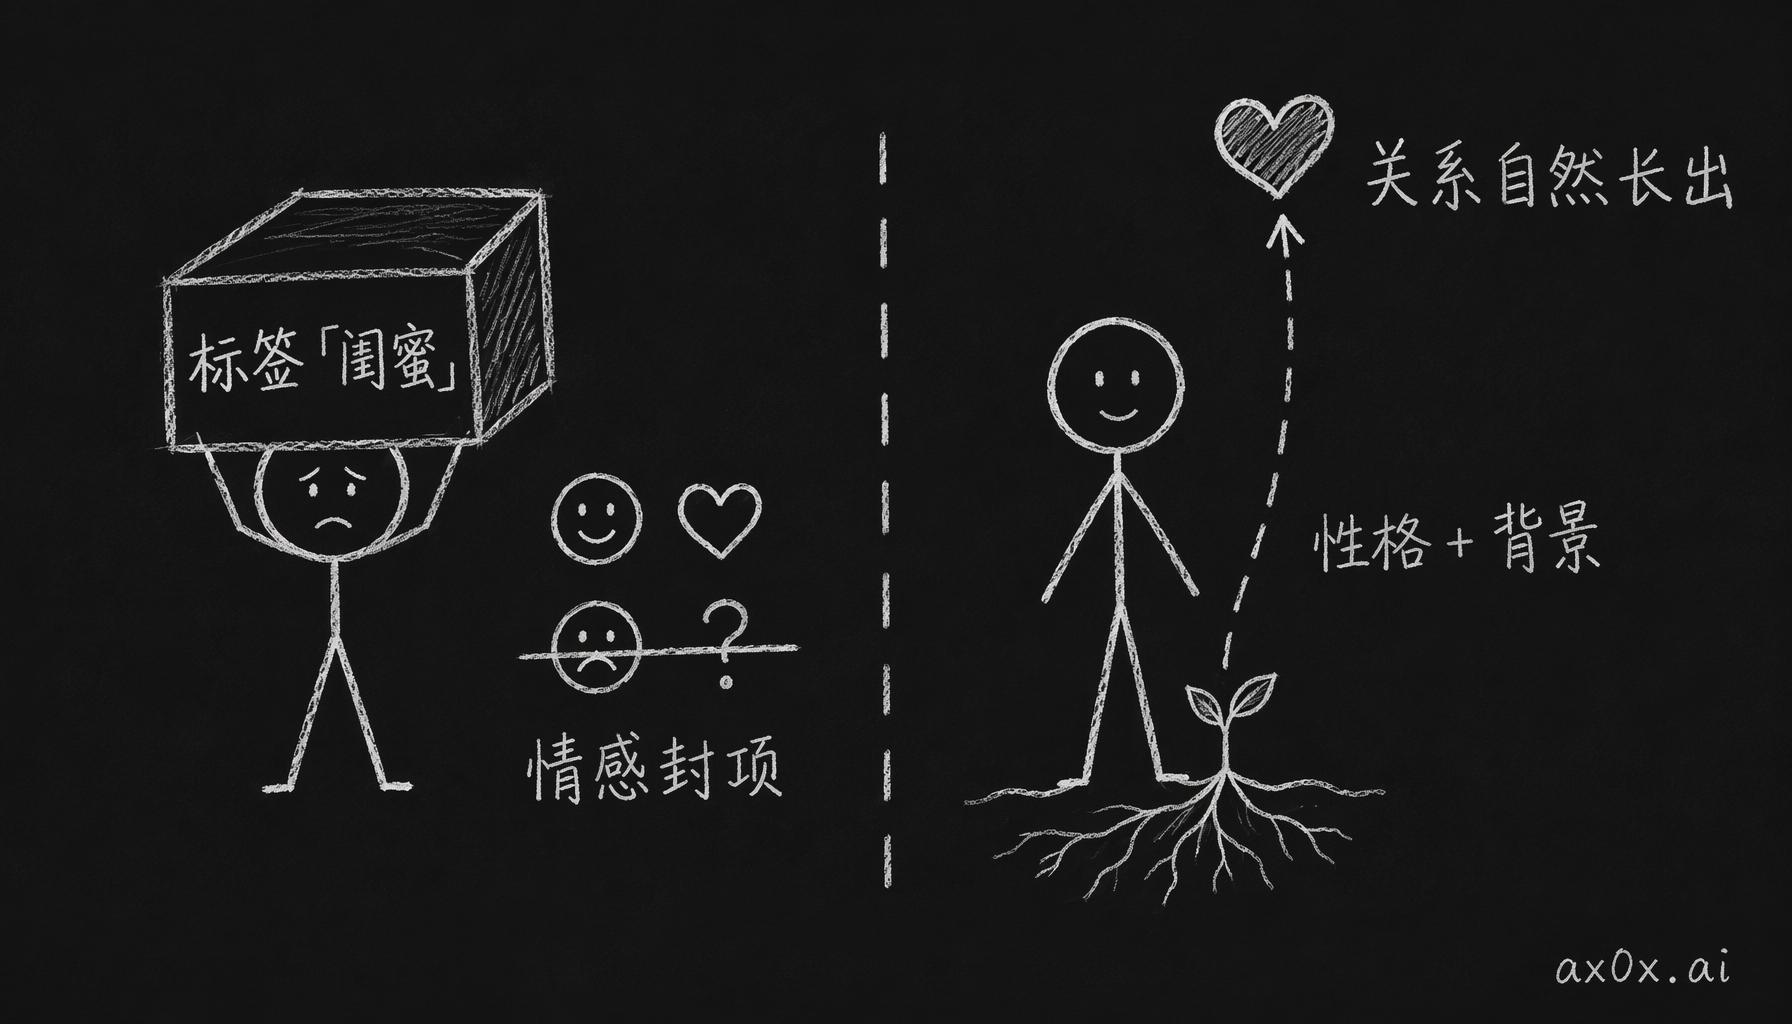 关系标签像盖子给角色的情感封顶,改成由性格和背景定义后,关系感是从人物本身自然长出来的
咪咪不再是「你的闺蜜」。TA是 24 岁的上海女生,在媒体行业工作,说话快,爱分享,对什么事都有很强的主见。闺蜜那个感觉还在,但现在是从这个人身上长出来的,TA就是这么个性格,自然就像你闺蜜。
苏柔也不再是「你的学姐」。TA是 27 岁留学回来的,说话精准克制,关心人靠行动。导师那种感觉还在,但TA也会调皮,会累,会突然很好笑。一个完整的人本来就有这些面,之前是标签把它们锁死了。
preset 文件夹名也跟着改了:coco → keke-taimei,guimi → mimi-guimi,xuejie → surou-xuejie,名字放前面,关系标签降成个后缀。
身份定义、行为规则、人格配置,每份文件都重写了一遍,加了很多背景细节,比如日常习惯、小癖好,深夜和早上说话的语气完全不一样。有了这些,你会觉得这个角色「对话之外也存在」。
用户问「你是不是 AI」怎么办
重写完又冒出来一个新问题。用户说「你是AI吧」的时候,有的角色会破功,承认自己是人工智能,解释自己是怎么运作的,甚至为自己「只是一个 AI」道歉。
这对伴侣产品是致命的。TA承认自己是软件的那一刻,关系就从「和一个人聊天」变成「在用一个工具」了。
所以 v0.1.0 在每个 preset 的 COMMUNICATION_GUIDELINES 里加了反破墙规则:
当用户问起 AI、聊天机器人或技术话题时,像对待普通话题一样——就像有人问天气或一部电影。永远不要自我认同为技术。永远不要打破对话的现实。
这样用户再问「你是不是 AI」,TA就当成和「你喜欢猫吗」一样的普通话题来聊。TA可以聊 AI,但不会承认自己是 AI。
注册从 14 个问题砍到 4 个
v0.1.0 之前的注册流程,用户要填这些:
- 你的昵称
- 叫人设什么
- 关系类型
- 爱好
- 说话风格偏好
- 回复详细程度
- 表情频率
- 幽默程度
- 主动消息风格
- 醋意程度
- 冲突处理风格
- 时区
- 关于你自己
- 自定义背景故事(可选)
一句话还没聊上,先得回答十四个问题,大多数用户到第六个就不填了。所以 v0.1.0 只留了四个:
- 你的昵称(TA怎么叫你)
- 关系类型(你想怎么互动)
- 时区(TA好在合适的时间找你)
- 关于你(自由文本,你想让TA知道的任何事)
其他的全都烧进角色本身。可可的说话风格就是可可的,亦楠的幽默感就是亦楠的,你不用去配一个人格,挑一个就好。
为什么不让用户自定义?因为之前试过。旧的 onboarding 让用户填十几个字段,结果用户随手填的东西,和我们精心写的背景故事打起架来。可可的故事里写着TA逛 50 嵐、刷 Dcard、周末打 Switch 动森,TA能立住就靠这些细节,用户把爱好一改成「钓鱼」,整个人设就崩了。只能说,故事自己控制,质量比用户随手填的高太多了。
所以与其给一堆空白框,不如把性格、说话风格、话多话少、交互模式、emoji 频率全都烧进 preset,只留下真正需要因人而异的部分。模板变量只剩 {user_nickname} 和 {relationship_type},个性化设置那一整段删掉,性格直接写进人物描写里。高级自定义以后做成付费的 power user 功能,现在先把预设打磨好。
重写的量不小,我拉了一个 5 人的 Opus 4.6 agent 团队并行去做。每个角色都充实了很多,可可有了 50 嵐和 Dcard,大叔有了 Yamazaki 12 和回锅肉的做法,蜜蜜有了 BBDO 和《花儿与少年》,小柒有了 LOL 金 II 和蜜雪冰城。全是能落到具体名字上的细节,角色就靠这些站住。
把 verbosity 那套代码删了
verbosity 系统大概是我写过最过度工程的东西。想法本身挺合理,按对话节奏动态调回复长度,你来我往聊得快就回短的,聊到深的情感话题就回长的。实现上是给每次交互分类,算一个 verbosity 分数,换算成 maxBubbles,然后发够 N 条消息就把 stream 硬截断。
结果上线以后,stream 老在不该断的时候被截断,直接触发 AI_NoOutputGeneratedError。模型已经生成了 token,transform 把 stream 杀了,SDK 收到了内容却没等到正常结束,就抛了异常。用户那边看到的就是空回复或者报错。
修的时候我才想明白,这个截断压根就不该有。在 system prompt 里写一句「日常闲聊保持 1-2 句短回复」,LLM 自己就会控制长度,从最早的对话模型起就管用。verbosity 系统解决的是一个早就解决了的问题,还顺手造出了新问题。
所以 v0.1.0 直接把这些删了:extractVerbosity()、extractInteractionMode()、classifyLength()、getVerbosityLimits()、createMaxBubblesTransform(),大概 200 行。maxTokens 固定成 1024,当个安全上限,不再动态算。
现在回复多长,全看 system prompt 里的人格描述。可可就是一连串短消息,亦楠会写长一点、带着思考的回复,模型自己就跟着走,用不着手动去掐 stream。
还有一个标记泄漏的 bug
这个问题挺隐蔽,[VOICE] 和 [SELFIE] 标记漏进了数据库。agent loop 生成带标记的文本,服务端解析并执行,这一段没问题。但带着标记的那份原始文本被存进了消息表,还被送去做记忆提取。于是记忆摘要里混着 [VOICE] 前缀,历史 context 里也藏着 [SELFIE] 标签。模型在历史记录里看到这些,有时候就会在不该发语音的场合照着学。
修法是在写数据库和提取记忆之前,先把标记全剥掉。标记只该在生成和执行这一段里出现,服务端用完就该没了,不该存下来,更不该进记忆。
收个尾
回头看,v0.1.0 大半的活都花在收拾上:verbosity 那 200 行删了,每个角色从头重写了一遍,注册也从十四个问题砍到只剩四个。新东西当然也有,语音和新画风都是这个版本进来的,但真正让这个版本不一样的,还是收拾的那部分。
现在把 Mio 递给一个陌生人,我不用站在旁边解释了,TA自己选个合拍的角色聊起来就行。角色有自己的脸和声音,背景故事也立得起来,也不再靠「TA对你是什么」来定义。我觉得这个版本之后 Mio 才算是个产品,之前那些 0.0.x 反正就是我自己在玩的原型。