web 端也能收到语音和自拍了
 跨平台功能对齐的概念插画
v0.1.0 给 Mio 加了语音,但只有 telegram 用户能听到。web 端还是只有文字,Fish Audio 生成的语音、Gemini 画的自拍,到了 web 端全被悄悄吞掉了。前端压根不知道拿它们怎么办,服务端生成了也是白生成。
v0.1.1 主要就是把两边补齐,现在语音和自拍在所有平台上都有了。顺手还干了几件别的事,注册流程重排了一遍,加了个成本看板,还上了个 pg_cron 任务,免得数据库无限涨下去。下面挨个讲。
把媒体塞进 SSE
服务端其实早就在生成语音和自拍了。telegram bot 收到的是二进制附件,web 端却什么都收不到,因为 SSE 流里只有文本 token,媒体走的是一条只有 telegram 能用的旁路。所以修起来也很直接,让媒体在 SSE 里也当一等公民,加两个事件类型:
event: voice
data: {"url": "https://storage.googleapis.com/.../voice-abc123.opus"}

event: selfie
data: {"url": "https://storage.googleapis.com/.../selfie-def456.jpg"}
服务端先把媒体传到云存储,再顺着传文本的那条 SSE 连接把 url 推下来。不用轮询,也不用单独调 API,客户端只是多听两种事件,改动很小。
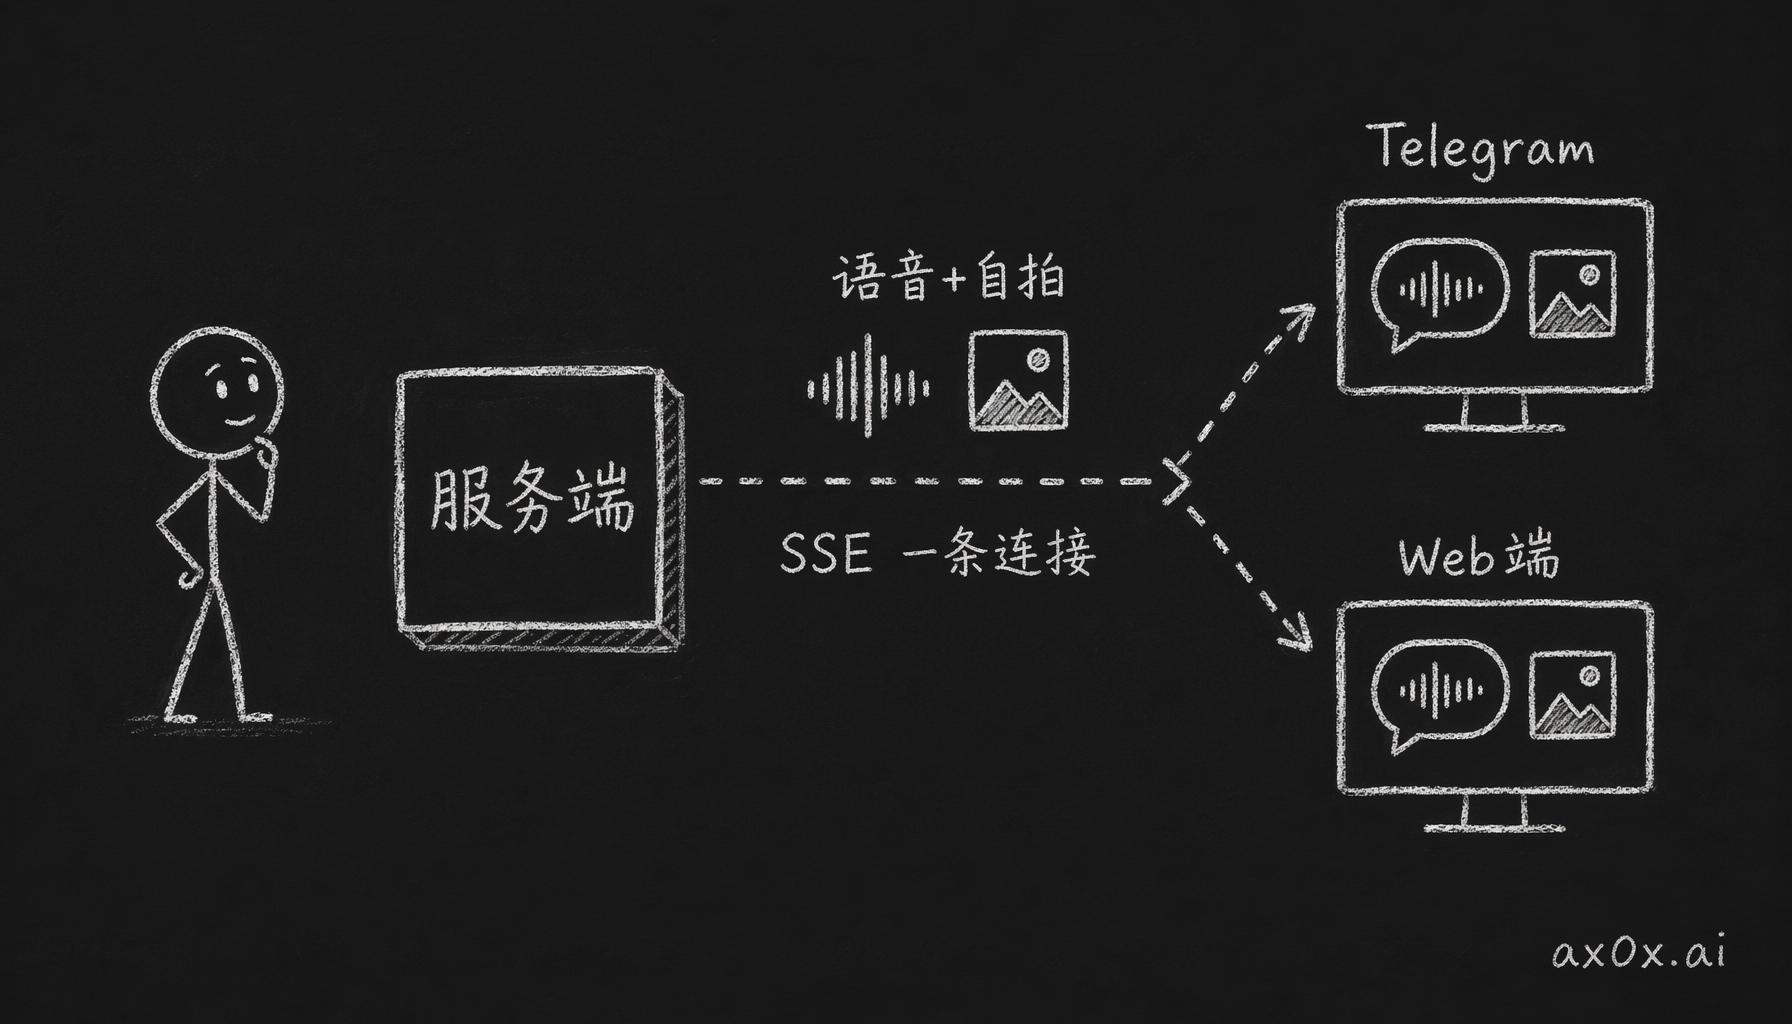 服务端把语音和自拍作为一等公民塞进同一条 SSE 连接,Telegram 和 Web 端因此都能收到,消除平台不对称。
前端这边,语音得做个专门的组件。我想做个中国用户一看就懂的,那就是微信的语音消息 UI,绿色气泡,一播放声波条就跳。VoicePlayer 渲染三根竖条,用 CSS keyframes 做动画,每根错开 100ms:
.bar {
  animation: pulse 0.6s ease-in-out infinite;
}
.bar:nth-child(2) { animation-delay: 0.1s; }
.bar:nth-child(3) { animation-delay: 0.2s; }
这个 UI 好在谁都不用学,微信里谁没见过一千遍。自拍就更简单了,直接在聊天流里内联渲染,跟 telegram 一样,不弹窗,也不加下载按钮,就是一张图出现在对话里,像有人给你发了张照片。
比收更麻烦的是在 web 端发送媒体。telegram 本身就支持传文件,输入框有个回形针图标,选完文件就完事了。web 端这套得从零做。我做的是分两步上传,用户选完文件,文件先变成一个预览条出现在输入框下面,缩略图上带个 X,可以删掉,点了发送才真的上传。这样用户能先确认一眼,不会发错。预览条就卡在输入框和发送按钮之间,看得到但不挡事。
注册再砍一个问题
v0.1.0 把注册从 14 个问题砍到 4 个,这个版本砍到 3 个,顺序也重排了。
之前是先问昵称,再问关系类型。听着好像说得通,先知道你是谁,再问你想怎么互动。但当时有件事没想到,昵称给哪些选项,其实应该看关系类型。选了情侣,建议的昵称就该是宝贝、老婆、亲爱的这类。选了好朋友,就该是同学、朋友,或者直接叫名字。毕竟朋友叫你宝贝很奇怪,伴侣叫你同学又太冷淡。
所以 v0.1.1 把顺序换过来了,先问关系类型,再问昵称,昵称的选项跟着你第一个回答变:
const options_map = {
  '情侣': ['宝贝', '老婆', '亲爱的', '老公'],
  '好朋友': ['同学', '朋友', '{name}'],
  '暧昧': ['小哥哥', '小姐姐', '{name}'],
}
实现上用的是 depends_on 加 options_map。每个注册步骤写明自己要看前面哪个答案,UI 照着渲染。没有写死的条件分支,全靠配置来驱动。
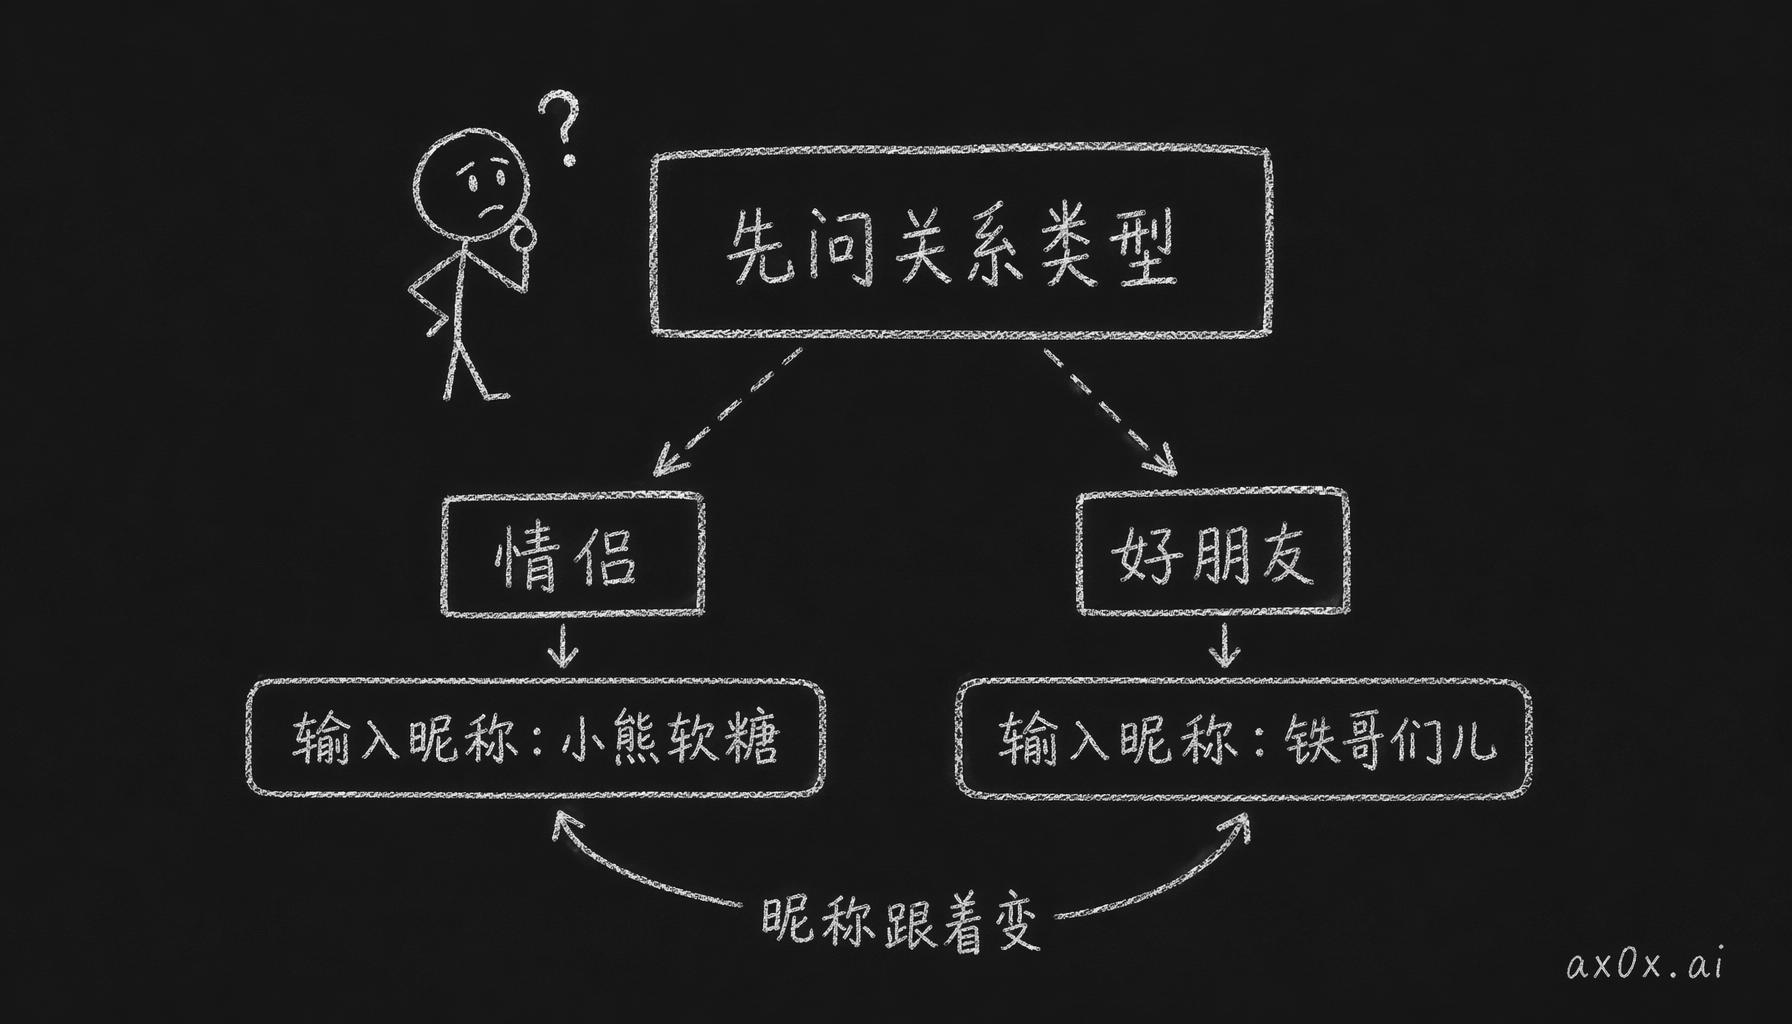 先问关系类型再问昵称,昵称选项由第一个答案动态决定,配置驱动而非硬编码分支。
时区那个问题直接删了。v0.1.0 里它还是第 3 问,但浏览器本来就知道用户在哪个时区,Intl.DateTimeFormat().resolvedOptions().timeZone 直接给你 Asia/Shanghai 或者 America/Los_Angeles,那还问什么呢。少问一个问题,信息一点没丢。
另外,整个流程的默认值都改成了性别中立的,默认昵称不预设性别,关系类型的标签也是包容的。改动不大,但不想被按男女二选一分类的用户,用起来会少很多别扭。
最后就剩三个问题,关系类型、昵称、关于你。一分钟以内就能开聊。
加了个成本看板
五个 AI 角色同时服务好几个用户,成本不盯着,就不知道钱花哪去了。哪个操作最烧钱?一天花多少?有没有用户在疯狂刷 API 额度?这些问题之前都答不上来。
v0.1.1 加了个只有管理员能看的成本看板,用的暗色主题,讲道理,仪表盘这种东西就该是暗的。一共四个面板。
- 概览:今天的总成本和历史累计花了多少,两个数字放在正中间。
- 分类明细:一张表,列出每种操作(TTS、自拍生成、LLM 推理、记忆提取)调了多少次、一共花了多少、平均一次多少钱。表一拉出来就发现,自拍生成一次的成本是 TTS 的 10 倍,后面要不要限流,心里就有数了。
- 最近交易:最近 20 条成本记录,新的在前,每行写着操作类型、用户、成本和时间戳。主要拿来抓异常,比如一个用户一小时生成 50 张自拍,一眼就能看出来。
- 每日成本图:每天花了多少钱的折线图。看趋势比看绝对值有用,跟着用户增长慢慢涨是正常的,要是突然冒出一根尖刺,要么是什么东西坏了,要么是有人在滥用。
所有成本查询都统一用 UTC,这也顺带修了个 bug。之前有的查询用本地时间,有的用 UTC,服务器时区跟查询时区一对不上,按天汇总出来的数就是错的。
30 天自动清消息
聊天记录是线性涨的,每个用户的每条消息都永久存着。原型阶段就 10 个用户,无所谓,真当产品做的话,这就是个定时炸弹。
但 Mio 的记忆系统本来就会把对话里重要的东西提出来,存成长期记忆条目。提完以后,原始消息基本就是多余的了,三周前的聊天记录用不着留,要点已经在记忆里了。所以 v0.1.1 加了个 pg_cron 任务,每天 UTC 凌晨 4 点跑:
SELECT cron.schedule(
  'delete-old-messages',
  '0 4 * * *',
  $$DELETE FROM messages WHERE created_at < NOW() - INTERVAL '30 days'$$
);
created_at 上有 B-tree 索引,所以删起来很快,不用扫全表,按索引找出那一段、批量删掉就行。
为什么定 30 天?大概就是两头取个平衡,LLM 随时拿得到近期的 context,数据库又不会无限涨。反正几天前的东西记忆系统都处理过了,原始消息留着也是留着。没做软删除,没做归档,也没往冷存储迁,就是直接删,因为重要的部分已经进记忆了,删了不心疼。
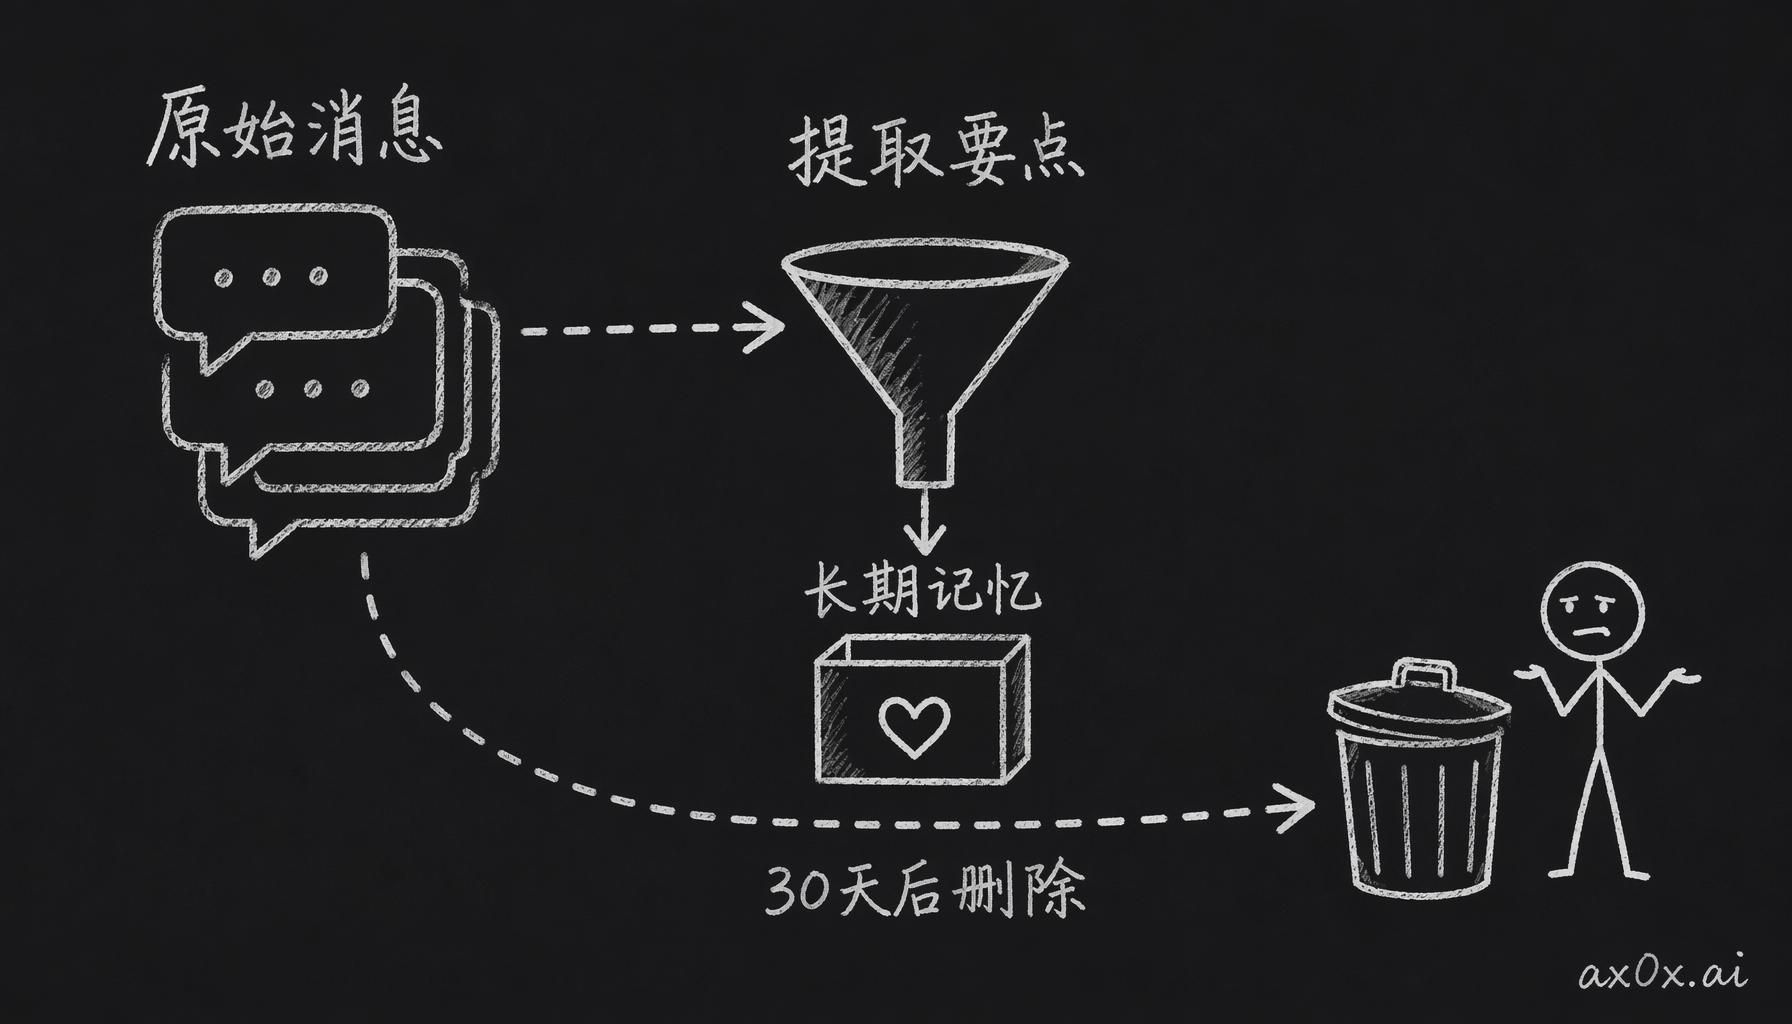 记忆系统先把对话要点提取进长期记忆,原始消息随之变冗余,所以 30 天后直接删除也不丢信息。
人设也调了两处
情侣关系支持:mimi-guimi 和 surou-xuejie 现在有了情侣关系专用的行为模式。之前选这两个角色当情侣,会觉得很泛,因为没有专门给恋爱场景写的规则,TA们默认就表现得像朋友。现在每个角色在恋爱场景里怎么回应都是单独定制的,怎么表达喜欢、吃醋、想念、说晚安,都分开写了。
keke-taimei 全面繁体化:可可的整套预设,包括身份定义文件、行为规则文件、人格配置文件和沟通准则,现在全部用繁体中文写。TA是台湾角色,就应该用繁体中文去思考,而不是简体写完再在表面转一下。差别全在用词上。軟體不是软件,訊息和消息、蠻好的和挺好的也是这种对子,用错一个,读起来就是大陆人在装台湾腔。
修了几个 bug
Discover 页面崩溃:这个页面是用来浏览可选人设的,一加载就崩,因为有个组件要的是数组,拿到的却是 undefined。先加了个防御性检查 personas ?? [],但根子上是 API 返回的结构变了,前端没跟着改。
AgentResponse 类型不匹配:agent 的返回类型在服务端和客户端两边慢慢不一样了,服务端返回 { text, voice?, selfie? },客户端要的是 { content, media? }。现在两边统一用一个共享类型。
VoicePlayer 清理:VoicePlayer 卸载的时候没清掉 Audio 对象,用户正在放语音的时候跳到别的页面,声音还会在后台接着放。现在在 useEffect 的 return 里加了清理函数。
这版做完之后
这版做完,web 端跟 telegram 基本就拉平了。一半用户在 web 端,总不能一直让他们用阉割版。版本号只从 0.1.0 走到 0.1.1,反正就是个补课的版本,先这样。