Mio 的关系不让选了,得自己处出来
 关系从陌生到亲密自然演化的概念插画
选关系这个设计一直不太对
v0.1.3 把防注入搞定之后,我开始想一个更根本的问题,关系到底该怎么来?之前的做法是 onboarding 的时候直接让用户选,好朋友、女朋友、闺蜜,选完 Mio 就按这个身份跟你聊。听起来挺合理,但用起来总感觉哪里不对。后来我想明白了,你刚注册,跟 TA 说了不到三句话,TA 就管你叫宝贝了,这就很假。它其实就是个角色扮演的快捷方式,跟视觉小说里选恋爱路线差不多,选完 NPC 下一秒就对你说情话。方便是方便,但一点都不真实。
所以 v0.1.4 把这个设计改掉了,关系不让你选,得自己处出来。现在每个角色都从「刚认识」开始,Mio 一开始会比较客气,跟你保持点距离。聊多了、熟了,TA 的语气会变,会开玩笑,也会跟你分享更多。到了暧昧阶段,TA 的表现又会有些细微的不一样。这些变化没有写死成剧本,是看你们实际怎么聊,一步步往前推的。
进化系统具体是这样跑的
进化的逻辑都在 evolution-processor.ts 里,每次对话做完记忆提取以后跑一遍。这里有个很重要的设计是 fire-and-forget,它不会卡住回复,用户完全感觉不到后台还有这么个东西在跑。流程大概分四步:
- 打分:用一个纯函数看这次对话的模式(亲密度、信任度、互动频率),算出关系分数的 delta
- 衰减:超过 2 天没聊,分数就会自己往下掉,这个检查放在主动消息的心跳里做。关系得经营,放着不管就会变淡
- 阶段解析:分数到了阈值就进到下一个阶段,刚认识 → 好朋友 → 暧昧 → 情侣
- 跳级验证:这一步加了一层 LLM 验证。光看分数不够,还得看聊的质量配不配得上这个阶段,连着刷「我爱你」是不会直接跳到情侣的
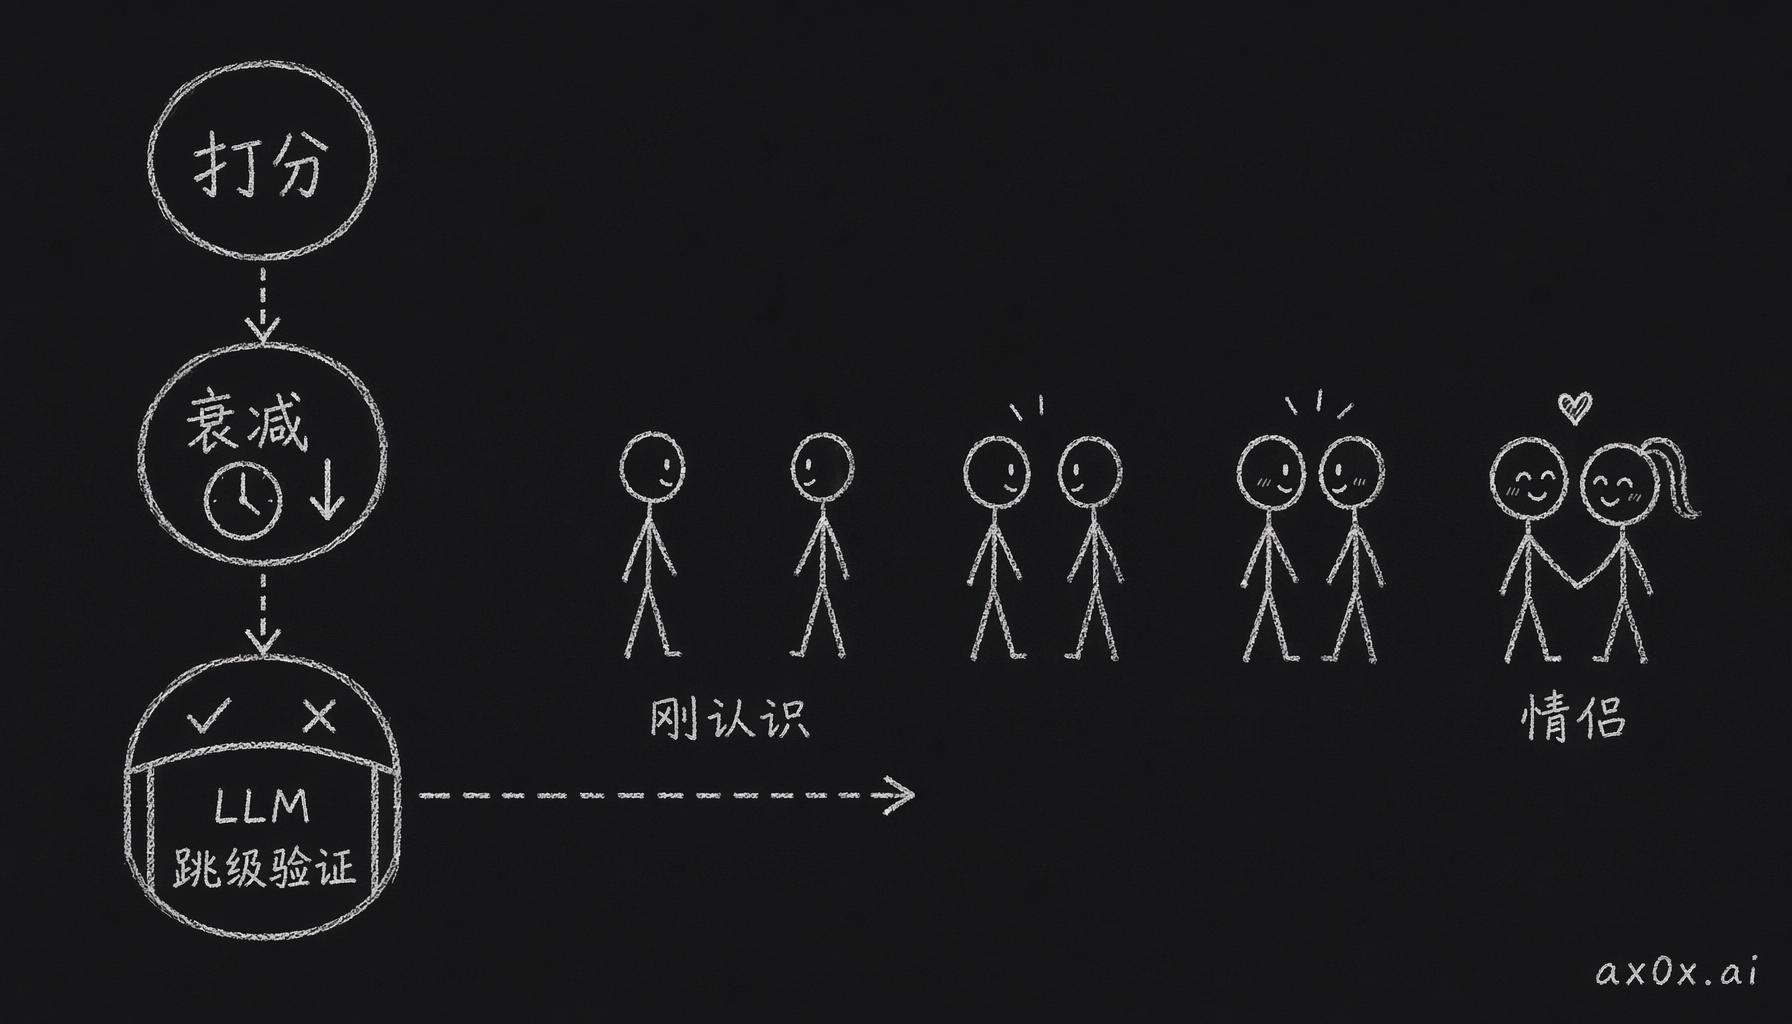 关系分数四步流水线(打分·衰减·阶段解析·LLM 跳级验证)如何驱动从刚认识到情侣的阶段跃迁
每个角色都有自己的性格演化配置,里面定了每个阶段的阈值和冷却时间。所以不同角色往前走的节奏可以完全不一样,有的慢热,有的很容易亲近。
关系阶段变了以后,RELATIONSHIP_DYNAMICS.md 会被注入 system prompt。这样 Mio 就知道自己跟你处到哪一步了,说话做事也跟着变,而且是一点一点、很自然地变。
记忆提取器也顺手升级了。除了 facts 和 episodes,它现在还会提取 relationship 类型的记忆。比如「TA 今天主动分享了心事」,这种信号会被记下来,拿去给关系打分。
Telegram 聊的,Web 也得知道
这个需求和关系进化是直接绑在一起的。如果你在 Telegram 上聊了很多,Web 端却看不到,那关系分数就算不准。
解决办法是 loadCrossSessionHistory(),用 inArray 把同一个 agent + user 在所有 session 里的消息都查出来。这样 LLM 看到的就远不止「这个平台上的对话」,你们在所有渠道聊过的东西它都能看到。如果 Web 端还没有 web session,就回退到随便哪个 session,Telegram 的也算,所以新用户在 Web 上也能看到之前在 Telegram 上的聊天记录。这次只改了查询层,schema 一点没动。
顺手把 system prompt 砍了 60%
做关系进化,system prompt 里就得再多塞一个 RELATIONSHIP_DYNAMICS.md。往里加东西之前,我先把它现在的样子查了一圈,发现它已经长到会让 Mio 的表现不够一致了,说它「有点长」都算说轻了。我又翻了一圈论文,有几个结论挺让我警醒的:
Lost in the Middle(Liu et al., TACL 2024):transformer 对输入的注意力分得不均匀,开头和结尾看得最多,到中间明显会松下来。一个 6000-10000 token 的人格配置文件,埋在中间的那些行为规则会被忽略得格外多。
Same Task, More Tokens(ACL 2024):system prompt 在 1500-3000 tokens 的时候,模型最能照着指令做,再长就开始掉,过了 5000 tokens 左右掉得更快。模型读得越多,挑着忽略的也越多。
Scaling Law in LLM Simulated Personality(arXiv 2025):人设写得越细,表现越一致,但有个拐点。过了这个点,多出来的细节反而会带进自相矛盾的地方,一致性又往下走。
还有一件事让问题更严重,就是中文的 token 税。中文一个字大概 1.5 tokens,英文一个字母才 0.25 左右。一个看着只有 3500「字」的人格配置文件,实际要吃掉 5000 多 tokens。Mio 的中文提示在 6000-10000 tokens,已经在行为退化区里陷得很深了。压缩前的数据是这样的:
| 人设 | 人格配置 tokens | 行为规则 tokens | 总计 |
|---|---|---|---|
| 可可 | ~4,400 | ~1,700 | ~6,100 |
| 蜜蜜 | ~6,500 | ~2,100 | ~8,600 |
| 苏柔 | ~6,200 | ~1,750 | ~7,950 |
| 小柒 | ~6,700 | ~1,750 | ~8,450 |
| 陈哥 | ~8,400 | ~1,700 | ~10,100 |
这还要再加上 system-prompt.ts 自己的约 2500 tokens(聊天原则、身份保护、自拍/语音指令)。所以每次对话光 system prompt 就有 9000-13000 tokens,对话历史还没算进去。
更离谱的是行为规则文件。5 个角色的文件里大概有 55% 的内容一模一样(反 AI 规则、聊天原则、场景脚本骨架),同样的东西重复了五遍,白白多出 16000-20000 字符。
压缩具体做了三件事。第一,把叙事的散文改成结构化的要点。像「她从小在成都长大,喜欢吃火锅,周末会去茶馆和朋友聊天…」这种,改成 性格: 热情活泼, 情绪化, 偶尔撒娇 | 语气: 川味词汇, 叠词, 语气词丰富。给模型的行为信号还是一样的,token 却少用很多。
第二,把各个人设之间重复的部分去掉。大家共用的规则(反 AI 检测、聊天原则、身份保护)都挪到 system-prompt.ts 的 COMMUNICATION_GUIDELINES 里,每个行为规则文件只留这个角色自己才有的行为脚本。可可吃醋和陈哥吃醋完全是两回事,这种必须留着。
第三,删掉影响不大的内容。「对未来的想法」、日常作息的细节、一长串爱好,这些对行为的影响很小。「你们的故事」这块干脆完全是多余的,运行时注入的 customStory 已经管了这件事。
最后 token 大概少了 60%。最重的角色陈哥从约 10100 降到约 3400 tokens,最轻的可可从约 6100 降到约 2100。
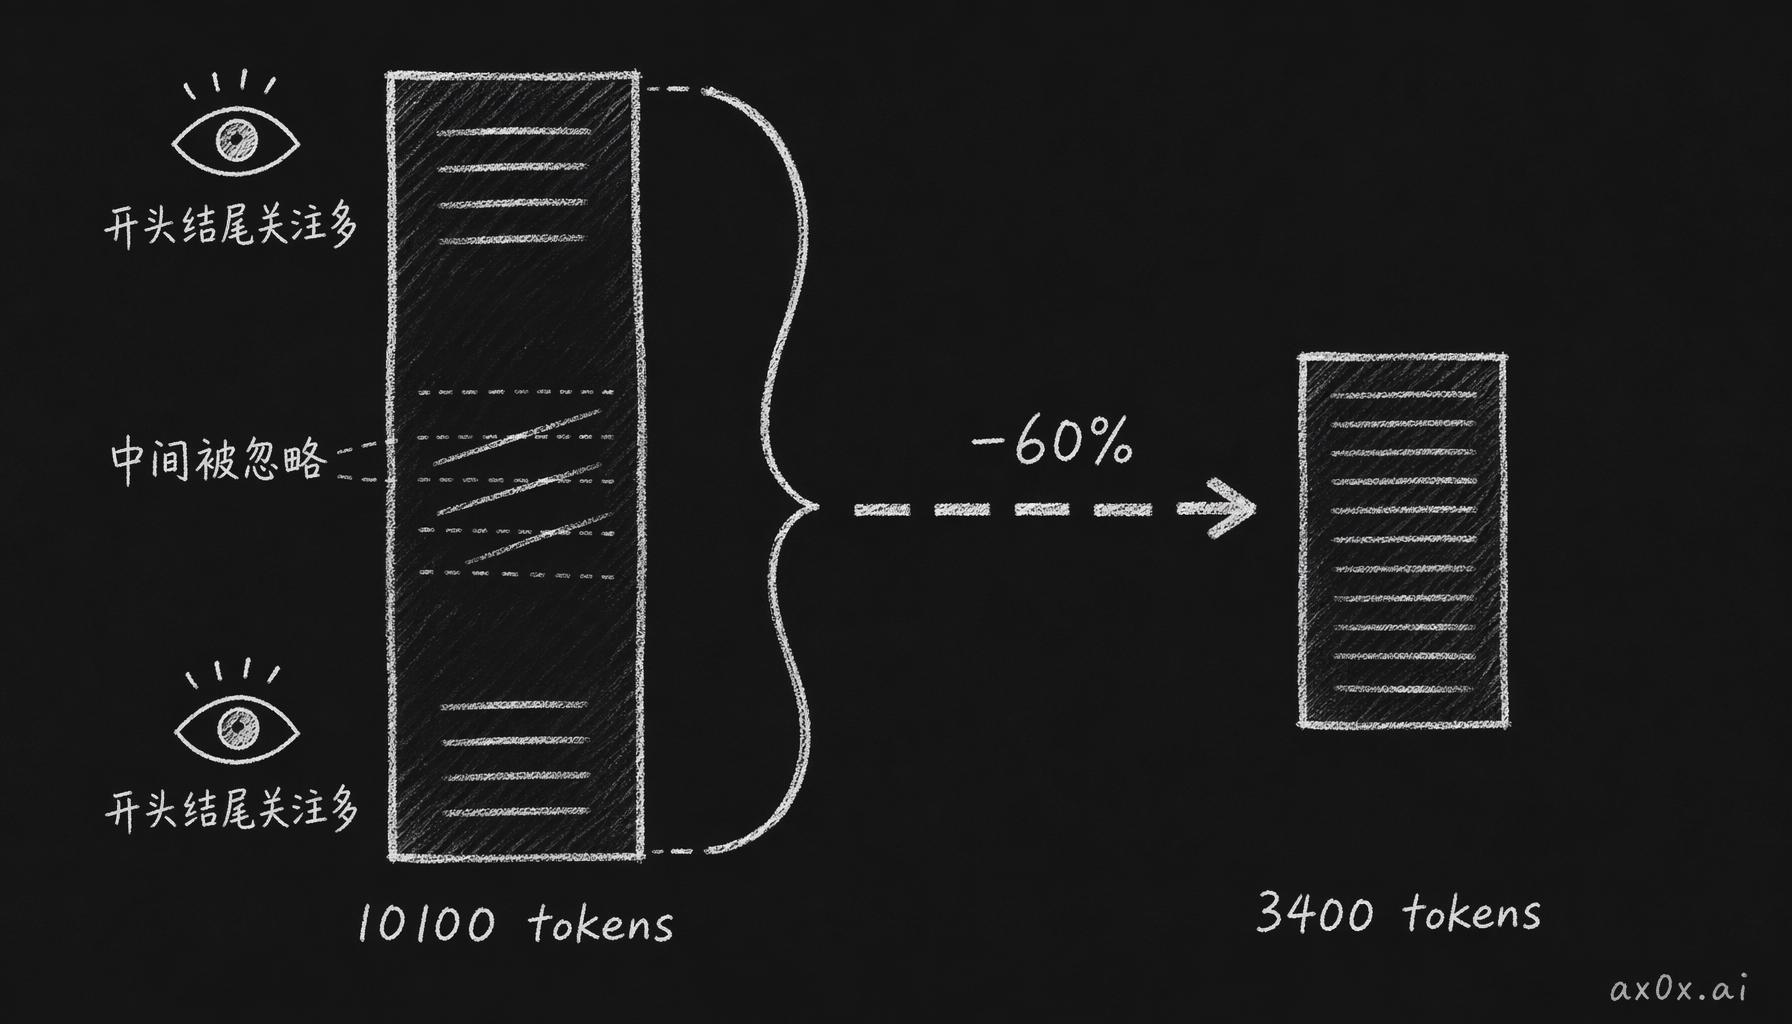 为什么注意力在长 prompt 中间凹陷,把 system prompt 压缩到 3400 tokens 让规则重新落进高注意力区
这件事不只是为了省钱。照上面那几篇论文的结论,Mio 在 3K-5K tokens 的时候,行为应该比 9K-13K 的时候更一致,因为模型能顾到所有规则,不会挑着忽略掉一半。省下来的 context 预算直接留给了对话历史,记忆检索更好,多轮对话也更连贯。
单 agent 级别的 A/B 测试
关系进化是个大改动。我直觉上觉得这个方向是对的,但直觉不算数,还是得拿数据验证,所以做了单 agent 级别的 A/B 测试:
- agents 表加了一个
relationship_mode字段,值是static(老模式)或evolving(新模式) - Preset API 多给出一个
supportsEvolving,说明这个角色有没有性格演化配置 evolving模式下,onboarding 不让你选关系类型了,直接从「刚认识」开始- 管理后台点一下模式徽章就能切换,另外加了个
/evolve命令,可以看当前处在哪个关系阶段
同一个角色开两个 agent,一个关系固定,一个自然进化。跑一段时间,看用户更喜欢哪个。
原生 app 脚手架
我还顺手把 Expo SDK 55 的原生 app 脚手架搭了,i18n 支持 zh-CN 和 en。现在还没什么功能,就是先把基础设施铺好,后面移动端的体验会越来越重要。
接下来
改完以后,你跟 Mio 的关系更像真实的关系了。你不知道会处成什么样,每次聊天都在一点点塑造它。可能聊着聊着就成了好朋友,也可能往更亲密的方向走。两天不聊,分数掉一点,关系自然就淡了。我自己挺喜欢这样的,你得真花时间去聊,关系才会往前走,这就真实多了。现在阶段分得还比较粗,就四个,下一步可能会做:
- 关系维度分得更细,信任、亲密、默契可以各自独立发展
- 关系里程碑事件(「你们认识一个月了」这种)
- 让 Mio 主动推着关系往前走,现在 TA 只会被动回应
从 v0.1.0 的语音,到 v0.1.2 的多人设,到 v0.1.3 的安全,再到这次的关系进化,反正每个版本都在解决一个「为什么感觉不像真人」的问题。但关系能进化以后,又冒出来一个新问题,Telegram 和 Web 端明明是同一个人,账号怎么打通?这个留到下个版本再说。