web 端也能发图片和语音了
 多模态通信补齐的概念插画
web 端差在哪
Mio 在 telegram 上,从 第三篇讲的 v0.0.2 开始就能看图、听语音、发自拍了。但同一个版本上线的 web 聊天界面一直只能打字,能输文字、能看流式回复,照片发不了,语音也录不了。
上一篇把 web UI 从头重做了一遍,这个缺口就更扎眼了。界面已经像个正经的聊天 app,可图片、语音一样都发不出去。v0.0.5 就干这一件事,telegram 用户第一天就有的照片、视频、语音、表情,在浏览器里全部补上。这次一共改了 38 个文件,新增 3,009 行代码,从开工到打 tag 发版用了 28 分钟。下面讲具体是怎么做的。
上传和发送拆成两步
整个方案里最关键的决定,是把上传分成两步。大概是这样,你选了一张照片,或者录完一段语音,客户端先把文件传到 POST /chat/media,服务端校验一下、存进内存,再返回一个 mediaId。等你点发送的时候,消息里带的只是 mediaIds[] 和文字,文件本身早就在服务端了。
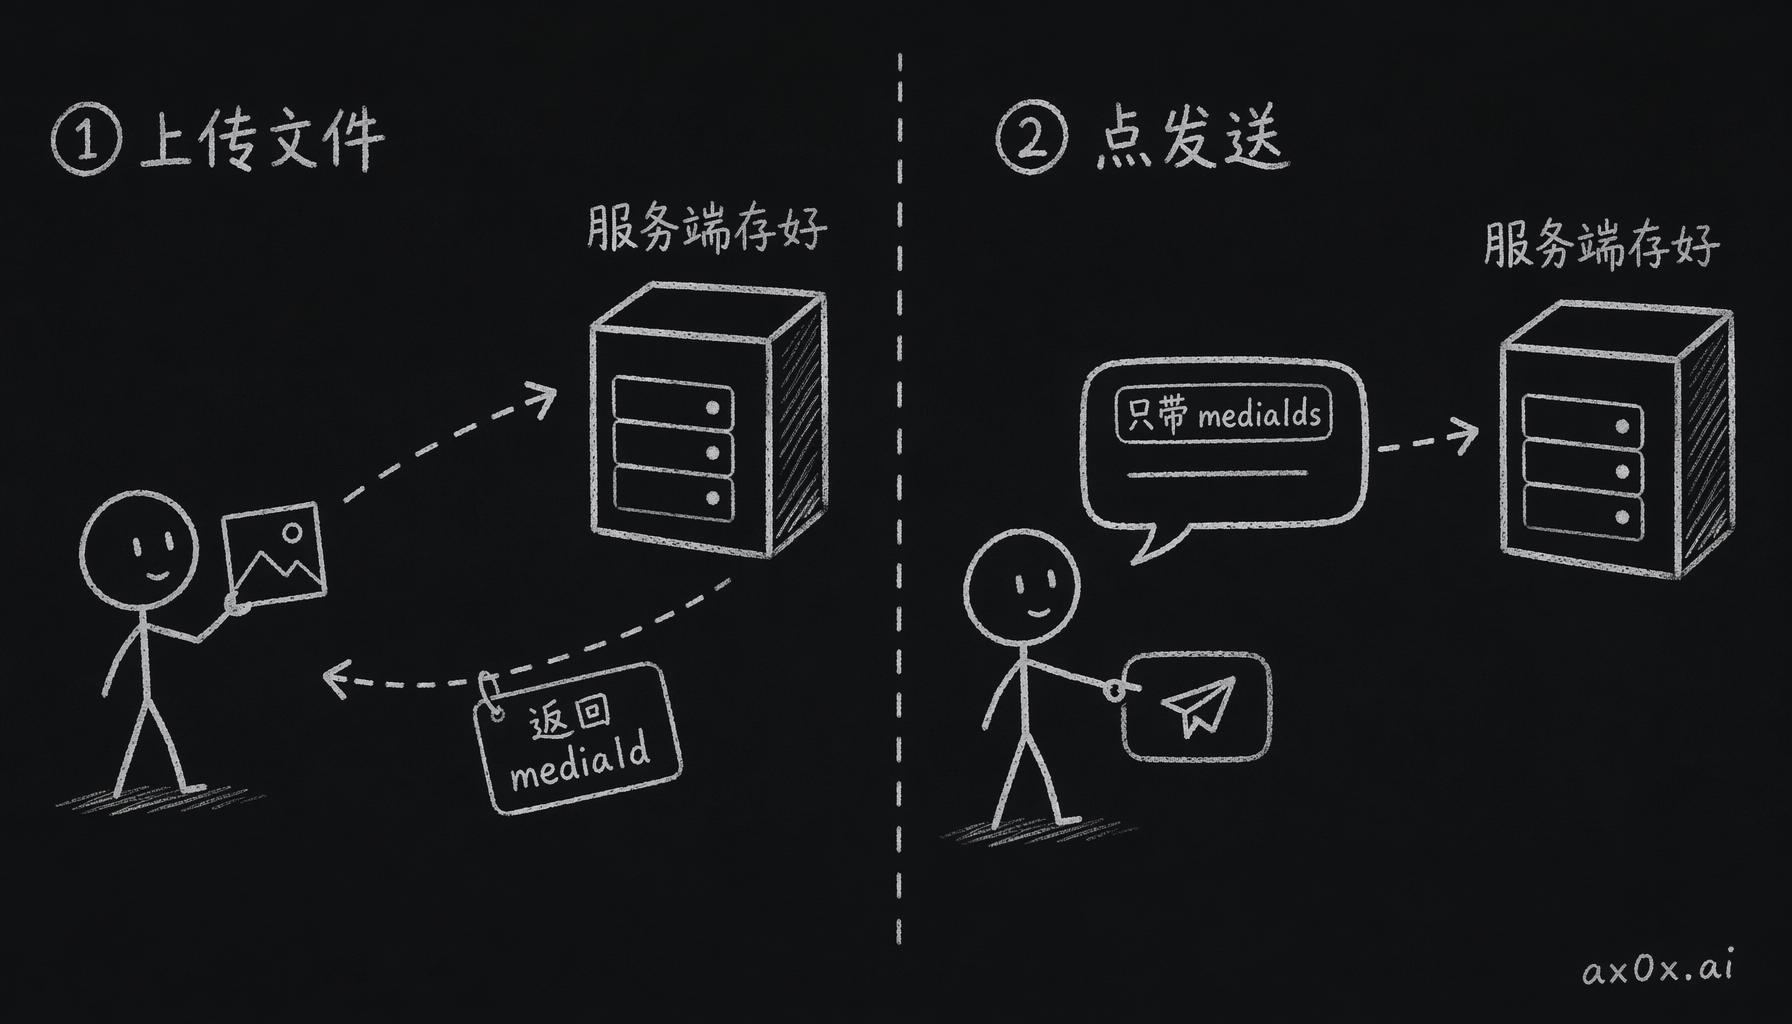 两阶段上传:先把文件传到服务端换回 mediaId,点发送时消息只带 mediaIds,把上传和发送拆成两个独立步骤
为什么不把文件和消息一起发?因为上传和发送挂掉的原因完全不一样。上传挂,多半是文件太大、格式不对,或者服务器内存不够;发消息挂,一般是认证或者限流出了问题。拆开以后能做的事就多了,可以显示上传进度,上传出错可以单独处理,用户发送之前也能先预览一下附件。
服务端这边基本没写新东西,直接用了现成的 processMedia() 管道,telegram 的图片和语音也是这套代码在处理。唯一新写的是一个放在内存里的 web downloader。telegram 的文件下载器对外有一个接口,web downloader 就把上传来的 buffer 包成同样的接口。这样两个来源走的是同一条管道,处理逻辑不用写两遍。
语音录制的浏览器兼容
录语音听起来简单,换几个浏览器一试全是坑。MediaRecorder API 没保证一定支持哪个 codec。Chrome 原生支持 WebM/Opus,Safari 以前一直不支持 WebM,只给 MP4,Firefox 又有自己的一套。
所以开始录音的时候,先跟浏览器协商 codec。先问它支不支持 audio/webm;codecs=opus,支持就用这个,文件更小,音质也更好;不支持就退回 audio/mp4。服务端两种都收,反正后面走的是同一条管道。
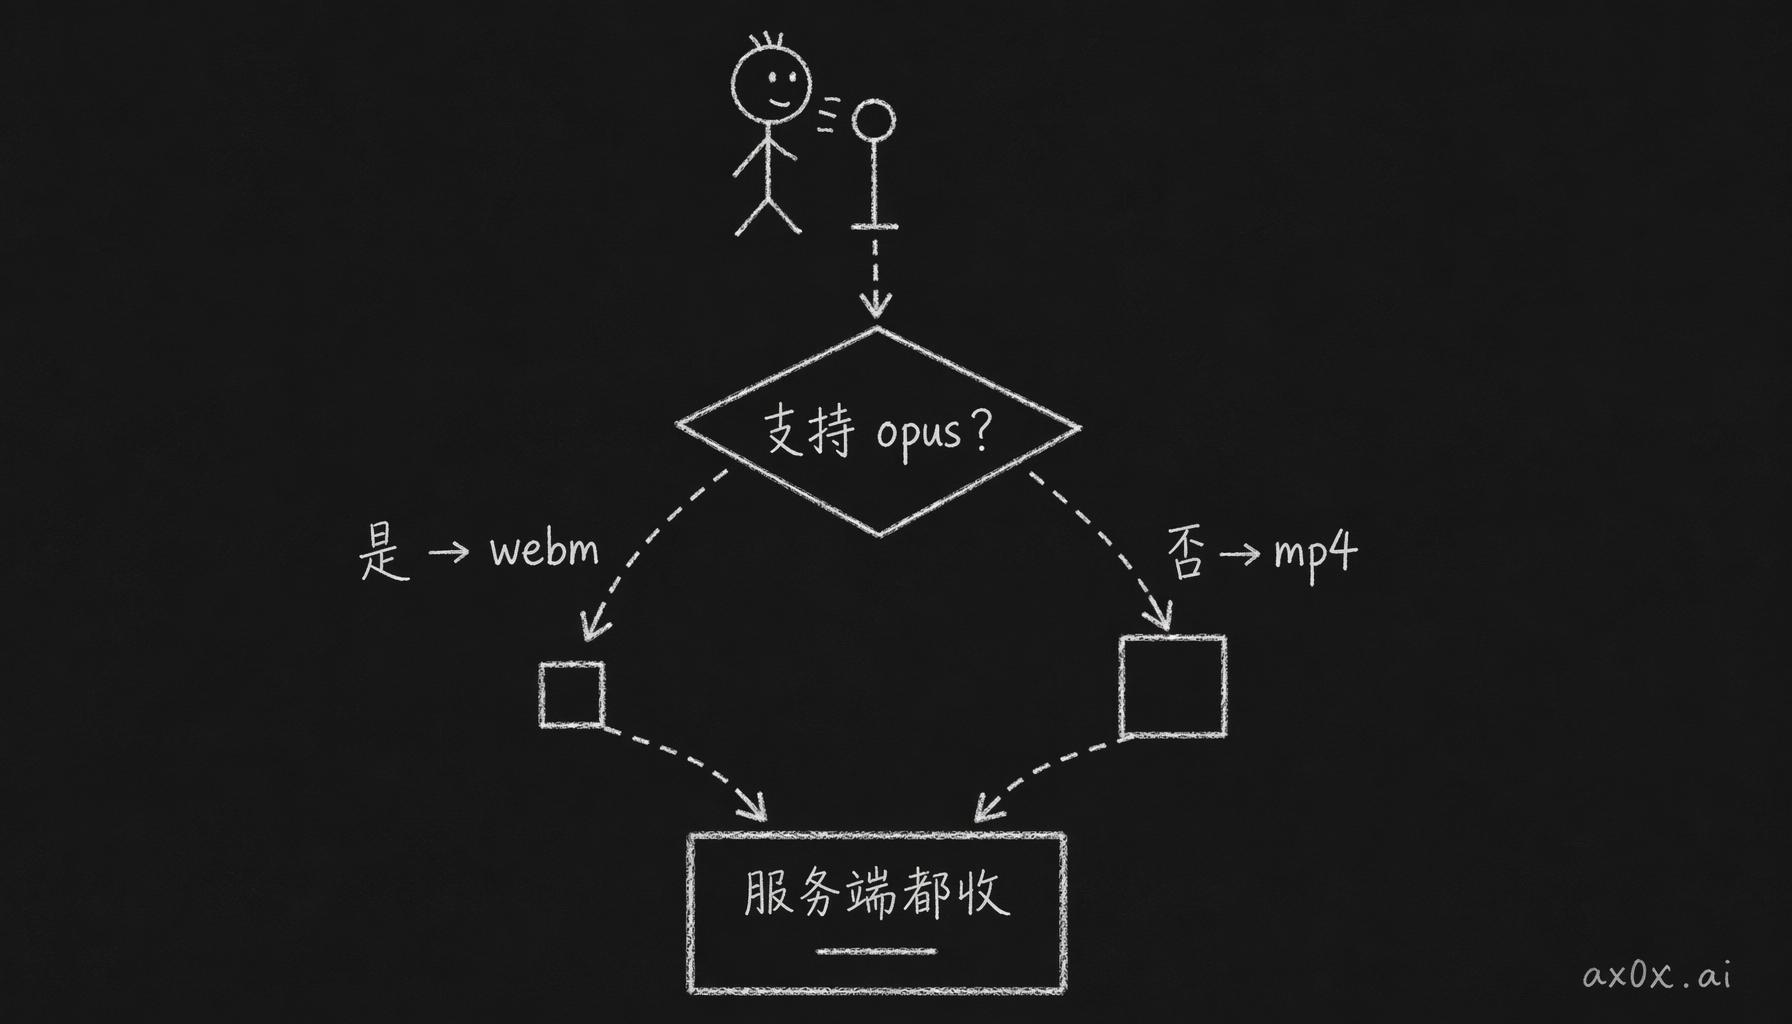 编解码器协商:录音开始先问浏览器支不支持 opus,支持走 webm、不支持退回 mp4,两条分支最后都汇进服务端的同一条管道
除了 codec,还有几个细节要处理。
- 最长只能录 5 分钟。不然用户忘了关麦,一个巨大的文件就传上来了。
- 用
sendingVoiceRef防止重复发送,外面再包一层 try/finally。从录完到发出去,中间有好几步异步操作,用户连按两下按钮,第一次还没发完第二次就进来了,这种事真会发生。 - 麦克风没权限的时候,要真的告诉用户。原来的代码是个空的 catch 块,错误直接被吞了;现在会弹一个 toast,提示「无法录音,请检查麦克风权限」。
一个把语音消息全部吞掉的 bug
这个 bug 花的时间最多。语音消息会悄无声息地消失,你录完、点发送,然后什么都没发生,没有报错,也没有任何反馈。
查下来,其实是两个 bug 叠在了一起。第一个在客户端。flushToServer 这个函数发消息之前会先检查一下,文本不能是空的。纯语音消息有 mediaId,但没有文字,就被这一步拦下来悄悄丢掉了,根本没发出去。
第二个在服务端。ChatSchema 给文本字段加了 .min(1),纯语音的空文本到这一层也过不去。所以就算客户端不拦,服务端也会拒掉。修法是改成 .refine(),只要 mediaIds 不是空的,文本为空也放行。两层都在悄悄失败,所以两层都得修,只修一个没用。
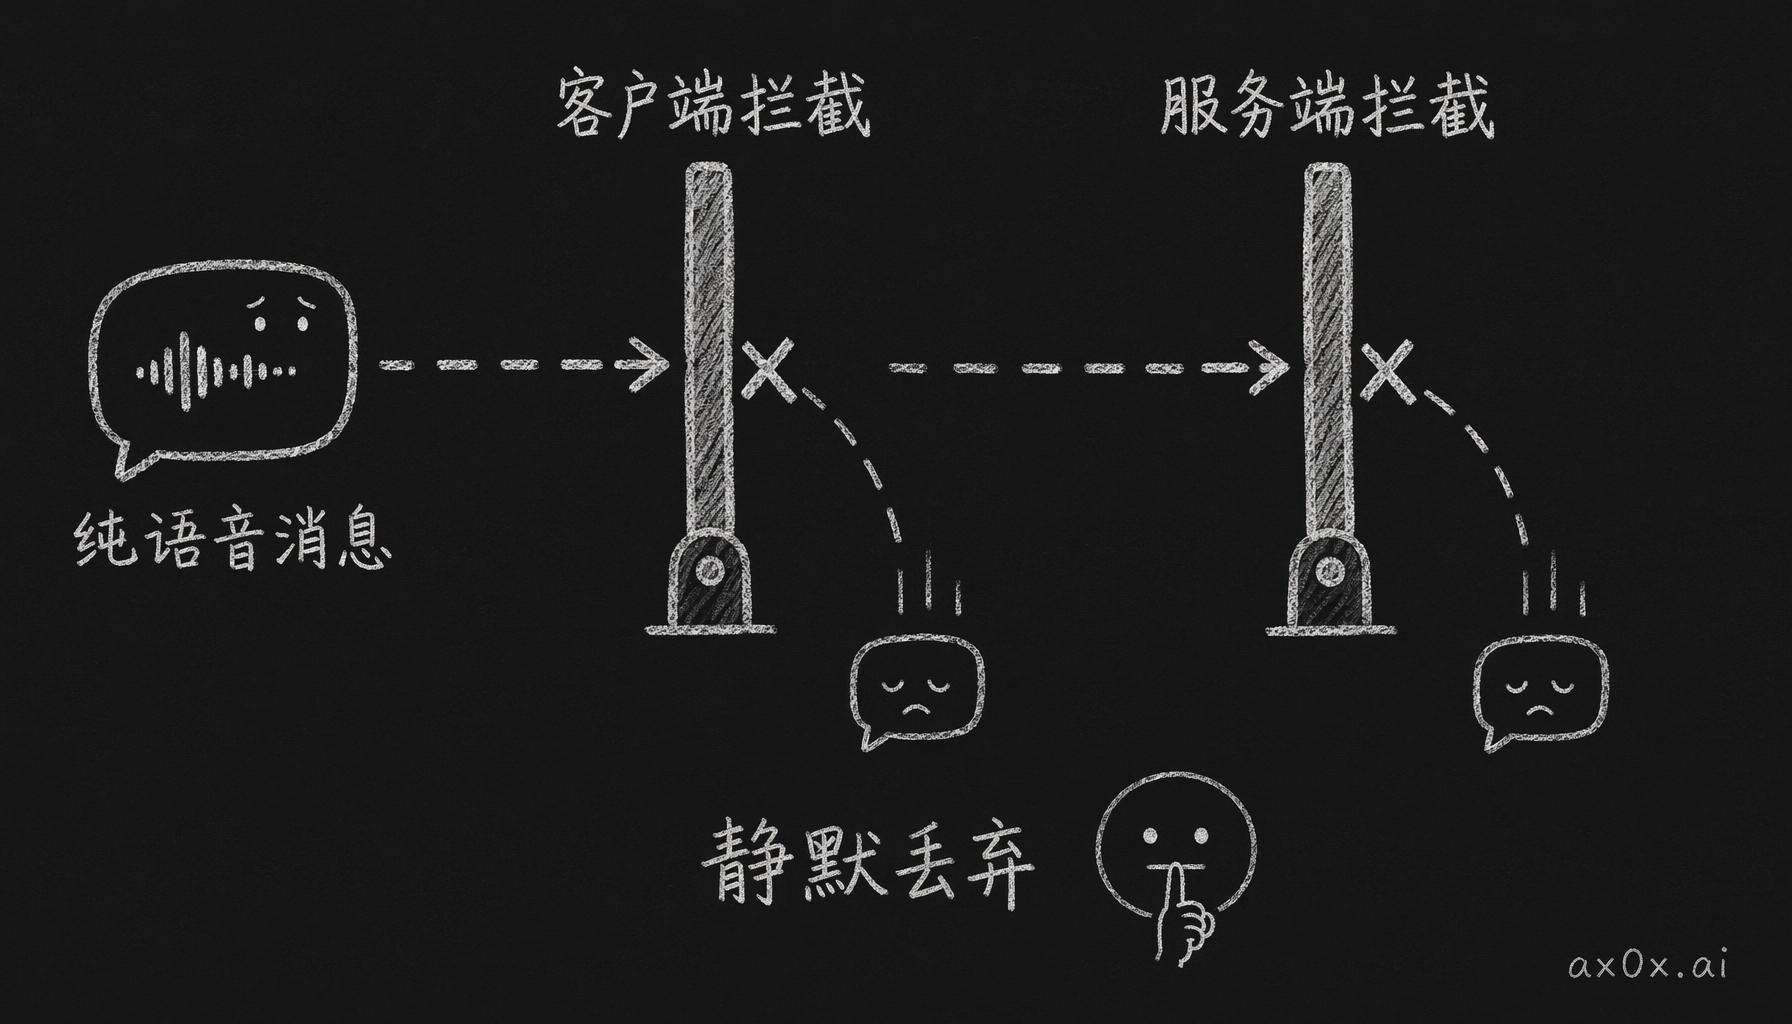 两层静默拦截:一条纯语音消息先被客户端的非空文本检查拦下,即使放行也会被服务端的 .min(1) 校验拒掉,两道关卡都无声丢弃,所以必须两层都改
顺着这条链路,还挖出了第三个问题。原来的代码先用 setTimeout(500) 等状态更新完,再去读 mediaIds。这是在赌时序,500ms 够不够全看运气。修法是让 addVoiceRecording 直接把 MediaAttachment 对象 return 出来,拿到就用,不用再等状态什么时候更新。
表情选择器
表情选择器要处理的细节比预想的多一点。用的是 @emoji-mart/react,加了懒加载,因为这个组件挺重的,不能拖慢首屏。中文 locale 也配上了,表情分类名会显示成中文。它放在输入栏里,和语音按钮、文件上传按钮排在一起。技术上没什么好讲的,但聊天 app 要是没有表情选择器,用起来就是差点意思。
白名单从环境变量搬进数据库
v0.0.5 之前,用户白名单放在一个环境变量里。要加一个人,就得改环境变量、重新部署,踢人也一样。只有三个测试用户的时候还能凑合,真要运营起来就不行了。
这次把白名单搬进了 telegram_allowlist 这张表,顺便给 users 加了一列 role(migration 0003)。服务启动的时候先把白名单加载进内存缓存,读的时候直接读缓存。环境变量留着做 fallback,如果数据库是空的,就退回去读 ALLOWED_TELEGRAM_IDS。
管理入口也一起做了,一共三个 API,GET/POST/DELETE /api/admin/allowlist,都有 admin guard 中间件挡着,另外还有一个中文界面的 /admin 页面。以后在网页上点两下就能管用户,代码和环境变量都不用碰。真要运营,这种后台是绕不开的。
两轮安全审计,修了 17 个问题
功能写完以后,又跑了两轮完整的安全审计。几个 audit agent 并行跑,把每个新文件和改过的端点都扫了一遍,一共找出 17 个问题,全都修掉了。这 17 条单拎出来哪条都不算大事,但上线之前都得堵上。下面挑几个重点的说一下。
- 用 magic byte 校验 MIME。
Content-Typeheader 和文件扩展名都不信,直接读文件本身的字节,用file-type库验 magic byte 签名。有人把malware.exe改名成photo.jpg传上来,到这一层就会被拒掉。 - 给内存设全局上限。
pendingUploads这个 map 把还没发出去的文件放在内存里,如果不设上限,恶意用户可以一直传,把服务器内存撑爆。现在全局最多 500MB,每个用户最多挂 3 个待发文件。 - 校验文件是谁的。web downloader 的闭包里捕获了
userId,取文件的时候会核对一遍文件是不是这个用户的。就算你猜到了别人的mediaId,也拿不到别人传的文件。 - 过滤 URL scheme。消息气泡会把上传的媒体渲染成内嵌图片,如果不过滤,有人专门构造一条消息,就能往里塞任意 URL。现在只放行
blob:和https:两种协议。 - sanitize 文件名。上传的文件名先清洗一遍再处理,想拿
../../etc/passwd.jpg这种文件名做路径遍历,是走不通的。 - 截断错误信息。上传失败的时候,报错会被截断,不会把完整的请求内容回显给客户端,免得泄露信息。
顺手修的一个心跳 bug
还有一个 bug 是顺手修的。Mio 有个主动消息系统,会去找一段时间没动静的会话,给用户发一条贴合当下场景的消息,查询条件是 lastMessageAt 小于某个阈值。问题出在新用户身上。刚做完 onboarding、还没发过第一条消息的人,lastMessageAt 是 NULL,而 SQL 里 NULL < anything 的结果是 NULL,不是 true,所以这批用户就被查询悄悄跳过了。
修起来就一行,加个 OR lastMessageAt IS NULL。可要是没这一行,每个新用户做完 onboarding 以后,Mio 永远不会主动找他说话,因为刚注册、还没发过消息的人,正好全被这个查询漏掉了。
下一步
整个 v0.0.5 是两个实现 agent 加两个 audit agent 干出来的,两边各自并行。实现用了 18 分 30 秒,安全审计 8 分 42 秒,发版 1 分 14 秒,从「开始 v0.0.5」到打 tag 一共 28 分钟,12/12 测试全过。
telegram 和 web 端之间最后一个大缺口就是媒体。v0.0.5 之后,两边在核心交互上算是对齐了,文字、图片、语音、表情、流式回复都有。有些功能得等两边能力一样了才做得了,接下来就能做这些了,后面几篇再讲。