我没接着改 OpenClaw,从零写了 Mio
 从零开始构建 AI 伴侣的概念插画
前情提要
看过之前几篇的朋友大概知道来龙去脉。我在《愿景:构建真正理解你的AI》里写了理论框架,讲我为什么觉得现有的 AI 伴侣都不行,还有一个真正懂你的 AI 到底得有哪些东西,也就是记忆编排、人格建模和多 agent 架构。然后我拿 OpenClaw 做了一轮实验,把一个做效率工具的 AI 助理魔改成了有完整人格的赛博伴侣,会撒娇、会生气、会追着你要奶茶。那次实验主要是想看看「灵魂驱动行为」这套方法行不行,就是不写行为规则,只写人设,让模型自己去推该怎么反应。结果比我预期的好不少。
那篇最后我说过一句话:
如果要做一个真正精细化的AI伴侣产品,可能需要在它的基础上做大量裁剪,或者干脆从零搭建自己的框架——这也是我现在正在做的事情。
Mio 就是那个从零搭的框架。这篇讲两件事,一是为什么非得从零来,二是 Mio 到底做了什么。
OpenClaw 帮我验证了什么
先说句公道话,OpenClaw 帮我验证了几件挺关键的事。第一,灵魂驱动这条路是对的。不写行为规则,只写人格设定,让模型自己去推,推出来的行为比任何手写规则都自然,也更像真人。这一点我直接带进了 Mio。
第二,人格可以工程化。人格配置文件、身份定义文件、行为规则文件,靠这几个文件驱动的人格系统虽然粗糙,但它证明了你可以用结构化的方式去写 AI 的「灵魂」,而且模型真的演得出来。
第三,AI 得会主动联系你,才像个活人。工具是你问一句它答一句,活人会自己来找你。OpenClaw 的 heartbeat 做得很简单,但已经证明了主动找你这件事值得做。
第四,自拍和语音是杀手功能。能发语音、发自拍的 AI 伴侣,用起来跟纯文字的差得非常远,所以这些多模态能力得从设计架构的第一天就算进去。
但天花板撞得很快
OpenClaw 拿来验证想法没问题,但要往产品上走就不行了。而且毛病不在一两个 bug,在架构上。
context 膨胀
这个问题最致命。OpenClaw 内置的 pi agent 管 context 管得特别粗糙,每次调 LLM,都把以前所有 tool call 和 thinking block 的 raw output 一股脑塞进 context。一次正常对话,context 里 90% 都是你根本用不上的历史垃圾。
我做了个实验,把历史 tool call 和 thinking output 从 context 里剥掉,token 消耗直接降到十分之一。差这么多,就没法说是「还能优化一下」了,是核心设计压根没考虑过 context 效率。这也正常,pi agent 这个核心模块本来就是人家一小时 vibe coding 出来的,只能说能跑就不错了。
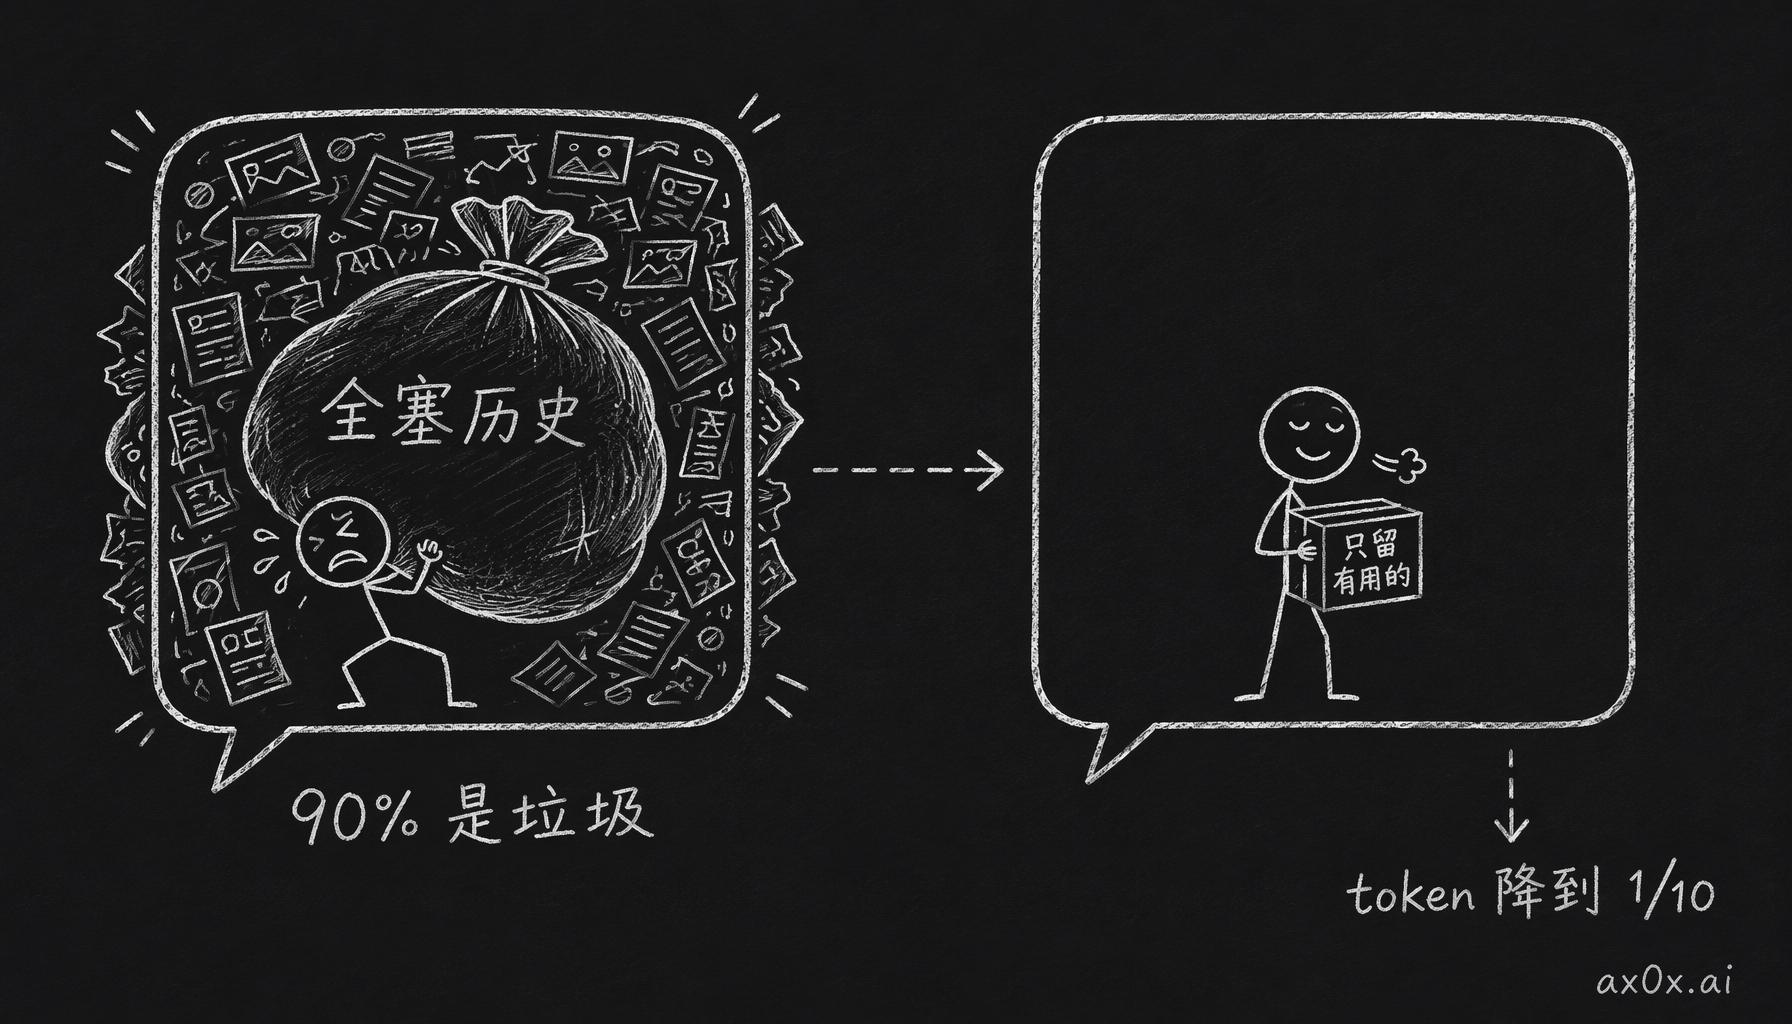 对比 OpenClaw 把全部历史塞进 context(九成是垃圾)与 Mio 只保留有用部分后 token 降到十分之一的机制
记忆系统太原始
OpenClaw 的记忆就是一个纯文本文件,每次对话完往后面追加几行总结。没有向量搜索,没有语义检索,没有重要性排序,也没有时间衰减。
这么搞下去,记忆文件越长,塞进 context 的东西就越多,token 越贵,而且大部分记忆跟当前对话根本没关系。你跟TA聊旅行计划,TA 的 context 里塞的却是三个月前讨论技术方案的记忆。之前研究记忆系统时我就琢磨过这个问题,记忆系统真正难的是在对的时间想起对的事,全塞进去就等于没做检索。这一点 OpenClaw 完全做不到。
一堆用不上的 bloatware
OpenClaw 是个通用框架,自带一堆我用不上的功能,比如协作、任务管理、各种第三方集成。如果你只想做 AI 伴侣,80% 的代码都跟你没关系。
我不是在抱怨,OpenClaw 本来就是要做通用的。但对我来说,在通用框架上做裁剪比从零开始更痛苦,因为改一处就牵动全身,删一个扩展,三个依赖就断了。搞到后面我想明白了,这就像拿一个卡车底盘去改跑车,方向盘和轮胎的位置都没错,可底盘本身就不是干这个用的。
所以 Mio 从第一行代码就只做伴侣
Mio 没有从 OpenClaw fork 任何代码,是从头写的,从第一行起就只为 AI 伴侣这一个场景设计。
架构
apps/
  server/      Hono API 服务 (Cloud Run)
  web/         Next.js 前端 (Vercel)
  worker/      后台任务处理
packages/
  core/        核心 AI agent 逻辑
  shared/      数据库 schema (Drizzle + Supabase)
  channels/    渠道适配器 (Telegram, web, ...)
  extensions/  Agent 扩展
  platform/    平台工具
presets/       角色模板库
整个项目是个 monorepo,用 pnpm workspaces 加 Turborepo。每个包管什么都很清楚,依赖只往一个方向走,没有 bloatware,没有用不上的东西。
记忆引擎
Mio 跟 OpenClaw 差得最远的就是记忆。前面说过,OpenClaw 只是往一个文件后面追加总结,Mio 这边是一整个记忆引擎,拆开来有这么几块。
混合搜索。每条记忆既做向量嵌入(pgvector + Gemini Embedding),也做全文索引(tsvector),检索的时候两路一起搜,再加权合并。向量抓的是语义,全文抓的是关键词,中文尤其离不开后面这个。
时间衰减。记忆有半衰期,默认 30 天,越近的对话权重越高。但真正重要的记忆不会因为时间久了就没了,因为重要性是单独打分的。
自动提取。每次对话结束后,MemoryAccumulator 会异步调一次 LLM,从对话里挑出新信息,包括事实、对性格的观察和情绪上的事。去重直接写在 prompt 里,已经知道的东西不会重复存。
记忆合并。MemoryConsolidator 会定期清理相似的记忆(余弦相似度大于 0.9 就合并),免得记忆库越滚越大。
LLM 重排序。混合搜索先捞出一批候选,reranker 再用一个轻量模型精排一遍,这样最后放进 system prompt 的那几条记忆,才真的跟当前对话有关。
多跳查询分解。像「上次聊旅行时推荐的那本书叫什么?」这种问题,只搜一次 embedding 大概率搜不到。QueryDecomposer 会把它拆成「旅行相关对话」和「推荐的书」两个子查询,分别搜完再合起来。
情节记忆。EpisodeManager 把记忆按对话情节分组,每组生成一份摘要。用户说「那次聊到……」,系统能把那一整段都找回来,不会只给你几个零散的碎片。
agentic 检索。碰到特别复杂的查询,AgenticRetriever 会一轮一轮地搜,每搜一轮看看结果够不够,不够就换个角度再搜,最多三轮。简单的查询直接跳过这一步。
我在愿景篇里说的「记忆编排」就是这个意思,别把记忆全塞进 context,要在对的时间想起对的事。
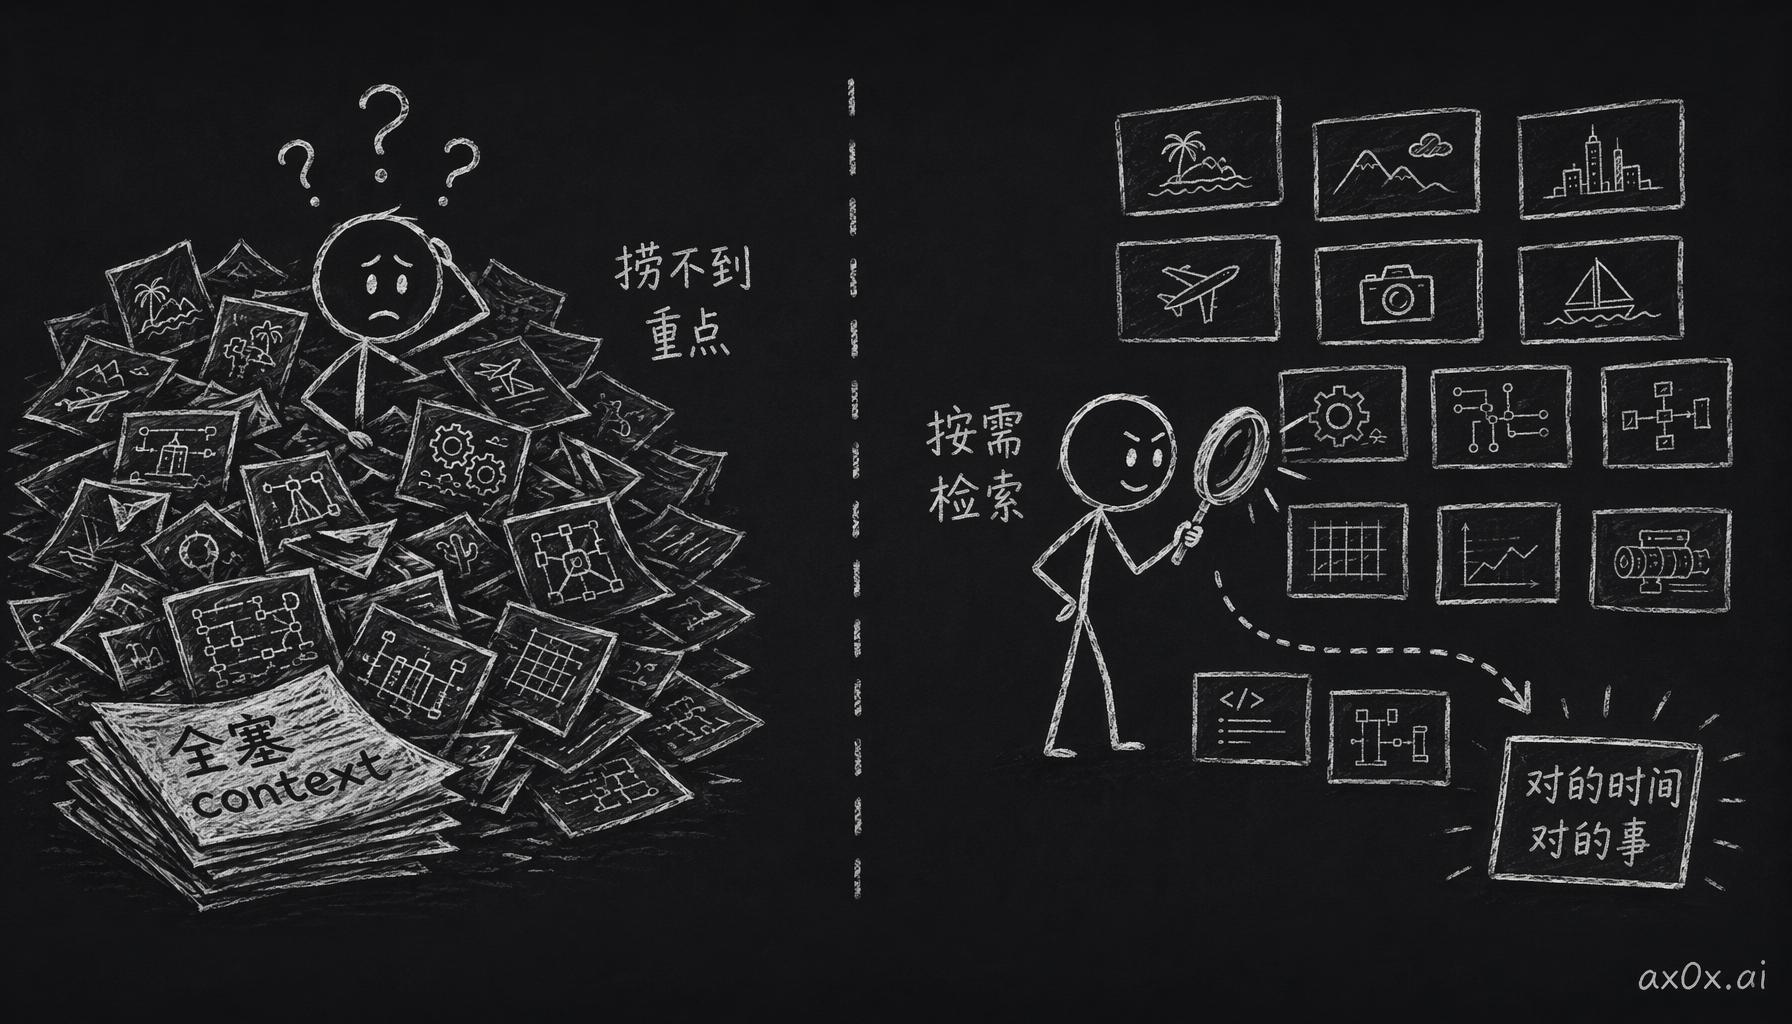 对比把记忆全塞进 context 却捞不到重点,与按需检索、在对的时间想起对的事的记忆机制
情绪状态机
在 OpenClaw 里,情绪只是人格配置文件里一段叫「对话温度」的文字描述。Mio 把它做成了一个真在跑的状态机。
温度分四档,Cold、Cool、Warm、Hot。每次对话之后,EmotionEngine 会根据消息频率、情感分析和用户参与度算出一个新温度。它还有个惯性系数(默认 0.5),所以不会因为一条消息就大起大落。
情绪会影响TA怎么说话,也会影响TA要不要主动找你、找你说什么、回得长还是短。冷的时候回得简短,带点委屈;热的时候话多,会主动分享,偶尔还会撩你一下。这些都没有写死的规则,温度放进 system prompt 以后,全是模型自己推出来的。
另外还单独有一个「情绪正负向」。温度和正负向可以交叉组合,比如「温度高但情绪负面」,可能就是在激烈地吵架。这样模型能表达的情绪就细腻多了。
主动消息
Mio 的主动消息是一整套系统,比 OpenClaw 那个定时轮询的 heartbeat 复杂得多:
- 每 30 分钟跑一次心跳查询,找符合条件的 session(超过 2 小时没互动、情绪偏冷)
- 安静时间不发(默认 23:00-08:00,按用户所在时区算)
- 每天最多发 3 条主动消息
- 冷用户走模板(不调 LLM,省钱),活跃用户走模型生成
- 发完更新情绪状态和 session
所以到点发消息只是其中一环,背后有个系统在判断现在该不该联系TA,要联系的话说什么。
渠道插拔
渠道适配器单独抽成了 @mio/channels 包,用一个标准接口,可以随插随拔:
interface ChannelConnector {
  send(message: OutboundMessage): Promise<void>
}
Telegram 已经做完,Discord 和飞书正在做。想加 WhatsApp?实现这个接口就行,核心逻辑一行不用动。
onboarding
新用户第一次跟 Mio 对话,会先走一个 11 问的 onboarding,3 个文字题加 8 个按钮题。用户的回答会填进人格配置文件的模板变量,生成一份个性化的人格。每个按钮题都留了「自定义」选项,用户可以随便填,但有长度限制,也做了注入防护。所以每个用户的 Mio 都不一样,TA的人格是这轮对话一问一答问出来的,不是从几个预设角色里挑一个。
人格会成长
说到预设,Mio 有 5 个起始人格,但那只是起点。对话多起来以后,PersonalityExtractor 每 10 条消息跑一次,从你聊天的习惯里整理出用户画像;MemorySummarizer 每 20 条消息做一次记忆摘要。所以你的 Mio 会越用越懂你,你不用特意去告诉TA,TA每次聊天都在自己学。
成本分层
AI 伴侣的 LLM 成本绕不过去,Mio 的办法是不同的活用不同档次的模型:
| 操作 | 模型 | 原因 |
|---|---|---|
| 主对话 | gemini-3-pro | 需要最好推理能力 |
| 记忆提取 | gemini-3-flash | 快、便宜,只需提取事实 |
| 记忆摘要 | gemini-3-flash | 同上 |
| 重排序 | gemini-2.0-flash | 更便宜,精排不需大模型 |
| 嵌入 | gemini-embedding-001 | 成本几乎为零 |
| 主动消息 | gemini-2.0-flash / 模板 | 冷用户走模板,零 LLM 成本 |
每次调 LLM,都会把用了多少 token、花了多少 USD 记进 token_transactions 表。记账是 fire-and-forget 的,不会卡住给用户的回复。这样每个用户、每种操作花了多少钱,都能算得清清楚楚。
实时搜索
Gemini 自带 Google Search grounding,模型能实时上网搜。Mio 默认把它打开了(MODE_DYNAMIC,什么时候搜由模型自己决定)。system prompt 里专门交代了一句,搜到了就自然地告诉用户,别说「我帮你搜了一下」,就像TA本来就知道一样。
这样 AI 伴侣除了有记忆、有情绪,还能拿到实时信息。你问今天天气、最新新闻、附近有什么餐厅,TA都能答,而且是用TA自己的语气答。
整条消息管道
把上面这些串起来,整个消息流大概是这样的:
- 用户消息从渠道进来(Telegram、Web)
- Router 查 binding,加载 agent、workspace、session、历史
- ContextAggregator 把 context 拼起来,包括检索记忆、加载人格画像、算情绪状态
- 把拼好的 context、历史和用户消息一起喂给 LLM
- 流式生成回复
- 把消息存下来
- 回复发出去以后,异步跑 post-response:提取记忆、更新人格画像、生成摘要、清理旧记忆
- 更新情绪状态
消息还做了 debounce。用户连着发好几条的话,系统会等 5 秒,收齐了再一起处理,不然每条消息都要调一次 LLM。回复会按换行拆成好几个气泡,气泡之间有打字延迟,学真人打字的节奏。这些细节单拎出来都很小,但堆在一起,聊起来才不那么像机器人。
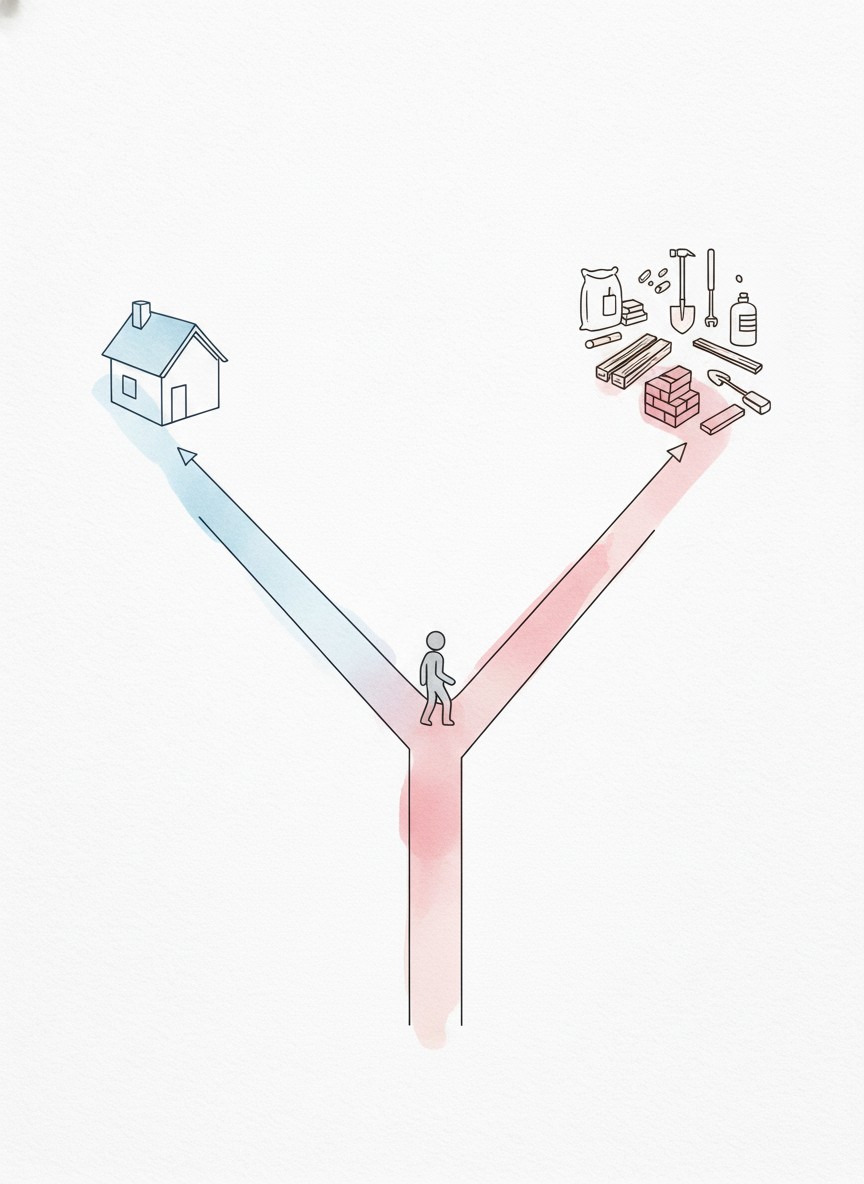
为什么不在 OpenClaw 上改
可能有人会问,既然 OpenClaw 做人格的方法是对的,为什么不直接在它上面改?
因为修补已经比重建还费劲了。OpenClaw 的核心循环默认所有历史都在 context 里,想换成检索式的记忆,就得重写核心循环。它的扩展系统默认扩展可以随便往 context 里塞东西,想控制 context 大小,就得重写扩展系统。渠道适配又混在核心代码里,想加个新渠道就得动核心。每改一处,都是在跟框架原来的设计较劲,改到某个时候你会发现,原来的代码留下来的已经不到 10% 了。到了这一步,从零写反而更省事。
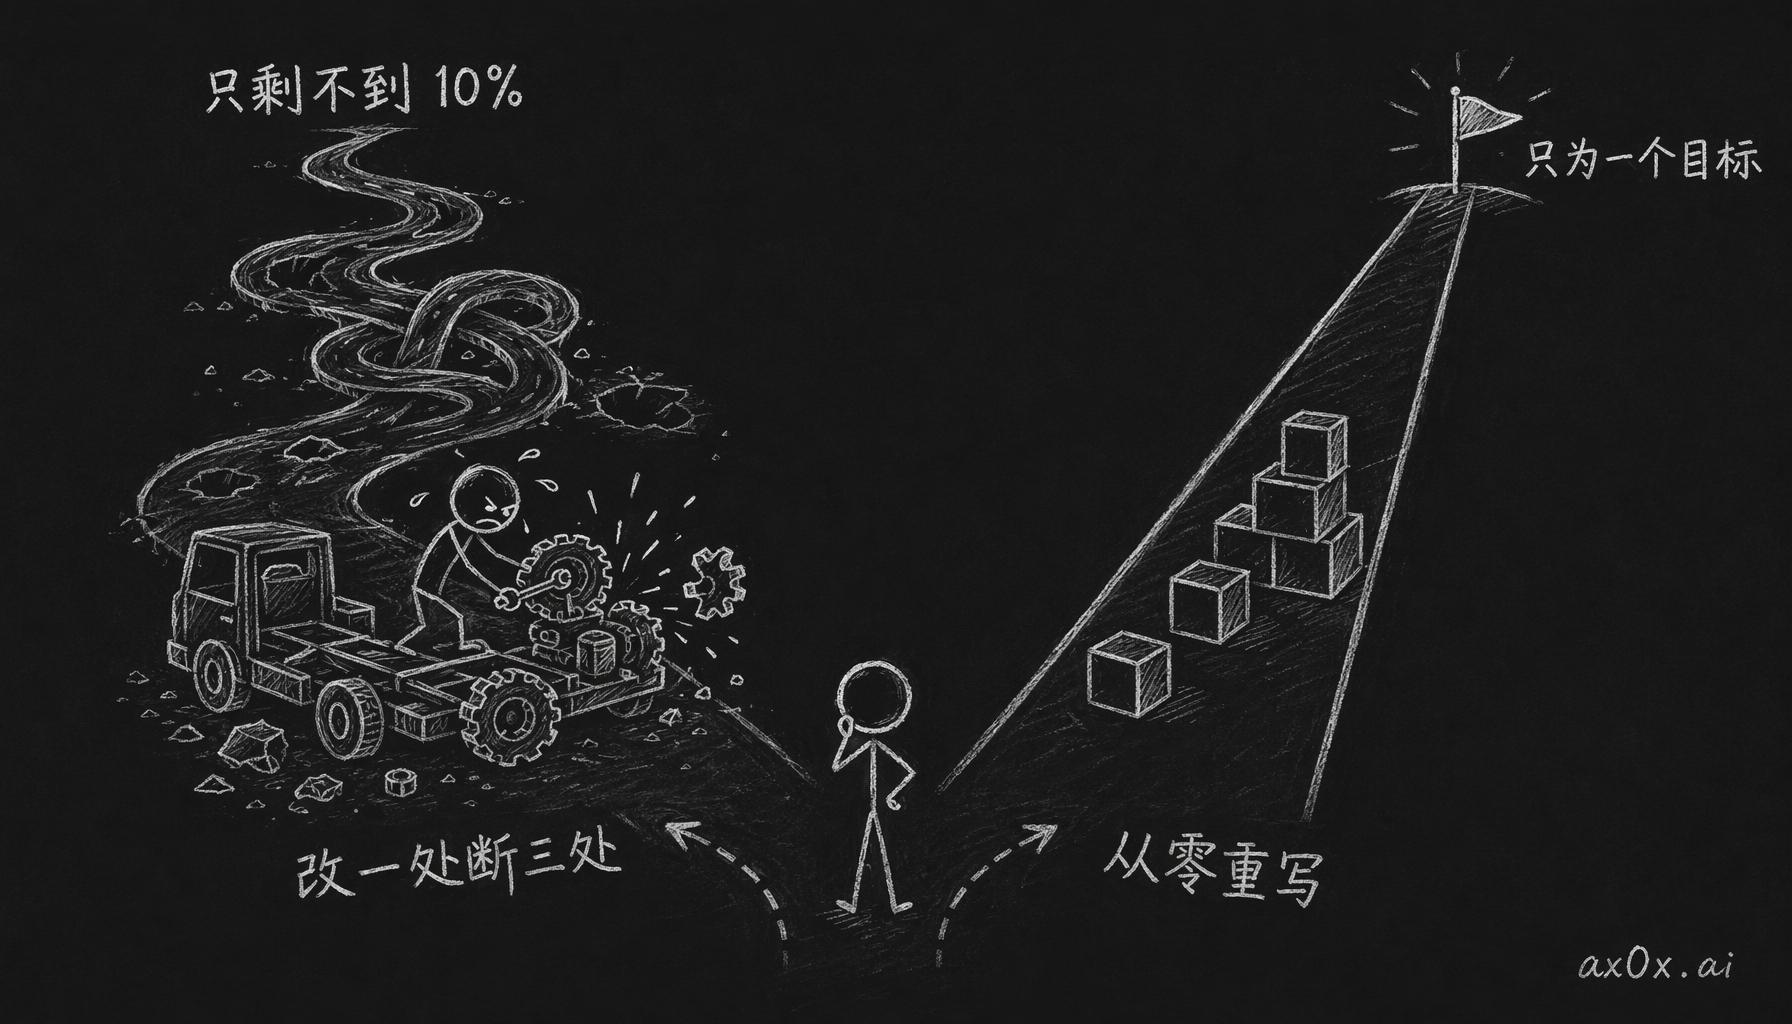 在岔路口对比:修补要不断对抗框架设计假设、最后只剩不到一成原始代码,与从零重写只为单一目标
Mio 从第一行代码起就只有一个目标,做一个有深度记忆、有活人感的 AI 伴侣框架。渠道抽象、记忆检索、情绪状态机、成本追踪,每一个设计都是围着这个目标定的。
接下来
Mio 现在能跑了。Telegram 渠道做完了,记忆系统上线了,情绪引擎也在转。要做的还有很多:
- Discord 和飞书渠道
- Web 端聊天界面(Next.js,已经在搭)
- 自拍扩展(在 OpenClaw 上验证过的杀手功能)
- 语音消息
- worker 进程(后台任务独立跑)
- 可穿戴设备集成,感知层是下一个战场
这是「Mio 开发日记」系列的第一篇,后面会写具体的技术实现,比如记忆系统怎么设计、情绪引擎怎么调参、onboarding 流程怎么一版版改。下一篇聊 v0.0.1,一共 39 个 commit,从 pnpm init 一直到TA第一次开口说话。