把聊天切到 gemini flash,成本降了 4 倍
 模型路由优化的技术概念插画
v0.0.5 把媒体支持做完以后,Mio 能看图、能听语音、能发表情,一个 AI 伴侣该有的功能差不多都齐了。但有个问题我一直拖着没管,就是太慢。
Mio 聊天一直靠的是 Gemini 3 Pro Preview,开着 thinking,首 token 要等 8 到 10 秒。8 秒有多长?你发一句「今天过得怎么样」,然后就盯着那个「正在输入」干等,七八秒以后才开始出字。聊天的产品让人等这么久,聊天的感觉基本就没了,你甚至会怀疑它是不是卡死了。开发的时候我一直忍着,反正在赶功能。等功能做完回头再看,最扎眼的就是这个延迟。
先跑一轮对比测试
我没拍脑袋直接换,先认真做了一轮对比,拿 Gemini 3.1 Pro 和 Gemini 3 Flash 专门按情感伴侣的场景去测。结果大概是这样:
| 指标 | 3.1 Pro | 3 Flash |
|---|---|---|
| 输入成本 | ~4 倍贵 | 基准 |
| 输出成本 | ~4 倍贵 | 基准 |
| 输出速度 | 90.8 t/s | 214 t/s |
| 首 token 延迟 (thinking) | 8-10s | 1-2s |
| 首 token 延迟 (minimal thinking) | N/A | 1-2 秒 |
成本差 4 倍当然重要,但真正让我拍板的是延迟。1-2 秒对 8-10 秒,用户是直接能感觉出来的。
剩下就是质量。做伴侣 AI,情感细不细腻就是产品本身,Flash 要是撑不住人设,省再多钱也没用。我查了一圈,社区的看法出奇地一致,都说 Flash 基本能顶替 2.5 Pro 来用。在特别细腻的情感表达上,两个大概差 1-2%,专业写东西的人分得出来,大多数用户分不出来。至于主动推剧情、人设前后一致这两点,Flash 反而更强。
还有一点挺反直觉,开 thinking 反而会让创意写作变差。好几个开发者都说过,Gemini 开了推理以后,情感和创意的输出反而不如不开。大家推荐的配置是 thinkingLevel: minimal,刚好也能把首 token 压到 1-2 秒。这么一算,切 Flash 基本没代价,速度和成本都赚了,质量也不掉,没什么好犹豫的。
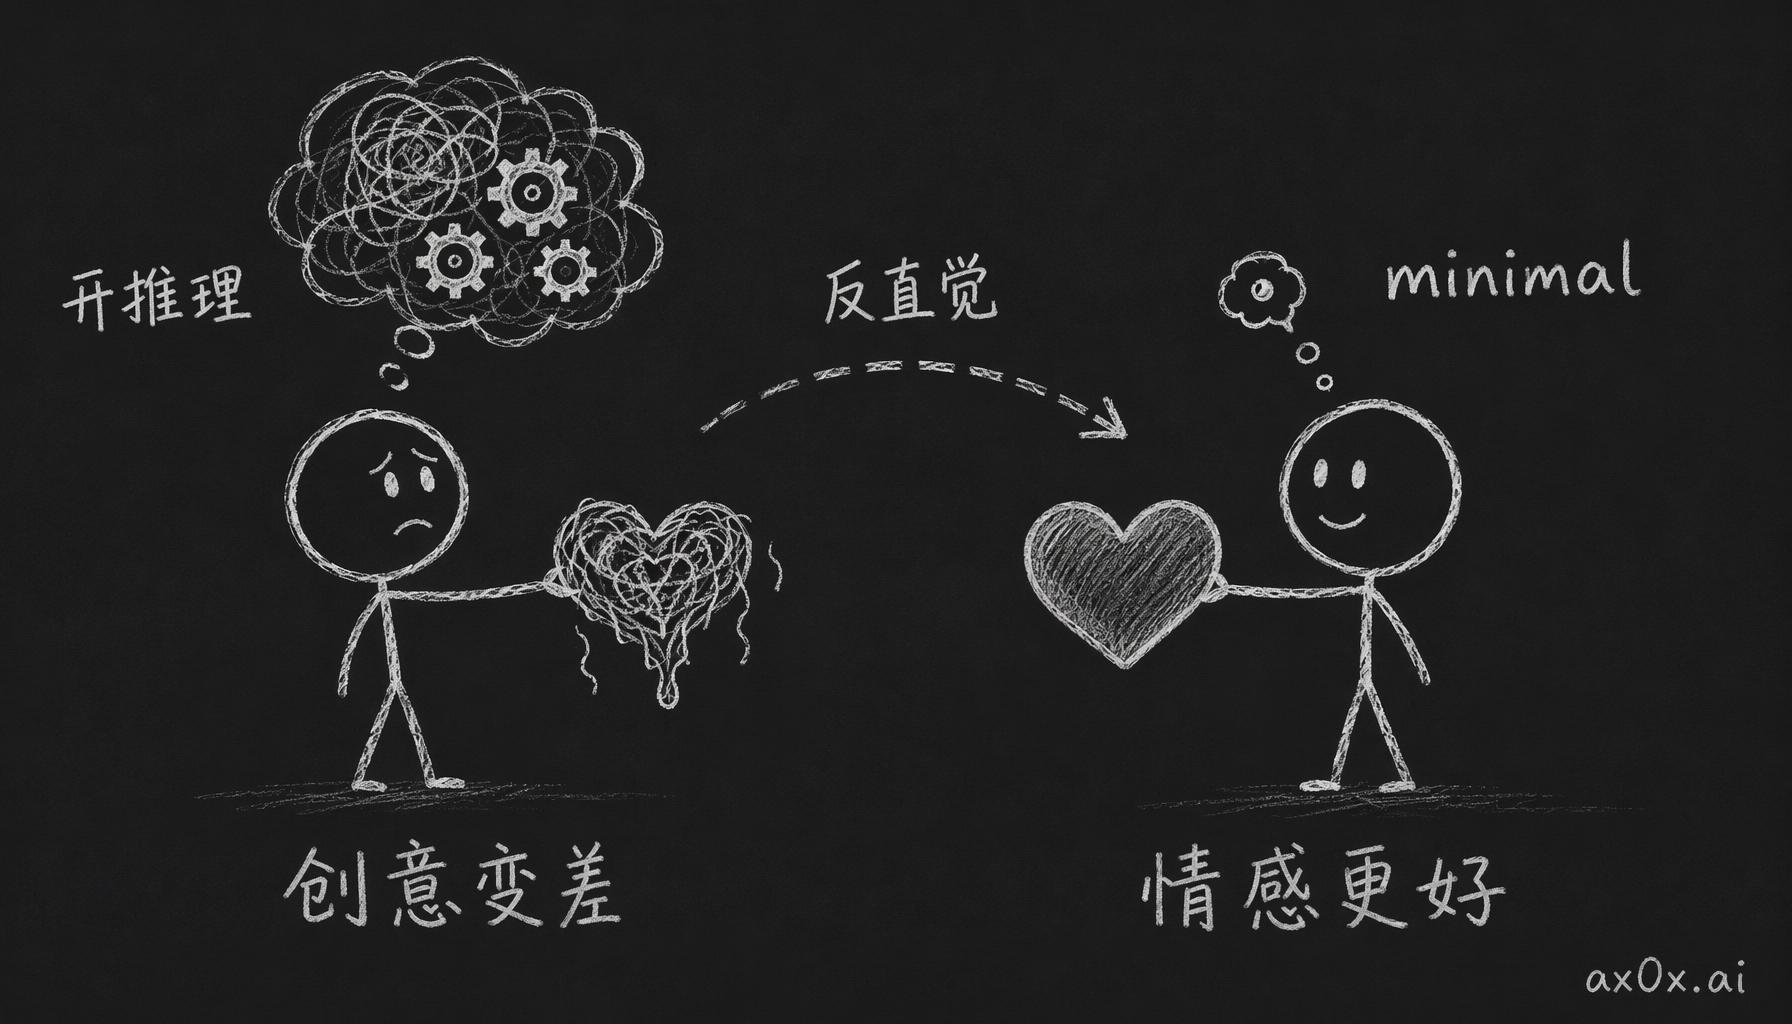 反直觉的反转:开推理模式反而让创意和情感写作变差,用 minimal thinking 反而更好。
按任务类型路由
想清楚以后,方案就很直接了。任务有轻有重,日常聊天要快,人格提取这种要深,那就按任务类型路由。
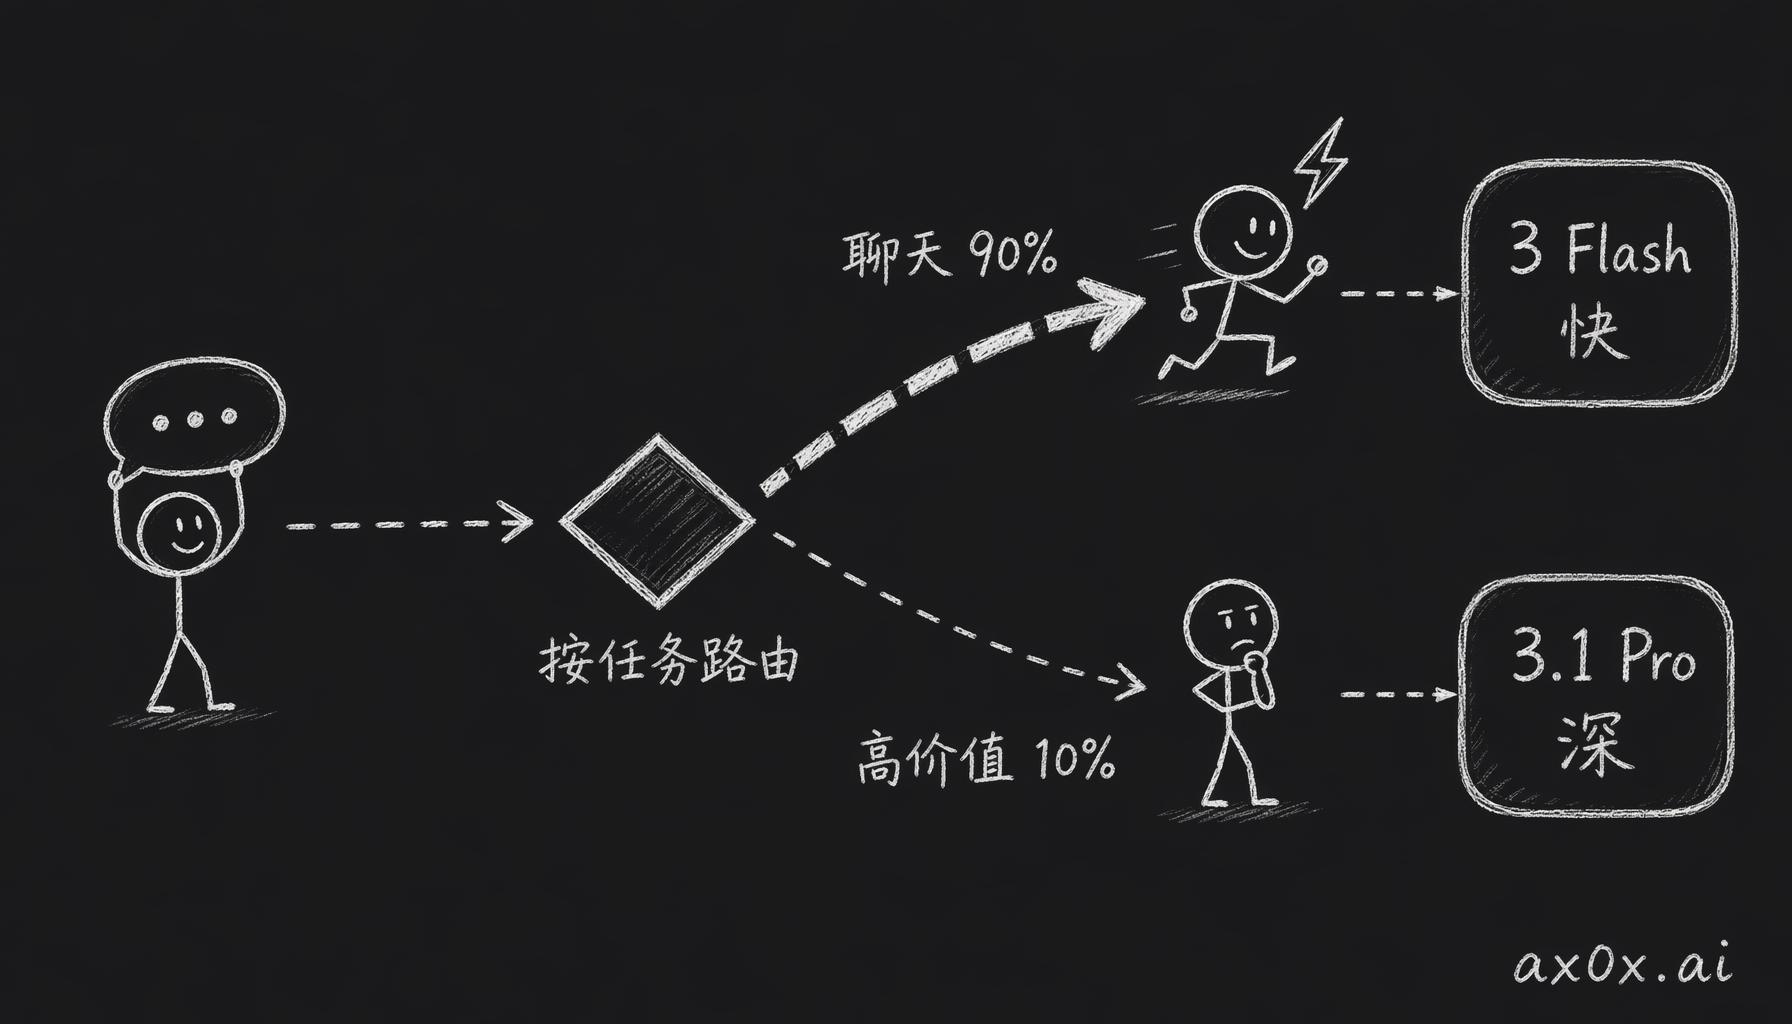 按任务类型把请求分流:90% 日常聊天走便宜快的 Flash,10% 高价值任务走贵而深的 Pro。
聊天(90% 的 API 调用):Gemini 3 Flash + thinkingLevel: minimal
- 首 token 1-2 秒
- 每秒吐 214 个 token
- 每百万 token 的成本大概是 Pro 的四分之一
- 日常聊天的情感细腻度完全够用
高价值任务(10% 的 API 调用):Gemini 3.1 Pro + thinkingLevel: low
- 从引导对话里提取人格特征
- 做记忆摘要,分析情感模式
- 这类任务算一次就把结果缓存起来,平时很少调,用贵一点的模型也无所谓
这么一拆,90% 的流量成本降了 4 倍。剩下 10% 的高价值任务从 3 Pro 换成了 3.1 Pro,质量反而还升了。
视觉 prompt 重写了一版
v0.0.5 加了图片上传,AI 能看图了,但说出来的东西特别泛。你发一张游戏截图,它回你「我看到一个彩色的游戏画面」。这种回复没什么用。你跟朋友说在打游戏,朋友会问「什么游戏?」,没人会回你「我看到一个彩色的画面」。
v0.0.6 重写了视觉 prompt,要它说具体的。游戏要叫出名字,品牌和 logo 要认出来,说到地点要带上具体信息。看图的 thinking 级别也从 minimal 提到了 low,会慢一点,但看得明显更懂。改完以后,它的回复大概就从「我看到一个游戏」变成了「你在玩原神?新地图怎么样?」。
中文语音转写修了两个地方
语音转写一直有 bug。用户发一段普通话语音,转出来的字里会冒出英文单词,或者口语的说法直接被漏掉。这次修了两个地方:
- OpenAI 转写器明确加上了
language: 'zh'参数。不加的话,模型会一段一段自己猜是什么语言,碰到中英混着说或者背景有噪音,就容易猜错。 - Gemini 备用 prompt 加强了口语、网络用语和中文专有名词。OpenAI 转写置信度不够的时候会走这条备用路径,现在俚语和一些特定的名词都能转对了。
改动本身很小,但语音是用户和 Mio 最亲近的交流方式,转写老出错,体验会伤得挺重,所以这两处其实很要紧。
顺手清掉 80 行重复代码
还有个代码质量的问题,从 v0.0.5 就一直搁着。POST /chat 和 POST /chat/stream 这两个 handler 里,解析媒体和拼 context 的逻辑几乎一模一样,其实就是复制粘贴过去的,大概 80 行。这次抽了两个共享函数出来:
resolveMedia()— 按 mediaId 取出待处理的上传,校验一下,返回处理好的媒体prepareChatContext()— 把历史记录、人设和媒体拼成对话 context
现在两个 handler 调的是同一套函数,那 80 行重复就没了。v0.0.5 的 audit 早就把这个问题标成了 MEDIUM,这次正好修掉。
Google 不想让 Gemini 当情感伴侣
调研的时候我还注意到,Google 明确表过态,不希望 Gemini 被拿去做情感伴侣 AI。他们团队的负责人公开说过,Gemini 的定位是「超级工具,不是情感伴侣」。具体有三个风险:
- 外部的安全过滤器是单独跑的,就算设了
BLOCK_NONE,它也可能在回复说到一半的时候把内容删掉 - Google 封过拿 API 做角色扮演这类场景的开发者
- 以后的模型版本可能会把情感和创意的输出管得更严
这件事不影响 v0.0.6 的选择,今天最好的还是 Flash。但架构上得留个后手。Mio 要足够 model-agnostic,哪天真被限制了,不用重写应用就能把 provider 换掉。刚搭好的模型路由层干的正好就是这个,等于顺手把后路也铺好了。
这一版改了什么
v0.0.6 前后就几个小时,一共六个 commit,每个都是小改,但用起来感觉好了挺多:
| 变更 | 影响 |
|---|---|
| 聊天模型:3 Pro → 3 Flash (minimal thinking) | 成本降 4 倍,首 token 1-2 秒 |
| 高价值任务:3 Pro → 3.1 Pro (low thinking) | 关键处的情感细腻度更好 |
| 视觉提示词 + thinking 级别 | 具体识别替代泛泛描述 |
| 中文语音转写 | 准确的普通话语音识别 |
| DRY 重构 | 消灭 80 行重复代码 |
| 部署文档 | 修正 Artifact Registry 命令 |
这个系列的第零篇做过一次取证分析,拆的是上一个伴侣框架早期为什么烧钱烧到撑不下去。那次学到的就是成本得先算清楚,不能等钱烧完了再回头算账。v0.0.6 选模型也是这么来的,先跑延迟基准,再算成本、比质量,还看了社区的经验,没凭「Pro 听着比 Flash 高级」这种印象拍板。调研说 Flash + minimal thinking 是对的,部署以后也确实是这样。
现在发消息,一两秒就开始出字了,聊起来舒服很多。至于 Google 那个态度,先记着,反正路由层已经搭好了,真到那天再说。