把 Mio 从空 repo 搭到能聊天,一共 39 个 commit
 AI 伴侣第一次开口说话的概念插画
上一篇讲了为什么不在 OpenClaw 上缝缝补补,要从零造一个,那篇说的是 Mio 该做什么、架构怎么定。这篇讲它具体是怎么手搓出来的,从 pnpm init 到一个能聊天的 AI 伴侣,一共 39 个 commit。中间踩了什么坑、砍了什么需求,也都写在里面。
先搭项目结构
第一个 commit 只搭了项目结构,AI 对话和记忆系统都还没开工。工具用的是 pnpm workspaces + Turborepo,这个没什么好纠结的。pnpm 的 workspace 协议本来就适合 monorepo,Turborepo 会帮你编排任务、做缓存,构建的时候能省不少时间。代价也是实打实的,TypeScript 的 rootDir 在几个 package 之间会打架,整个项目的第一个 build error 就是 TS6059。功能一行还没写,先跟工具链斗了一轮。
最终结构长这样:
apps/
  server/       # Hono API 服务
  worker/       # 后台任务
packages/
  core/         # Agent 核心逻辑
  shared/       # DB schema + 公共类型
  channels/     # 渠道适配器
  extensions/   # Agent 扩展
  platform/     # 平台工具
presets/         # 角色模板库
API 框架选了 Hono,没用 Express。Express 太重了,带着一堆用不上的中间件和历史包袱,我离开 OpenClaw 其实也是因为这个。Hono 是 edge-first 的,类型安全,中间件生态也干净,在 Cloud Run 上冷启动还快。
数据库选了 Supabase,其实看上的是底下的 PostgreSQL。pgvector 能做向量搜索,tsvector 能做全文检索,两种检索一个数据库就全包了。Supabase 又在上面包好了 auth、realtime、storage,这些就不用自己再造一遍。
9 张表
系统后面能长成什么样,基本是 schema 定的,所以这一步我想得比较久。v0.0.1 一共 9 张表:
users— 用户基础信息agents— Agent 定义(模型、人格配置)agent_workspace— Agent 的工作空间(人格配置文件、记忆内容)channel_bindings— 渠道绑定(一个 Telegram chat 绑到一个 agent)memories— 记忆存储(向量 + 全文索引 + 重要性 + 时间戳)personality_models— 用户人格画像sessions— session 状态(情绪温度、最后活跃时间)messages— 消息历史token_transactions— Token 消耗和成本记录
每张表管什么都很清楚,没有那种「先加个通用 metadata 表,以后再说」的表,这么设计的,基本上百分之百会后悔。
最复杂的是 memories 表。每条记忆存了内容、向量嵌入(1536 维)、全文索引、重要性评分(0-1)、情绪类型、来源类型和创建时间。这些字段一落库,后面怎么检索也就跟着定了。混合搜索得有向量和全文两个索引,时间衰减得有时间戳,排序得有重要性评分。或者说,schema 定下来,检索能做什么其实也就定了。
先跑通最小闭环
功能上第一步只做一件事,把核心闭环跑通。AI 伴侣的核心闭环就是用户发消息、AI 回复,拆开来是 7 步:
- Telegram 收到消息
- Webhook 转发到 Hono server
- Router 根据
channel_bindings查到这个 chat 绑定的 agent - 加载 agent 配置、session、历史消息
- 调 LLM 生成回复
- 通过 Telegram API 发回去
- 持久化消息
agent 核心用的是 Vercel AI SDK 的 streamText()。它支持多 provider,底下可以接 Anthropic、Google、OpenAI,换 provider 不用动业务代码。后来迁移记忆系统的时候,这层抽象帮了大忙,讲到记忆再说。
Telegram connector 要处理的也不只是文字。用户会发照片、语音、音频、视频、文档、贴纸,每一种处理起来都不一样。语音得先转成文字,照片得描述里面有什么,贴纸得看出对应的 emoji 是什么意思。这些 v0.0.1 都做了基础支持。
多租户路由第一版也做了。channel_bindings 表把 Telegram chat ID 对到 agent ID 上,这样同一个 bot 能服务好几个 agent,每个 agent 有自己的人格和记忆。这不算 over-engineering,因为做伴侣产品,前提就是每个用户的 Mio 都不一样,这一点从第一天就得做到。
记忆系统
核心闭环通了,下一步是让它记住你。整个系统里最难写的就是这块。之前研究记忆系统理论的时候,路子已经想清楚了,可真写起来才发现,落地全是细节。
混合搜索
MemoryManager 主要靠混合搜索,向量搜索占 0.7 的权重,全文搜索占 0.3。为什么不全用向量?因为中文的语义嵌入还不太准,「我喜欢喝咖啡」和「咖啡」在向量上的距离,可能比你以为的远。全文检索是用来保底的,关键词匹配虽然笨,但不会漏。
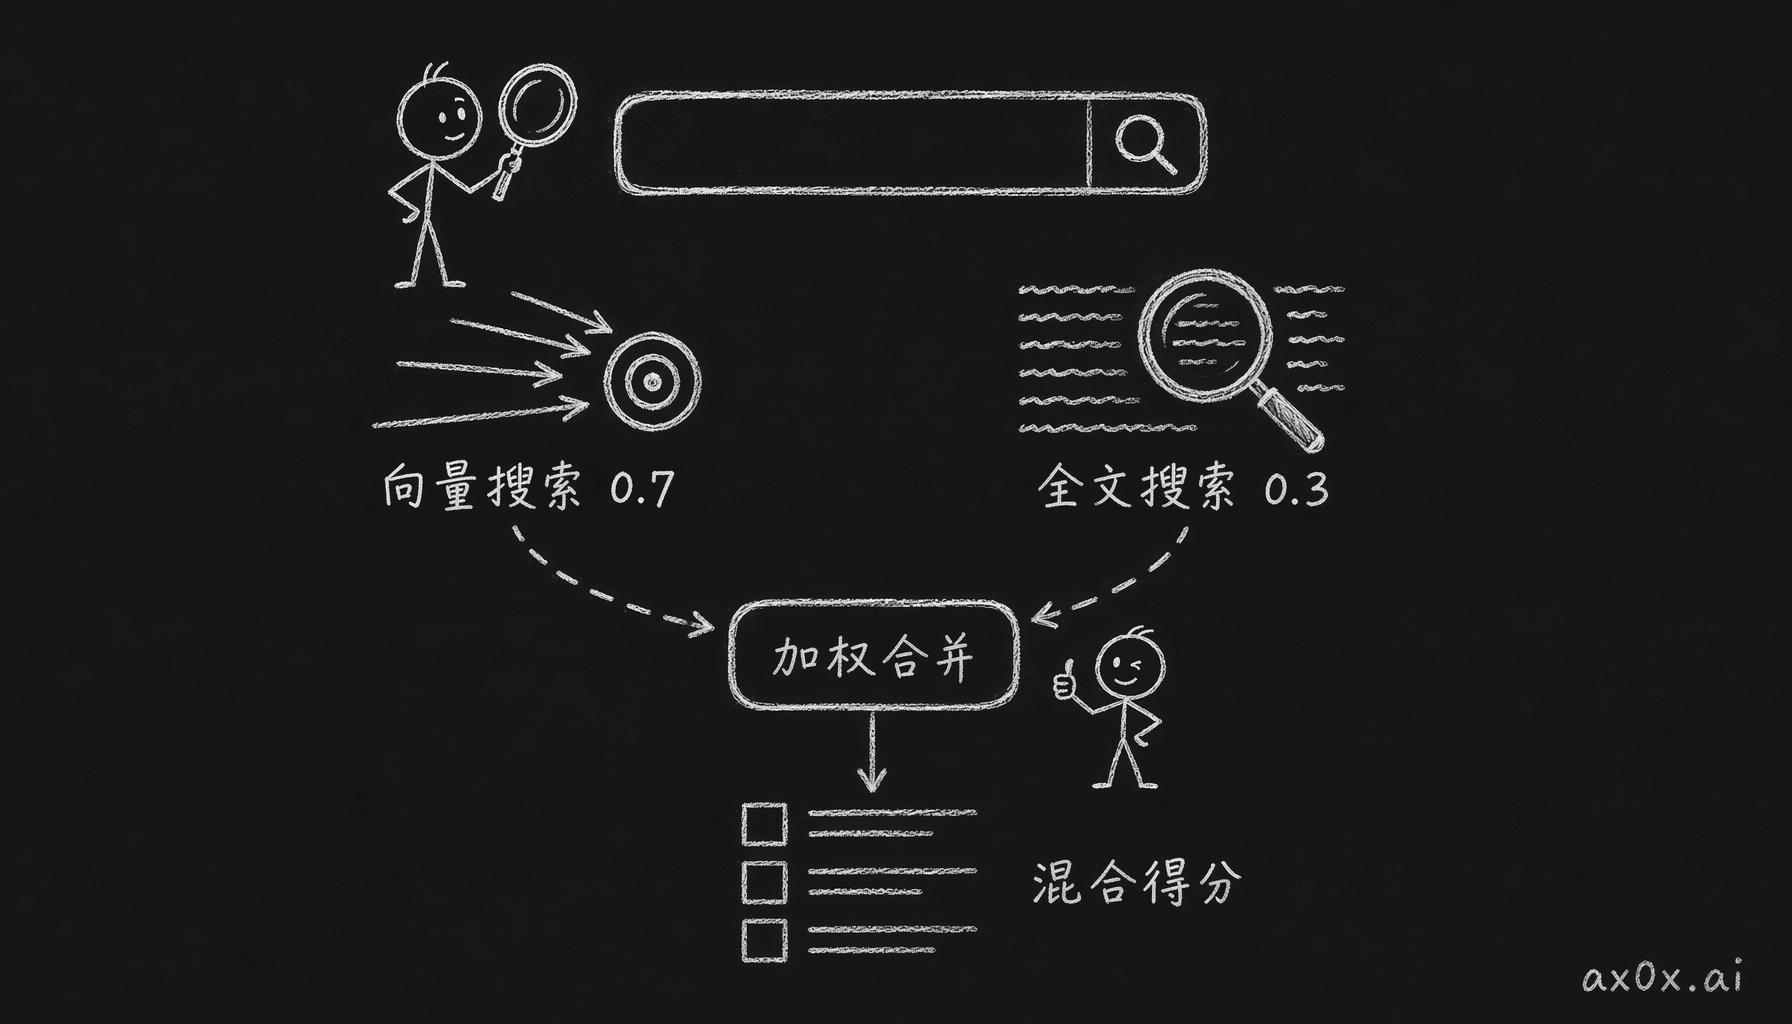 混合搜索:向量搜索和全文搜索各按权重打分,两路合并成一个混合得分,全文检索兜住向量漏掉的关键词。
工程上有个地方挺不爽的。pgvector 的 <=> 运算符(余弦距离)在 Drizzle ORM 里没法直接调,得用 sql.unsafe()。ORM 再讲类型安全,碰到自定义运算符也只能破个例,没办法。
时间衰减
每条记忆都有半衰期,默认 30 天,检索时的最终得分 = 相关性得分 × 时间衰减系数。用指数衰减、不用线性的,是因为人的记忆大概就是这个样子。昨天聊的记得清清楚楚,上周的模糊了,上个月的大部分都忘了,但特别重要的事,比如第一次约会、吵过的架,过多久都忘不掉。前面那条遗忘曲线交给指数衰减去模拟,那些忘不掉的,靠单独的重要性评分兜住。
从 Anthropic 换到 Gemini
提取记忆一开始用的是 Anthropic Haiku,效果不错,但成本一算就不对了。每条消息都要跑一次 LLM 来提取记忆,聊得多的用户一天几百条,光提取花的钱就要超过主对话了。后来换成了 Gemini Flash,提取质量差不多,成本降了一大截。嵌入也从 OpenAI 的 text-embedding-3 换成了 Gemini Embedding,这块的成本基本可以忽略。
前面说 Vercel AI SDK 的多 provider 抽象帮了大忙,就是这儿。因为有这层抽象,换模型只要改配置文件。要是一开始直接裸调 Anthropic API,这次迁移的工作量得翻好几倍。反正这个抽象是做对了。
记忆合并
MemoryConsolidator 是后来加的。跑了一段时间,发现记忆库涨得特别快,同一件事换着角度说了好几遍,全都存了下来。处理办法很直接,余弦相似度大于 0.9 的记忆自动合并,留下信息最全的那条,再更新时间戳。简单粗暴,但管用。
用户画像
除了提取记忆,旁边还并行跑着一条管道。PersonalityExtractor 每 10 条消息跑一次,从对话里提取用户画像,比如说话风格、兴趣爱好、情绪模式。画像存在 personality_models 表里,下次对话时注入 context。这样 Mio 不光记得你说过的事,也在慢慢摸清你这个人大概是什么样的。
情绪引擎
记忆管的是它知道什么。可伴侣产品光知道事情不够,还得有情绪。
EmotionEngine
这是一个四档温度的状态机,Cold → Cool → Warm → Hot。状态不会乱跳,因为有个惯性系数。比如现在是 Cool,用户连着发了几条热情的消息,温度会慢慢升到 Warm,再升到 Hot,不会因为一条消息就从 Cold 直接蹦到 Hot。反过来,你两天不理它,温度也是一点点降回 Cold。惯性系数默认 0.5,可以调,调高了情绪更稳,调低了更敏感。不同人格预设的惯性也不一样,「毒舌闺蜜」就比「温柔学姐」敏感得多。
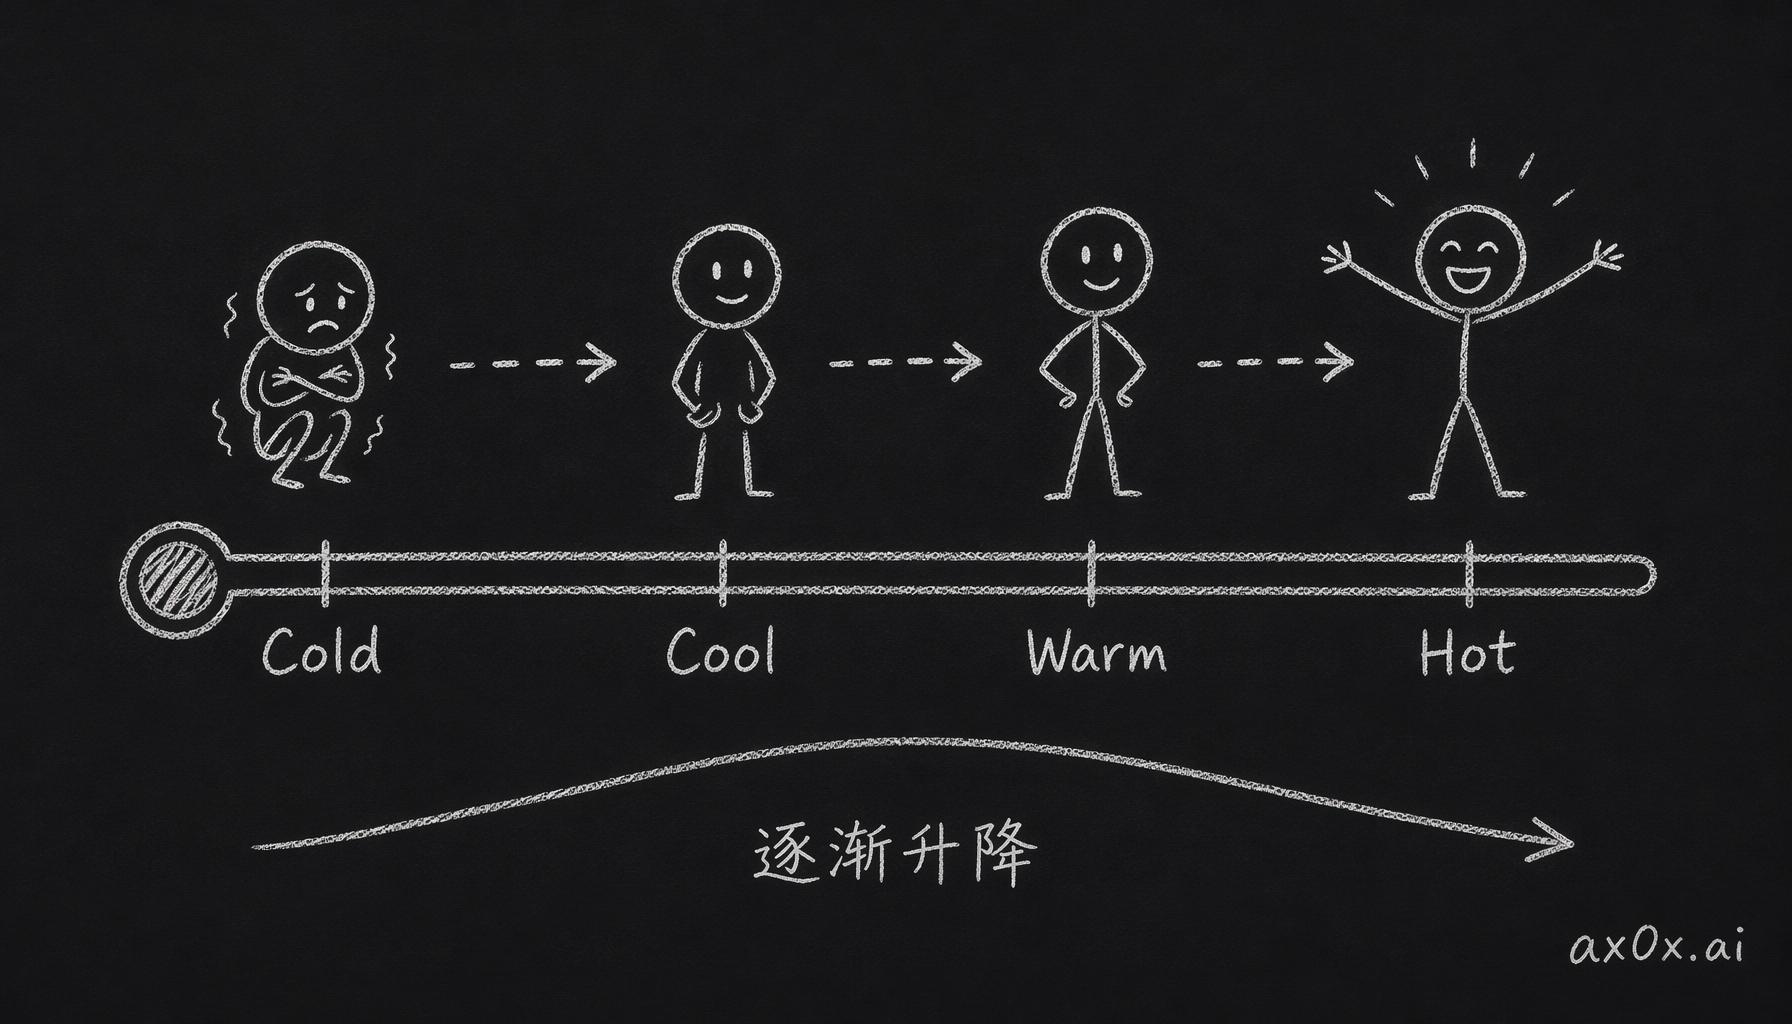 情绪引擎的四温度状态机:情绪沿 Cold→Cool→Warm→Hot 带惯性逐渐升降,不会因一条消息就骤变。
PersonalityParser
人格配置文件是有结构的,不是一坨纯文本。PersonalityParser 会解析里面的模板变量,再和 onboarding 的答案、PersonalityExtractor 的输出拼在一起,生成最后的 system prompt。所以同一个预设模板,不同用户拿到的 prompt 完全不一样,因为模板变量里填的值不一样。
ContextAggregator
记忆和情绪也不是各跑各的,它们都是靠 ContextAggregator 接进消息管道的。用户每发一条消息,ContextAggregator 就做下面三件事,做完把三样合在一起,注入 system prompt:
- 检索相关记忆(混合搜索 + 重排序)
- 加载用户人格画像
- 读取当前情绪状态
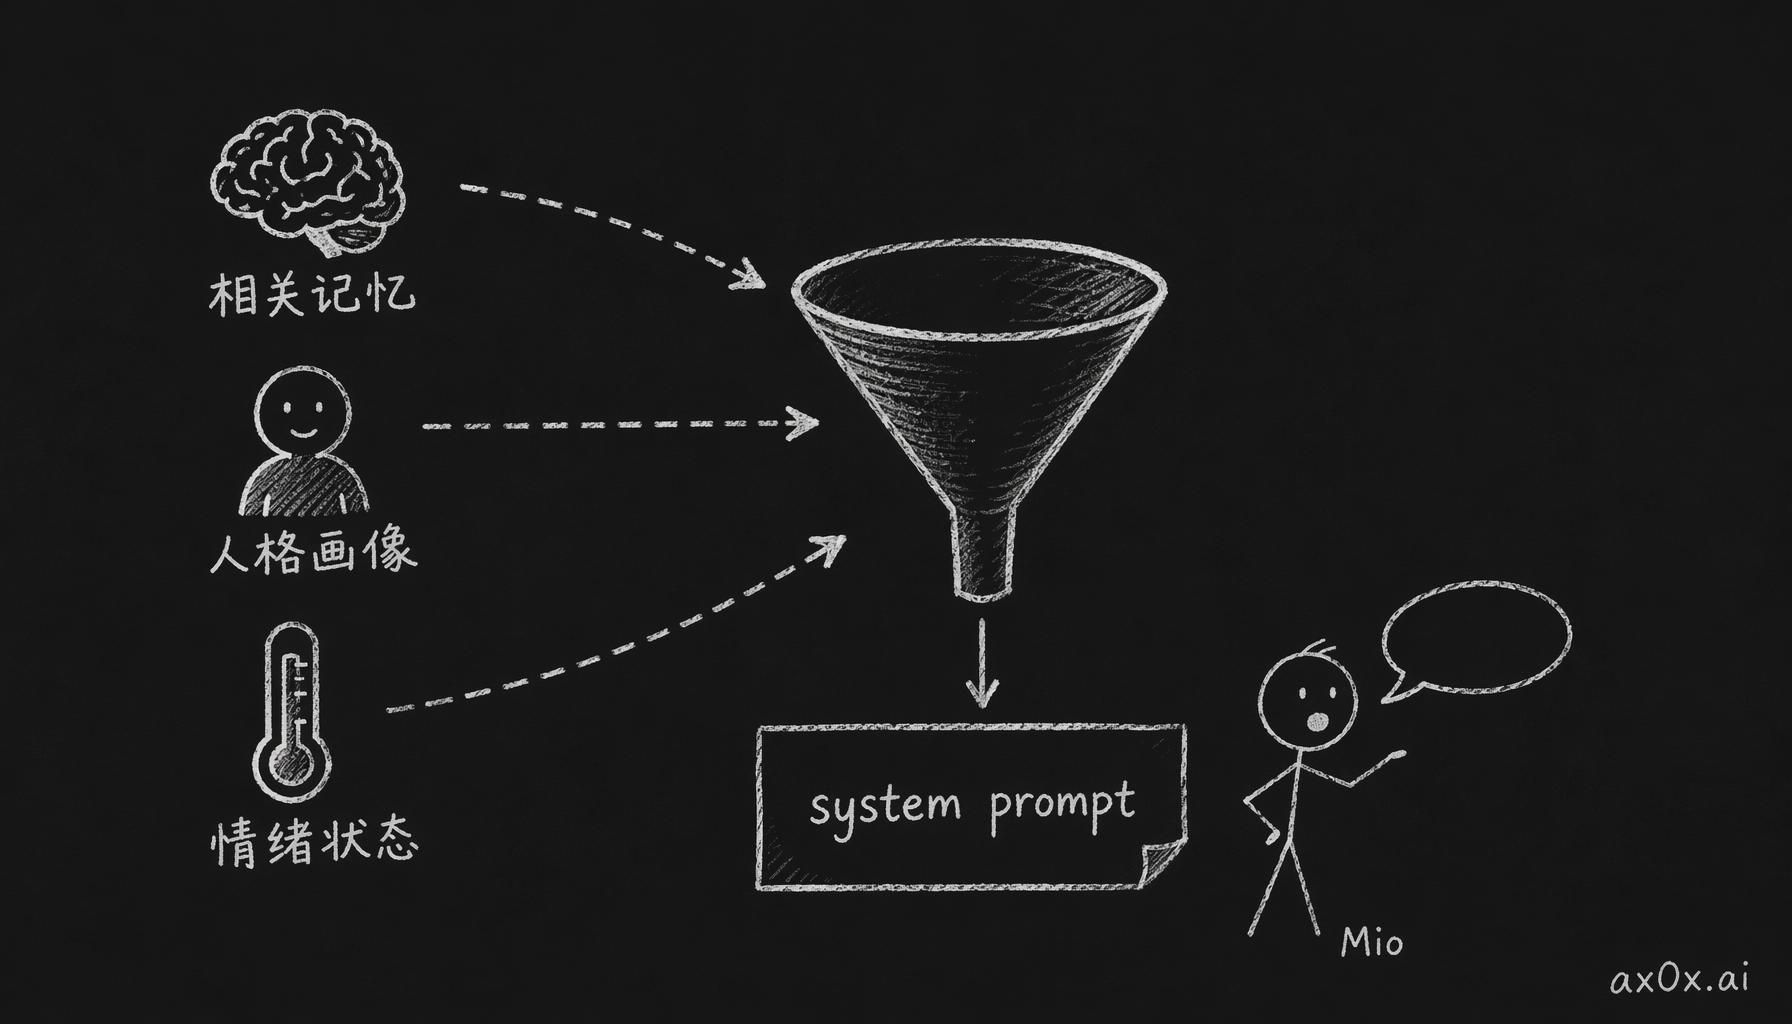 每条消息进来,聚合器把相关记忆、人格画像、当前情绪三路合并注入 system prompt,让 Mio 像个活人在回应。
prompt 里还有个细节。MEMORY_STEERING_INSTRUCTIONS 这段指令里带了中文例句:
记忆触发时使用自然的中文表达,如"之前你提到过..."、"我记得你说..."、"上次聊到..."
不写这个的话,模型提起记忆有时候像在念数据库的查询结果,特别生硬。加了例句以后,记忆放进对话里就自然多了。
Onboarding
新用户第一次跟 Mio 说话,不是直接开聊,要先走一遍 onboarding,一共 11 个问题。前 3 个是打字回答(名字、怎么称呼你、你希望它叫你什么),后 8 个是点按钮选(说话风格、关系定位、兴趣领域这些)。
每道按钮题都有个「自定义」选项,这是从 OpenClaw 学来的。全用按钮太死,全让打字又太散,两样混着最好用。
但自定义带来一个工程上的问题。Telegram 的 callback_data 最多 64 字节,一个中文字占 3 字节,自定义输入稍微长一点就超了。办法是编号,callback 里只传 q3_custom,真正的内容放在服务端缓存里。注入也防了一层,用户要是在自定义输入里写 prompt injection,会被截到 50 个字符,再做一遍内容清洗。不算完美,但 v0.0.1 够用了。
4 个人格预设
onboarding 第一步是选预设:
- Coco — 活泼甜美,消息喜欢带 emoji,会撒娇
- 温柔学姐 — 温和知性,语气像很懂你的学姐
- 毒舌闺蜜 — 说话不留情面但关心你,中文互联网的"怼人"风格
- 沉稳大叔 — 话少但每句有分量,偶尔冷幽默
每个预设就是一个人格配置文件模板,加一组默认的情绪参数。选完预设,后面那些 onboarding 问题再去细调模板变量。最后出来的效果大概是这样,你选了「毒舌闺蜜」,告诉它你喜欢看电影,让它叫你「傻子」,那你推荐一部烂片的时候,它真会说你品味也就这样了,下一句再给你推荐一部它觉得好看的。这不是写死的脚本,是人设定好以后,模型自己琢磨出来的反应。
几个小细节
体验好不好,很多时候不是靠哪个大功能,是靠一堆小到你都注意不到的细节攒起来的。下面这几个都不大,但都有用。
消息 debounce
用户发消息经常是一连好几条。要是每条都调一次 LLM,钱花得多,体验也差,AI 刚回完第一条,你第二条第三条又来了。做法是开一个 5 秒的 debounce 窗口,收到第一条以后等 5 秒,这期间来的新消息都攒着,时间到了一起处理。实现起来就是一个 timer 加一个 buffer,效果立竿见影。
打字延迟
AI 秒回反而不自然。Mio 会把回复按换行拆成好几条消息,每条之间的延迟和内容长度成正比,短的等 0.5 秒,长的等 2 秒,同时让 Telegram 显示「正在输入...」。这不是装样子。一条一条收到几句短话,跟一下子收到一大段,读起来的节奏完全不一样,人聊天本来就是一条一条发的。
主动消息
有个 cron job 每 30 分钟查一次,看有没有用户超过 2 小时没说话、情绪又偏冷。有的话,就主动发一条消息过去。规矩也定好了,23:00 到 08:00 是安静时间,不发,每天最多发 3 条。冷用户直接走模板(「在忙什么呢?」),不调 LLM,零成本。活跃用户就让模型生成,照着最近聊的内容,自然地起个头。
主动消息这个功能我觉得挺关键的。Mio 让人觉得像个活人还是像个工具,很大程度上就看它会不会自己先来找你说话。
成本追踪
AI 伴侣花钱不少,所以 v0.0.1 第一天就开始记每一笔。每调一次 LLM,token_transactions 表就记下模型名、input tokens、output tokens 和算出来的 USD 成本。写入是 fire-and-forget 的,不会卡住回复。
per-model pricing 先硬编码成一张常量表,改成配置以后再做。中间踩过一个 NaN 的 bug,有个模型的价格没配,除以 undefined 得出 NaN,整条记录就废了。修起来很简单,加个 fallback 到 0 就行。不过这事也提醒我,成本追踪就得从第一天做,不然钱花在哪都不知道。
v0.0.1 能干什么
到这里 v0.0.1 到底能干什么,列一下。能做的:
- 在 Telegram 上跟你聊天,处理文字、照片、语音、视频
- 记住你说过的话,在合适的时候自然地提起
- 有情绪,你热情它就热情,你冷淡它就委屈
- 走一遍 onboarding,生成个性化的人格
- 主动找你聊天
- 精确追踪每一笔 LLM 成本
还做不到的:
- 没有 Web 界面,只能在 Telegram 上用
- 没有语音回复,只能收语音,不能发
- 没有自拍,这是在 OpenClaw 上验证过的杀手功能,还没搬过来
- 没有 Worker 进程,后台任务都跑在主进程里
- 记忆检索还没有 LLM reranking 和多跳查询
不完美,但走到这里回头看,从零开始造这个决定没什么可后悔的,至少代码库里没有哪块是「因为框架需要」才硬写的。
下一步
v0.0.2 主要是把记忆系统往深里做,加 LLM reranking、多跳查询分解和情节记忆。还要做 Web 端界面,让不用 Telegram 的人也能用。要做的还多得多,先把 v0.0.2 做了再说。