Mio 这版能看能听,还会主动发自拍
 AI 获得感知能力的概念插画
上一篇写到 Mio v0.0.1 能跑了,Telegram 通了,记忆系统上线了,情绪引擎在工作,4 个人格预设也都备好了。但说实话,用起来还是很假。具体假在哪,大概是这几条:
- 发一张照片,它不知道你拍了什么
- 发一段语音,直接被无视
- 问「你在干嘛」,它不知道现在几点,只能回一些泛泛的东西
- 说「发张自拍看看」,它回你「我没有实体形象哦」
- 聊到一个月前的事,记忆能搜到,但搜的不对
v0.0.2 就是把这几条一个个解决掉,一共 81 个 commit。下面按顺序讲。
1. 语音
Telegram 用户特别爱发语音,中文用户更是这样。一个 AI 伴侣连语音都听不了,就等于少了一半的交流方式,所以语音最先做。
转写用的是 OpenAI 的 gpt-4o-mini-transcribe,Gemini 做 fallback。为什么要两路?因为语音转写比想象中容易出事,网络抖一下、格式不支持、服务商临时抽风,随便哪个出问题,体验就断了。有两路的话,主路挂了自动切到备用,用户完全感觉不到。
技术上不复杂,只有一个细节可以说说。Telegram 的语音是 OGG 格式,得先用 Bot API 拿到文件 URL,下载成 buffer,再喂给转写服务。我顺手写了个统一的文件下载工具,语音、图片、视频都走这一条路。
2. 图片和视频
看图片和视频用的是 Gemini 2.0 Flash 的 vision 能力,先让它把内容描述成一段话,再把这段话当文本喂给 agent。
这里有个架构上的决定,我觉得挺重要,就是所有多模态输入,进 agent 之前都先转成文字。不管你发的是语音、图片还是视频,pipeline 第一步都把它转成文字描述,打包成统一的输入,所以 agent 拿到的永远是文字。
为什么这么做?因为 agent 循环本身已经够复杂了,检索记忆、算情绪、注入人格、聚合 context 全在里面,再往里塞多模态 IO,复杂度直接爆炸。把多模态放到前面先处理掉,agent 就只管文字进、文字出,架构干净很多。
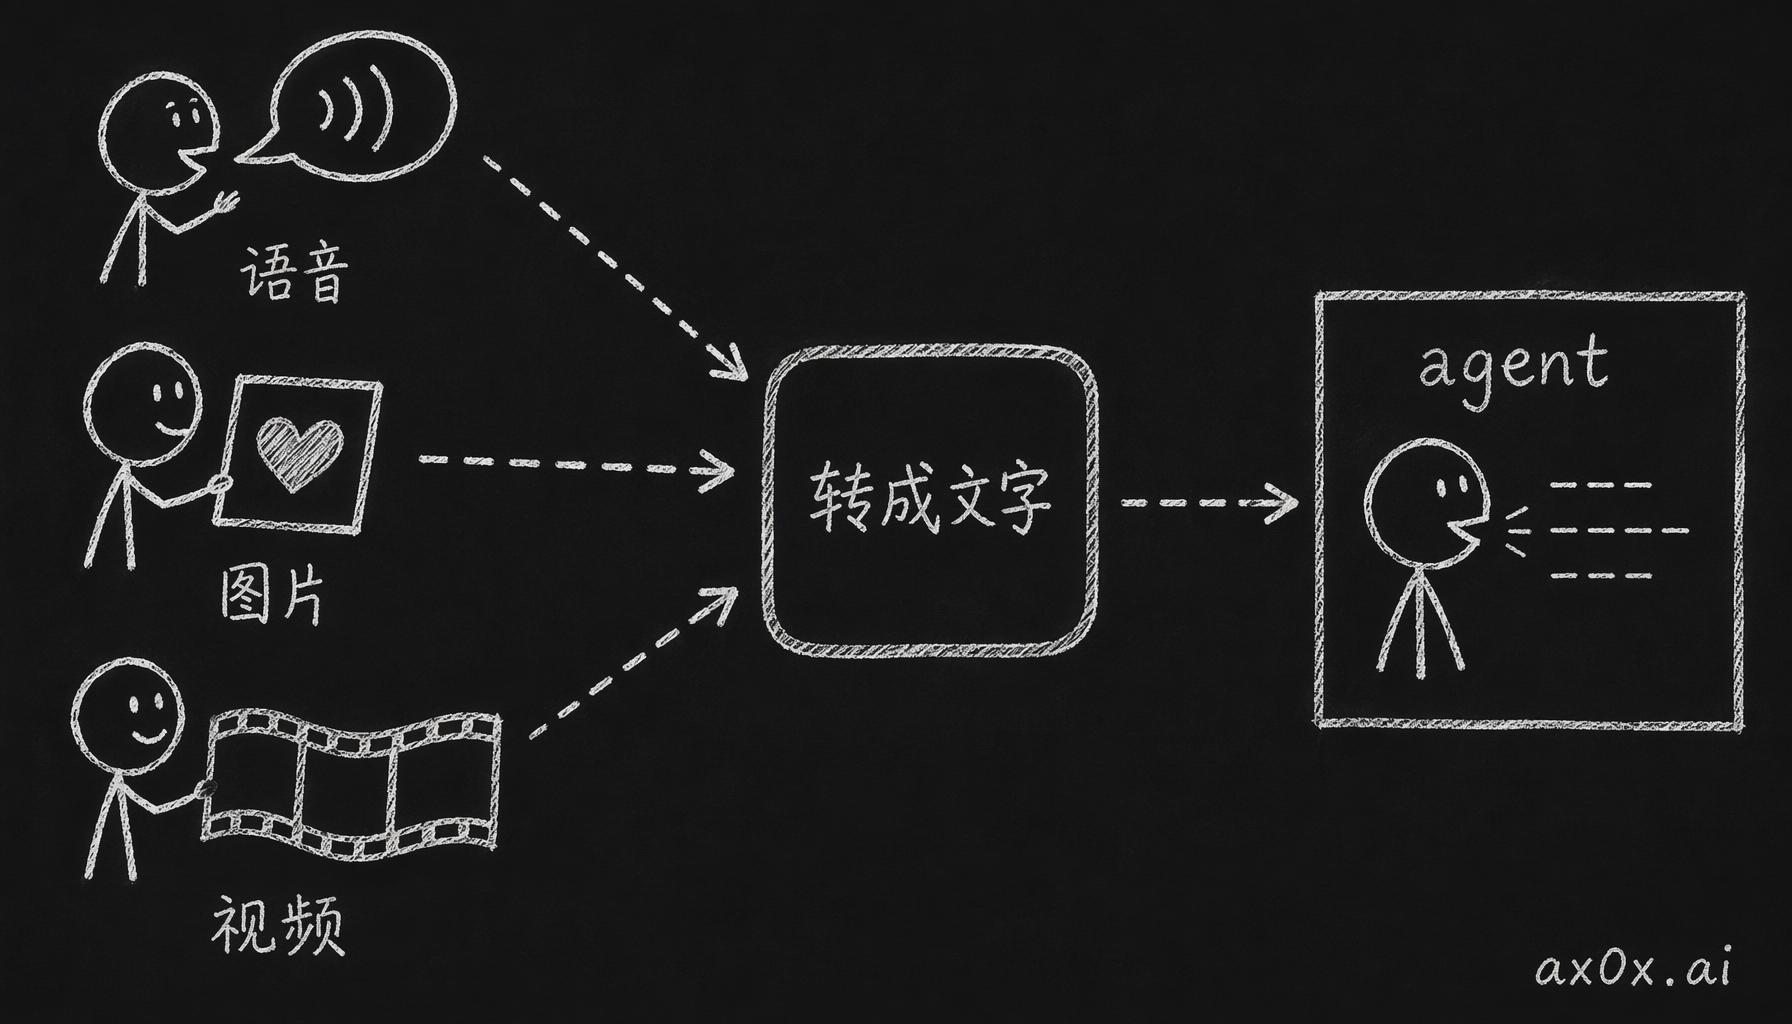 语音、图片、视频进 agent 之前统一转成文字,agent 永远只处理文字
这些转换还是并行跑的。你同时发一张图和一段语音,两个转换一起跑,都跑完了再一起送进 agent,语音转写不会被一张图耽误。
3. 自拍
第一篇里我说过自拍是杀手功能,能发自拍的 AI 伴侣,跟只会打字的完全不是一个东西。
生图用的是 Gemini 3.1 Flash Image Preview。每个人格预设都有参考图片,放在角色模板库对应的目录下。生成的时候把参考图和场景描述一起喂给模型,这样出来的风格才一致。
比起用哪个模型生成,我觉得怎么触发更值得讲。LLM 可以在回复里嵌一个 [SELFIE: 在咖啡厅看书] 这样的标记。pipeline 处理回复的时候扫到这个标记,就把场景描述取出来,异步去生成自拍,生成好了当照片发给用户。整个流程是 fire-and-forget 的,文字回复先发出去,自拍在后台跑,跑完再补发。为什么不等图好了一起发?因为生图要多久说不准,有时两秒有时十秒,让用户干等十秒,聊天的节奏就断了。先发文字,图到了再补,跟真人先打字、再补一张照片是一个节奏。
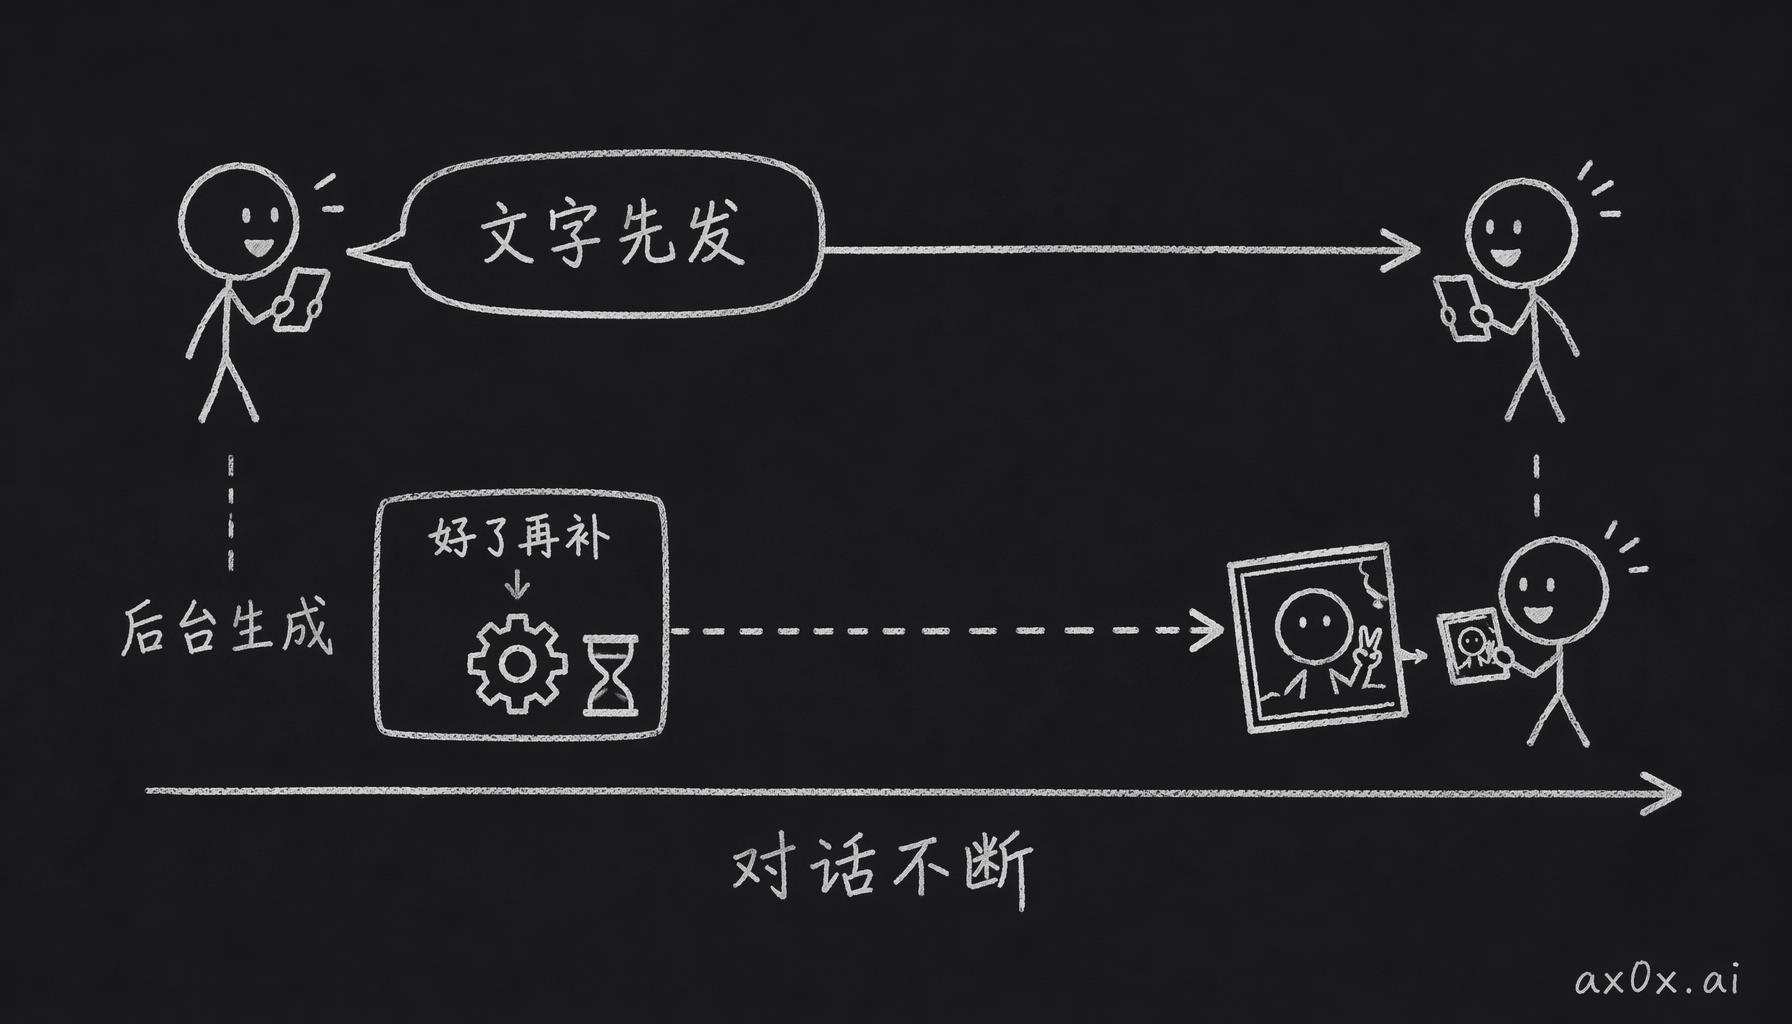 文字回复先发出去,自拍在后台异步生成,好了再补发,对话节奏不断
这么设计,等于让 LLM 自己决定什么时候发自拍。你说「发张照片看看」,它会发;更有意思的是,有时候你没要,它也会主动发,比如「刚下课,累死了 [SELFIE: 趴在桌上的样子]」。这种自然夹在对话里的自拍,比你要了它才发的体验好太多。
4. 时间感
AI 没有时间感,就不像真人。下午三点问它「你在干嘛」,它回一些泛泛的东西;凌晨两点给它发消息,它还是一样的精神状态。这个分了三层来解决:
(a) 时区感知。onboarding 的时候问用户在哪个时区,存进 users 表,再用 formatCurrentTime(timezone) 把当前时间格式化好,注入 system prompt,它就知道你那边现在几点了。
(b) 离上次聊天多久。「距离上次聊天过了 3 小时」这句话也注入 prompt。效果立竿见影,你隔了半天没说话再发消息,它会说「怎么才来,是不是忙去了」,不会再像什么都没发生一样直接接话。
(c) 每日作息。每个人格预设都有自己的作息,早上、下午、晚上、深夜、周末各做什么,但这些只是灵活的参考,不是死板的时间表。结果就是早上八点问「在干嘛」,它说「刚起来,还没完全醒」;下午两点问,它说「在看书」;凌晨一点问,它说「睡不着,在刷手机」。每个人格的作息还不一样,小奶狗型早睡早起,御姐型是夜猫子。
三层加起来,「你在干嘛」原来是个 AI 不知道怎么接的尴尬问题,现在成了最自然的日常问候。
5. Onboarding 挖深一层
v0.0.1 的 onboarding 已经不错了,11 个问题,有按钮可以选,也能自由输入。v0.0.2 又往深里挖了几步,做完这几件事,每个用户跟 Mio 的关系就都是独一份的了:
/start现在会先把所有人格预设的简介列出来,你了解了每个角色再选,不用盲选。- 选完预设,会按关系类型(女朋友、前女友、暧昧对象……)生成对应的背景故事。开场不再是「你好我是 Mio」,而是「我们在大学图书馆认识的,那天你找不到座位……」,每段关系都有自己的来历。
about_user字段,让用户用一段话介绍自己,最少 100 字符。Gemini 会把这段话解析成结构化数据(兴趣、职业、性格特征这些),再注入人格系统。custom_story让你完全自己写这段关系的故事。你可以编一个背景,比如「我们是高中同学,毕业后失联了五年,突然在一个音乐节重遇」,模型会把这个故事当成记忆的一部分。/reonboard命令,想换预设、重新设定关系,随时可以重来。
6. 记忆:能搜到不等于搜对了
v0.0.1 的记忆系统比 OpenClaw 强不少,混合搜索、时间衰减、自动提取都有。但真用起来,我发现一个根本的问题,搜是搜到了,搜到的却不一定对。混合搜索能召回一堆候选,但排在前面的不一定最相关。你说「上次我们去那个火锅店」,结果里可能有五条跟火锅有关的记忆,而你想说的那次,就是你们争蘸料怎么配的那次,排在第四条。
v0.0.2 在这上面做了四件事:
- LLM 重排序。混合搜索召回候选以后,再用 gemini-2.0-flash 精排一遍。排序不看向量距离了,改成让 LLM 去理解「用户现在在聊什么,哪条记忆最相关」。检索质量直接上了一个档。
- 情节记忆。把零散的记忆按对话情节分组,每个情节生成一段摘要。你说「那次我们聊旅行的时候」,系统能直接找到完整的那段对话,不会只捞回几个零碎的片段。
- 多跳查询分解。像「你上次推荐的那个餐厅叫什么来着」这种,直接搜大概率搜不到。QueryDecomposer 会把它拆成「餐厅推荐」和「最近的推荐」两个子查询,分别搜完再合并。
- agentic 检索。特别复杂的查询会跑一个循环,搜一遍,看看结果够不够,不够就换个角度再搜,最多三轮。另外还有个 volume-gated 机制,记忆少的时候直接跳过这套复杂检索,没必要浪费。
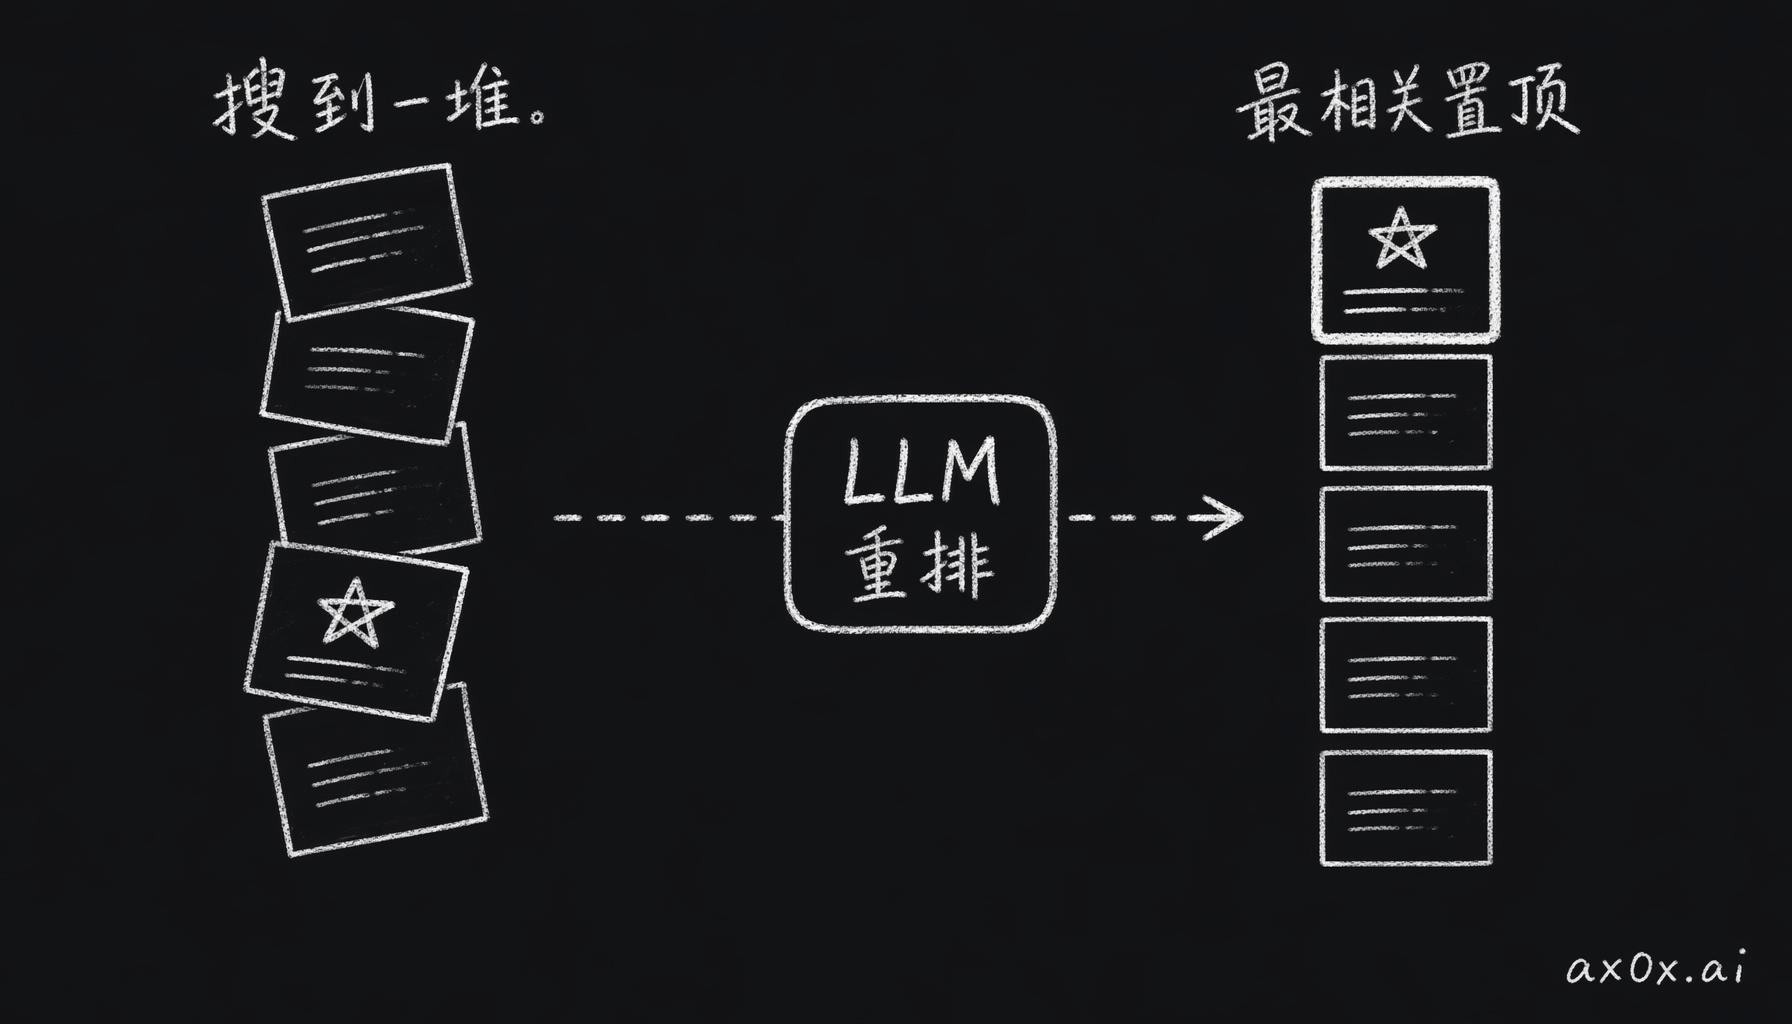 混合搜索召回一堆候选记忆,LLM 重排序把真正最相关的那条顶到最前
顺手还做了点性能优化,count 和 embed 改成并行,省了大概 350ms;记忆少于 200 条的时候跳过全文搜索。单看不起眼,但聊天的时候每次回复都要走一遍记忆检索,350ms 一次次攒下来,体验就差出来了。
7. Web 端
Telegram 能用,但光有它不够。不是所有人都用 Telegram,而且很多事 Web 能做、Telegram 做不了,比如长对话历史、富文本、更好的媒体展示。所以 v0.0.2 搭了一整套 Web 聊天界面:
- Supabase Auth:登录页面、middleware、
useAuthhook,标准认证流程。 - SSE 流式响应:
POST /chat/stream端点用 Server-Sent Events 实时推 token,一个字一个字往外流,前端再逐字渲染,就是打字机效果,用户不用干等整条消息生成完。 - 微信风格 UI:方形头像、长方形气泡、CSS 三角形尾巴、深色模式。为什么做成微信风格?因为目标用户最熟悉这套交互。设计上 mobile-first,手机上用起来跟原生 App 差不多。
Web 端以后会是主力平台,很多计划要做的功能(记忆可视化、关系图谱、设置面板)只能在 Web 上做。还有一件 Telegram 做不到的事,就是完整的聊天历史。Telegram 存消息有限制,Web 端直接从数据库读,所有对话一条都不丢。
8. 不光鲜但必须做的
前面说的都是用户能感觉到的。可 v0.0.2 能从 demo 变成能上线的东西,靠的是下面这些不起眼的活。
安全上加固了四处,做起来都挺无聊,但不做就不敢上线:
- 路径遍历防护。preset ID 做了严格校验,不然有人传
../../etc/passwd当 preset ID,服务器就没了。 - MIME 感知分发。媒体文件按真实的 MIME type 送进对应的处理管道,不靠扩展名去猜。
- 模板注入防护。用户输入不会被当成模板执行,你在自述里写
${process.env.SECRET},也只会被当成普通文字。 - bot token 泄露防护。日志和错误消息里不会暴露 Telegram Bot Token。
管道这边也改了一批:
- 自适应 debounce。不再固定等 5 秒,而是跟着对话节奏调,聊得快就等短一点,聊得慢就等长一点。
- 中途打断重新回复。AI 还在生成的时候用户又发了新消息,就停掉这次生成,带上新消息重新来,不会再出现 AI 还在回旧消息、把新消息晾在一边的尴尬。
- 交互模式。有
realistic和companion两种模式,再配一个 3D 限制矩阵,管住它的行为边界。 - 动态回复长度。闲聊就短一点,聊得深就说得细一点。
- Telegram 从 polling 切到了 webhook 模式,响应延迟更低。
测试也补上了,一共 220 个。单元测试覆盖 agent、soul、cost、memory 这几个模块,集成测试覆盖 API 和 channels,Vitest、path aliases、coverage 这些配置也都搭好了。覆盖率 48.7%,不算高,但在快速迭代的阶段,这是一张实打实的安全网。每个核心模块都有测试兜着,改东西不用全靠祈祷。
9. 人格本身也加深了
v0.0.1 的人格配置文件写得比较薄,v0.0.2 全部扩到了 200-312 行,里面有完整的背景故事、情绪系统描述、说话方式、口头禅,还有不同情绪下会怎么反应。每个预设还另外加了一个行为规则文件,写的是硬规则,模型不能越过的底线。还新加了一个预设小奶狗(xiaonai),加上之前四个一共 5 个,照顾不同用户的偏好。
Google Search 接地也加上了。在 MODE_DYNAMIC 模式下,模型自己决定什么时候去搜实时信息。你问它今天天气怎么样,或者某个明星最近有什么消息,它能搜到,再用自己的语气告诉你,就像它本来就知道一样。
最后
反正 v0.0.2 干完,Mio 能看你发的照片,能听你说的话,知道现在几点,知道自己长什么样,能在对的时候想起对的事,还能在浏览器里跟你聊。这一版里里外外用上了 5+ 个模型层级,转写、vision、生图、重排序各管各的。每一件单拿出来都不算复杂,但攒到一起,整个东西就「真」了一截。
下一步大概会做这些:把主动消息做得更好,让多轮对话更自然,加上语音回复,再把 Web 端从能用做到好用。这些放到 v0.0.3 再说。