重建 Mio,六成代码直接搬过来了
 软件器官移植手术的技术概念插画
动手重建 Mio 之前,我先把 packages/core 里的 import 路径一个一个追了一遍,想搞清楚 v1 到底有多少东西要扔。结果比我预想的好不少。大部分模块根本不管 persona 是什么,就是收参数、返回结果,只是调用方碰巧把人设数据传了进去,函数自己对人设完全无感。最后盘下来,60-70% 的核心基础设施能直接搬过来,15% 要改造,剩下 15-20% 彻底删掉。
为什么 v1 的人格化路线必须砍,第一篇写过了。新方向长什么样,第二篇也写过,就是有性格、但没有物理身份的陪伴,参照系是 Her,不是 Character.AI。这篇只讲工程上的事,哪些模块留,哪些改,哪些删,各自为什么。
每个模块过三条标准
我的做法是给 v1 的每个模块过三条标准:
- 直接读身份定义文件、人格配置文件或者行为规则文件的,删。
- 假设了多 agent 架构、要在多个人格或者会话之间做路由的,删。
- 核心逻辑在一用户一伴侣的世界里还有用的,留。
标准很简单,但真做起来,你得把整个 codebase 从头到尾 audit 一遍才敢下结论。有的模块看着耦合得很紧,追进去才发现其实很松。也有反过来的,代码看着挺干净,底下却藏着没写出来的假设。不全部看完,你判断不了。
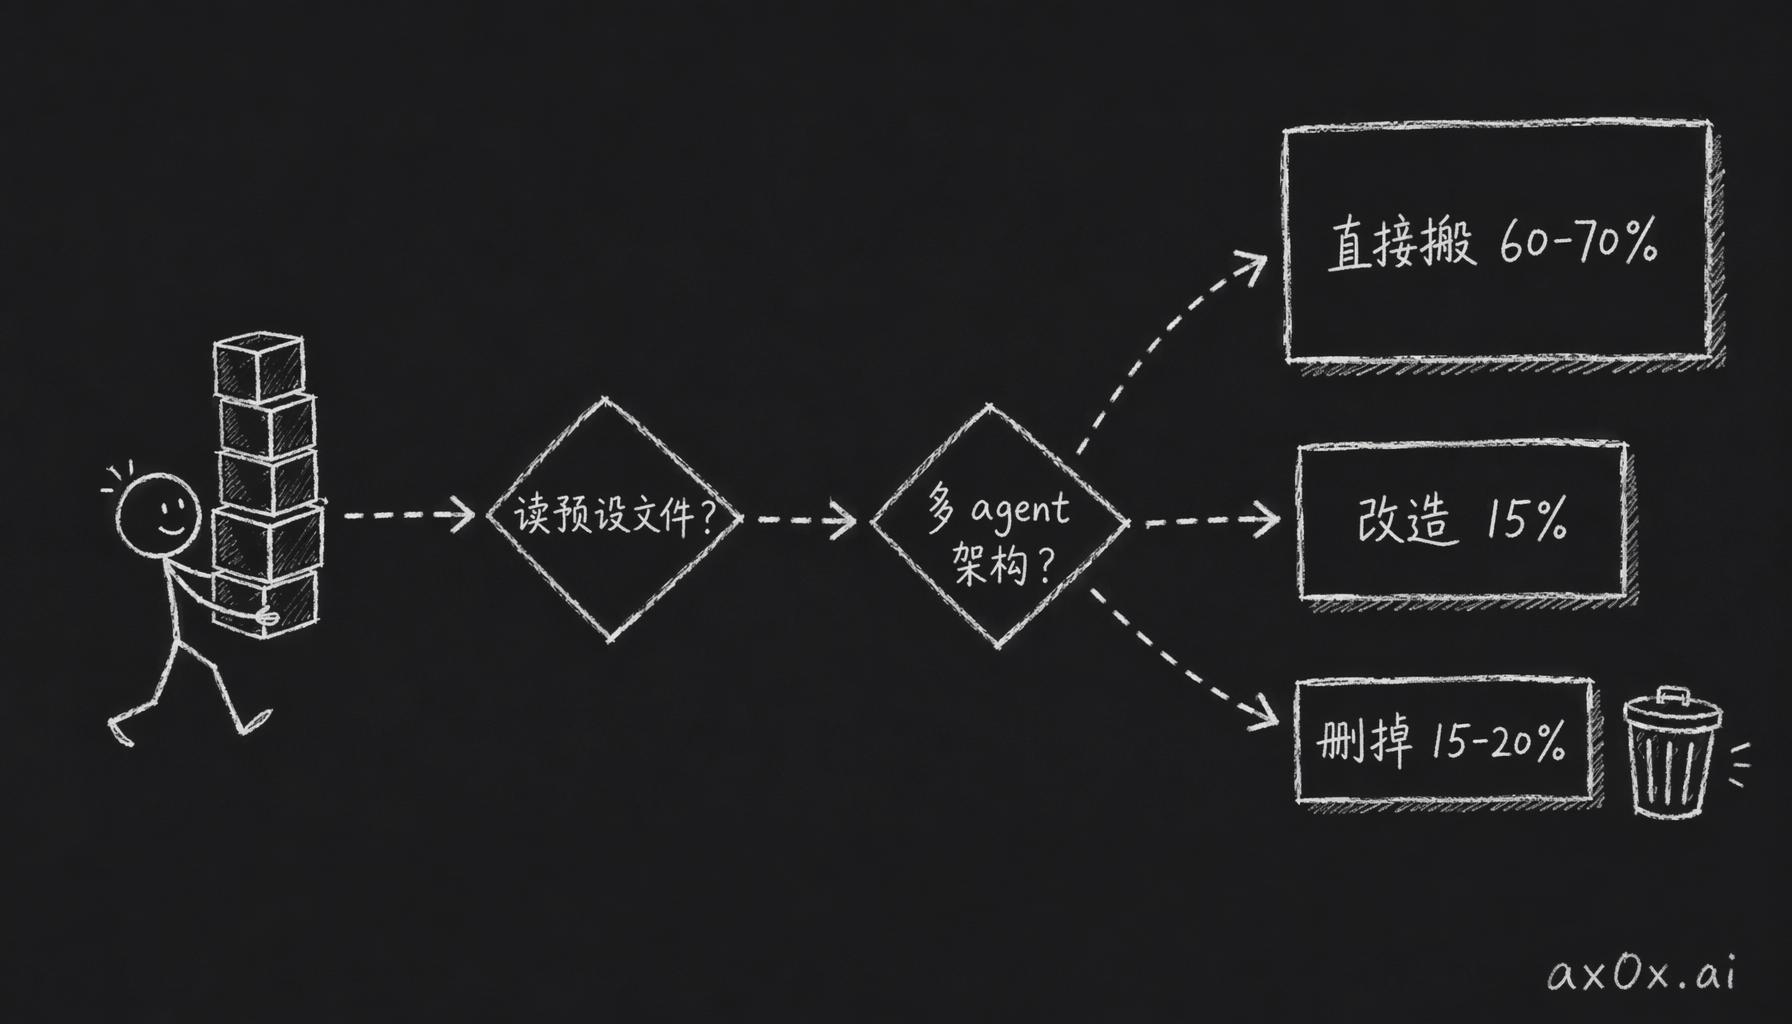 v1 每个模块过两道判断,分诊成直接搬、改造、删掉三堆
直接搬走的 60-70%
这批模块全是纯基础设施,谁在调它们、调它们的是哪种 companion,它们不知道也不关心。
记忆系统是里面花工程力气最多的一块。packages/core/memory/ 管这么几件事:从对话里提取记忆,生成 embedding,用 pgvector 做语义搜索,给记忆打重要性分,再让它随时间衰减。整个模块跟人设一点耦合都没有。它干的活就是拿到 user ID 和对话内容,提取出记忆,连着向量 embedding 一起存下来,要用的时候再按语义相关度捞出来。每一行代码都带得走。v1 系列第三篇写过它是怎么重建的,架构到现在没变,还是每次对话后提取记忆,用 768 维向量做 embedding,按余弦相似度检索。v2 唯一的变化是记忆从绑 agent 改成绑 user,改个列名而已,算不上架构变更。
媒体管线全是纯函数。TTS、视觉理解、语音转写、URL 浏览,都在 core/media/ 下面:
tts.ts:输入文本和声线 ID,输出音频vision.ts:输入图片,输出描述transcribe.ts:输入音频,输出文字browse.ts:输入 URL,输出页面内容
这四个模块都不知道是谁在调它们。整个管线从第一天起就是按纯函数写的,第六篇(媒体管线)和第八篇(URL 浏览)里都记过。当时这么写只是图干净,现在回头看,这么做是对的。
订阅系统跟 companion 层完全没关系。套餐分级、用量统计、哪些功能开给哪一档,都在 core/subscription/ 里。它只知道 free/starter/pro/max 和每天的额度,不知道 persona 是什么。
成本追踪就是记账。每次 LLM 调用、TTS 合成、视觉分析用了多少 token、花了多少美元,core/cost/ 都记下来。单位经济学那篇里的数据全是它出的,原封不动搬过去。
模型配置也不依赖人设。models.ts 里写着能用哪些 LLM 模型,还有各自的定价、context window 和路由规则,模型路由架构原样保留。
拼系统提示词的那段代码也是纯函数。agent/system-prompt.ts 拿到性格描述、情绪状态、相关记忆和 user context,拼成一个系统提示词字符串。以前调用方传进来的是身份定义文件里的人设数据,现在传的是用户自定义的性格描述。函数一行不用改,变的只是传进去的东西。
要改造的 15%
这批模块的核心逻辑没问题,但身上带着 v1 的假设,得切干净才能用。情绪引擎(soul/emotion.ts)就是典型。情绪模型本身很扎实,它追踪 valence(效价)、arousal(唤醒度)和一组离散情绪,每次交互完更新一次。毛病出在 v1 里它跟日程系统缠在一起。Mio 晚上「觉得累」,是因为日程表上这么排的,跟聊了什么没关系。修的办法就是把日程相关的引用全拔掉,让情绪只跟着对话和对时间的感知走。情绪模型留下,假装有生活的那部分触发器拆掉。
主动消息(soul/proactive.ts)管的是在用户没开口的时候,什么时候发消息、因为什么发。v1 里它从 proactive.json 拉每个人格专属的触发器,比如「刚下班」「要做瑜伽了」。新引擎简单得多,或者说更实在,调度那套基础设施保留,换掉的是那些假装有生活的内容。触发器只剩四类:
- 时间感知:「晚上了,今天过得怎么样?」(知道现在几点,不假装有日程)
- 记忆驱动:「你上次说要去面试,怎么样了?」(从存储的记忆里提话题)
- 情绪延续:「昨天聊完感觉你心情不太好,今天好点了吗?」(读上次的情绪状态)
- 单纯关心:「好几天没聊了,想你了」(检测对话间隔)
context aggregator(context/aggregator.ts)是编排层,每次调 LLM 之前,它把记忆、最近的消息、情绪状态和 user context 拉到一起。v1 里它还得拉每个 agent 自己的背景故事和关系动态。这次改造就是把多 agent 路由和查关系类型的逻辑去掉,只留下检索记忆和拼 context 这两件事。
彻底删掉的 15-20%
剩下这些模块都是冲着「预设人格」写的。预设人格没了,它们也就没有留着的理由了。
先是预设文件。一共五个人格目录,每个目录下面都有身份定义文件、人格配置文件和行为规则文件,写着「成都咖啡师小萌」是谁、「研究生学姐」喜欢什么、「中年大叔」怎么说话。几百行精心打磨的背景故事,全部删掉。v2 里性格是在对话里慢慢长出来的,没有文件可读。
然后是参考图片。每个 persona 原来都配了一组参考照片,用来生成自拍。v2 的 companion 不假装是人,也就用不着伪造一张脸。
日程系统。media/schedule-*.ts 模拟一个人的日常作息,Mio 9 点到 6 点「上班」,晚上「去健身」,过了午夜「睡觉」。这是 v1 里最难做好的一块,对留存的贡献却最小。用户会依赖上 companion,是因为它记得自己说过什么,跟它假装做瑜伽一毛钱关系都没有。
人格风格模块。media/persona-style.ts 和 relationship-dynamics.ts 按事先定好的关系类型(朋友、恋人、知己)来调回复的风格。v2 里关系是自然长出来的,长成什么样就是什么样。
关系进化。relationship/evolution-*.ts 用写死的阶段推进逻辑,追踪关系走到了哪一步。讲道理这就是过度工程,companion 记得你、回复跟得上,关系自然会加深,用不着一个状态机在后面推。
数据库从 10 张表砍到 4 张
架构到底简化了多少,看数据库这层最直观。v1 到后期攒了差不多 10 张表,v2 砍到 4 张核心表加 1 张辅助表。
v1 Schema (~10 张表)
users              — 复杂,带 agent 关联
agents             — 每个用户多个,绑预设,含 customStory、relationshipType
sessions           — 多 agent、多渠道路由
messages           — 绑定到 session
memories           — 绑定到 agent
token_transactions — 不变
channel_bindings   — Telegram/web 渠道路由
onboarding_states  — 多步骤状态机
telegram_allowlist — Telegram bot 访问控制
account_link_tokens — 跨平台账号关联 token
v2 Schema (4 张核心表 + 1 张辅助表)
-- 用户:简化,去掉 agent 关联
CREATE TABLE users (
  id                UUID PRIMARY KEY DEFAULT gen_random_uuid(),
  email             TEXT UNIQUE,
  timezone          TEXT DEFAULT 'Asia/Shanghai',
  subscription_tier TEXT DEFAULT 'free',
  trial_expires_at  TIMESTAMPTZ,
  daily_usage       JSONB DEFAULT '{}',
  created_at        TIMESTAMPTZ DEFAULT now(),
  updated_at        TIMESTAMPTZ DEFAULT now()
);

-- 伴侣:每个用户一个,就这么简单
CREATE TABLE companions (
  id             UUID PRIMARY KEY DEFAULT gen_random_uuid(),
  user_id        UUID UNIQUE REFERENCES users(id),  -- UNIQUE 强制一对一
  name           TEXT NOT NULL,
  voice_id       TEXT,
  personality    TEXT,            -- LLM 生成的几句性格描述
  emotion_state  JSONB DEFAULT '{}',
  created_at     TIMESTAMPTZ DEFAULT now(),
  updated_at     TIMESTAMPTZ DEFAULT now()
);

-- 消息:扁平化,绑定到用户,没有 session 概念
CREATE TABLE messages (
  id             UUID PRIMARY KEY DEFAULT gen_random_uuid(),
  user_id        UUID REFERENCES users(id),
  role           TEXT NOT NULL,   -- 'user' | 'assistant'
  content        TEXT,
  media_urls     TEXT[],
  emotion_state  JSONB,          -- 回复时的情绪快照
  created_at     TIMESTAMPTZ DEFAULT now()
);

-- 记忆:和 v1 几乎一样
CREATE TABLE memories (
  id             UUID PRIMARY KEY DEFAULT gen_random_uuid(),
  user_id        UUID REFERENCES users(id),
  type           TEXT NOT NULL,
  content        TEXT NOT NULL,
  embedding      vector(768),     -- pgvector
  importance     REAL DEFAULT 0.5,
  access_count   INT DEFAULT 0,
  last_accessed  TIMESTAMPTZ,
  created_at     TIMESTAMPTZ DEFAULT now()
);

-- 费用追踪:和 v1 一样
CREATE TABLE token_transactions (
  id              UUID PRIMARY KEY DEFAULT gen_random_uuid(),
  user_id         UUID REFERENCES users(id),
  operation_type  TEXT NOT NULL,
  model_id        TEXT,
  input_tokens    INT DEFAULT 0,
  output_tokens   INT DEFAULT 0,
  cost_usd        NUMERIC(10,6) DEFAULT 0,
  created_at      TIMESTAMPTZ DEFAULT now()
);
最要紧的是 companions.user_id 上那个 UNIQUE 约束,一个用户只能有一个 companion。加上这一个约束,选哪个 agent、session 怎么路由、渠道怎么绑,这些需求全没了,整套多 agent 基础设施最后就剩下一个外键。
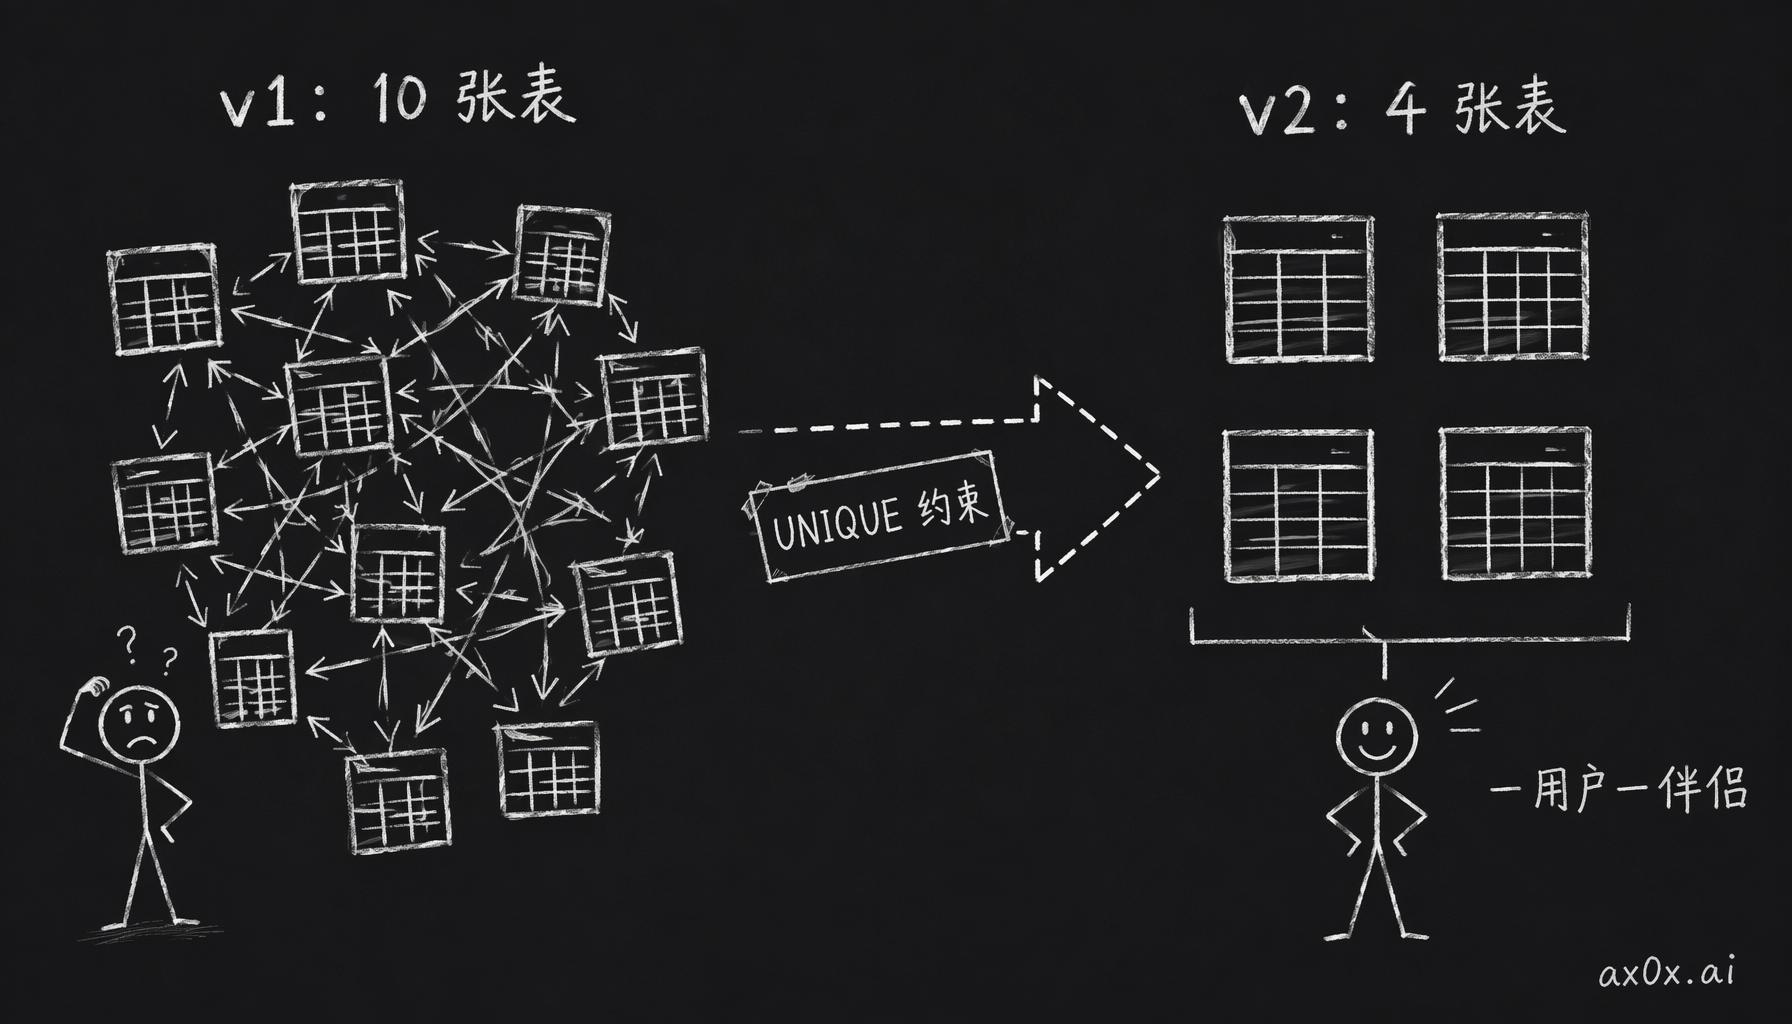 一个 UNIQUE 约束把十张表的多 agent 架构塌缩成四张表
砍掉的表
| 砍掉的表 | v1 中为什么存在 | v2 中为什么不要了 |
|---|---|---|
agents | 每个用户多个 persona | 一用户一 companion,存在 companions 表 |
sessions | 多 agent、多渠道路由 | 没有 session,消息是每个用户一条扁平流 |
channel_bindings | 按 agent 做 Telegram/web 渠道路由 | 单平台 native app |
onboarding_states | 多步骤分支状态机 | 对话式 onboarding,状态活在聊天里 |
telegram_allowlist | Telegram bot 访问控制 | 不做 Telegram 了 |
account_link_tokens | 跨平台账号关联 token | 单一认证系统 |
消息也从绑 session 改成绑 user。v1 里一条消息属于一个 session,session 属于一个 agent,agent 属于一个 user,想查「这个用户说了什么」得 JOIN 三次。v2 里消息直接挂在 user_id 上,查一次就拿到了。记忆也一样,记忆是用户本人的,跟哪个人设实例没关系。
WebSocket 替代 SSE
v1 用 SSE(Server-Sent Events)推 LLM 的流式响应。SSE 能用,但它是单向的,只能服务器推给客户端,客户端要发消息还得另发一个 HTTP 请求。v2 换成了 WebSocket,理由有四条:
- 天生就是双向的。roadmap 最后要做到实时语音对话,SSE 做不了双向音频流,WebSocket 可以。现在搭在 SSE 上,以后还得再拆一遍,不如一开始就用 WebSocket。
- 主动消息更干净。v1 里要发主动消息,客户端得一直维护一个轮询连接,或者单独开一条 SSE 通道。换成 WebSocket 以后,服务器推主动消息和推聊天回复,走的是同一个通道、同一套协议。
- Expo 支持得更好。React Native 对 WebSocket 的支持很成熟,文档也全;SSE 在 React Native 里得打 polyfill,重连还有一堆边缘情况。WebSocket 断线重连早就有人解决了,有
reconnecting-websocket这种现成的库。 - 自带心跳。WebSocket 有 ping/pong 帧,能检查连接还健不健康;SSE 只能在应用层自己做 keepalive,放到移动网络上更容易出问题。
协议很简单,每个用户一条 WebSocket 连接,整个实时通信层就这些,一共六种消息类型:
Client → Server:  { type: "message", text, mediaIds? }
Server → Client:  { type: "token", text }           // 流式
Server → Client:  { type: "done", messageId, emotionState }
Server → Client:  { type: "voice", audio }           // base64
Server → Client:  { type: "proactive", text, emotionState }
Server → Client:  { type: "emotion", state }         // 光球状态更新
砍掉 Telegram
这个决定有点疼。Telegram 是 Mio v1 的主渠道,用户平时跟 companion 聊天就是在 Telegram 上。砍掉它倒不是因为 Telegram 不好,是换了新架构以后,留着它没意义了。
最要命的是聊天记录同步不到 Telegram 的界面里。用户在 native app 里跟 companion 聊了几周,打开 Telegram 一看,一片空白。companion 什么都记得,聊过的话却一条都看不见。这种体验已经不能叫精简版了,是直接坏掉了。
onboarding 让这个矛盾更大。v2 的 onboarding 是对话式的,companion 就是在这段对话里诞生的,没法让用户在 Telegram 里走完这个流程,再切回 app。反正你都得先下载 app 做 onboarding 了,那还回 Telegram 干嘛?
所以 v0-v1 不做 Telegram。以后如果跨平台触达真的变得重要,做 Apple Watch 或者 Android 的 widget,都比在别人的平台里塞一个聊天 bot 更有意义。
技术栈对比
留下的和换掉的,放一张表里看:
| 层 | v1 | v2 |
|---|---|---|
| 前端 | Next.js web + Telegram bot | Expo / React Native |
| 动画 | CSS | React Native Skia |
| 服务端 | Hono | Hono(保留) |
| 实时通信 | SSE | WebSocket |
| 数据库 | Supabase + Drizzle | Supabase + Drizzle(保留) |
| 向量搜索 | pgvector | pgvector(保留) |
| ORM | Drizzle | Drizzle(保留) |
服务端基本没动。Hono 轻量好用,Supabase + Drizzle 这套数据库层已经验证过了,记忆系统又离不开 pgvector,所以全留着。大变化在客户端,从 Next.js web app 换成了 Expo native app。仿微信改版那次的工程做得很扎实,但这回整个 UI 的路子都换了,那 30 多个组件一个都带不走。新客户端就是一个聊天屏幕加一颗会动的光球,样子从仿微信变成了更像 GPT 语音模式的那种。
第一个 commit 不从零开始
mio-v2 起步的时候,手里已经有一个 packages/core,里面装好了这些东西:
- 带 pgvector 语义搜索的完整记忆系统
- 完整媒体管线(TTS、STT、视觉、浏览)
- 订阅和计费系统
- 成本追踪系统
- 模型配置系统
- 接受参数的系统提示词构建器
这些基础设施都不用重新造。要新写的只有六件事:
- 新数据库 schema(4 张表,上面写好了)
- 新 WebSocket 服务端(替换 SSE 端点)
- 新 Expo 客户端(聊天屏幕 + 动画光球)
- 对话式 onboarding(性格从对话中涌现)
- 改造后的情绪引擎(去掉日程,纯对话驱动)
- 改造后的主动消息(去掉假装有生活的触发器)
讲道理,这次重建最费劲的,其实是忍住别去重写那些已经能用的东西,真的会手痒。反正现在 schema 定了,每个模块留、改、删也都盘完了,接下来就是搭 Expo app,把 WebSocket 接通。光球第一次动起来的事,留到第四篇再写。