Mio 的账到底算不算得过来
 AI 伴侣单位经济模型的商业概念插画
先交代下背景
做 OpenClaw 原型那会儿,两周账单直接离谱。早期版本一天的成本就高得离谱,一个用户跑两周就能烧掉一笔不小的钱。那次给我的教训很直接,成本得从第一天就当架构问题来解,别想着以后再优化。
现在 Mio 迭代到第八个版本了,这篇就拿线上的真实生产数据,把这个账一层层重新算一遍。
真实数据
拿线上生产环境一天的数据来算,一共 77 次调用,差不多 28 条聊天消息。成本按类别拆开是这样的:
| 类别 | 成本占比 |
|---|---|
| 聊天(LLM) | ~59% —— 绝对大头 |
| 人格提取 | ~21% —— 单次贵但调用少 |
| 记忆摘要 | ~10% —— 中等成本,调用少 |
| 语音合成(TTS) | ~3% —— 单次很便宜 |
| 记忆提取 | ~3% —— 单次很便宜 |
| 主动消息 | ~2% —— 几乎忽略 |
| 记忆重排序 | ~2% —— 单次可忽略不计 |
| 向量嵌入 | <1% —— 约等于免费 |
一个活跃用户一天下来,花的钱非常少。聊天占了将近六成,是绝对的大头,其次是人格提取和记忆这几个任务,剩下的语音、嵌入、重排序全是零头。
跑了 1000+ 次交互再取平均,每条消息的成本几乎可以忽略,跟早期原型比降了两个数量级。但只能说,对低价的层级来说,这还不够低。
钱花在哪了
这个账我一般分两块算,媒体是按需往上叠的,算第三块。
每日固定开销(占比不大):
- 人格提取是固定成本里最大的一块,一天跑 3 次,用的是 Gemini 3.1 Pro
- 记忆摘要中等,一天 2 次
- 记忆提取和嵌入基本可以忽略
- 主动消息按需触发,也可以忽略
每条消息的成本(几乎可忽略):
- 大头是聊天本身的 LLM 调用,每次 8K-17K 输入 token
- 记忆重排序可以忽略
- 一天 30 条消息,一个月的账单不大;一天 100 条,变动成本就开始超过固定成本了;到一天 200-300 条,变动成本是固定开销的好几倍
媒体成本(按需叠加):
- 语音合成、图片理解都几乎可以忽略
- 视频理解稍贵一点
- 自拍生成也几乎可以忽略
prompt 压缩干了什么
上面这些数字都是压缩前的。v0.1.4 把 system prompt 压掉了差不多 60%,从 9K-13K token 压到 3K-5K。每次聊天的输入 token 里,system prompt 占得最多,把它压下来,每条消息成本的大头也就直接砍掉了。
保守估计,压缩之后每条消息的成本能降 ~35%,每天的固定开销能降 ~25%。反正算下来,不管用量在哪一档,每个月的成本都明显往下走。用得越多的层级降得越明显,因为变动成本在里面占得更多。
每个层级到底赚不赚钱
每个付费层级每天都有消息上限,这样最坏的情况下,成本也有个顶。下面算的就是上限打满的极端情况。
压缩前(当前):
| 层级 | 消息上限 | 满载毛利 |
|---|---|---|
| 免费 | 20/天 | 获客漏斗(成本中心) |
| 入门 | 30/天 | 亏钱 —— 满载入不敷出 |
| 进阶 | 100/天 | 勉强打平 |
| 高级 | 200/天 | 小赚 |
| 旗舰 | 300/天 | 小赚 |
压缩后(v0.1.4+):
| 层级 | 消息上限 | 满载毛利 |
|---|---|---|
| 免费 | 20/天 | 获客漏斗(成本中心) |
| 入门 | 30/天 | 转正 —— 稳妥盈利 |
| 进阶 | 100/天 | 毛利可观 |
| 高级 | 200/天 | 毛利很健康 |
| 旗舰 | 300/天 | 毛利很健康 |
说实话,压缩前按满载算,只有高层级能赚钱。压缩之后,所有付费层级都转正了,高层级的利润率也明显变好了。
有一点得说清楚,「满载」指的是用户每天把消息额度全部用完。实际上一般只会用到上限的 40-60%,所以实际的利润率比这个最坏情况好得多。
还有一点挺有意思,为什么层级越高,利润率就越高?因为低层级用户付的钱,买的是实打实吃成本的功能,像 LLM 聊天、语音识别、图像理解。高层级用户付那么高的价,买的反而是几乎不多花成本的东西。自拍生成的成本可以忽略,优先响应不花钱,NSFW 解锁不花钱,扩展记忆的成本也可以忽略。所以层级越往上,用户多付的钱基本不会带来新的成本,利润率就一级比一级高。
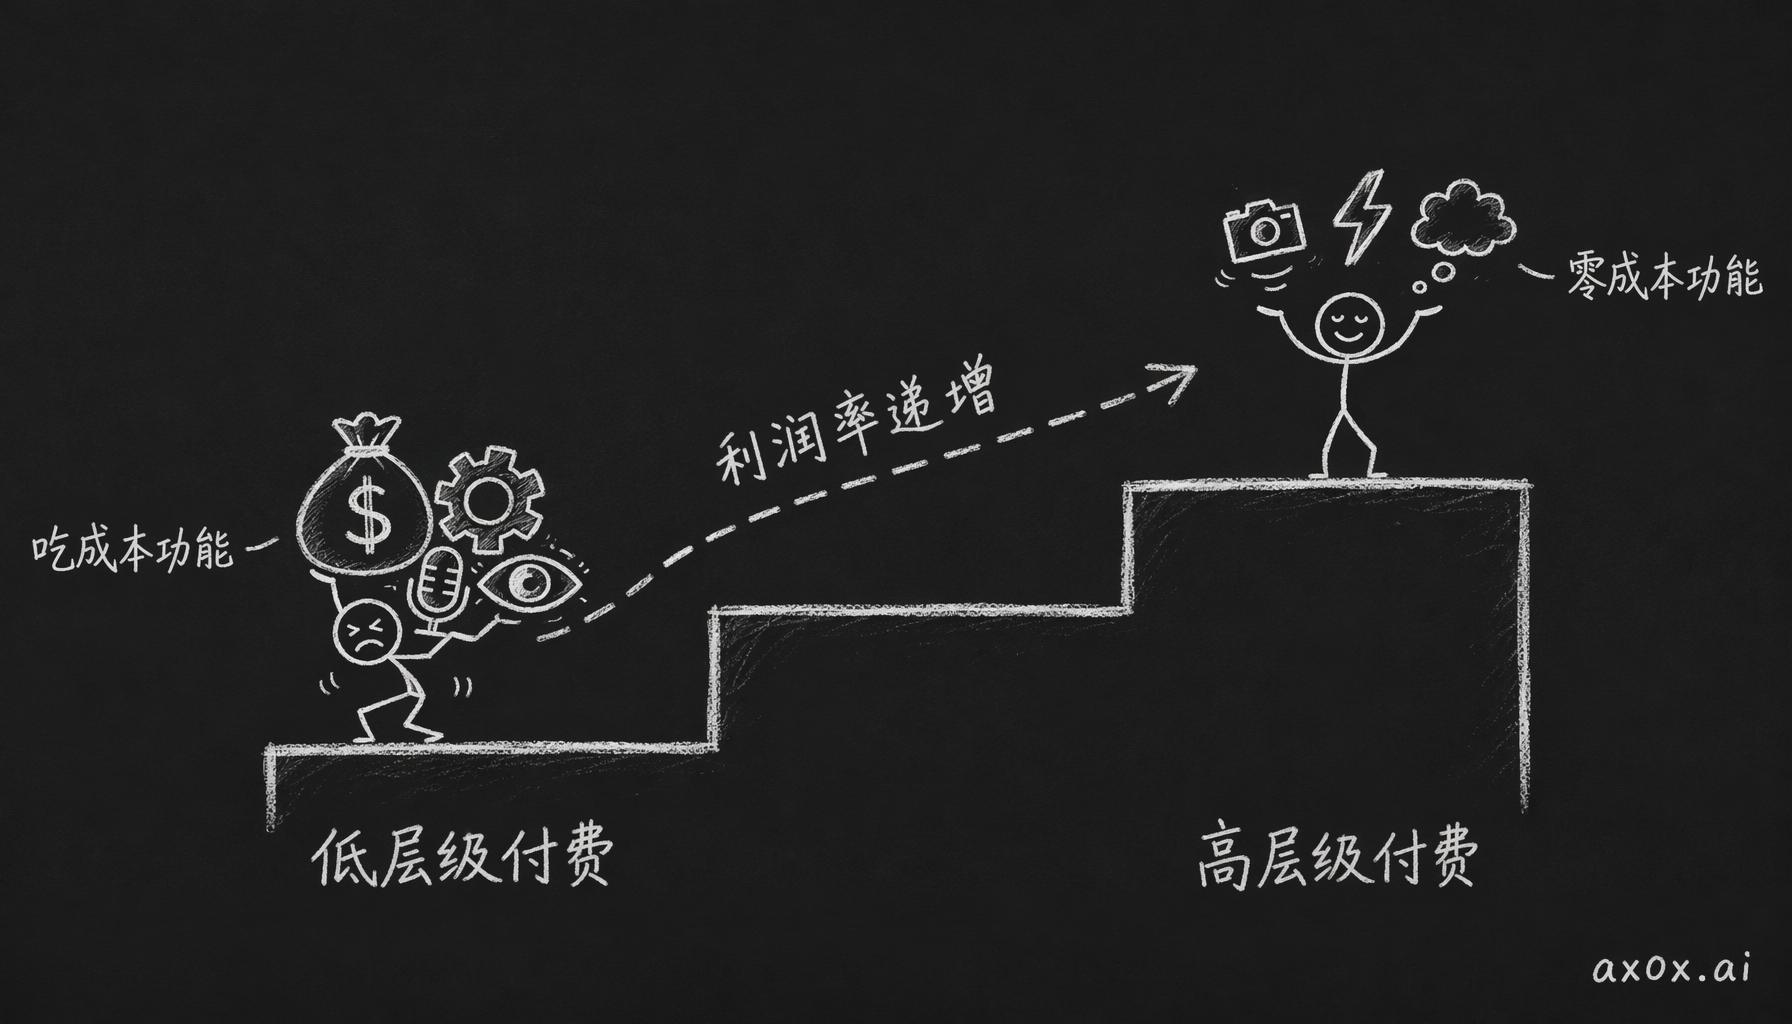 为什么付费层级越高利润率越高:低层级付的钱买的是吃成本的功能,高层级付的钱买的是几乎零成本的功能
为什么这个账只会越算越好
成本后面还会接着降。原因有三个,prompt 还能压,模型在降价,路由也还能往下挪。
-
prompt 还能继续压。v0.1.4 的压缩砍掉了 60% 的 system prompt token,这种优化只要做一次,所有用户的每一条消息都跟着省。后面还有 lorebook 架构,背景故事用到了才注入,不用每次全量加载,保守估计还能再降 30-40%。
-
模型本身一直在降价。过去两年,LLM 推理成本降了两个数量级。现在每条消息的成本,一年内可能还会再降 3-5 倍,因为 Gemini 一直在降价,便宜模型的能力也涨得很快。
-
路由还能往下降级。Mio 的智能路由现在已经把 90% 的对话交给 Gemini 3 Flash,只有人格提取和记忆摘要用 Gemini 3.1 Pro。等便宜模型的能力上来了,还有更多操作可以往下挪。这跟 prompt 优化一样,每挪一次,所有用户都跟着省。
prompt 优化、模型降价、架构改进这几样叠在一起,6 到 12 个月内应该能把所有层级的毛利推到 50-70%+,比现在压缩后这一版还要好不少。
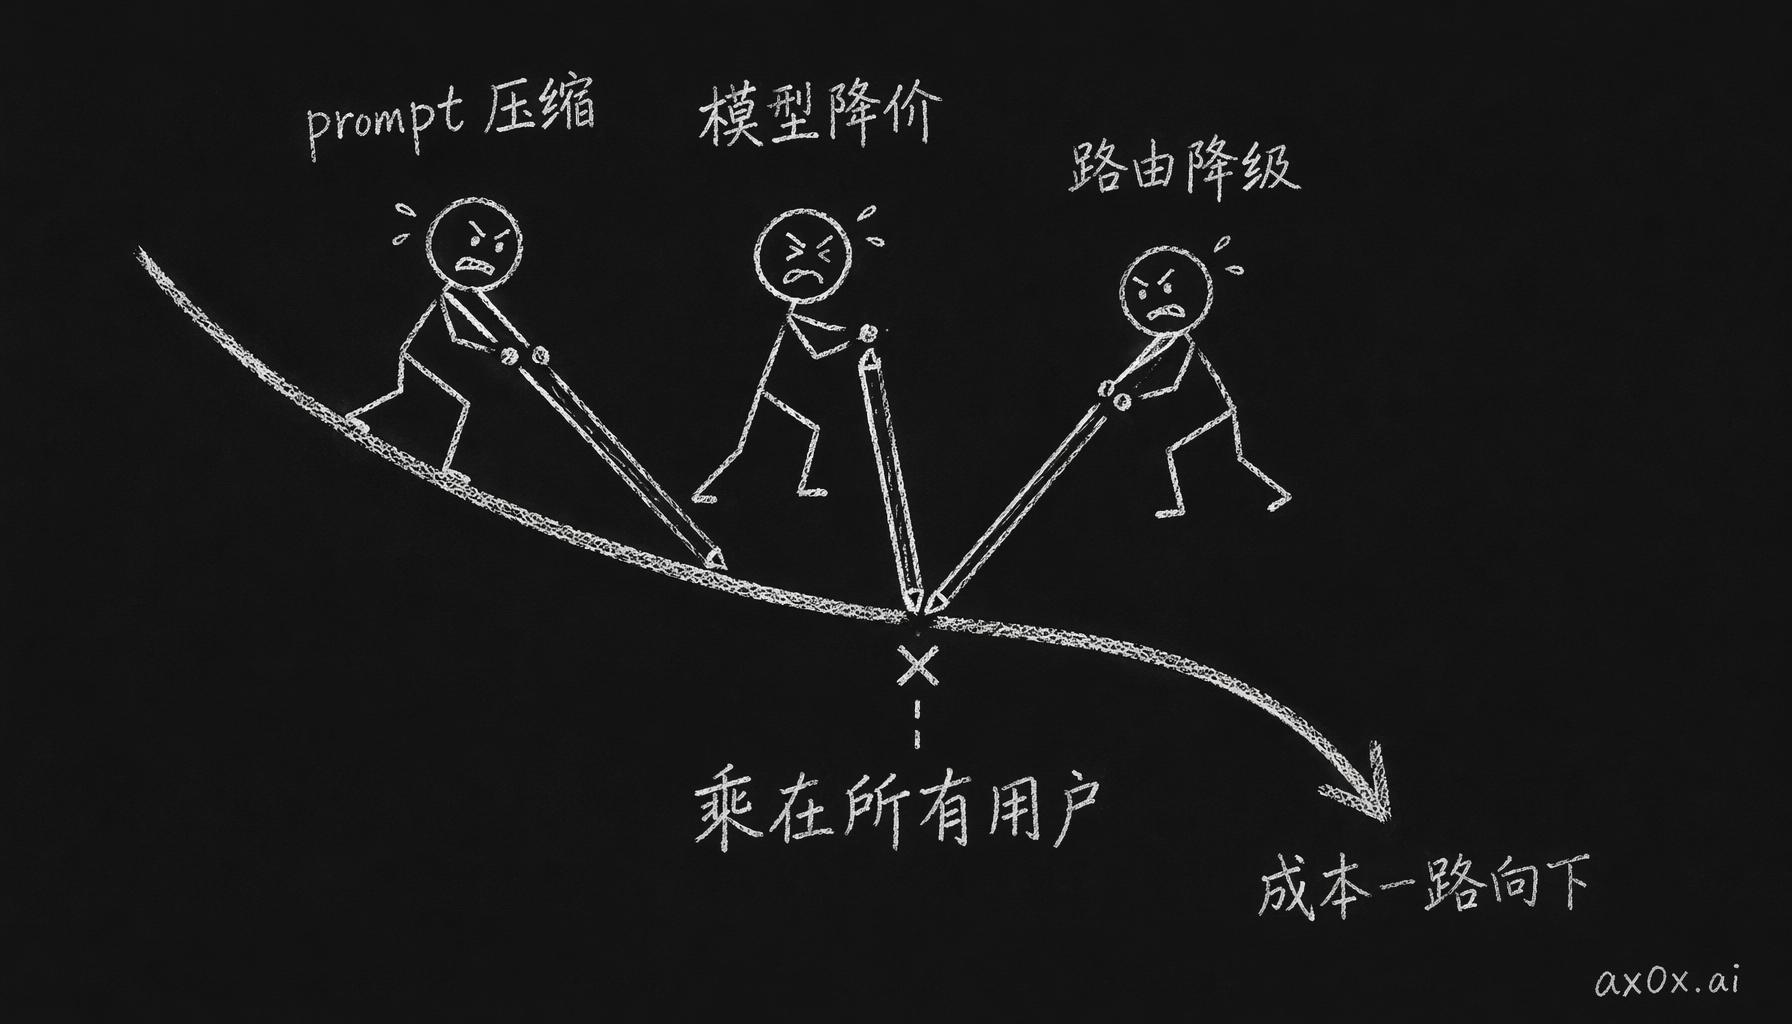 三股力量同时把每条消息的成本往下压,而且每一次优化都乘在所有用户身上,所以这个账只会越算越好
对比
| 指标 | 早期原型 | Mio(压缩前) | Mio(压缩后) | Mio(12 个月预测) |
|---|---|---|---|---|
| 每用户每天成本 | 天文数字 | 降两个数量级 | 再降一大截 | 只剩零头 |
| 每条消息成本 | 高得离谱 | 几乎可忽略 | 再降 ~35% | 再降 3-5 倍 |
| 入门层级能盈利? | 不能 | 仅高层级 | 能(稳妥盈利) | 能(毛利很高) |
| 记忆管理 | 无(只加不减) | 多层检索引擎 | + 压缩提示 | + 自优化 |
| 情感细腻度 | 基于规则 | 灵魂驱动 | + 关系进化 | + 微调模型 |
这是 Mio 宣言的技术附录,愿景和产品故事从宣言那篇看起。