开发机一天死了两次,两次原因不一样
 冻结的服务器诊断现场
说个挺离谱的事,我的开发机一天之内死了两次。第二次还是在我修完第一次、觉得已经稳了之后死的。整个过程都是 claude code 在弄,我一共就说了两句话,觉得有意思,记录一下。
事情是这样的。早上八点,我跟平常一样 SSH 进开发机准备干活,连不上。这台机器是 GCP 上的一台 c3-standard-4,16GB 内存,Ubuntu 24.04,上面跑着几个长驻服务,带个无头浏览器。昨晚还好好的,两小时前我还上去过。
我没自己动手查,直接开了 claude code,第一句话:「devbox 连不上了,帮我看看。」
它做的第一件事是查 GCP 实例状态:
gcloud compute instances list --filter="name~claude-devbox"
状态是 RUNNING,公网 IP 也在,机器本身没挂。然后试 TCP 连不连得上:
nc -z -w 5 <VM_IP> 22
22 端口是通的,但 SSH 卡在「banner exchange」,就是 SSH 握手的第二步。卡在这一步能看出不少东西。TCP 连得上,说明内核的网络栈还活着;sshd 没反应,说明用户态已经冻住了。内核还活着,用户态已经死了,大概就是这么个状态。
接着它去读 serial console:
gcloud compute instances get-serial-port-output claude-devbox --zone=us-west1-b
日志二十多个小时前就停了,最后几条是 rsyslogd 的 omfile action 在反复 suspend/resume,系统连自己的日志都写不出去了。到这里基本能确定,资源被耗光了,用户态全冻住了,只剩内核还撑着 TCP。那就只能硬重启,敲下这条命令,30 秒后 SSH 就恢复了:
gcloud compute instances reset claude-devbox --zone=us-west1-b
元凶:snap Chrome + PM2 的无限崩溃循环
机器活过来以后,claude code 去翻上一次启动的日志,很快就找到了元凶。snap 装的 Chrome 和 PM2 凑到一起,成了一个无限崩溃循环。
开发机上有个无头 Chrome,用 PM2 管着,Chrome 是用 Ubuntu 的 snap 装的。snap 包有 cgroup 隔离,进程必须跑在 snap.chromium.chromium 这个 cgroup 里。但 PM2 是个 systemd service,它拉起来的子进程全在 system.slice/pm2-user.service 里。cgroup 对不上,snap-confine 就直接不让启动。Chrome 一退出,PM2 看见了马上重启,重启又被拒,又退出,又重启,一秒钟几百次。PM2 里既没设 max_restarts 也没设 restart_delay,所以这个循环没有任何东西拦得住。
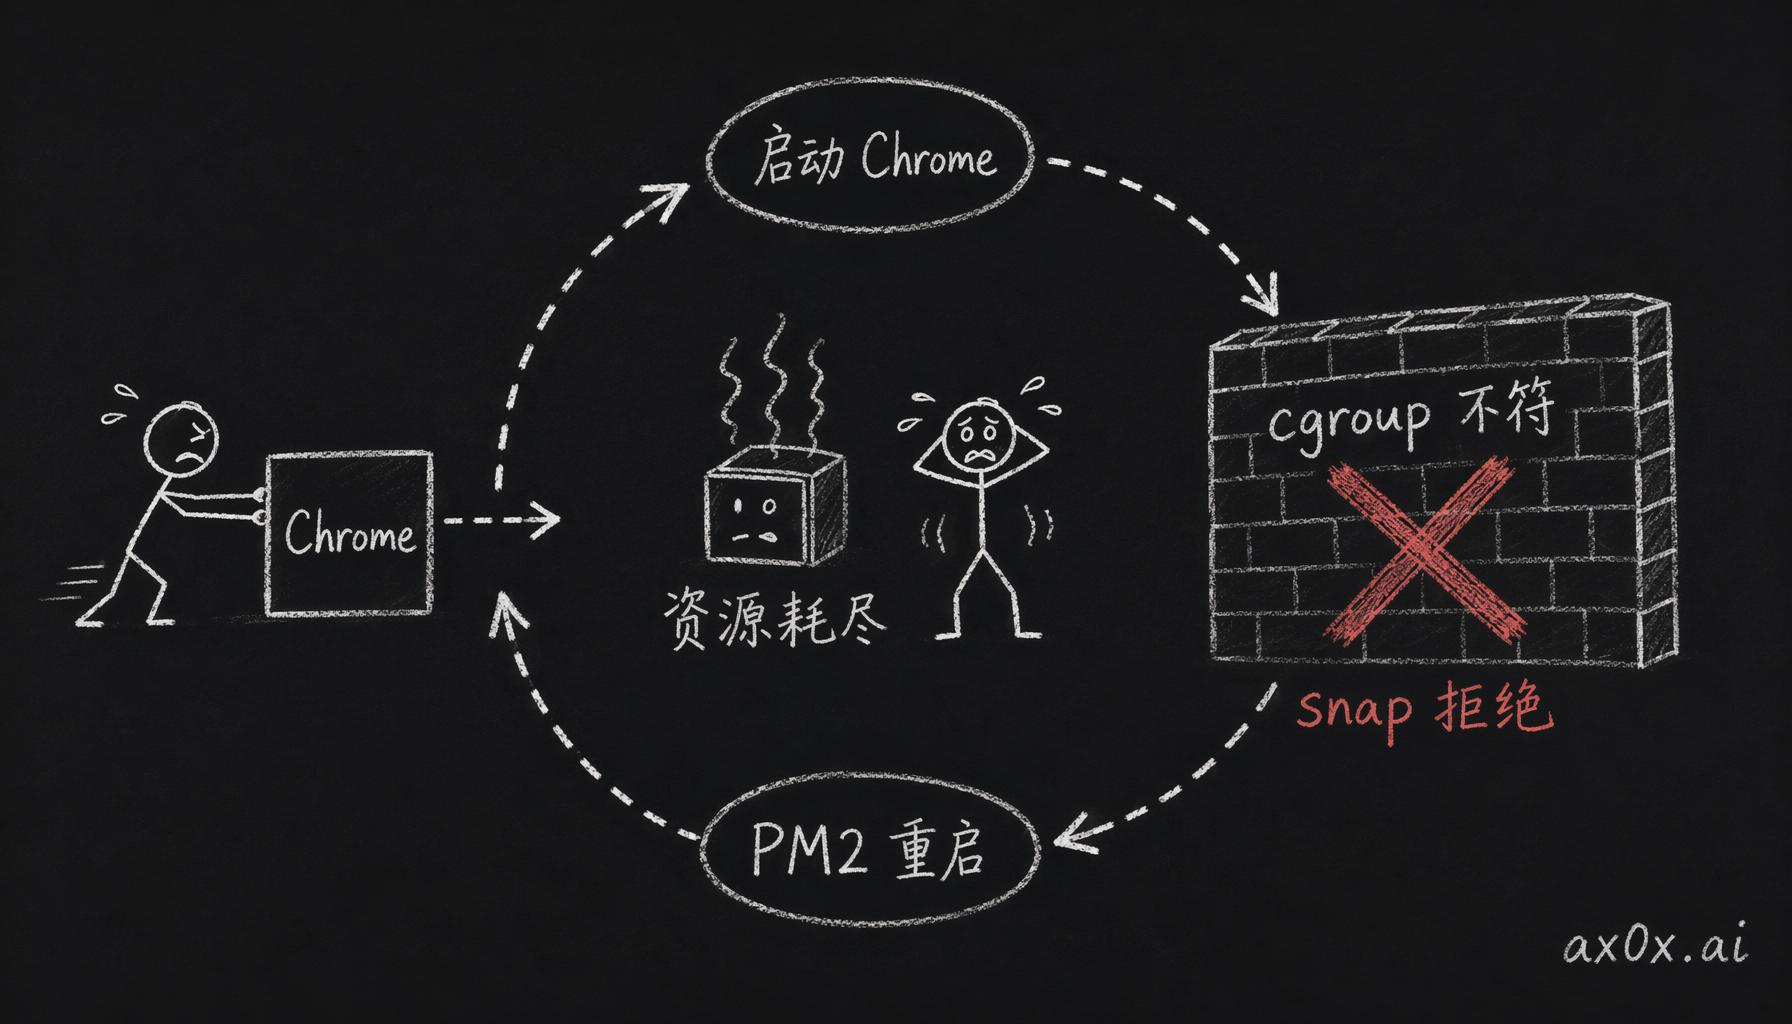 snap Chrome 和 PM2 凑成的无限崩溃回路:cgroup 不符被拒 → PM2 立刻重启 → 再被拒,一秒几百次直到资源耗尽
数字挺吓人。上一次开机一共跑了 33 个小时,错误日志里 snap cgroup 拒绝了 3,055 次,成功启动只有 12 次,而且这 12 次还是因为 cgroup 检测有竞态,碰巧让 snap-confine 放过去的。讲道理,Chrome 就算起不来,也不该让它试三千次。每次启动失败都要 fork 进程、分配内存、写错误日志,然后退出。几千次下来,PID 用光了,内存用光了,磁盘 I/O 也打满了,机器就是这么被拖死的。
除了这个元凶,还有两个帮凶。第一个是 SSH 暴力破解。开发机有公网 IP,SSH 直接对着互联网,也没装 fail2ban。claude code 数了一下上一次开机期间登录失败了多少次:
sudo journalctl -b -1 --no-pager | grep -c 'preauth'
6,066 次。33 小时平均下来每分钟三次,每一次都会 fork 一个 sshd 子进程。光这一项要不了命,但 Chrome 的崩溃循环已经把资源拖得很紧了,再多出这么多 fork,就是帮着把机器往死里拖。
第二个是没有 swap。16GB 内存,一点 swap 都没配,机器从正常到死掉,中间一点缓冲都没有。内存一满,OOM killer 要么把关键进程(比如 sshd)杀了,要么自己死锁。哪怕只配 2GB swap,内核至少还有时间回收一点,不至于直接锁死。
日志里还能看到一个预警,两次冻结之前都出现了这两行:
rsyslogd: action 'action-8-builtin:omfile' suspended
rsyslogd: action 'action-8-builtin:omfile' resumed
rsyslogd 连日志文件都写不进去了,这就是系统冻住前最后的信号。以后监控里再看到这两行,就得马上处理。
第一轮:一口气修了五件事
一、换掉 snap Chrome。要根治,就得卸掉 snap 版 Chromium,改装 Google Chrome 的 .deb 包:
wget -q -O - https://dl.google.com/linux/linux_signing_key.pub \
  | sudo gpg --dearmor -o /usr/share/keyrings/google-chrome.gpg
echo 'deb [arch=amd64 signed-by=/usr/share/keyrings/google-chrome.gpg] \
  https://dl.google.com/linux/chrome/deb/ stable main' \
  | sudo tee /etc/apt/sources.list.d/google-chrome.list
sudo apt-get update -qq && sudo apt-get install -y google-chrome-stable
换完在 PM2 里把路径改成 /usr/bin/google-chrome-stable,之后一次 snap cgroup 错误都没有,也没再重启过。所以在 Ubuntu 上,别把 snap 装的浏览器交给 PM2 或者 systemd 管,snap 的 cgroup 隔离和外面的进程管理器就是合不来,老老实实用 .deb 包。
二、给 PM2 加重启限制。就算 Chrome 换掉了,所有 PM2 进程也还是得有个兜底:
// ecosystem.config.cjs
{
  name: 'my-service',
  script: '/path/to/script.js',
  max_restarts: 10,      // 崩溃 10 次后停止
  min_uptime: '10s',     // 跑满 10 秒才算"启动成功"
  restart_delay: 5000,   // 每次重启间隔 5 秒
}
PM2 进程要是没设 max_restarts 和 restart_delay,随便崩一次都可能变成无限 fork 循环,这回算是亲身验证了一遍。
三、装 fail2ban:
sudo apt-get install -y fail2ban

sudo tee /etc/fail2ban/jail.local << 'EOF'
[sshd]
enabled = true
port = ssh
filter = sshd
logpath = /var/log/auth.log
maxretry = 3
bantime = 3600
findtime = 600
EOF

sudo systemctl enable --now fail2ban
装完不到十分钟,fail2ban 就封了第一个 IP。SSH 挂在公网 IP 上就是这样,每分钟都有人在敲门。
四、加 swap:
sudo fallocate -l 4G /swapfile
sudo chmod 600 /swapfile
sudo mkswap /swapfile
sudo swapon /swapfile
echo '/swapfile none swap sw 0 0' | sudo tee -a /etc/fstab
4GB,差不多是内存的 25%。swap 不指望它当内存用,就是给 OOM killer 留点缓冲,让内核有时间做 reclaim,不至于直接死锁。
五、SSH 加固:
sudo tee /etc/ssh/sshd_config.d/99-hardening.conf << 'EOF'
PermitRootLogin no
MaxStartups 5:50:10
MaxSessions 5
LoginGraceTime 30
EOF

sudo sshd -t && sudo systemctl reload ssh
这里面最管用的是 MaxStartups 5:50:10。它允许 5 个还没认证的连接,再来的新连接每个有 50% 的概率被直接丢掉,最多 10 个。这样暴力破解的流量在 TCP 层就被限住了,加密和认证都还没开始。
几个小时后,又死了
修完这五项,我觉得稳了,就回去写代码。结果过了几个小时,又连不上了。
这回我连惊讶都没有,直接开 claude code,说了第二句话:「又死了,查。」查下来发现,第一轮修的只是表面,机器本身的毛病一点没动。
claude code 把 VM 重置以后,先看了内存都被谁占着:
| 服务 | RSS |
|---|---|
| Chrome(6 个进程) | 861 MB |
| PM2 + Node(9 个服务) | 529 MB |
| openclaw-gateway(Docker) | ~500 MB |
| claude code(opus) | 412 MB |
| LiteLLM(Docker) | 258 MB |
| Docker daemon | 194 MB |
| Xvfb | 80 MB |
| 合计 | ~2.8 GB |
一开机就吃掉 2.8GB。Cursor 远程连上来再加 1GB,跑两个 claude code 实例又加 1GB,Docker 容器还没设内存上限,理论上能一直涨下去。第一轮修好了崩溃循环,可每个进程都能无限吃内存,这事完全没人管。snap Chrome 是不再当 fork 炸弹了,但整台机器的内存还是没人看着。
还发现一件挺离谱的事,snap Chromium 居然还在系统里。上一轮只是在 PM2 里把路径换成了 Google Chrome,snap 包压根没卸,AppArmor 日志里还能看到 snap chromium 的 DENIED 记录。
第二轮:七件事
一、Docker 内存限制。openclaw-gateway 限 1.5GB,litellm 限 512MB,写进 docker-compose.override.yml,重启以后生效。
services:
  openclaw-gateway:
    deploy:
      resources:
        limits:
          memory: 1536M
二、彻底删掉 snap Chromium。sudo snap remove chromium --purge,这次是真卸了。
三、sysctl 调优。vm.swappiness=10,少用 swap,先回收缓存;vm.overcommit_memory=0,严格模式,不让进程申请超过实际可用的内存。写进 /etc/sysctl.d/,重启生效。
四、OOM killer 优先级。给 sshd 设 oom_score_adj=-1000,永远不杀它,这样什么时候都能 SSH 进去;给 Chrome 设 +500,内存不够先杀它。这两个值用一个 systemd service 开机自动设好。
五、内存看门狗。用 cron 跑一个脚本,每分钟看一次内存用了多少,超过 85% 就杀掉 Chrome 并记日志,超过 95% 就把 PM2 里最吃内存的进程杀掉。
六、装 GCP Ops Agent。内存、CPU、磁盘的指标实时报给 Cloud Monitoring,再配一条告警,内存用量超过 85% 持续 2 分钟就发通知。
七、PM2 内存上限。每个 PM2 进程都加上 max_memory_restart,Chrome 400MB,其他服务 150-200MB,谁超了就重启谁,不让哪个进程把整台机器吃光。
顺便发现机型也选错了
聊到要不要加内存的时候,claude code 顺手查了一下机型。c3-standard-4 是计算优化型,Intel Sapphire Rapids,2.7GHz,是给 HPC 和游戏服务器用的。我拿它跑什么呢?claude code 在等 API 返回,Cursor IDE 99% 的时间闲着,Docker 在转发 LLM 请求。等于我一直在为根本用不上的 CPU 性能多掏钱。
拉个对比出来是这样:
| 机型 | vCPU | 内存 | 月费 | 对比 |
|---|---|---|---|---|
| c3-standard-4(当前) | 4 | 16GB | ~$152 | — |
| e2-highmem-4(推荐) | 4 | 32GB | ~$131 | 省 $21,内存翻倍 |
| e2-standard-4 | 4 | 16GB | ~$97 | 省 36%,内存不变 |
e2-highmem-4 内存翻了一倍,月费反而更低。e2 是通用型,用的是共享核心调度,适合忽高忽低的负载。我这台机器平时就是等 API、等我敲键盘,偶尔跑个 npm run build,根本用不着专门的 Sapphire Rapids 核心。
换机型只要三步,停机、改机型、再启动,前后 30 秒,磁盘、IP 和配置都还在:
gcloud compute instances stop claude-devbox --zone=us-west1-b
gcloud compute instances set-machine-type claude-devbox \
  --zone=us-west1-b --machine-type=e2-highmem-4
gcloud compute instances start claude-devbox --zone=us-west1-b
换完是 32GB 内存,空着 28GB。原来那 6 个 claude 会话在 16GB 上挤得很难受,现在连一半内存都用不到。
12 项加固清单
两轮加起来一共 12 项。第一轮是止血:换掉 snap Chrome(用 .deb 包替掉 snap,cgroup 就不冲突了);PM2 重启限制(max_restarts + restart_delay,防 fork 炸弹);fail2ban(挡 SSH 暴力破解);4GB swap(给 OOM killer 留缓冲);SSH 加固(MaxStartups 5:50:10,在 TCP 层限流)。
第二轮是根治:Docker 内存限制(每个容器都有上限,吃不光宿主机);彻底删掉 snap Chromium;sysctl 调优(swappiness=10、overcommit_memory=0);OOM killer 优先级(sshd 永远不杀,Chrome 先杀);内存看门狗(cron 每分钟看一次,到 85% 自动止损);GCP Ops Agent 加告警(实时监控,到 85% 就通知);换机型(c3-standard-4 换成 e2-highmem-4,内存翻倍,钱还少了)。
学到了什么
回头看,第一次死其实是好几个问题凑到一起了。snap Chrome 的崩溃循环是直接原因没错,但如果有 PM2 重启限制,它就循环不起来;配了 swap,内存耗尽也不至于直接锁死;装了 fail2ban,那六千次暴力破解也凑不上热闹。这些问题单拎出来哪个都不致命,要命的是一层防线都没有,其实随便哪一环兜一下,机器都死不了。所以防线得有好几层,一层漏了还有下一层。
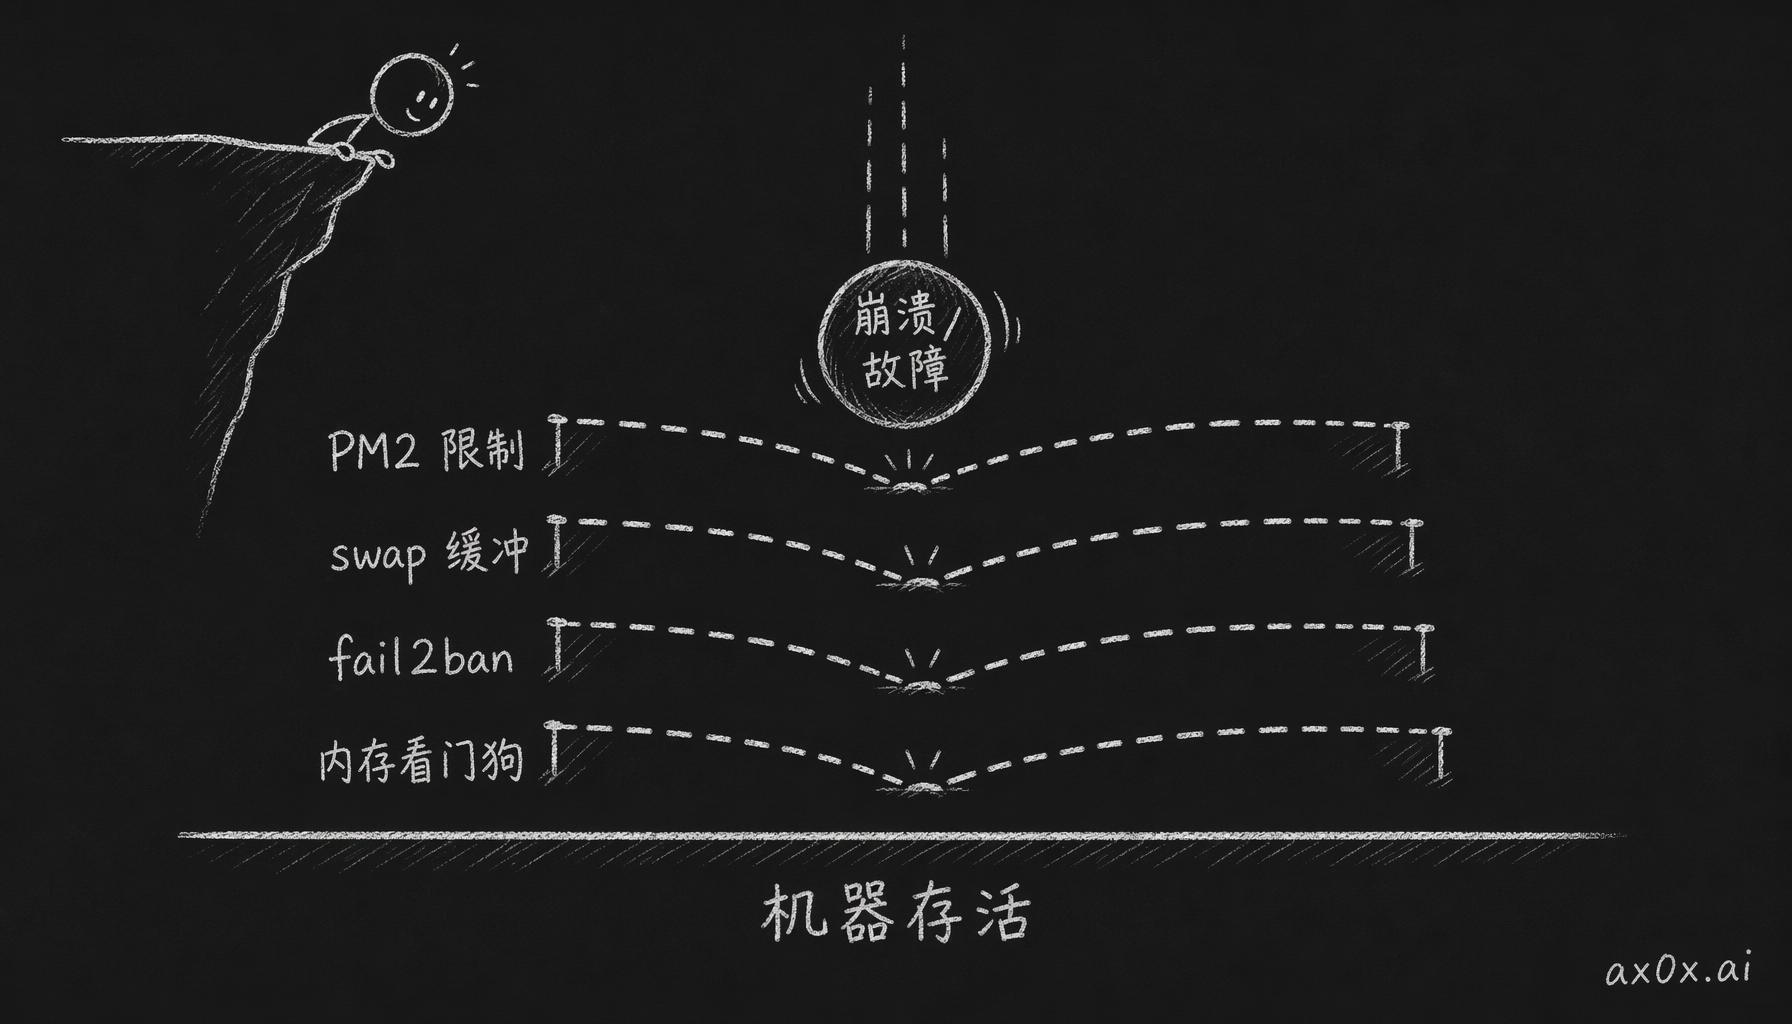 纵深防御:故障像坠落的小球,一层防线漏了还有下一层接住,多层叠起来任何单点失效都兜得住
第二次更扎心,修完一轮别急着觉得安全了。我当时是真觉得稳了,结果 Docker 没设 memory limit,PM2 没设 max_memory_restart,监控告警一个都没有,连机型都选错了。只要还有进程能无限吃内存,机器就总有办法死。现在我修完东西会多想一步,问问自己它还能怎么死,想不出来了才算修完。
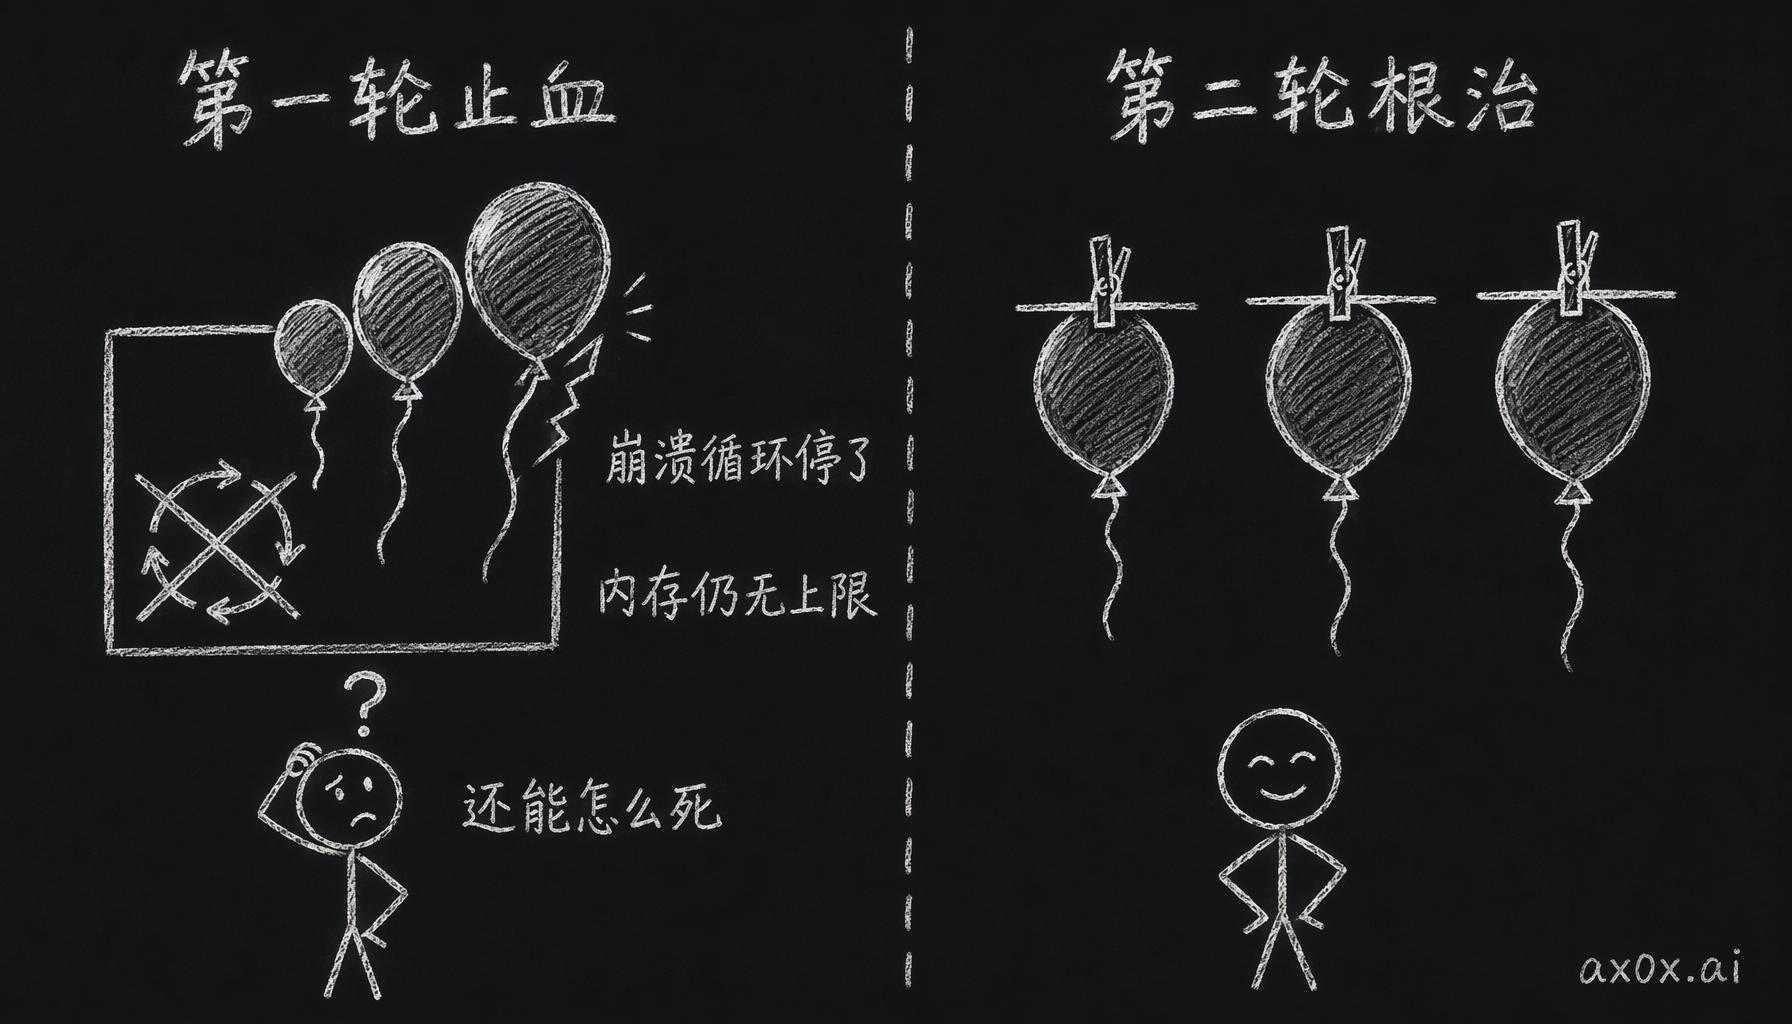 修完表面≠修完根因:第一轮止住崩溃循环,但每个进程仍能无限吃内存,得一直问『还能怎么死』直到问不出来才算修完
反正开发机挂在公网上,每分钟都有人来敲门,出事是迟早的,就看出事的时候你有几层防线兜着。这 12 项现在都跑着,先观察一阵。