
审代码这活,我也交给 agent team 了
 四个 AI 审查员并行审代码
上一篇讲的是构建。十个任务拆给五个 AI,按 DAG 分三波调度,一个 session 就把 Mio 的多模态输入、增强 onboarding 和 selfie 生成全做完了。但构建完其实活只干了一半。五个 agent 并行写出了 81 个 commit,横跨三层架构,代码能跑,typecheck 也全过。可是能跑只能说明它没写崩,扛不扛得住还得另说,中间还差一轮认真的 review。所以这篇讲另一半,审代码、修 bug、发版本,用的还是同一套 agent team 的模式,只是干的活完全不一样。
这个 session 是崩溃之后恢复回来的,context 已经压缩过一轮了。所以第一步先不急着干活,先重新确认一下状态:
比 origin 领先 38 个 commit
TypeScript: 0 errors
基线没什么问题。但扫 repo 状态的时候,顺手扫出来一个 bug,{custom_story} 这个占位符漏进了 LLM 的 prompt。五个人格配置文件里都留着这个早就没用的模板占位符,本来 onboarding 的时候应该替换掉,结果替换逻辑根本没管它,它就原封不动地进了发给模型的 system prompt。这种 bug 麻烦就麻烦在它「能跑」。模型看到这段乱码会直接忽略,照常回复,功能上什么都没坏,但每条消息都在白白浪费 token。而且真有人去看 prompt,看到一个光秃秃的 {custom_story} 挂在里面,还是挺尴尬的。修起来是小事,但这也正是发布前要做 review 的原因,这类东西你不主动去查,它永远不会自己冒出来。
四个专业 reviewer,各看各的
我跟 claude code 说了一句:"ok do a full review with agent team of the implementations." 它就起了四个专业的审查 agent,每个管一块:
- Media reviewer,管 transcribe、vision、process、selfie、reference-images、file-download 这一摊。
- Onboarding reviewer,管状态机、命令、预设配置、schema。
- Pipeline reviewer,管 server 的 index.ts、router、system-prompt、agent loop。
- Security auditor,管 API key、输入验证、路径穿越、SSRF、prompt 注入、成本滥用。
为什么要分专业?其实跟人的团队一个道理,同一个文件,安全专家和做功能的 reviewer 看到的东西不一样。通用 reviewer 盯的是代码本身写得对不对,security auditor 不太管这个,它一门心思都在攻击面上,找哪些地方能被人钻进去。四份报告大概五分钟就全回来了,汇总是这样:
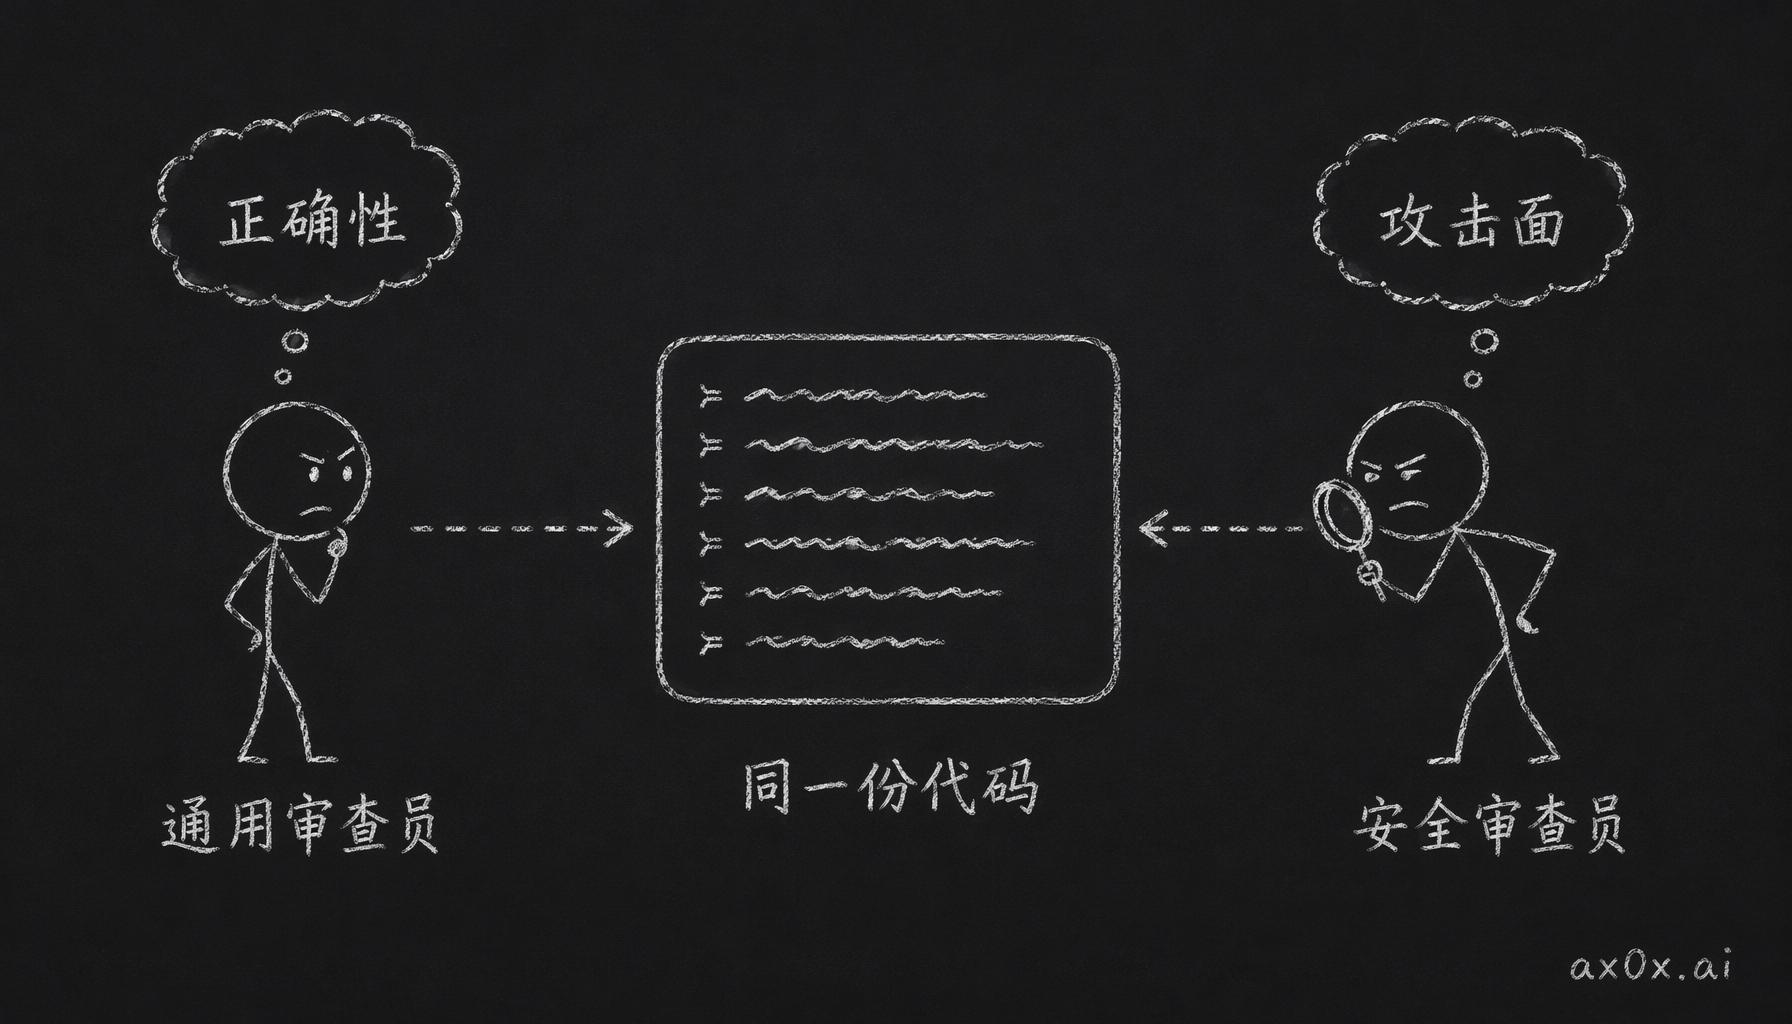 同一份代码,通用审查员盯正确性、安全审查员盯攻击面,专业分工才能各自发现对方漏掉的 bug
| 审查员 | 结论 | CRITICAL | HIGH | MEDIUM |
|---|---|---|---|---|
| Media | WARNING | 0 | 4 | 10 |
| Pipeline | BLOCK | 2 | 4 | 6 |
| Onboarding | WARNING | 0 | 4 | 7+ |
| Security | BLOCK | 2 | 4 | 5 |
两个 BLOCK 加两个 WARNING,这样是发不了的。四个 CRITICAL 分别是:
- 成本归因缺失。
processMedia()被调用的时候还拿不到userId,媒体处理花的钱就记不到对应的用户头上。 - 打字指示器泄漏。消息批次是空的时候没调
clearInterval,bot 就会一直显示「正在输入...」。 - HTTP API 路径穿越。
/api/agents这个端点收一个presetId参数,不做任何验证就直接拼进了文件路径,很经典的目录穿越漏洞。 - bot token 泄漏到下载 URL。Telegram 的文件下载 URL 本身就带着 bot token,下载出错的时候,这个 URL 可能连着 token 一起被打进错误日志。
HIGH 大概有十个,四份报告去重之后是这些:引用图片的缓存没设上限(这条三个 reviewer 都各自标了);selfie 和 media 操作没有超时;生成端点没有限流;.replace() 里的 $ 符号会造成模板注入;item.size 是 undefined 的时候,文件下载就没有大小上限;没校验 MIME 类型;超时之后 about_user 被设成空字符串,验证就这么绕过去了;onboarding 还没走完的时候跑 /reonboard 会有竞态;bubble transform 里的 token 计数会变成 NaN;成本追踪出错了也不吭声,.catch(() => {}) 把错误直接吞了。
这里面有些问题,一个认真的通用 reviewer 也能找到。但路径穿越和 bot token 泄漏这种,是 security auditor 专门去探攻击面才探出来的。成本归因那个,是 pipeline reviewer 顺着数据流一路追出来的,因为那条数据流横跨好几个模块,不专门追根本注意不到。所以分专业多花的这份成本,我觉得挺值。
三个 fixer,严格按文件分
审查结果拿到以后,又起了三个修复 agent,分工严格按文件所有权来:
- Security fixer,管 agents.ts、file-download.ts、onboarding.ts、process.ts。路径穿越:加 preset ID 白名单验证。bot token 泄漏:把原始错误换成通用错误信息。模板注入:用
split/join换掉.replace()。MIME 验证:给 audio、image、video 各加一个类型白名单。 - Pipeline fixer,管 index.ts、loop.ts、reference-images.ts。打字指示器:在空批次那条路径上补
clearInterval。成本归因:把 Telegram user ID 传进processMedia()。NaN token:在合成事件里替换成 0。selfie 超时:加 30 秒的AbortController。缓存上限:最多 10 条,最旧的先淘汰。成本日志:用真正记错误的日志换掉.catch(() => {})。 - Onboarding fixer,管 onboarding.ts、process.ts、commands.ts。超时默认值:不设空字符串了,设成「用户未填写自我介绍」。reonboard 竞态:开新会话之前先调
clearOnboardingState()。下载后大小检查:Telegram 不给文件大小的时候,下载完再验一次。Promise.allSettled:一个媒体失败,不会再把全部结果带崩。
这里有一点得提一下,没有哪两个 agent 改过同一个文件。上一篇里构建的时候,文件所有权是用来防合并冲突的,修 bug 也是这个原则。分工按文件分,一个文件永远只有一个 agent 在动,所以三个 agent 同时改代码也不会互相踩脚。
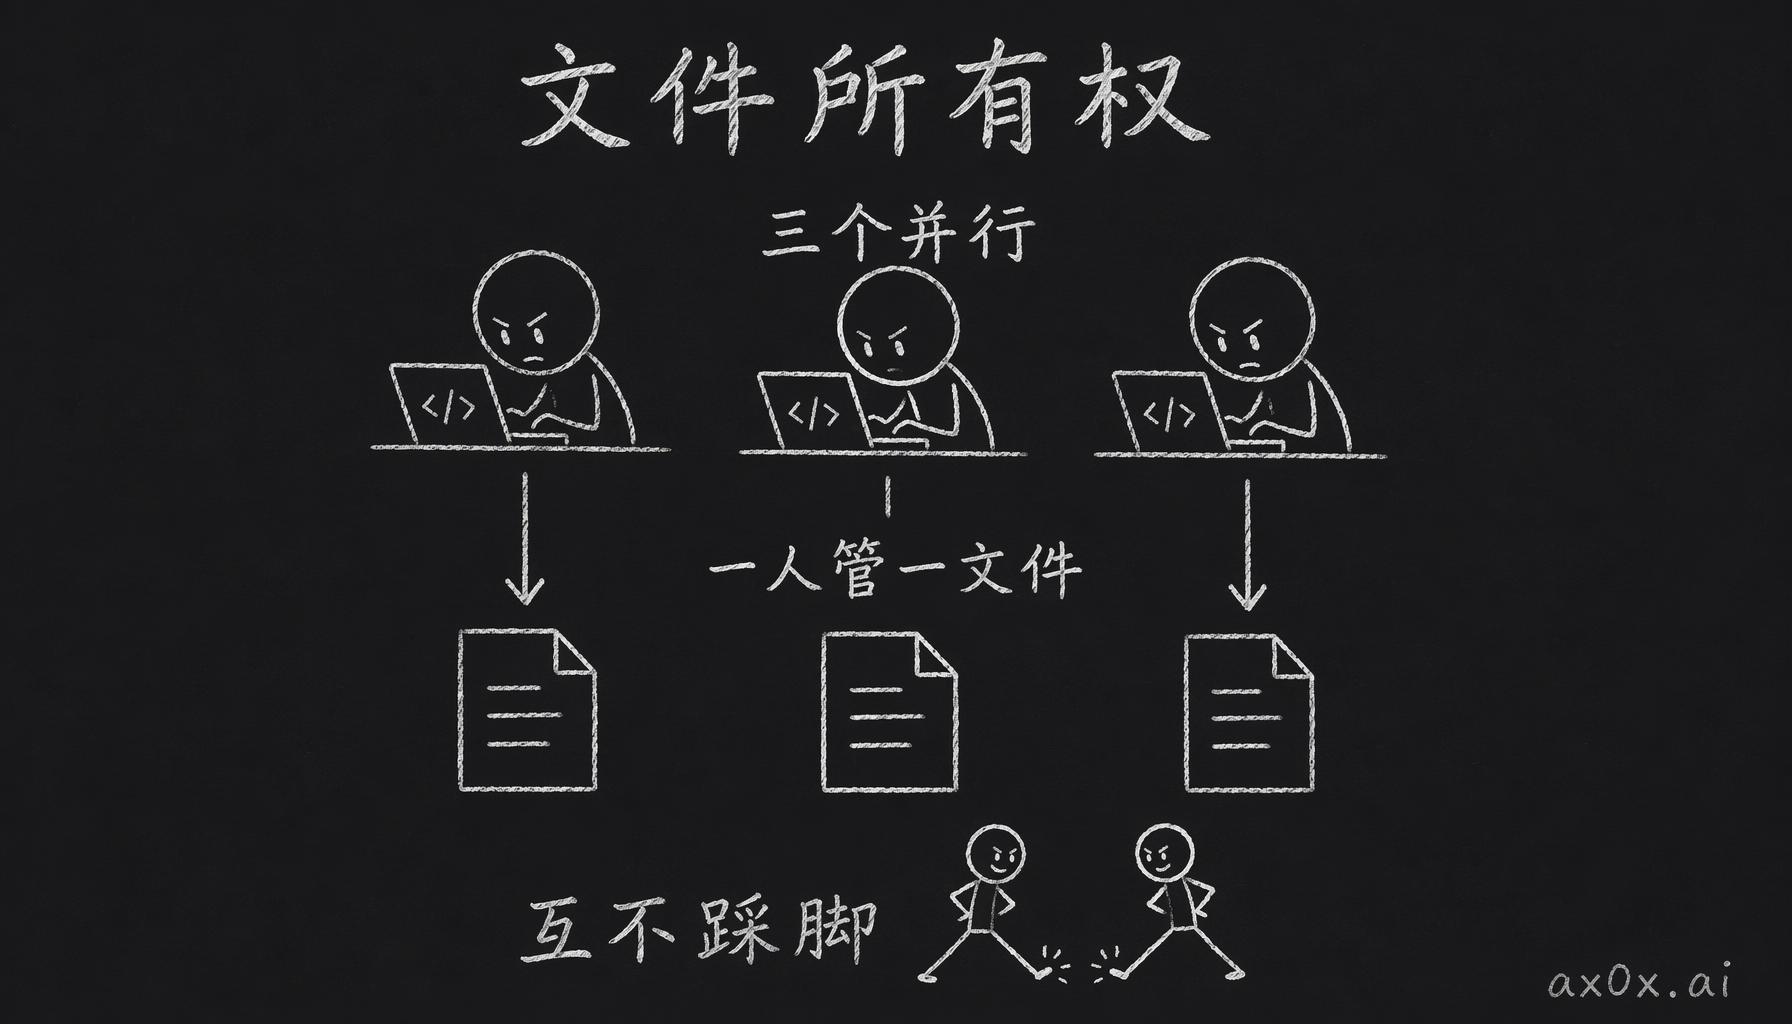 修复按文件所有权分工,一个文件只有一个 agent 在动,三个修复员并行改代码也互不踩脚
第四个 agent 是文档更新员,跟修复一起跑,把 CLAUDE.md、API.md、SCHEMA.md、TECHNICAL.md、DATA-FLOWS.md、CONVENTIONS.md 和 TODO.md 全都更新了一遍。文档漂移是真会发生的,趁改动还热乎顺手修掉,比过阵子发现文档全过期了再补要便宜得多。
changelog 和发布:机械活直接扔给 agent
修复都提交以后,我又说了一句:"let's also add a changelog thing." claude code 就同时起了两个 changelog agent。一个管 v0.0.1,看前 39 个 commit(2 月 26 日上午 10 点 PST 之前),也就是打基础的那段;另一个管 v0.0.2,看后面那 81 个 commit,也就是上一篇里三个功能一起冲的那一轮,再加上这一轮所有的审查修复。两个 agent 各写各的,最后合成一份 CHANGELOG.md,然后:
git tag v0.0.1 <commit-hash>
git tag v0.0.2
gh release create v0.0.1 --notes-file ...
gh release create v0.0.2 --notes-file ...
两个版本、两个 tag、两个 GitHub release。这种活纯机械,不需要什么判断,说实话也没人想手动做,扔给 agent 跑就完了。
最后一步是把经验存下来。项目的 CLAUDE.md 里加了两样东西,一个是 "Releases & Versioning" 章节,把写 changelog 和打 tag 的流程记下来;另一个是一条规则,"Always use doc-updater subagent for documentation updates"。流程上改进了什么,不记下来就没了,下次还会在同一个地方卡住。CLAUDE.md 就是这个项目的记忆,写进去的东西换了 session 也还在,context 压缩之后还在,崩溃恢复之后也还在,反正写进去就丢不了。VM 那篇里讲过,长 session 里崩了再恢复是常事,所以往 CLAUDE.md 里写得越多,context 重置的时候丢的就越少。
从审查到发布这一整轮,拆开是五个阶段,一共十一个 agent,全在一个 claude code session 里跑完:
- 审查前清理(1 个 agent,手动修复)
- 并行代码审查(4 个专业 reviewer)
- 并行修复(3 个 fixer + 1 个文档更新员)
- changelog + 发布(2 个 changelog agent)
- 流程改进(把经验写进 CLAUDE.md)
这种先审再修的流程,后来我又跑了几轮,攒下来几条习惯:
- reviewer 可以分专业。security auditor 和 pipeline reviewer 看同一个文件,能找出不一样的 bug,通用审查会漏掉只跟某个领域有关的问题。
- fixer 要严格按文件所有权分。不让两个 agent 改同一个文件。分工按文件分,不按 issue 分,两个 issue 落在同一个文件上,就交给同一个 fixer。
- 文档更新跟修复一起跑。旁边多挂一个文档更新 agent,几乎不多花什么,但能防住文档漂移。
- 走流程的活可以全自动。changelog、tag、release 这些都是机械活,用不着人来判断。
- 审查过程里学到的东西,session 结束前写进 CLAUDE.md。
上一篇讲的是 agent team 怎么把东西造出来,拆计划、排依赖、五个 agent 并行写代码。这篇的审查、修复、发布,用的还是那几样,任务分解、文件所有权、并行执行,一样新东西都没有。反正现在写代码的已经不是人了,审代码的也不是,人管的是 high-level 的决策。这个 session 里我拢共就说了两句,一句开审查,一句要 changelog,剩下的活都是 agent 在跑,后面几轮基本也还是这么跑的。