服务器又挂了,查下来是 cursor 的问题
 内存泄漏监控仪表盘
开发机又挂了,讲道理这事挺离谱的。第三篇里那台 16GB 的 c3-standard-4 被 snap Chrome 的崩溃循环搞死过一次,之后我做了 12 项加固,机器换成 32GB 的 e2-highmem-4,还专门装了个内存看门狗,本来觉得这事翻篇了。结果这天又是一样的场面,我当时的原话是「server seems dead again wtf is going on??」。SSH 超时,卡在 banner exchange,跟第三篇一模一样,内核活着,用户态没人应门。
先处理了个小插曲,gcloud 认证过期了,得重新登一遍:
gcloud auth login
然后查 VM 状态:
gcloud compute instances list --filter="name~claude-devbox"
RUNNING。跟上次一样,GCP 觉得机器好好的,实际上用户态已经冻住了。
去 serial console 里翻日志:
gcloud compute instances get-serial-port-output claude-devbox --zone=us-west1-b
能看到两件事。第一件,GCP Ops Agent(otelopscol)一直在循环报 PermissionDenied,每一轮丢掉 1,800 多条 metrics,同时还在狂写错误日志。这个 agent 是第三篇装的,装它就是为了防崩溃,结果它自己在加速崩溃,挺讽刺的。第二件,日志最后一行是 systemd-resolved: Under memory pressure, flushing caches,然后就没了。是内存压力,有方向了。
reset 重启:
gcloud compute instances reset claude-devbox --zone=us-west1-b
SSH 能进去了。看门狗这段时间一直在记日志,机器是怎么死的,整个过程都被它录下来了。
01:39 UTC,开机 8 小时,内存 87%,claude code 占 1GB。这时候还没什么事。
09:12 UTC,开机 15 小时,内存 89%,五个 node 进程,每个 2-2.7GB,合计约 12.8GB。这时候内存已经快见底了。
09:13 UTC,内存 94%,swap 88%,看门狗动手杀了 Chrome 和一个 node 进程。但已经来不及了,系统进了死亡螺旋。
那个时间点,32GB 内存是这么被分掉的:
| 进程 | RSS |
|---|---|
| 5x node(Cursor) | ~12.8 GB |
| Chrome | ~0.9 GB |
| openclaw-gateway(Docker) | ~0.6 GB |
| PM2 服务 | ~0.8 GB |
| LiteLLM(Docker) | ~0.3 GB |
| GCP Ops Agent | ~0.5 GB |
| Docker + 内核开销 | ~0.5 GB |
| 合计 | ~16.4 GB 内存 + 3.5 GB swap |
32GB 的机器,进程吃掉了大概 20GB,光五个 node 进程就占了将近一半。光看这个分布,问题出在哪就很明显了。
我第一反应是 claude code 在吃内存。之前见过它涨到 1-2GB,五个 session 各 2.7GB,好像也说得通。其实也谈不上说得通,是我当时想当然了。看门狗日志里写的进程名是 node,不是 claude。claude code 的进程名就叫 claude,如果那五个真是 claude session,日志记的就会是 claude。它记的是 node,所以这五个进程是 Cursor 的。
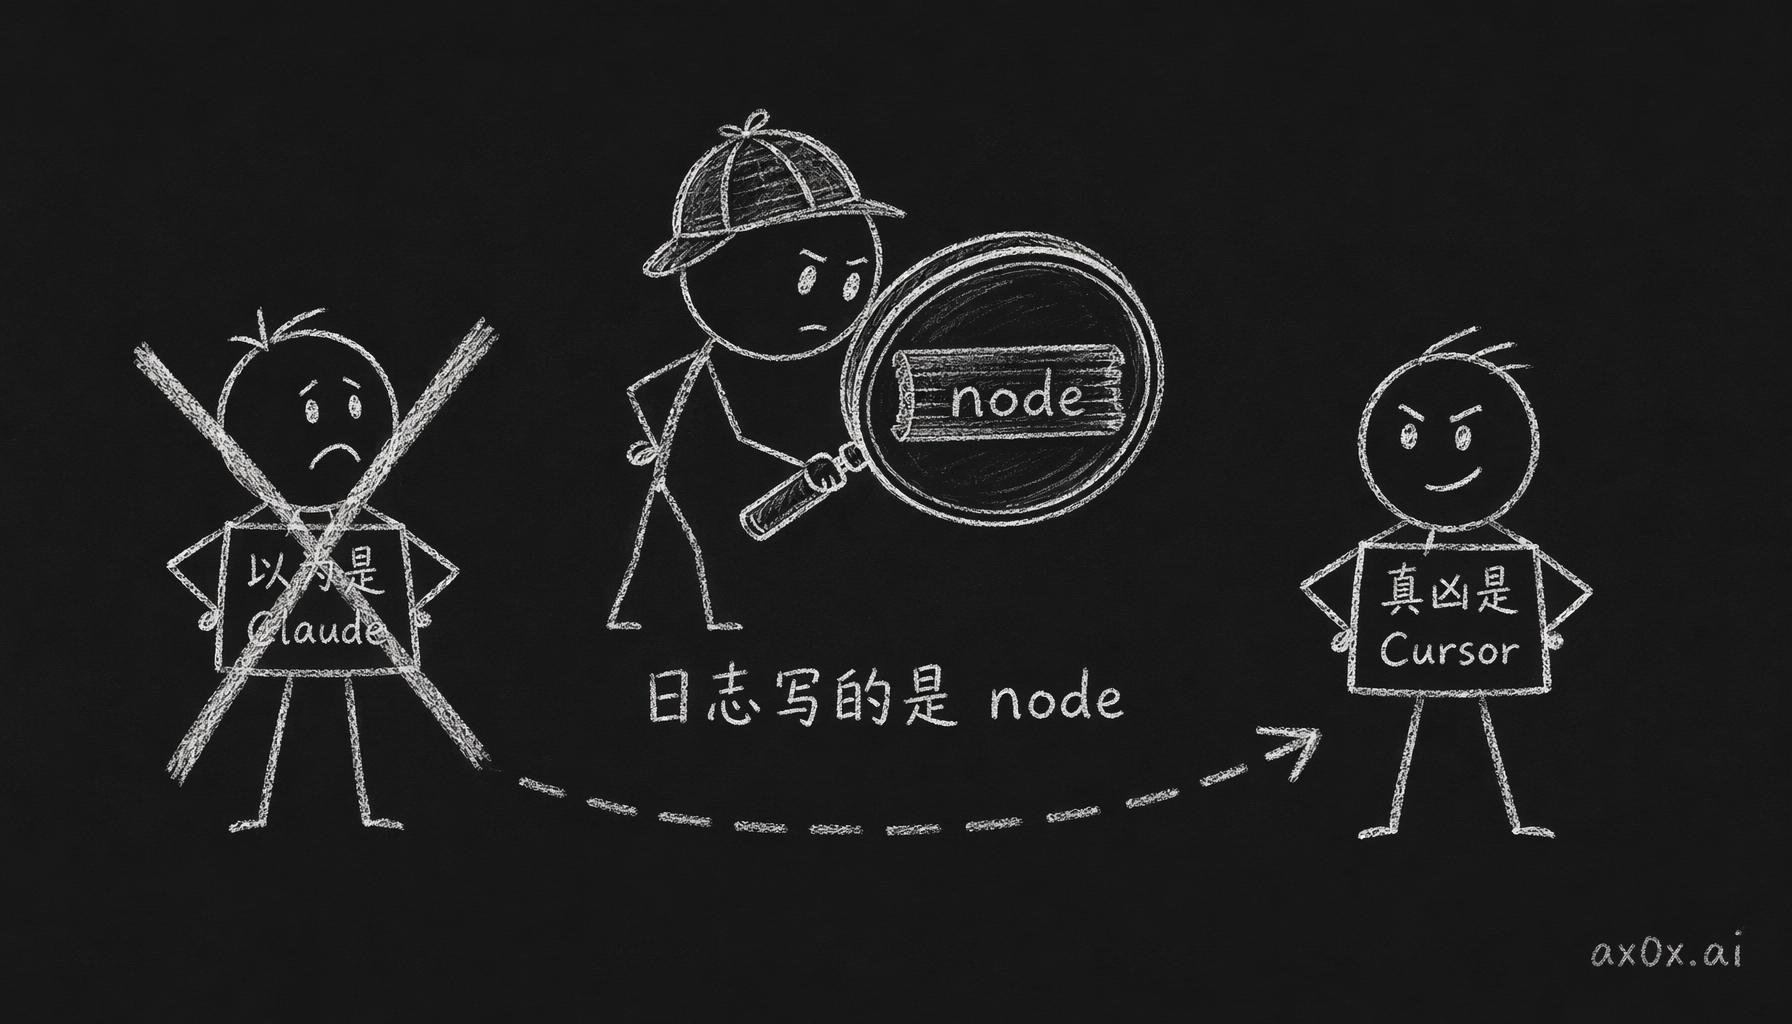 第一反应怪罪 claude code,但看门狗日志记的进程名是 node 而非 claude,据此把真凶锁定为 Cursor
后来我就去查了一下 Cursor 的 SSH 远程模式是怎么跑的。它会在服务器上起一堆 node 子进程:
- server-main.js:缓存打开的文件、撤销历史、搜索索引,从不释放。
- extensionHost:所有扩展跑在一个进程里。V8 的 gc 很懒,不到内存压力大不做 major gc,所以内存只涨不降。
- fileWatcher:在内存里存着整个文件树,仓库越大、文件事件越多,它就越涨。
- ptyHost:终端滚动缓冲区,从不截断。
- tsserver:把整个项目的 AST 放内存里,会重新解析,不会收缩。
而且默认没设 --max-old-space-size,V8 默认的堆上限大概是 4GB。15 个小时里,每个进程从约 400MB 涨到 2-2.7GB,胀了六七倍。五个进程一起这么涨,光 Cursor 就吃掉 12GB 以上,再加上机器上别的服务,32GB 就不够用了。
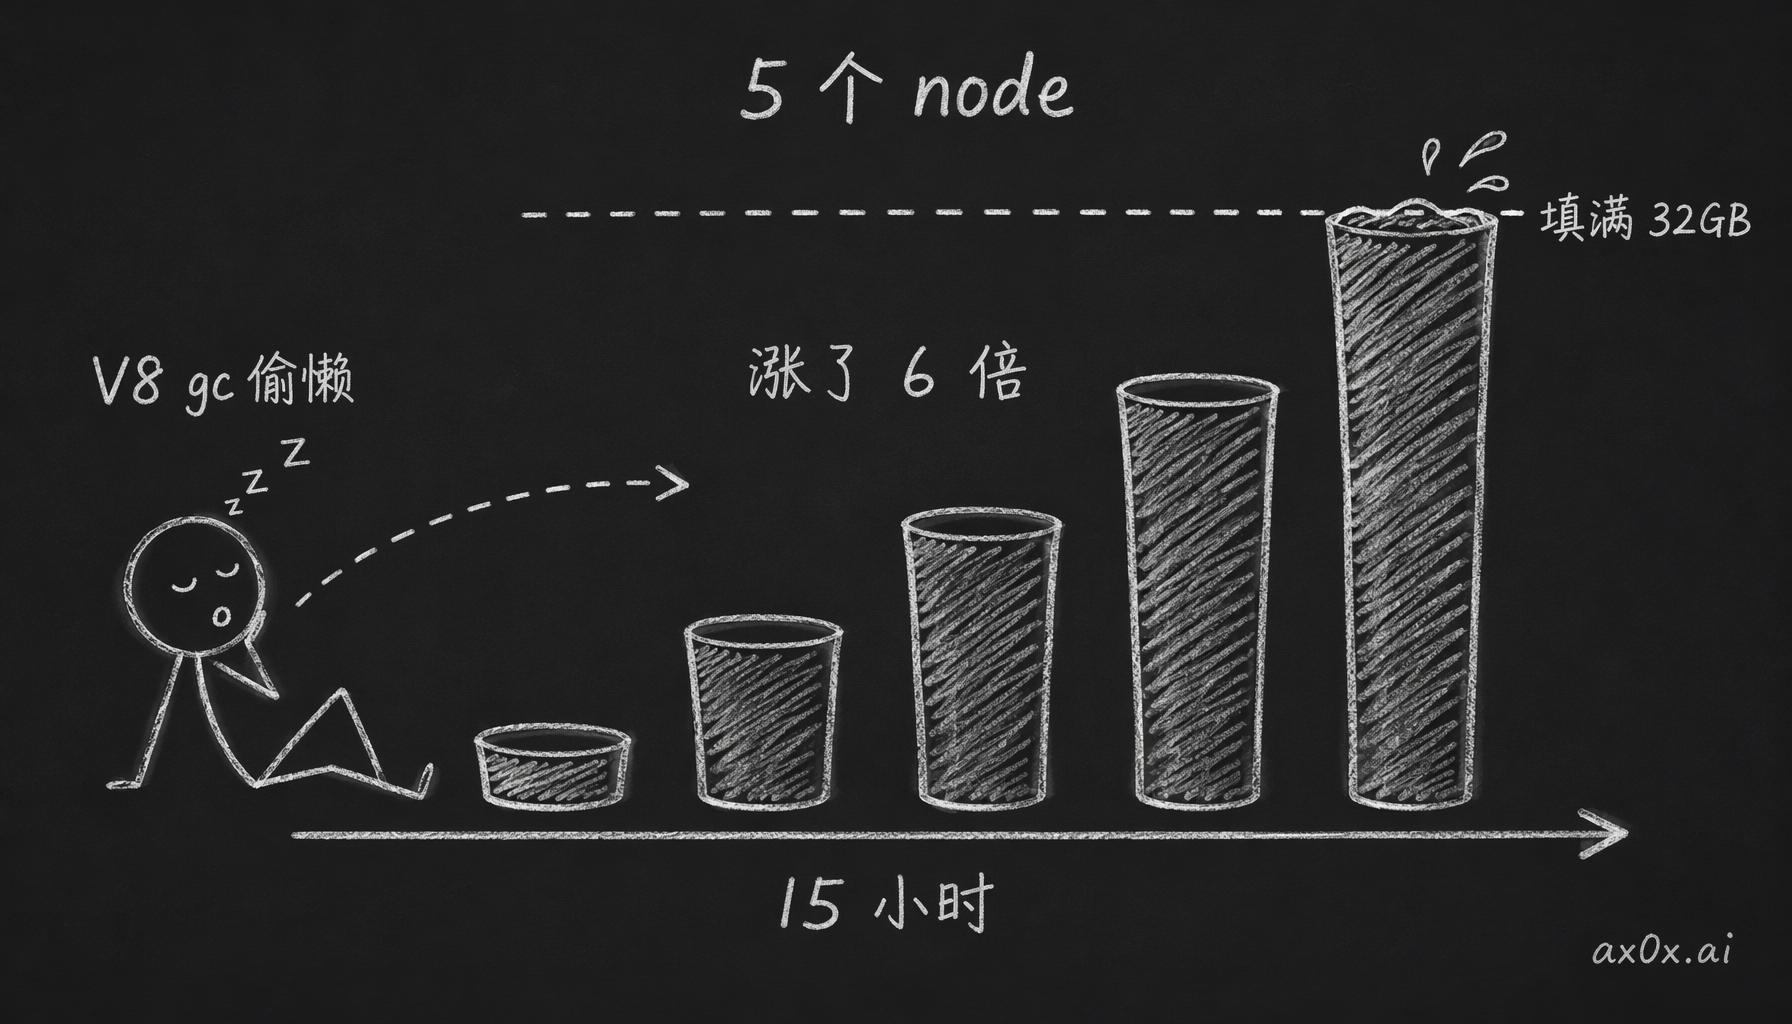 五个 node 进程因 V8 懒惰 gc 而单调膨胀,15 小时从约 400MB 涨到 2.7GB,把 32GB 内存填满
修了三个地方,一个一个说。一是 Ops Agent 的权限。这个监控 agent 是为了防崩溃装的,但 IAM 权限不对,每次推 metrics 都失败,失败了还写错误日志,白白耗磁盘 I/O 和内存。给 VM 的 service account 加上 monitoring.metricWriter 和 logging.logWriter 以后,错误日志就不再往外涌了。
二是看门狗阈值。旧阈值太松了,85% 才预警,92% 才杀 Chrome,等它动手的时候系统已经在 swap 里挣扎了。12GB 的 node 进程一直堆到 92% 它才出手,跟没管差不多。新阈值改成 75% 预警记日志,80% 杀 Chrome,85% 杀任何 RSS 超过 1GB 的 node 进程,赶在 swap 被打满之前动手。
三是给 Cursor 加个内存守卫,一个每 5 分钟跑一次的 cron。内容如下:
# 杀掉任何 .cursor-server 下超过 1GB RSS 的 node 进程
pgrep -f '.cursor-server' | while read pid; do
  rss=\$(awk '/VmRSS/{print \$2}' /proc/\$pid/status 2>/dev/null)
  if [ "\${rss:-0}" -gt 1048576 ]; then
    kill -TERM "\$pid"
    logger "cursor-guard: killed pid \$pid (RSS: \${rss}kB)"
  fi
done
SIGTERM 是温和的。Cursor 客户端发现断开了会自动重连,几秒钟的事,用起来就是编辑器闪一下「Reconnecting...」,然后一切照旧,工作一点不丢。这一点挺关键的,因为 Cursor 的远程架构本来就支持重连,服务端进程足够无状态,杀掉一个胀起来的进程没有任何影响,等于替 V8 做了一次它自己懒得做的 gc。不是每个架构都能这么干,能的话就用上。
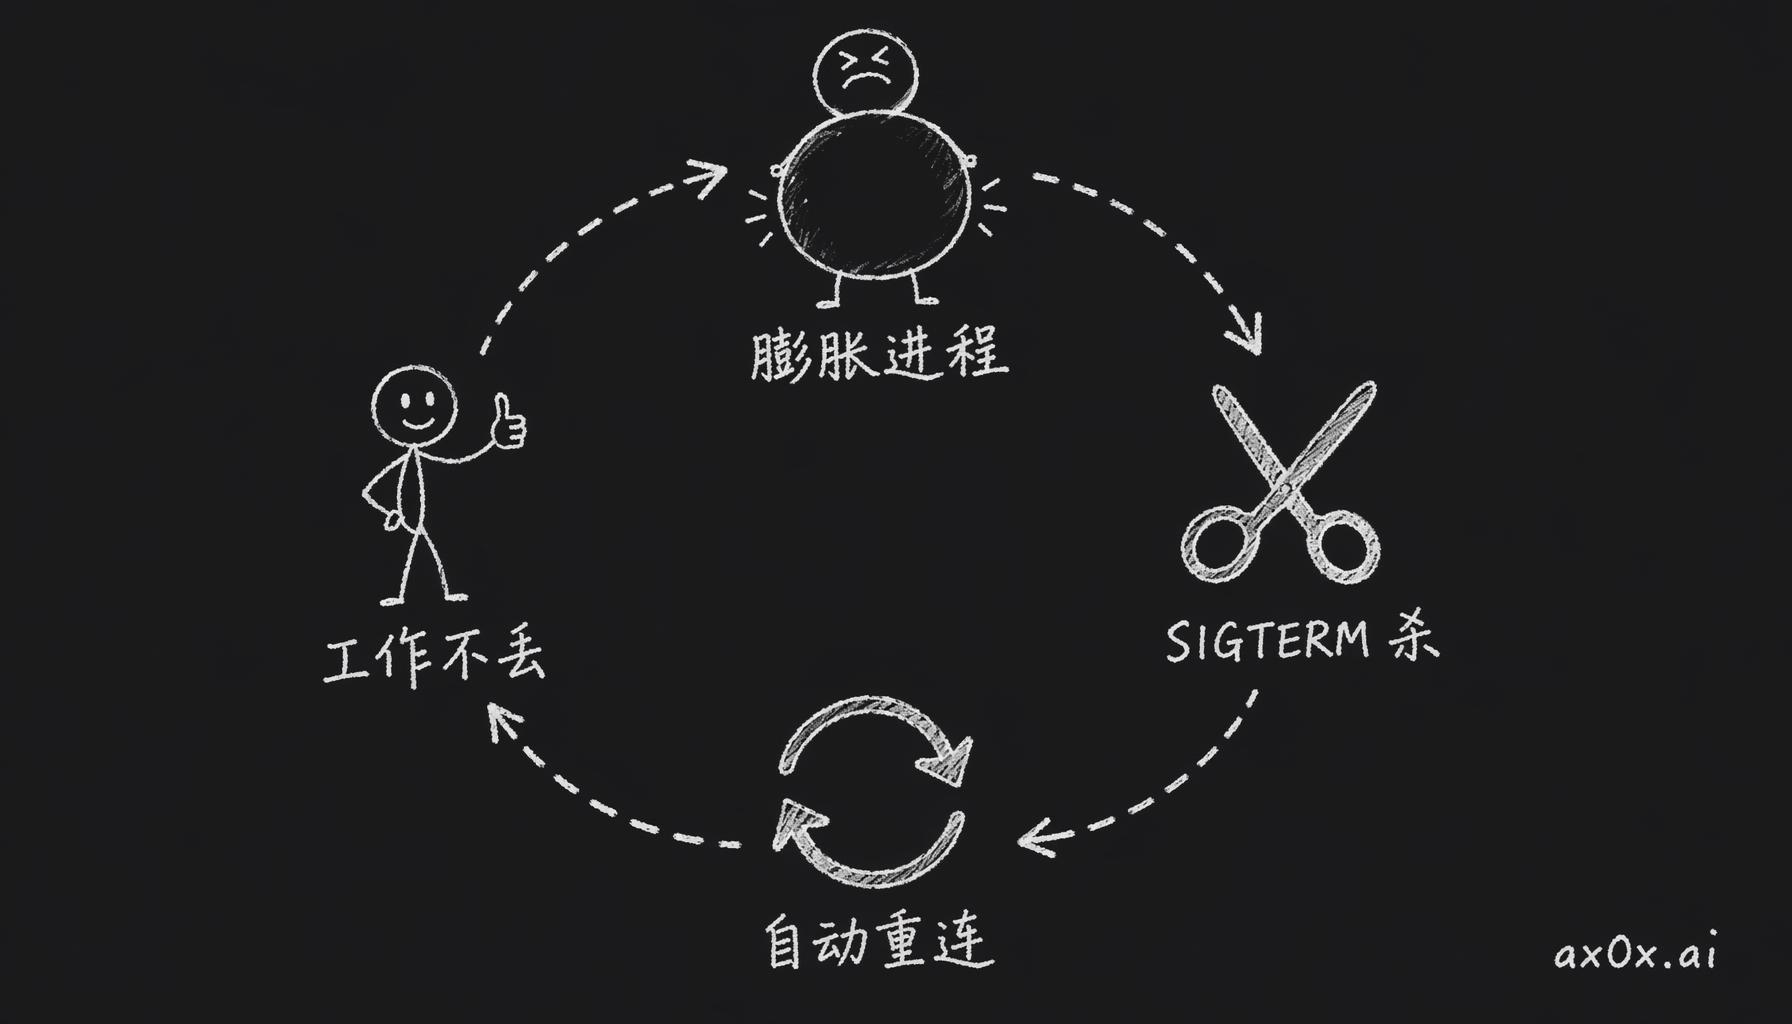 cron 用 SIGTERM 杀掉膨胀的 Cursor node 进程,客户端秒级自动重连、工作不丢,等于替 V8 做了一次它自己懒得做的 gc
回头看,这次跟第三篇其实是一回事,都是长时间跑的进程没有内存上限,慢慢把开发机的内存吃光。第三篇那次是 snap Chrome 的 fork 炸弹,机器还是 16GB。这次换成 Cursor 的 node 进程,机器都升到 32GB 了,还是被填满。所以 32GB 只是多买了点缓冲时间,问题本身没变。感觉只要没有进程级的内存上限,长时间跑的进程早晚会把你给它的 RAM 填满。V8 的 gc 策略基本保证了这一点,它不到堆压力大不做 major collection,而「压力大」的意思就是「快到上限了」。默认 4GB 上限再加上懒惰的 gc,每个 node 进程生下来就是一个慢速内存泄漏。
这次还有个事挺有感触的,就是监控本身也会出问题。Ops Agent 装上是为了抓内存异常,结果权限没配对,它自己反而在耗资源、刷错误日志。监控工具跟别的服务一样,也得配对权限、设好资源限制。另外就是进程名,看门狗日志里记的是 node 还是 claude,直接决定了往哪个方向查。我要是不看进程名,默认 node 就是 claude code,修的方向就全错了。
这些修完之后,开发机到现在一直挺稳的。但稳不稳我现在也不太敢下结论,毕竟第三篇修完那阵子它也稳过一段时间,先跑着看吧。