一个 session 里同时跑了三种协作模式
 三种协作模式并行运转
Mio v0.0.3 那天要干的活挺多的:给 telegram bot 的 onboarding 流程加分级输入验证,部署,看实际用起来的反馈再调限制,更新六个文档,写 changelog,打 v0.0.3 的 tag,跑一遍完整的代码审计,把审计找出来的问题全修掉,最后全部推到生产。这一堆从头到尾大概用了 26 分钟,因为有三种完全不同的协作模式同时在跑。下面一个模式一个模式地讲。
模式一:我说哪里不对,看着它改
这个 session 是从一个很具体的需求开始的,给 Mio 的 onboarding 流程加输入验证。bot 会问用户昵称、爱好、性格偏好,全是自由填写的文本,之前所有字段共用一个 500 字的上限。所以昵称那一栏能填 500 个字,这挺离谱的。
我把需求跟 cc 说了。它读了 onboarding 的代码,把所有输入字段找出来,做了个两档的方案,SHORT_INPUT_KEYS 里的字段(昵称、爱好)限 50 字,其他长文本字段还是 500。然后 build docker 镜像,push 到 registry,部署到 cloud run,revision 44。从读代码到写完再到部署,大概 14 分钟。
这就是直接模式。我和它盯着同一个问题结对干,docker build、gcloud run deploy 这种机械的活它来,怎么设计我来定。
500 → 50 → 10 → 6
部署完我去线上试了一下。昵称给 50 字还是太多,而且空白的输入也没拦住。我直接说:
"50 chars feels too much for name.. doing a one fit all max is bad, also validate blanks"
它马上就改了,不分两档了,改成每个字段单独设上限,昵称 10 字,风格/性格选项 30 字,爱好 50 字,长文本 500。空着提交会被打回来,还附一句「不能空着哦~」。build、push、deploy,revision 45。从我提反馈到新版本上线,大概两分钟。
然后我又看了一眼昵称的 10 字。中文名字一般就 2-4 个字,昵称也很少超过 6 个,给 10 个还是多了。
"max 10 char seems still a lot for chinese chars?"
改成 6,再部署一次,revision 46。
昵称上限就这样前后换了四个数,500 → 50 → 10 → 6,除了第一版,之后每一轮从我说「这不对」到「上线了」大概两分钟。不用提 ticket,不用等下个 sprint,也不用先上 staging 验一遍,就是我说哪里不对,看着它修,上线,我再试。三次生产部署都是在这段对话里顺手做完的。
模式二:踢个任务出去,自己继续干
昵称限制还在改的时候(就是 10 → 6 那一轮),文档的活也在排着:六个 docs 文件,一条 changelog,还有 v0.0.3 的 git tag。文档这种活最容易拖成「回头再补」,然后就一直没补。
我说了一句:
"spawn subagent to update all docs in docs/, todo, etc, and update changelog and tag v0.0.3 release"
cc 起了一个后台 agent,然后回过头接着跟我聊昵称限制。那个后台 agent 自己读文档,改六个文件,写 changelog,打 tag,这时候我还在主 session 里改实现。
过了几分钟它回来汇报,六个文档改完了,changelog 写好了,v0.0.3 的 tag 也打了。有个小出入,它写进文档的还是旧的 10 字限制,因为它和最后那轮改动是同时跑的,它先跑完了。这种记一笔回头改一下就行,不算什么事。
什么活该走后台很好判断,不用我盯着的就踢出去,我接着干主线。有点像你把一个 CI pipeline 丢出去跑,自己接着写代码,只不过这回跑 pipeline 的是个 agent。
模式三:给个目标,让它自己收敛
实现做完了,文档也在更新,接下来要做一次完整的代码审计。不是随便扫一眼,是彻底审一遍,还要把问题修掉。
"spawn agent team to do full review and audit of current codebase, then fix any issues. Do this iteration until review agent cannot find issues"
cc 建了个小团队,一个审查 agent,一个修复 agent,用依赖链串起来,然后开始一轮一轮地跑。
- 第一轮:审查 agent 扫了整个 codebase,找出 22 条问题,安全、可靠性、正确性方面的都有。修复 agent 接过去修了 21 条,剩一条先放着。那条是内存累加器批处理效率的优化,优先级 LOW,算是合理的技术债。
- 第二轮:审查 agent 对着修完的 codebase 重新跑,又找出 3 个新问题,都是第一轮修的时候带进来或者翻出来的。修复 agent 全修了。
- 第三轮:最后验一遍,没有新问题,结论 APPROVED。
三轮下来,25 个问题修了 24 个。剩下那条是性能优化,既不是 bug 也不是安全风险,现在去改,多出来的复杂度不值得。
团队模式里我只给了一个目标,审到干净为止。agent 怎么建,依赖链怎么设,迭代几轮,全是它自己的事。中间结果我一个都没看,只看了最后的总结。
这次和第五篇那次审查比,差别在迭代。那次只跑一遍,四个审查员找问题,三个修复员修完就结束了。这次审查 agent 会回头检查修复 agent 干的活,发现有漏的,修复 agent 再修,一直转到找不出新问题才停。
三种模式是怎么叠在一起的
实际的时间线是这样的:
0:00   开始实现输入验证
       ├── 直接模式:读代码,实现分级限制
14:00  部署 revision 44
       ├── 直接模式:用户测试,给反馈
       ├── "50 字太多了,要拦空白"
16:00  部署 revision 45(按字段限制 + 空白拦截)
       ├── 直接模式:继续反馈
       ├── "10 个字对中文名还是太多"
       ├── 后台模式:文档 agent 启动 ← 并发
17:00  部署 revision 46(昵称 → 6 字)
       ├── 后台 agent 还在跑文档/changelog
19:00  后台 agent 完成(6 个文档、changelog、v0.0.3 tag)
       ├── 团队模式:审查团队启动 ← 并发
       ├── 第一轮:22 条发现 → 修复 21 条
       ├── 第二轮:3 条新发现 → 全部修复
       ├── 第三轮:验证通过 → APPROVED
26:00  全部提交、推送、gh release 创建完毕
我在主 session 里跟 cc 结对的时候,文档 agent 在后台跑;审查团队自己迭代的时候,我在忙发布的事。实现和文档是叠着做的,我这边改代码,后台 agent 那边更新文档。审查那一段就完全不用我管了,团队自己转。
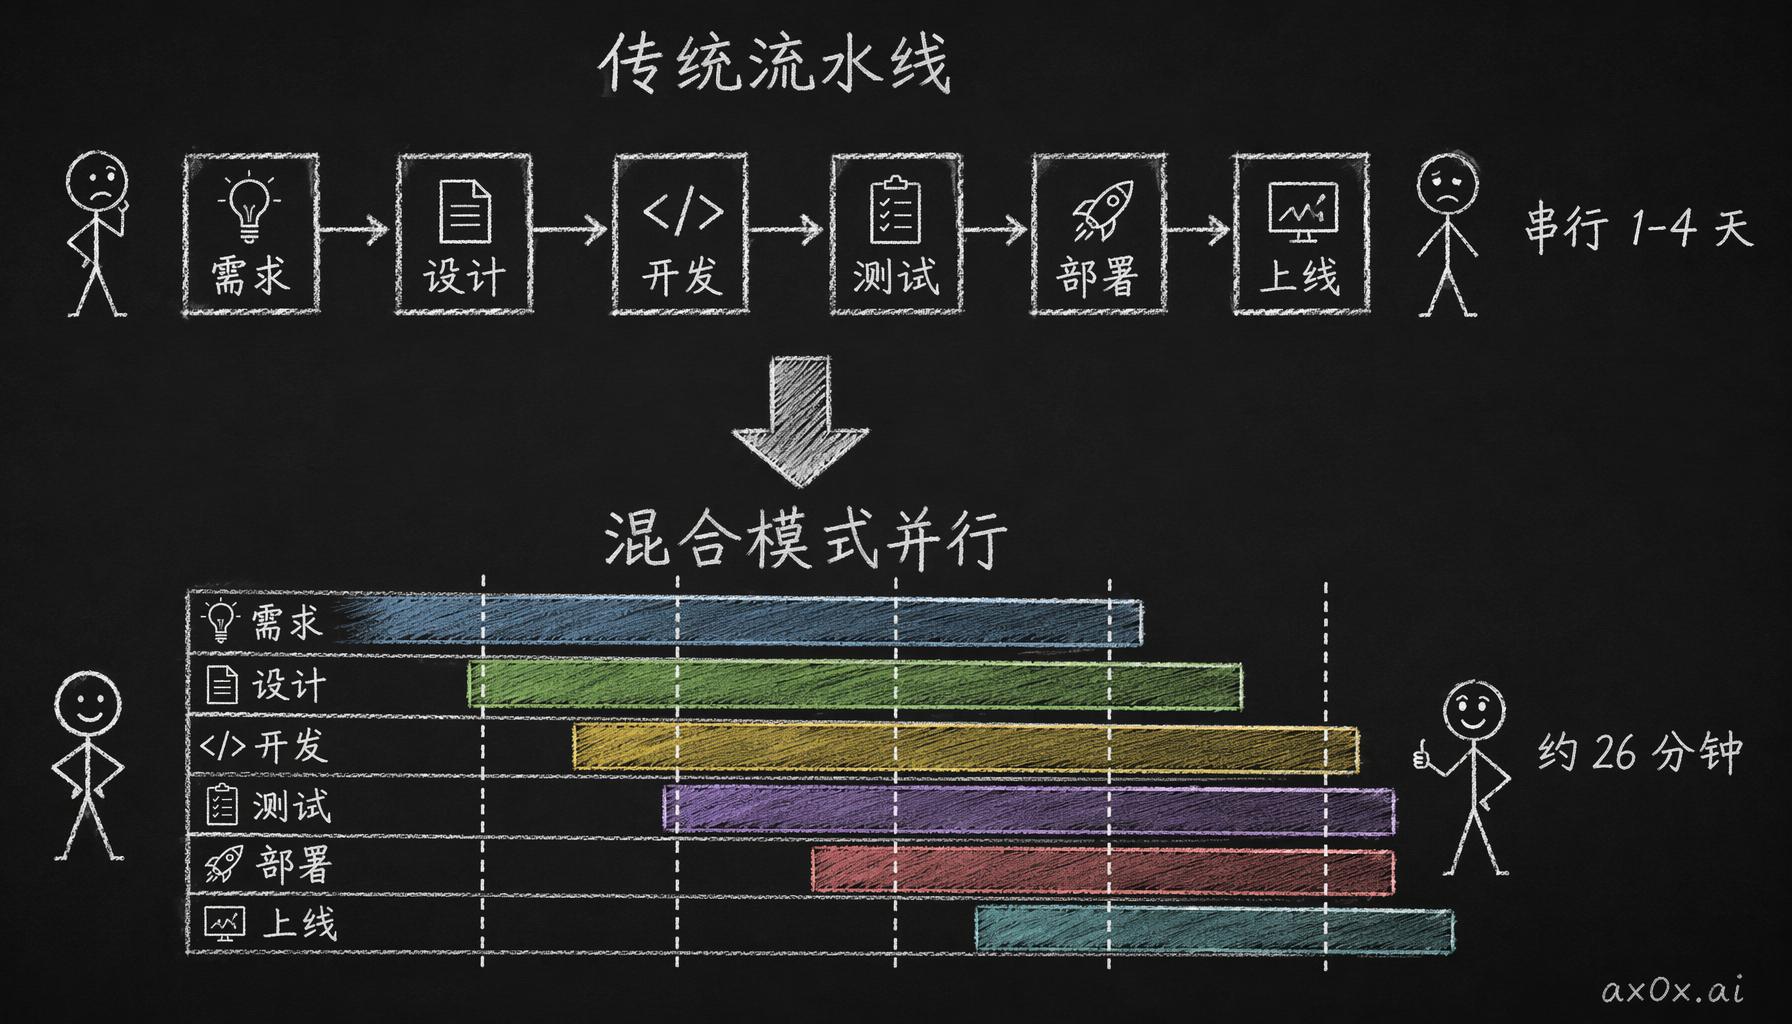 传统串行流水线(1-4 天)压缩成上下重叠的并行流(约 26 分钟)。
发布
审查团队 approve 以后,提交,推送:
git push origin main --tags
gh release create v0.0.3 --title "v0.0.3: Multimodal Input, Enhanced Onboarding, Selfie Generation"
从写第一行代码到发 github release,都在一个 session 里。这次的产品视角我单独写了一篇,这篇就只讲工作流。
最后说说什么活用什么模式。直接模式的反馈来得最快,我说哪里不对,马上就能看到它改,像昵称限制那种两分钟一轮的迭代,也只有它做得到。但是它一直占着我的注意力,整个过程我都得看着。文档这种不用盯的活就走后台模式,任务起了就可以不管,做完它自己会来汇报,中途没法给反馈也无所谓。审查这种要反复迭代的适合团队模式,给个目标它自己收敛就行,但是快速小改用它就太重了。
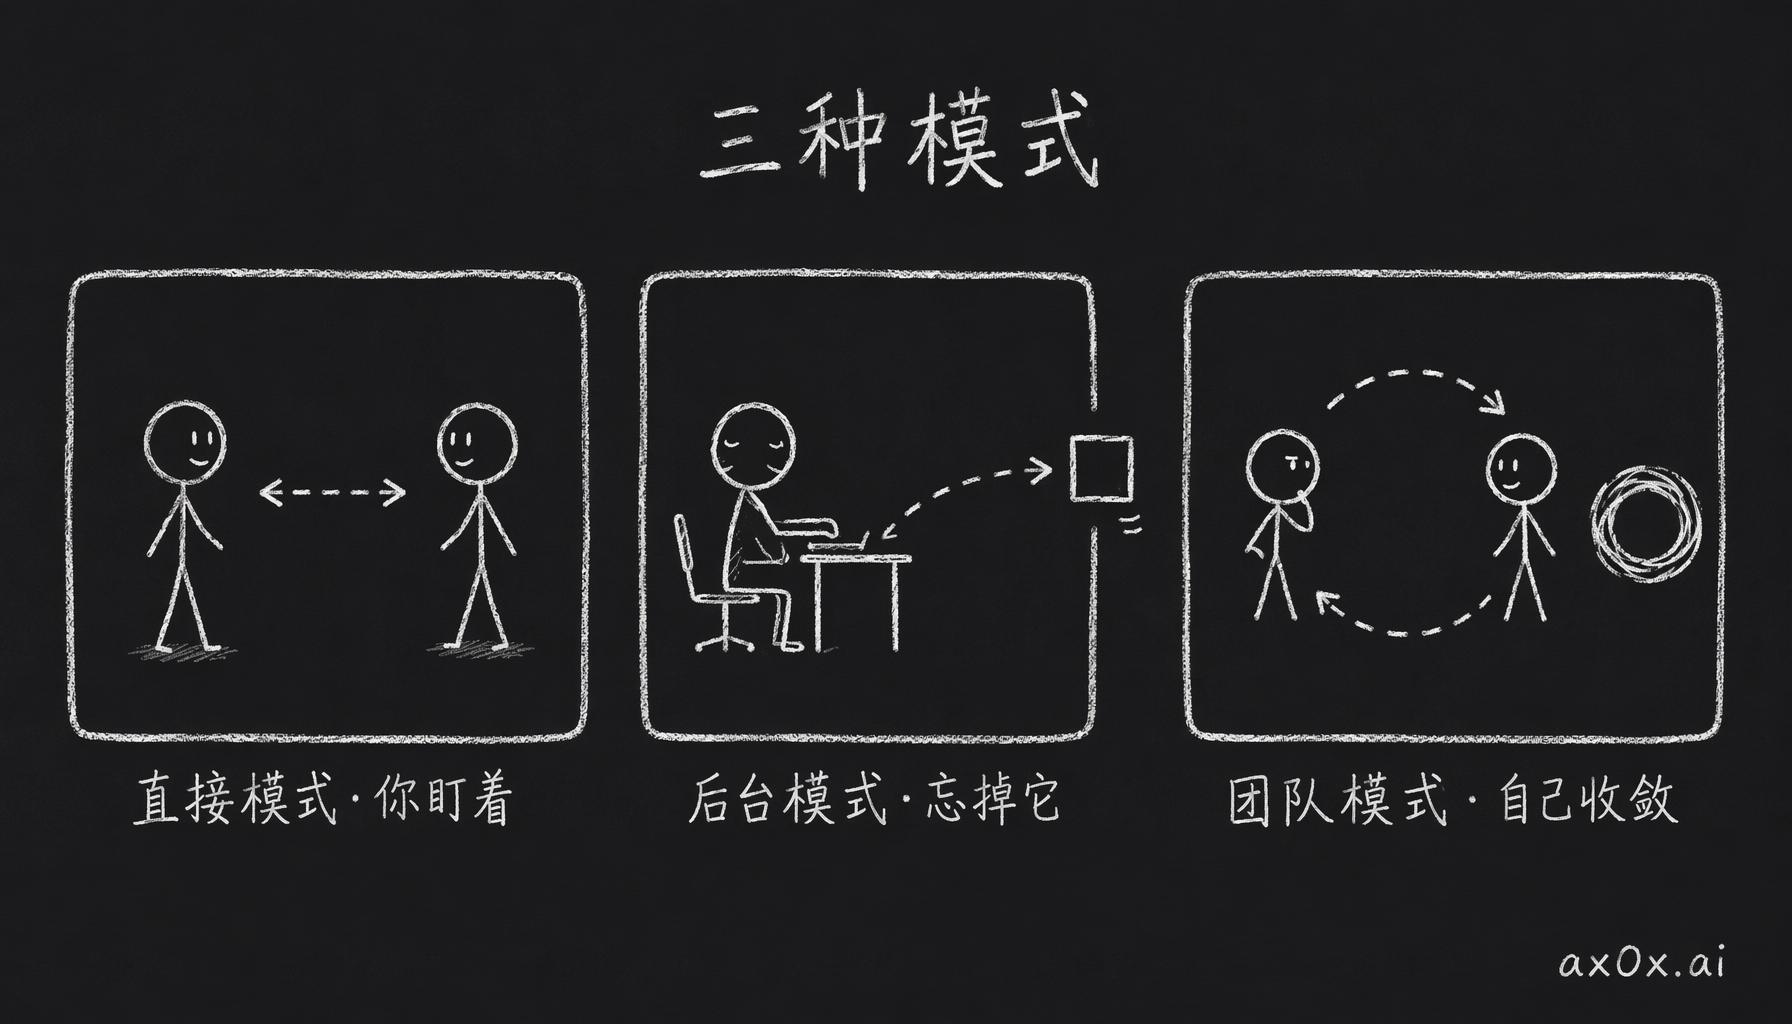 三种协作模式的对比:直接结对反馈最紧但要盯着、后台委派可以忘掉它、团队循环给个目标自己收敛。
反正没有哪个模式什么场景都能管,好用的是在同一个 session 里随手切,有时候两三种一起跑。第四篇讲 agent team 的时候演示过几个 agent 并行干活,这篇又往前走了一步,结对、后台委派、自治循环,三种同时在跑。
跑下来我的感觉是,机械的活全交给 agent 以后,我基本只管拿主意,不碰执行了,比如做什么,限制设多少合适,什么时候发布。现在慢的反而是我拿主意这一步,不是执行。