29 天把 5 个散装 app 合成一个平台
第 1 篇讲了为什么零领域知识也敢做算命平台,这篇讲具体是怎么做的,不挑好看的讲。会讲真实的架构决策、最难啃的 bug,还有每天能提 39 个 commit 靠的是哪些基础设施。
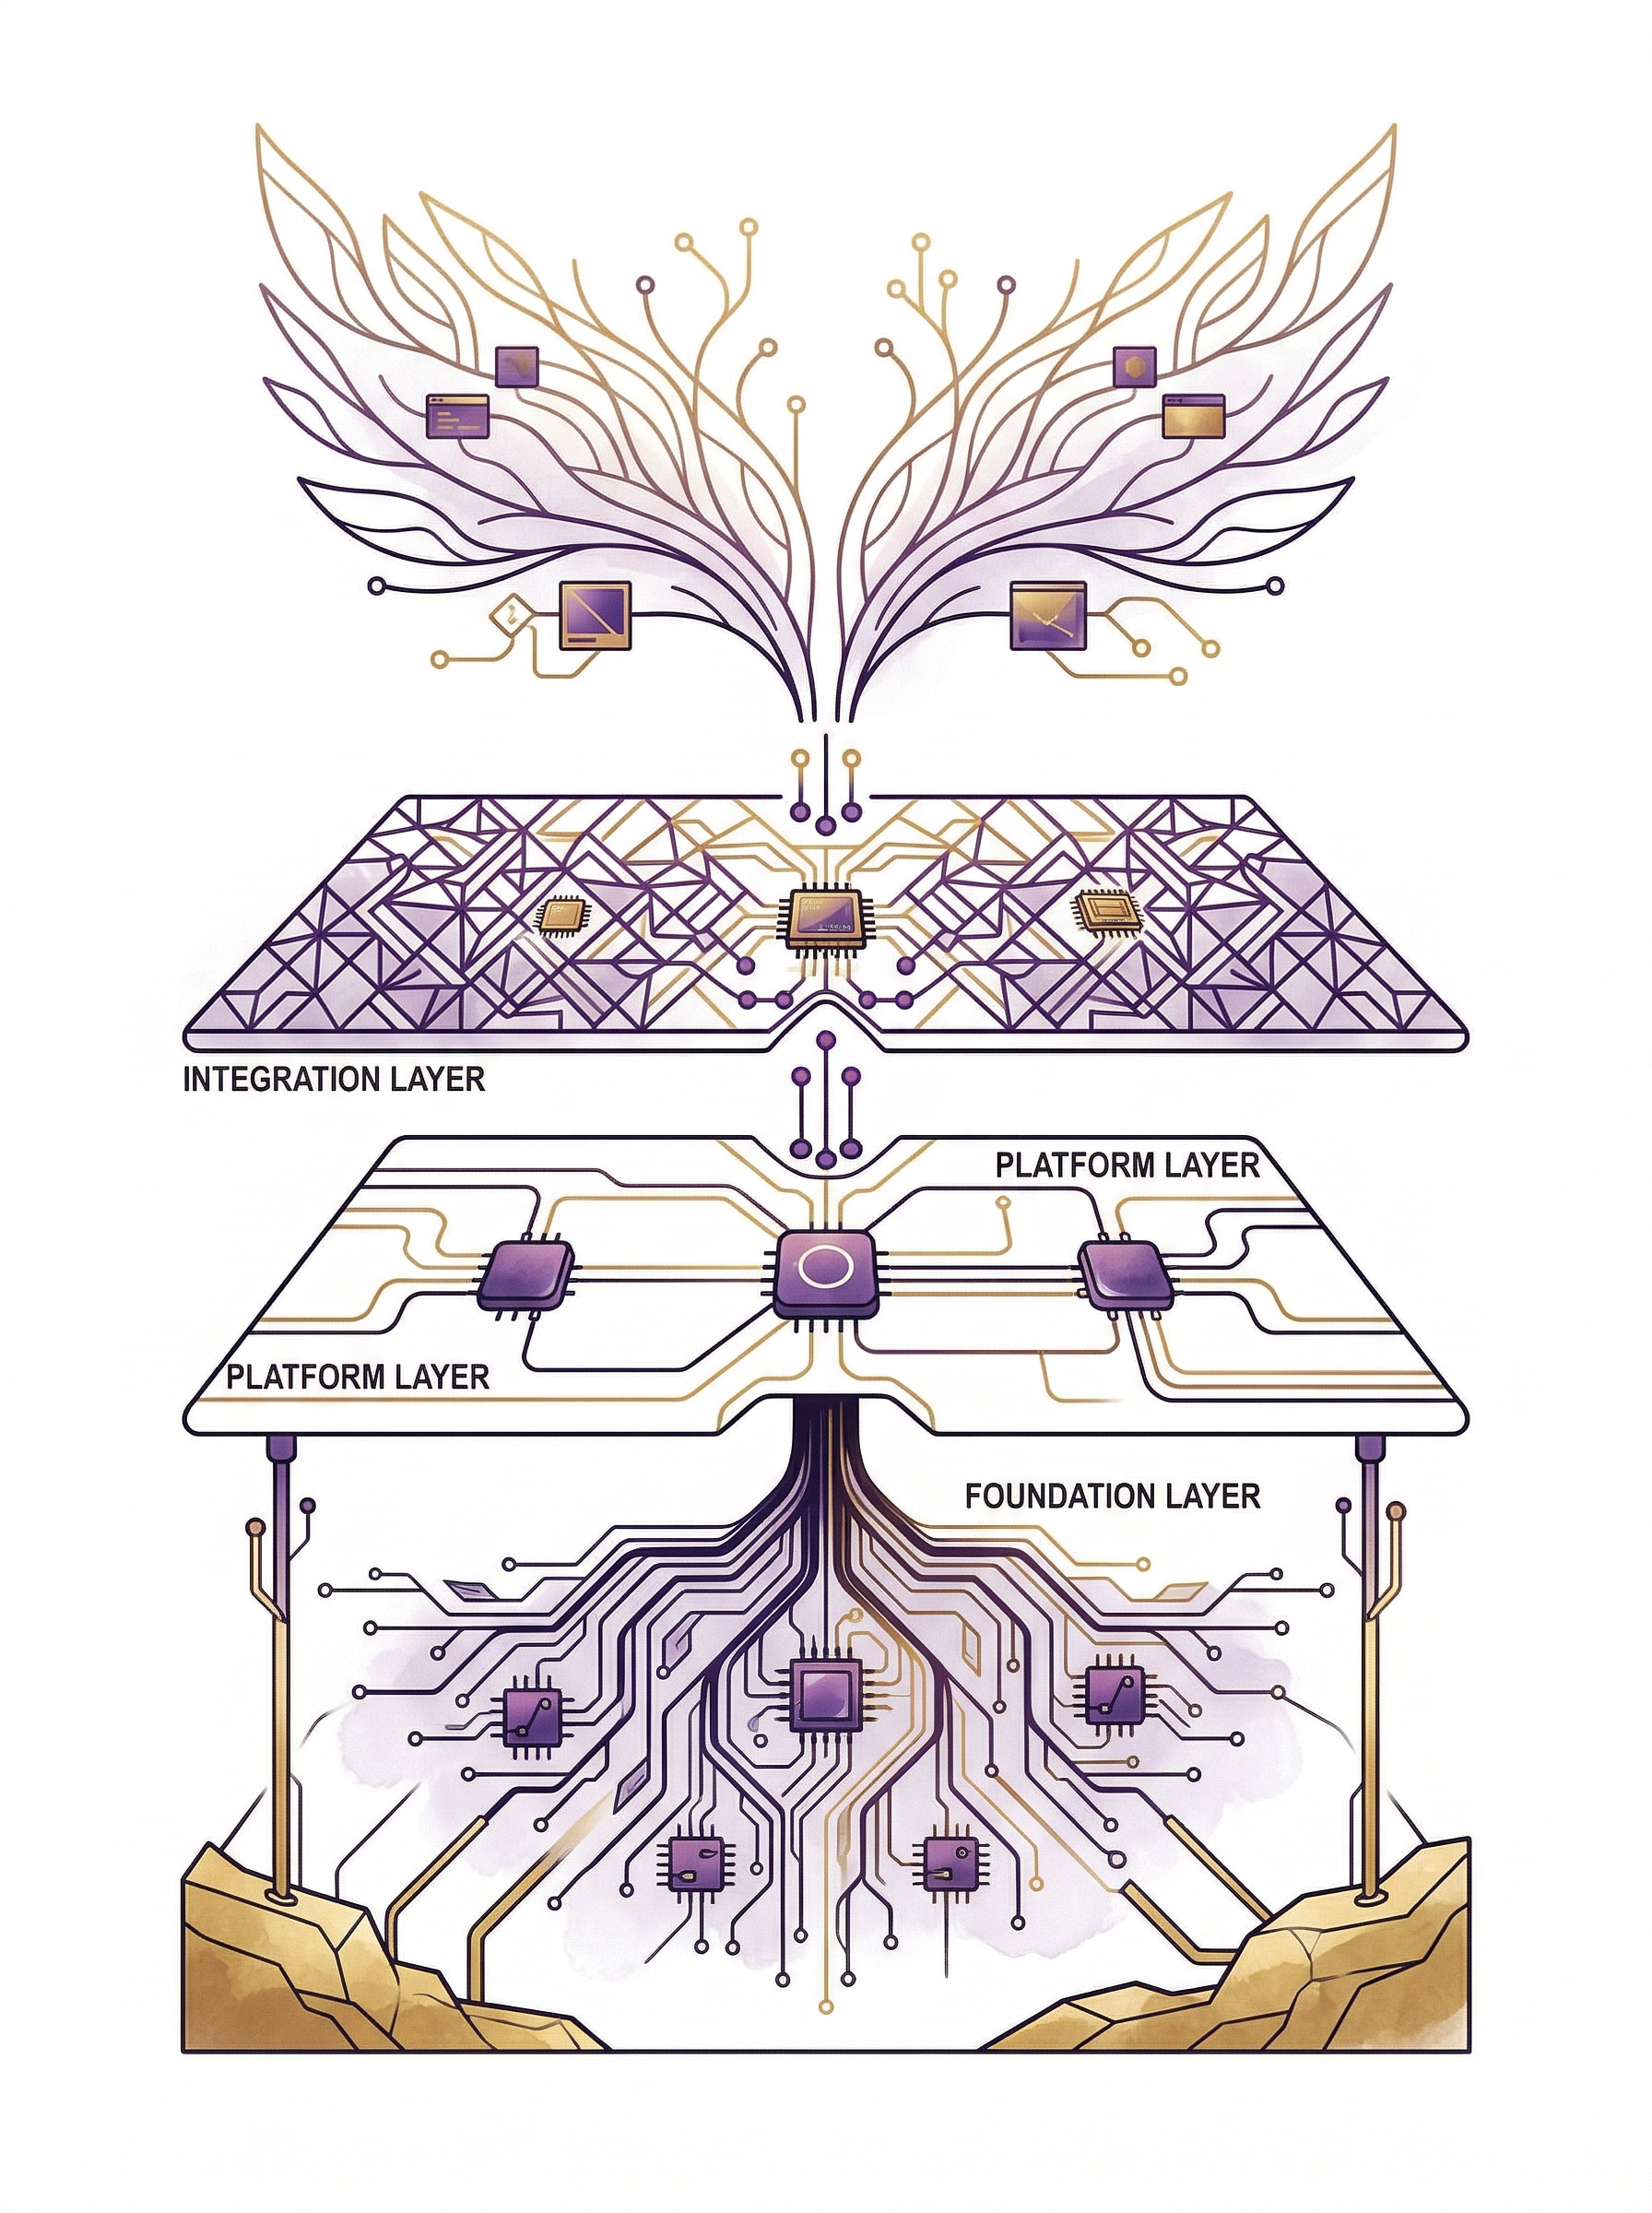 猫咪建筑师将五个分散的小楼合并成一座统一平台
先说起点。刚开始手上是 5 个完全独立的 Next.js 应用,放在 5 个 repo 里,分别是八字、星座、塔罗、解梦、占卜。每个应用有自己的认证、自己的 Supabase client、自己的 Tailwind 配置,用户想全用一遍,得登录五次。这只能说是五个散装 app 摆在一起,算不上平台。
头四天,先把 5 个 repo 合成一个
第 1 天搭 Turborepo,提了 21 个 commit。道理上很简单,应用搬进 apps/,共享代码提到 packages/,但一动手,每条 import 路径都炸了。那天 80% 的时间就干两件事,修 import,再跑构建看能不能过。
第 2 天撞上 CSS。Tailwind 配置统一到 packages/config 以后,凡是用了自定义 design token 的应用全崩了。而且不是那种冒红字的报错,是「这个按钮怎么小了 2px」那种,没有报错可看,只能一个个拿眼睛对。那天 38 个 commit,基本每个都在修视觉回归。
但第 2 天也有真东西出来,提出了四个共享 package,分别管 PDF 生成、聊天记录、共享聊天 UI 和通用 React hooks。看着 5 个应用里重复的代码收成一份,真的很爽。
第 3 天加了 MBTI 性格测试,这是第 6 个应用。顺手做了微信浏览器检测,因为中国互联网很大一部分流量走的是微信内置浏览器,不处理不行。UA 嗅探还得做得更稳,因为微信的 UA 在 Android、iOS 和桌面端长得都不一样。
第 4 天是大头,56 个 commit,把统一的 API package 做出来了。packages/api 把所有应用跟 AI 模型打交道的方式统一成一套写法,认证检查、扣积分、选模型、SSE 流式输出和错误处理都在里面。52 条 API 路由全部迁了过去。迁移是 claude code 干的,我给它看了一个示例,剩下的它自己迁完,实际花了大概一小时,手动做至少要一整天。
第 4 天还顺手搞定了 GDPR 合规和中英双语的法律页面,又用 DFA 写了第一版敏感词过滤器。过滤器是刚需,因为玄学内容里天生就有一堆词会被简单的关键词过滤拦下来,比如算命、破财、桃花劫,所以得有一套靠谱的白名单方案。
测试和品牌
整个 monorepo 的测试都用 Vitest。先测什么后测什么,我想得比较清楚,分三层:
- 先测共享 package,比如 API 流式输出的 helper、Supabase client、积分管理。所有应用都压在这些东西上面,它一出问题,全家一起出问题。
- 再测领域计算,包括八字计算、塔罗抽牌、六壬占卜。我零领域知识,没法判断算得对不对,那就退一步,只测结果稳不稳,同样的输入永远给出同样的输出。
- 最后测 API 路由,mock 认证 token 做集成测试。
CI 用的是 GitHub Actions,每个 PR 都跑 lint、类型检查、构建和测试。等到正式开始冲里程碑的时候,测试已经有 34 个文件、1,922 个了。
品牌也是这时候定下来的,叫 PanPanMao(盼盼猫),一只会算命的猫。猫这个主题一定,后面的事就好办了,每个应用都配上猫的装饰,积分当货币用,改叫小鱼干。拿积分隔这一层挺关键,因为人愿意「花 5 条小鱼干」,却不太愿意看到具体花了多少美元。人民币套餐也提前配好了,还没开,等进中国市场再用。
几块难啃的
技术上最难的功能是手面相识别,PR #1 就是它,改了 56 个文件,新增 6,881 行。
思路是让 MediaPipe 全在浏览器里跑,检测这一步不用来回找服务端。代码拆成了几个 hook。useMediaPipeLoader 懒加载 WASM(大概 3MB),在模块级缓存;useFaceDetector 跑实时的 BlazeFace,摄像头预览 60fps;useFaceLandmarker 出 478 点的面部网格,拍照时跑一次;useHandLandmarker 出 21 点的手部关键点,也是拍照时跑一次。
后面还补了两个中国特供的修复。PR #50 把 WASM 和模型文件放到本地的 public/mediapipe/,因为中国用户访问 cdn.jsdelivr.net 和 storage.googleapis.com 不稳。PR #35 给掌纹检测加了降级,碰到 WebGL 起不来的设备,就从 GPU 退到 CPU 上跑。
多模态的 prompt 也不能偷懒,你不能跟模型说一句「看看手」就完了。prompt 分四层:角色定义 → 知识注入(五官、三停、十二宫)→ 交叉验证 → 结构化输出格式。
积分经济这边最头疼的是匿名用户转正。PR #2(M1 Foundation)动了 100 个文件。新用户一进来就是 Supabase 的匿名账户,等他用兑换码或者登录时,积分、算命记录、聊天历史都得无缝并到正式账户上。兑换流程做成了一个状态机:idle → checking → redeeming/logging_in → success/error。
不同标签页之间的积分,靠 Supabase 实时订阅来同步。这里有个很隐蔽的 bug,用户在一个标签页买了积分,切到另一个标签页,那边还挂着旧余额。用户以为没买成,又买一次,钱就扣了两遍。修法就是靠实时订阅,一秒内把所有标签页都同步过来。
然后是把 18 条流式路由统一起来。到这时候已经有 18 条 SSE 流式路由了,每条都自己实现了一遍 ReadableStream。PR #16 做了一次大重构,把其中 15 条迁到共享的 createAIStreamResponse() helper 上,删掉大概 1,200 行重复的样板代码,还顺手加了几个生命周期钩子,initEvents、onComplete、onError、refundCreditsOnError。剩下三条确实得自己处理。MBTI 聊天要用 accumulated-buffer-delta 模式把信号剥掉,梦境小说是多步骤的生成协议,每日运势不走流式,还带服务端缓存。
全场最难做对的是 AI 的语气。PR #38 是因为真实用户的反馈才做的,问题是解读太讨好了,什么都往好了说,事业说必成,健康说没问题,感情也总有希望。真的算命先生不这么说话。修法是把全部 6 个领域的 prompt 从头到尾改一遍。整体语气从「偏积极正面」改成「好说好,不好明确指出」;健康解读从「混合分析」改成「中立偏负面,直接给健康警示」;碰到负面的指标就直接说凶、不利,后面再给化解方案。这是少数 AI 没法自己做完的改动,因为语气调到什么分寸,得靠人判断在这个文化里大家期待听到什么,这个判断模型自己给不出来。
里程碑冲刺
2 月 12 日一天合了 15 个 PR,M1(积分经济)、M2(每日枢纽)、M3(PostHog 数据分析)同一天上线。
每日枢纽(PR #4)是为了留存做的。算命天生是有事才来,用户带着问题来,拿到答案就走了,枢纽要给他一个每天回来的理由。这里想清楚了一件事,内容要在北京时间午夜用 cron 提前生成好,不要等用户来了再生成。这样用户早上一打开,页面马上就出来,不用对着转圈等 3 秒。真让用户干等这 3 秒,他就不信这个产品了。
接下来加了流年运程(PR #85),这是个全新的领域,里面有生肖计算器、太岁分析、流年飞星和 AI 运势解读,一共 48 个文件,162 个领域测试。
Portal 主题那个 bug 挺有意思,展开讲讲。每个应用有自己的 CSS 主题(.theme-hub、.theme-tarot 这种),但 React portal 是用 createPortal(content, document.body) 渲染的,DOM 节点直接挂到 body 上,跑到了应用的主题 wrapper 外面,portal 里的内容就拿不到 CSS 变量。一开始的修法是检测 closest('.theme-hub'),再把 overlay 的类写死,但 9 个主题乘 13 个 portal 组件,这条路走不下去。PR #67 换了个办法,加一个 ThemeProvider context 声明当前用哪个主题类,再做一个 ThemedPortal 组件,用 MutationObserver 把对的主题类和暗色模式类包在 portal 内容外面。这么做就对了,后面再加多少主题都不用动。
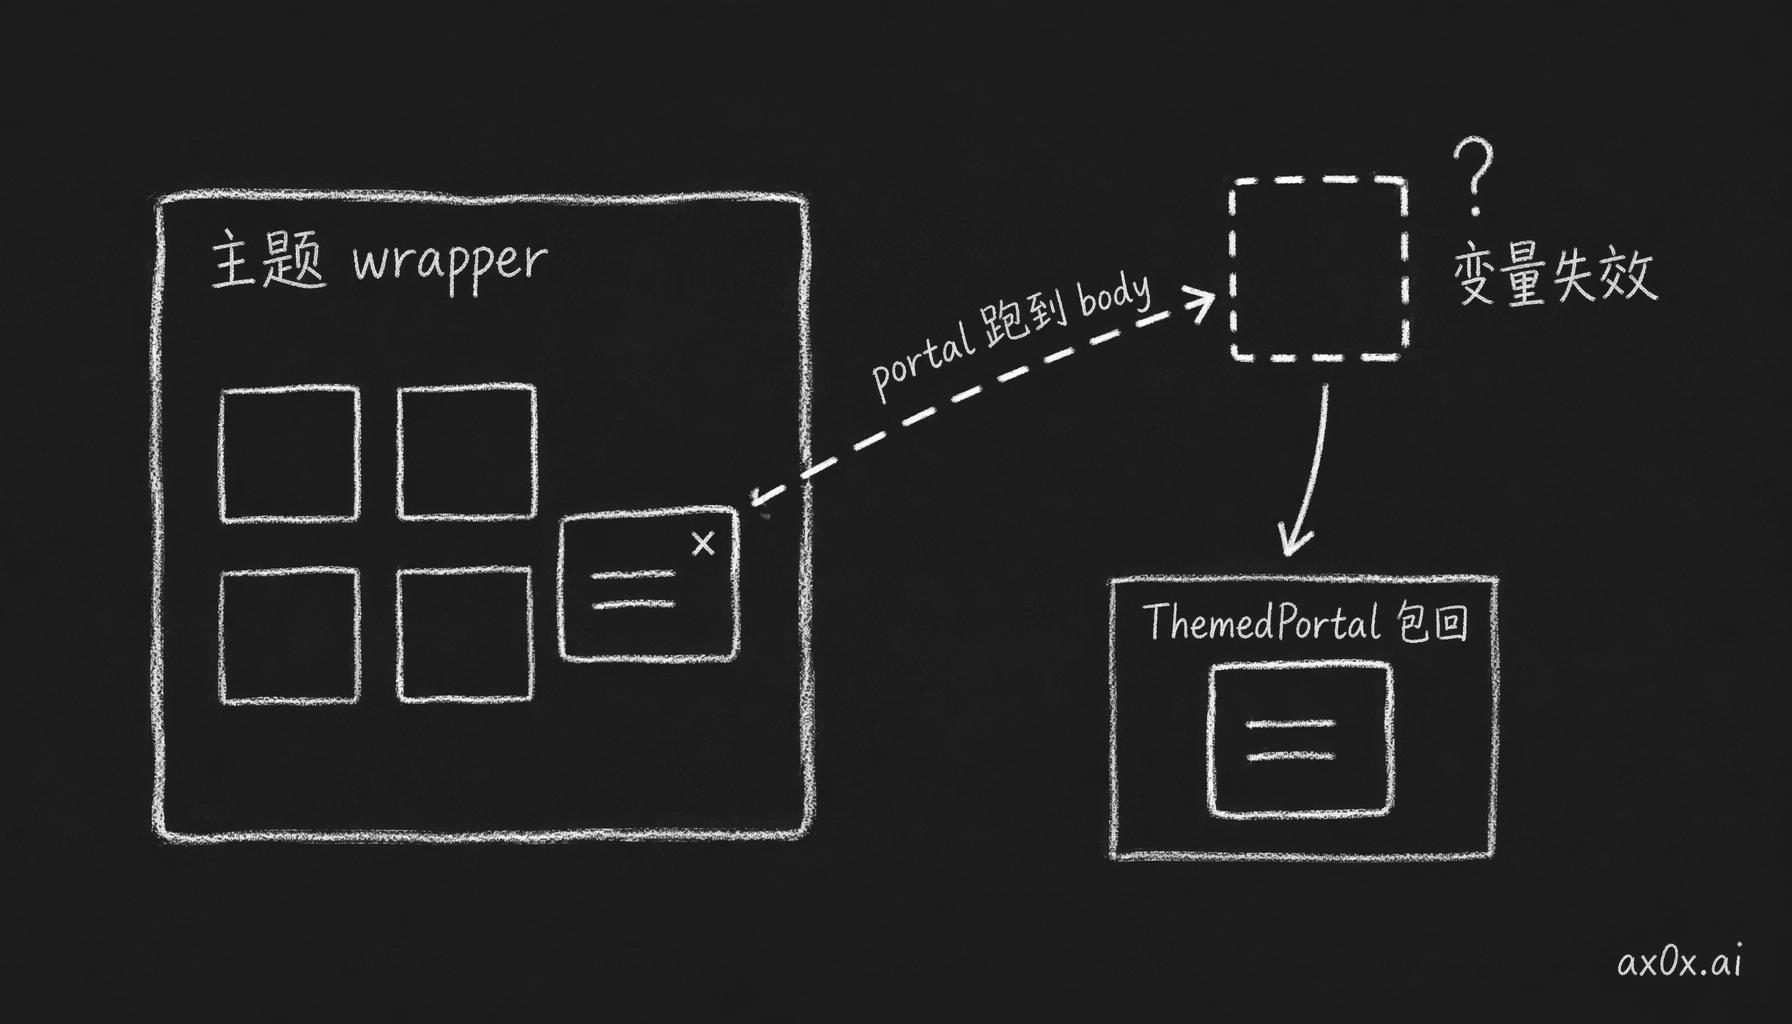 React portal 渲染到 body、跑出应用主题 wrapper,CSS 变量失效;用 ThemedPortal 把主题类包回 portal 内容来修
最后一个大的基础设施 PR 是弹性 AI 流式传输(#105),做的是服务端的流式缓冲。19 条 AI 流式路由一边往外发,一边用 StreamBufferManager 把数据块顺手存进数据库,客户端要是中途断了线,调 GET /api/stream/{id} 就能把完整的响应拿回来。同一个 PR 还把消费端统一了,14 个组件里原来有 3 种读 SSE 的写法,全换成一个 useAIStream hook。最后算下来,加了一整套弹性基础设施,代码反而净少了 186 行。
内容过滤器前后改了三版。V1 就是第 4 天那个 DFA 关键词过滤,碰到敏感消息整条拦掉。V2(PR #78)能在流式输出里过滤了,但一遇到敏感词就把整个流掐断,用户积分扣了,拿到的解读却是残的,这个体验不行。V3(PR #104)改成行内遮蔽,把敏感词换成 **检测到违禁词**,流不断。整体是两道过滤,输入这边用严的,广告、政治、色情、犯罪全拦;输出这边用松的,不拦「广告」这一类,不然算命的术语会被误杀。还有正好卡在两个 chunk 中间的词,遮蔽时也得处理好。
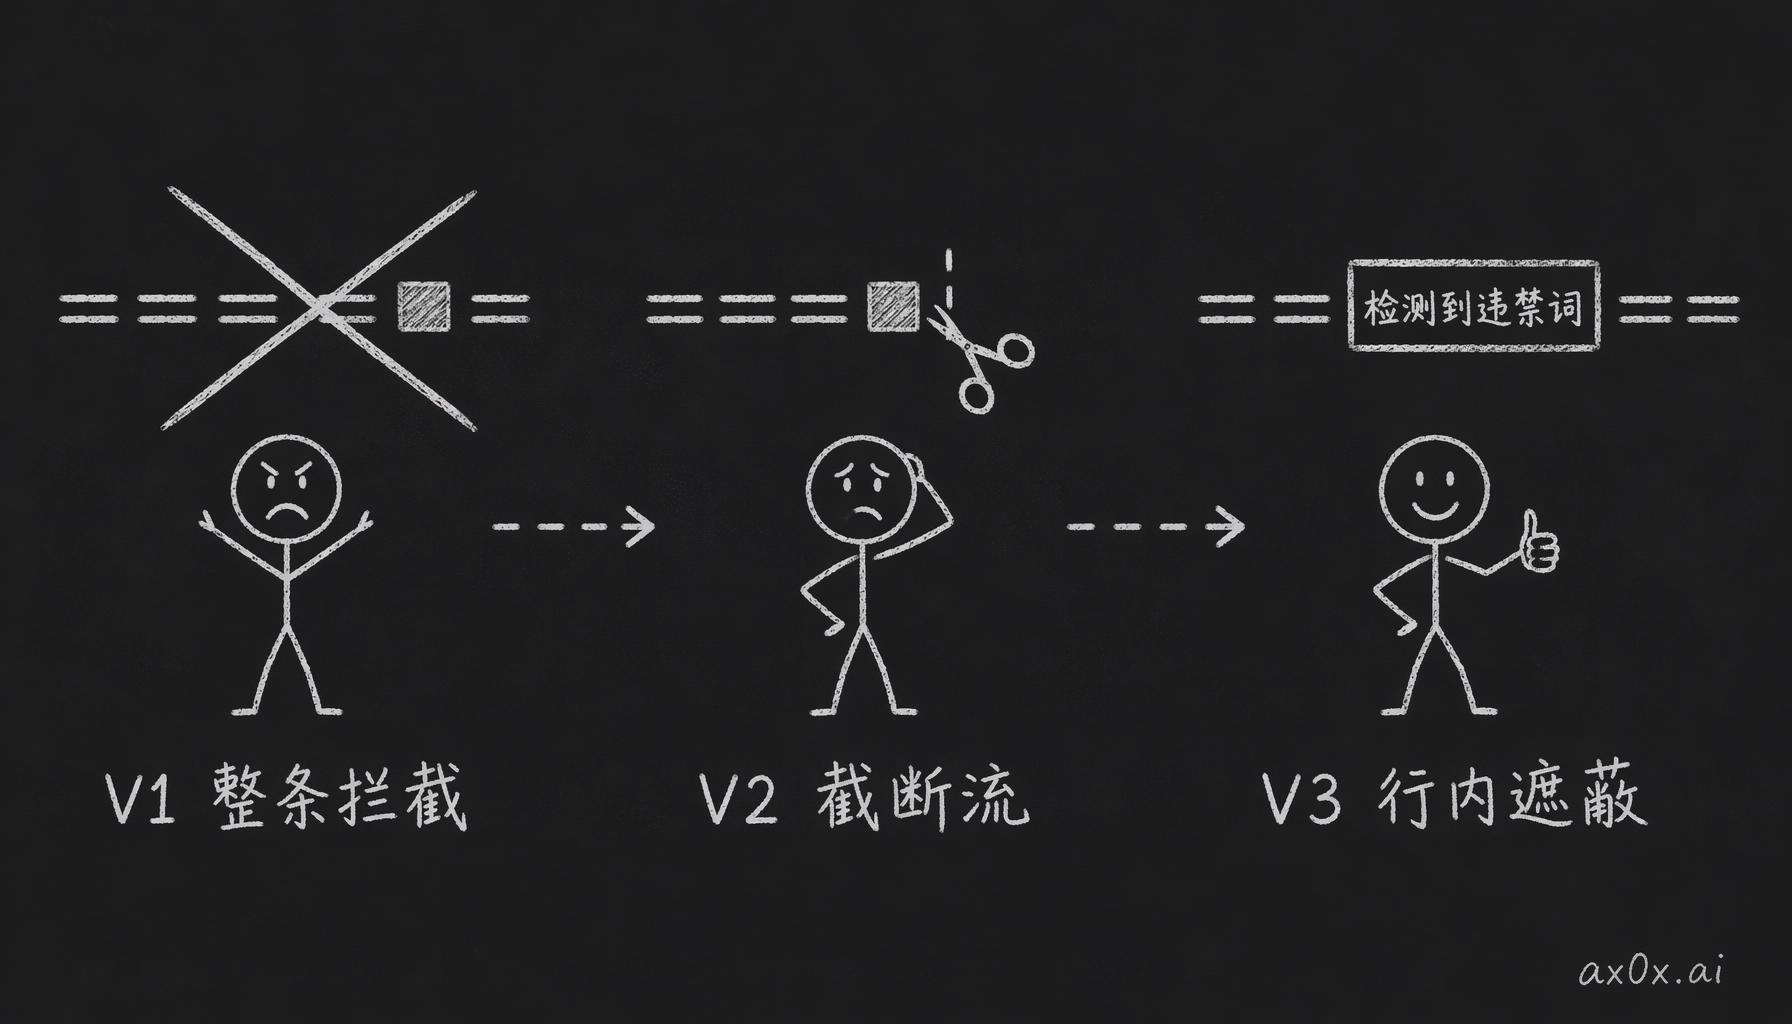 内容过滤器三版演进:V1 整条拦截、V2 遇敏感词截断整条流、V3 行内遮蔽不中断流
最后盘个数
29 天一共 1,134 个 commit,平均每天 39 个,最多的一天 98 个,没有哪天是零。109 个 PR,其中 66 个写了详细描述。9 个产品线,每个都有真的业务逻辑。85 个 API 端点,19 条 SSE 流式路由。代码大概 284,000 行,分在 16 个 package 里。最后一次数,通过的测试有 2,021 个。
这个速度能撑住,靠的就是前面那些共享 package。新加一个产品线,认证、积分、模型选择、内容过滤、流式传输、错误处理、UI 组件全是现成的,做新产品要多花的功夫几乎都落在 prompt engineering 上。
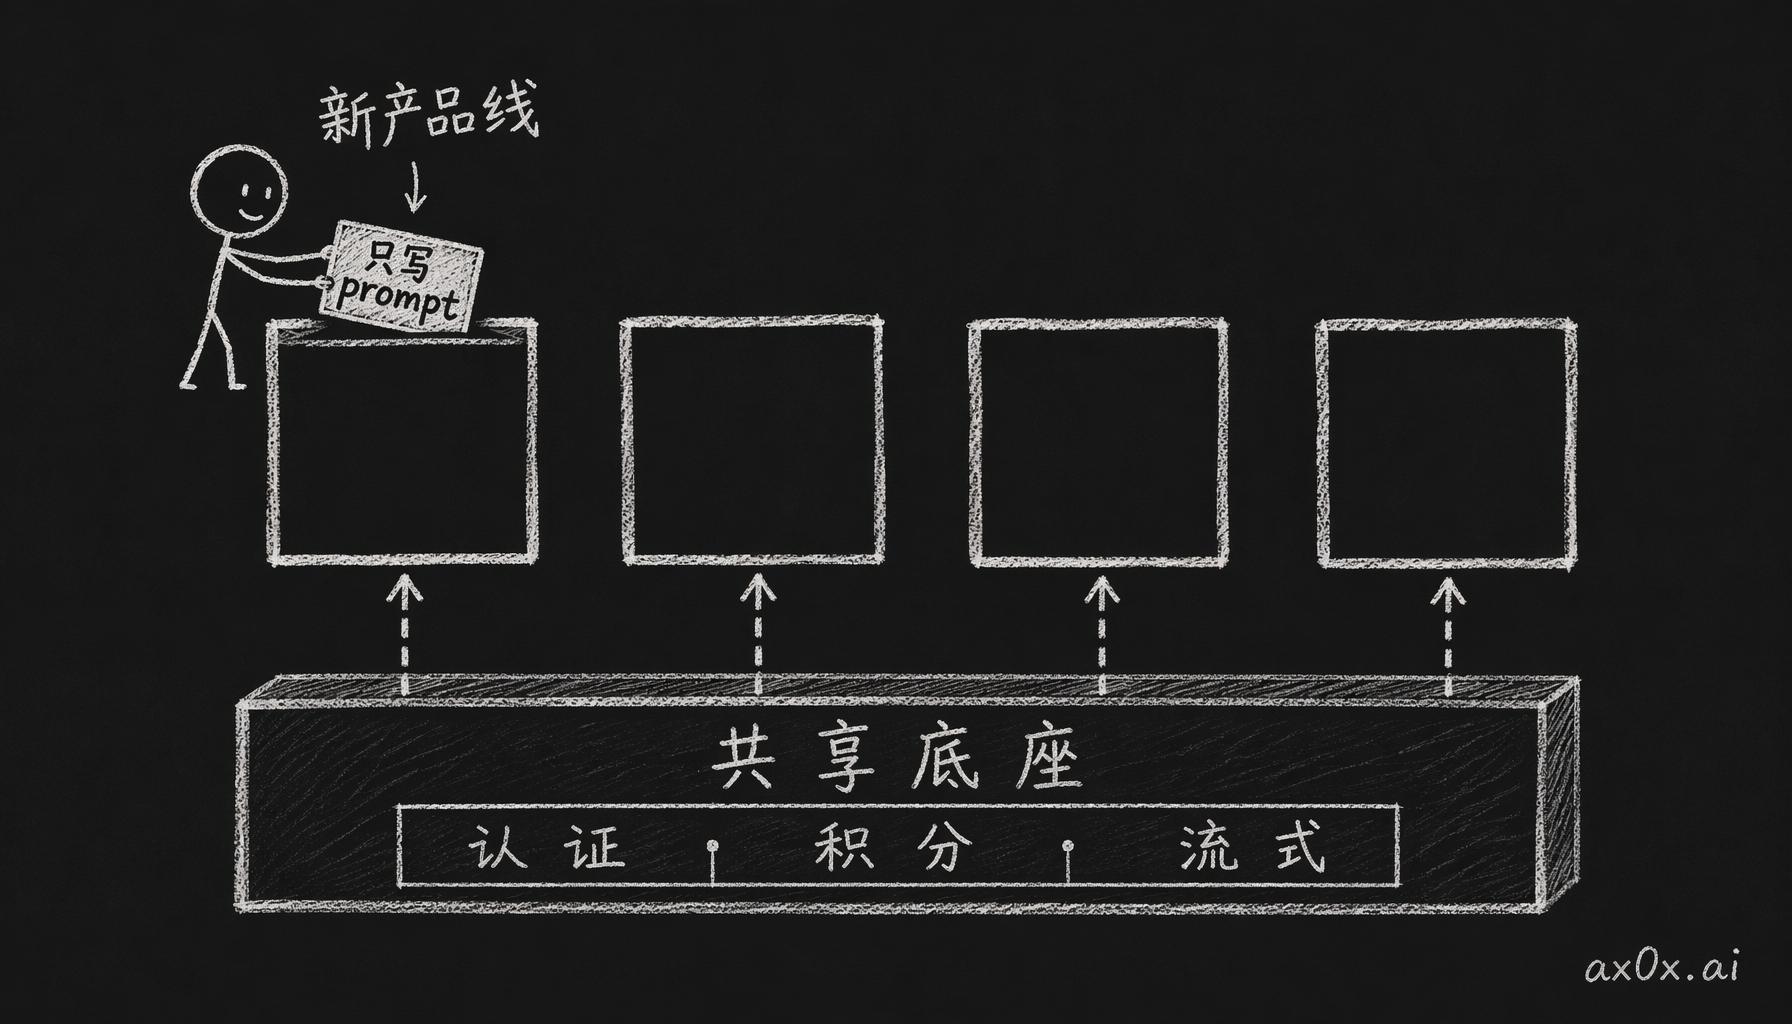 共享 package 做成底座后,新增一个产品线只需写 prompt,认证/积分/流式全是现成的,边际成本几乎归零
第 3 篇讲真实的教训,哪些事出乎意料,哪些事做错了,还有这一趟做下来,我对以后怎么做产品的想法变了哪些。