我造了个知识编译器,让 AI 自动帮我写 wiki
每天刷的文章、论文、技术博客挺多的。读的时候觉得这个洞察真好,三天以后就只剩个大概了,再过一个月,基本整个都想不起来。我以前的工作流是读完就收藏,结果收藏夹里堆了 500 篇,一篇都没再打开过。讲道理,收藏这个动作基本等于扔了,只是心理上好受一点。
Karpathy 说过一个做法,我觉得很对。自己维护一个 wiki,把读到的东西全喂进去,让条目互相引用,一直往上垒。这种 wiki 越喂越聪明,因为它会滚复利。每加一篇新文章,不光是多了一个条目,还会顺手更新五个已有的页面、加两条新的交叉链接,一些你之前没注意到的关联就这么连上了。
问题是手动维护这个东西真的太累了。读完要总结,要找相关的 wiki 页面,要手动加引用,还要更新索引,一套下来比读原文还花时间。所以我写了 Cortex。我脑子里是这么对应的,obsidian 负责浏览和阅读,相当于 IDE;LLM 干编译器的活,读源材料、写 wiki;编译出来的 wiki 一直在长、在重构、在攒复利,它就是那个代码库。
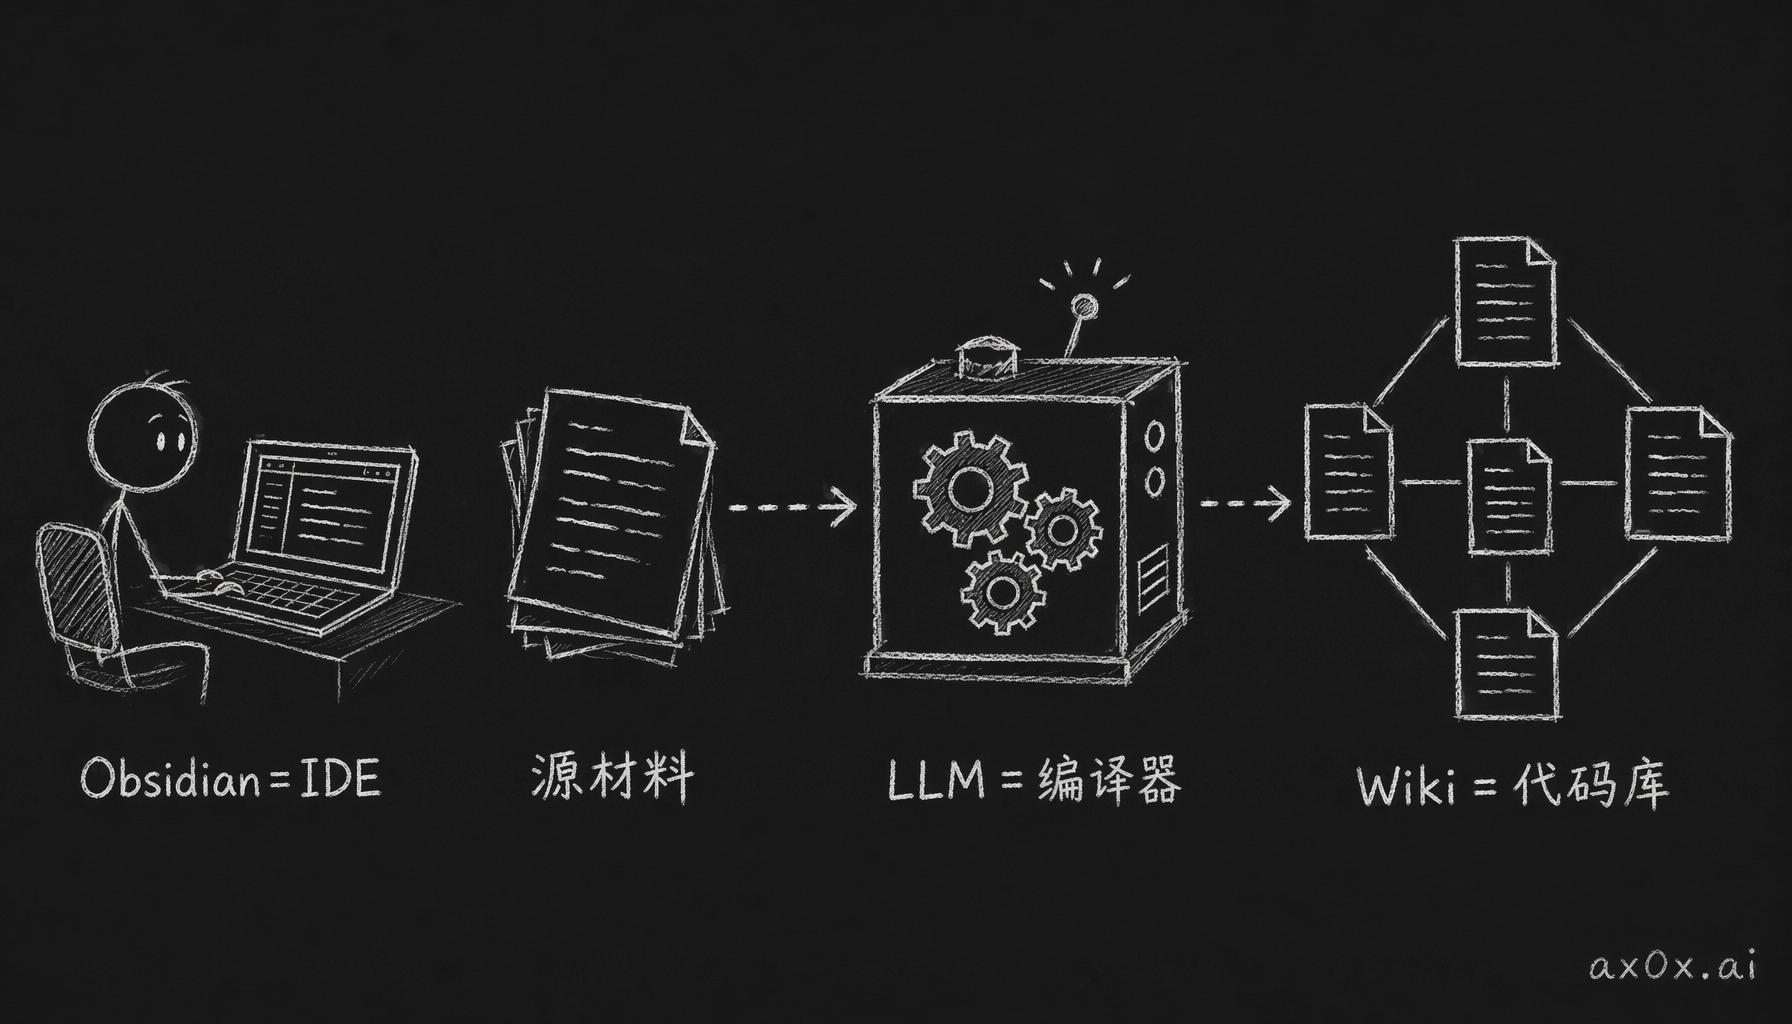 把知识管理映射成编译流程:Obsidian 当 IDE、LLM 当编译器、Wiki 当代码库
Cortex 里面其实没有任何 LLM 代码,没有 api key,prompt chain、embedding 这些也都没有。它就是一个 MCP 服务器,提供 5 个文件读写工具,claude code 通过这 5 个工具去读源材料、写 wiki。编译的逻辑写在一个 markdown 文件里。这个文件教 AI 怎么组织知识,什么时候该新建条目,什么时候更新旧条目,来源怎么引用,什么样的概念该单独开一页。想换个编译方式,改这个 markdown 文件就行,不用改代码,也不用重新部署。感觉做这个东西更像是在配置 AI 怎么干活,真正写代码的部分反而最少。
具体用起来是这样。往 obsidian vault 的 inbox/ 里丢链接或者文件,下次打开 claude code,hook 会自动提醒你:"[Cortex] inbox/ 里有 3 个文件等着处理。"然后 claude code 自动跑三步:
- Ingest:读源文件(URL 通过 Jina Reader 转成 markdown),生成元数据,存进
sources/ - Compile:读源文件,决定创建还是更新哪些 wiki 文章,加上
[[wikilinks]]和来源引用 - Index:更新总索引,记录操作日志
这些在 obsidian 里都能实时看到。新文章冒出来,交叉引用跟着刷新,你就看着这个 wiki 一点点变大。
整个项目我故意做得很小,一共就 15 个源文件,5 个依赖,连数据库都没有,这些都是想好了才这么做的。不用数据库,是因为真的用不上。manifest 就是一个 JSON 文件,索引是 markdown,日志是只往后追加的 markdown。所有状态人都能直接读,也能直接放进 git,版本控制、备份、迁移就全白送了。
搜索我也没自己做,交给了 qmd。这是 Shopify 创始人 Tobi Lutke 写的一个 MCP 服务器,专门搜 markdown。Cortex 负责写,qmd 负责读,两个 MCP 服务器各干一件事。编译流水线我也直接省了,DAG、任务队列、build system 一个都没用。LLM 读 schema,调那 5 个工具,所谓的流水线其实就是 agent 自己在推理。这么做还有个好处,模型一升级,文章质量就跟着升级,代码一行都不用动。
服务器本身只暴露五个工具,全是文件操作。这五个工具怎么用,靠 schema 和那个 markdown 文件来教。
| 工具 | 做什么 |
|---|---|
cortex_ingest | 读 URL 或文件,提取内容,存为 source |
cortex_write | 创建或更新 Wiki 文章,自动更新索引 |
cortex_diff | 显示 inbox 里有什么、哪些还没编译 |
cortex_log | 往操作日志里追加记录 |
cortex_status | 返回 vault 统计(source 数、文章数、最后活跃时间) |
架构上我最满意的一个决定,是 source 不可变,wiki 可变。source 一旦写进去就再也不改,这样我读过什么,永远留着一份原始记录。wiki 文章则一直在更新,会加上新的交叉引用,相关的 source 多了,总结也越写越完整,过时的结论也会被改掉。这样证据和推理就分开了。wiki 里每句话都能追到某个 source 上;如果某个 source 有问题,就去改引用它的那些 wiki 文章,source 本身不动。
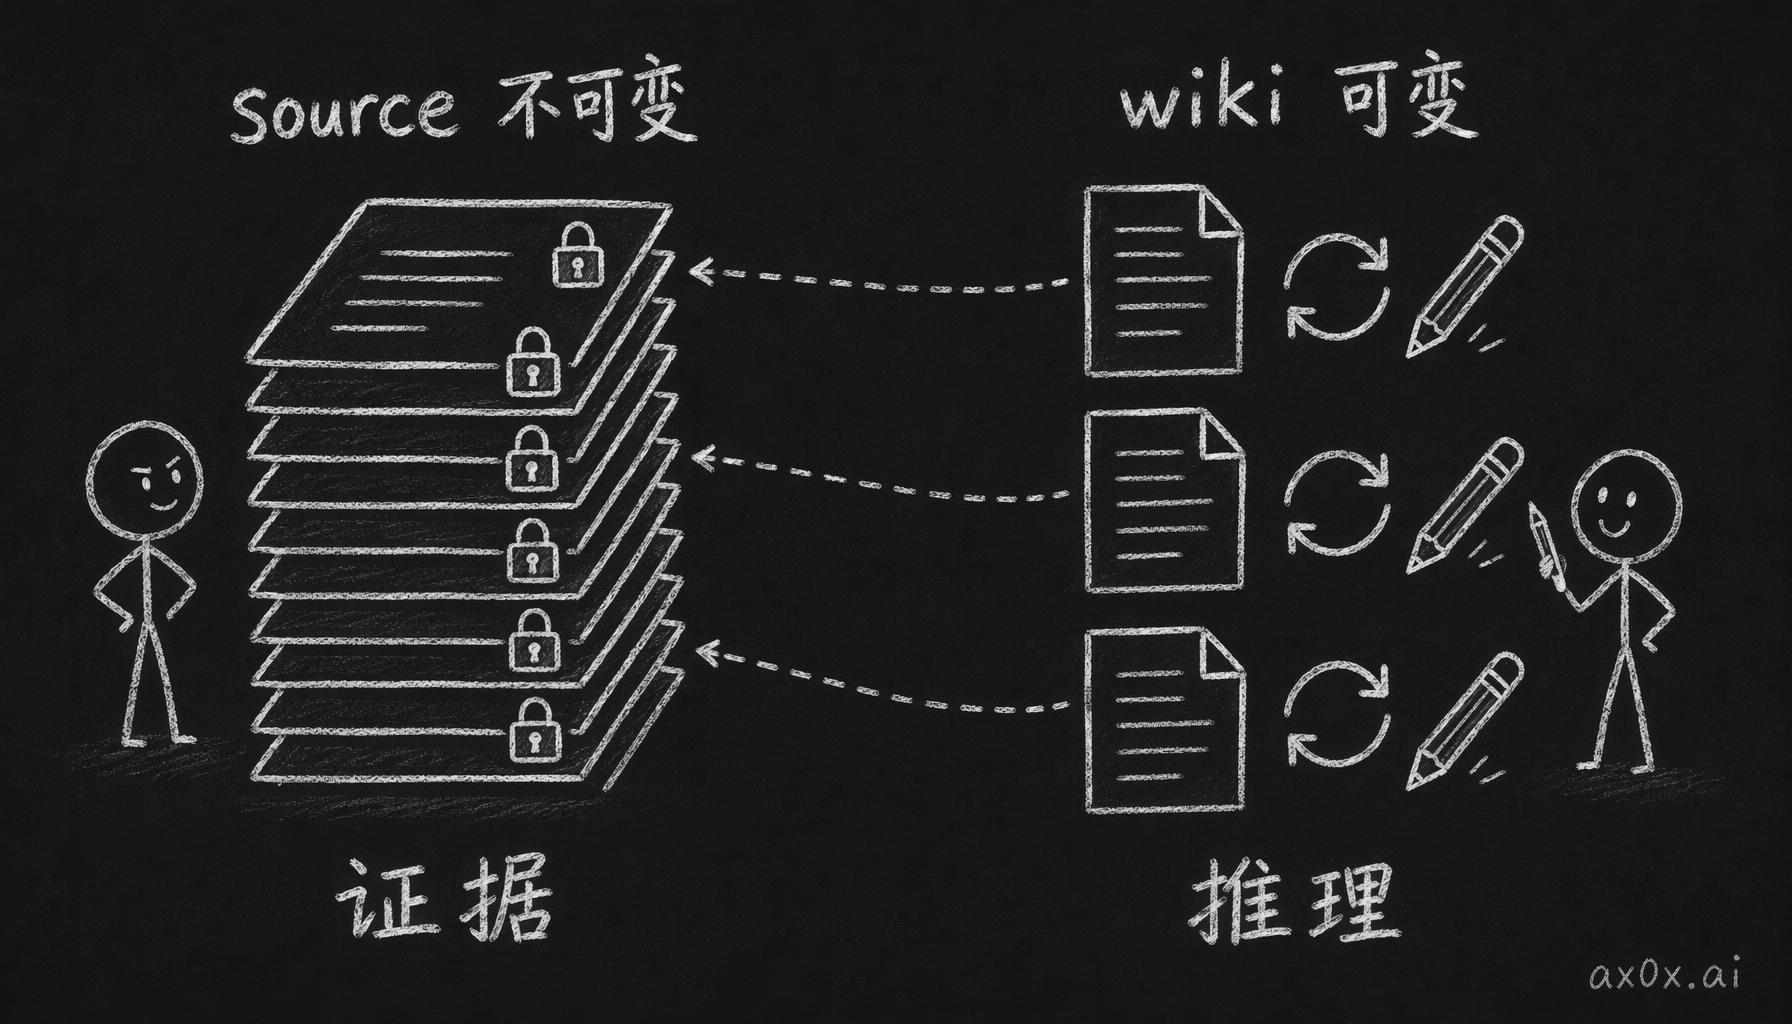 source 只读不改是证据,wiki 一直更新是推理,wiki 每句话都能虚线回溯到某个 source
用了一段时间,最让我惊喜的是喂到 50 篇 source 以后,一些我没让它写的文章开始自己冒出来了。AI 发现有些主题横跨好几个 source,就自己写 synthesis 文章,把散在不同来源里的相关洞察串到一起。这已经不是「一篇 source 对应一篇 wiki」那种机械的对应了。复利大概就是这么来的。每篇新 source 都能跟已有的全部知识连上,攒得越多,新喂进去的一条能连上的点就越多,价值差不多是按指数往上走的,反正不是线性的。
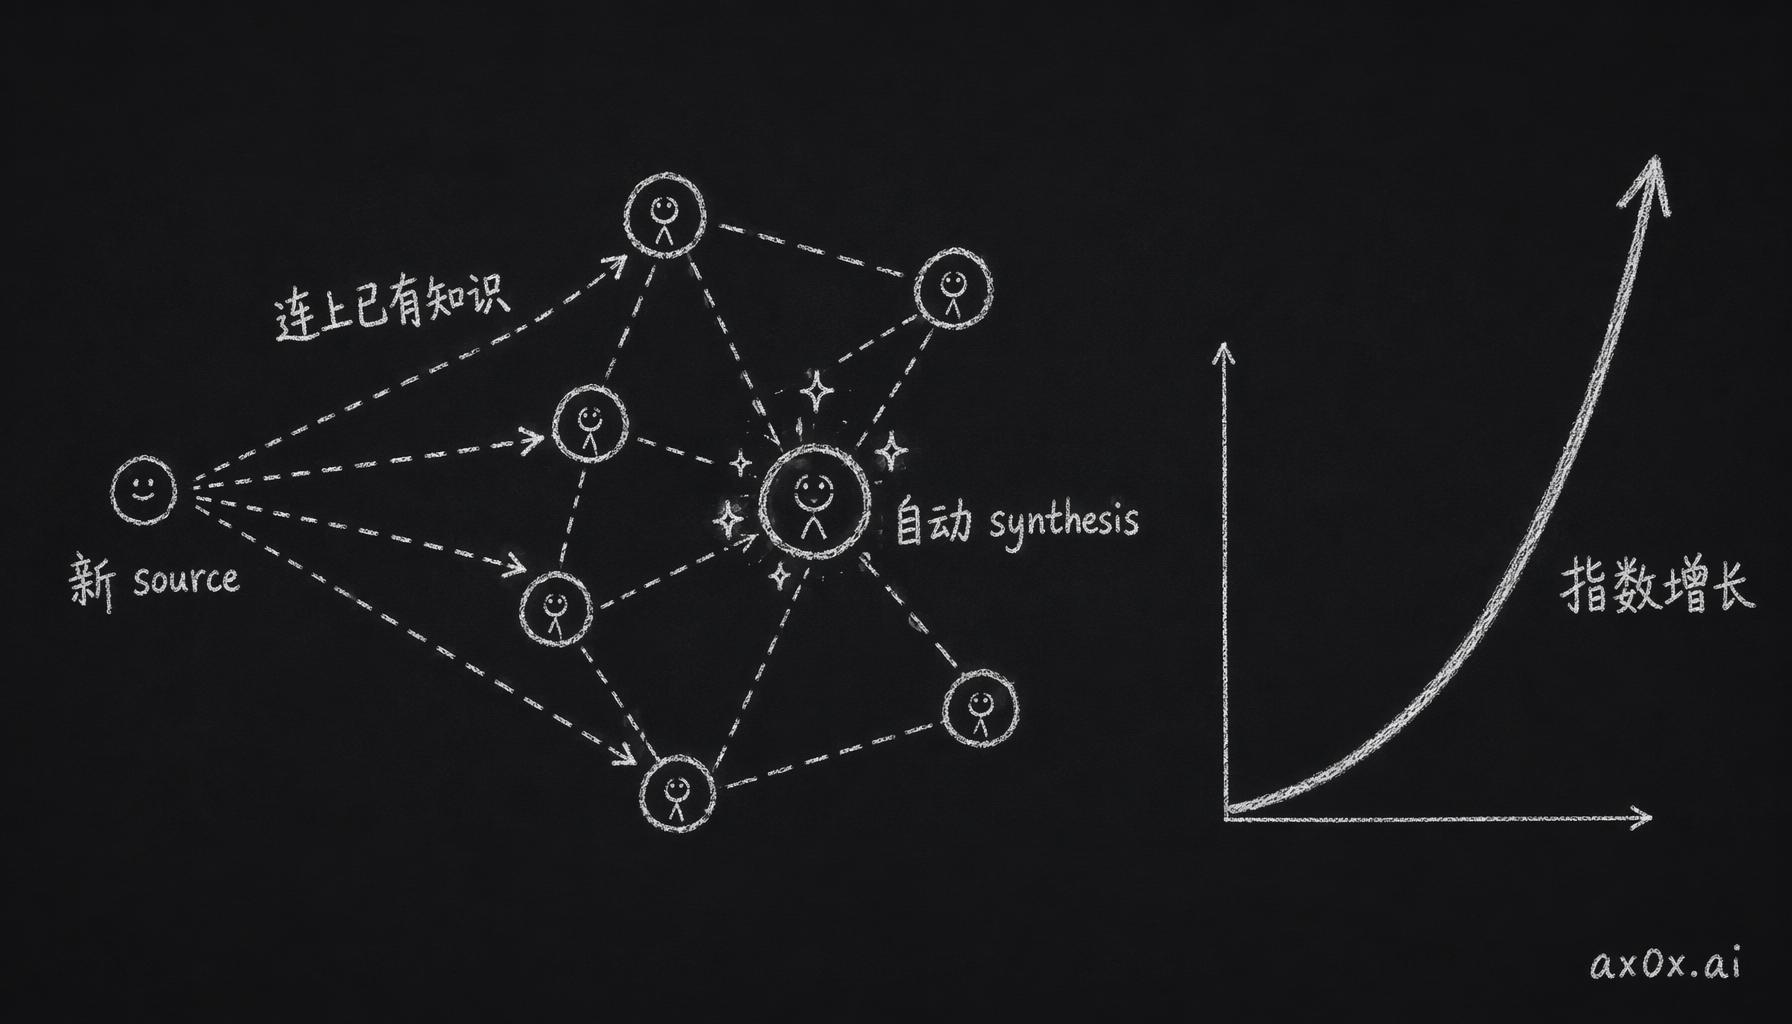 每喂一篇新 source 就能连上已有的全部知识,还自动冒出 synthesis 文章,价值按指数往上走
想试的话,一行命令初始化:
npx cortex-kb init ~/my-wiki
再把 MCP 服务器注册到 claude code,往 inbox 丢链接就行。代码在 github.com/xingfanxia/cortex,现在是 Phase 1,核心循环已经跑通,我自己每天都在用。这个东西没有 UI,没有设置页,也没有仪表盘,就是 5 个 MCP 工具加一个 markdown 文件,剩下的全交给 obsidian。