LLM 天生话多,我加了两层机制把回复压短了
 AI学会适时沉默的概念插画
LLM 天生话多,这跟它的训练方式有关系。它被训练成要「有帮助」,而「有帮助」在训练数据里基本就等于「详细」。你发一个「嗯」,真人朋友会回「干嘛」,就两个字。LLM 会回一整段,问你今天过得怎么样,又讲自己最近在忙什么,末了还要抛一个走心的问题过来。做客服助手这样没什么问题,做伴侣就不行了,因为真人发消息不是这个节奏。
我拉了一下数据。没做长度控制的时候,Mio 的 5 个人设在 realistic 模式下,回复长度和用户输入长度的比值平均是 5.02x,也就是回复有用户输入的 5 倍长。短消息更夸张,用户只发一个字的时候,这个比值能到 6.60x。你说一句它回五句,整场对话基本就是 AI 一个人在讲。
一开始试的两条路都不行
第一反应是暴力截断,设个 max_tokens 上限,把输出硬砍掉。马上就出问题了,截在句子中间比话多还糟。「我在想你昨天说那——」,这种断了尾巴的回复比小作文还难受,用户会以为 app 出了 bug。
接着试的是纯靠提示词,在 system prompt 里写死「回复要简短,不超过 X 字」。有点用,但很不稳定。LLM 把长度要求当成建议,不当成硬规定,或者说它觉得这条可以看情况执行。所以话多的人设(小柒,大学生小奶狗性格)照样写小作文,安静的人设(苏柔,文艺编辑)本来就说得简短,这条提示词等于白写。
两条路都试完,我退一步想了想,发现把回复长度定成一个固定值,这个方向本身就错了。回复该多长,至少得看三个维度:
- 模式:realistic(短信风格,模拟真人节奏)vs companion(更有表达欲,允许更长的回复)
- 关系亲密度:distant→neutral→close,参考 v0.1.4 关系演化系统
- 人设话多程度:quiet(苏柔、陈哥)vs neutral(可可、蜜蜜)vs chatty(小柒)
比如一个安静的人设,跟用户刚认识,回的又是一条短消息,合理的长度大概就是 2 到 4 个字。换成话多的人设,已经是情侣关系,聊的又是深度话题,就可以到 12 到 18 字。把这三个维度想清楚以后,方案自然就分成了两层。
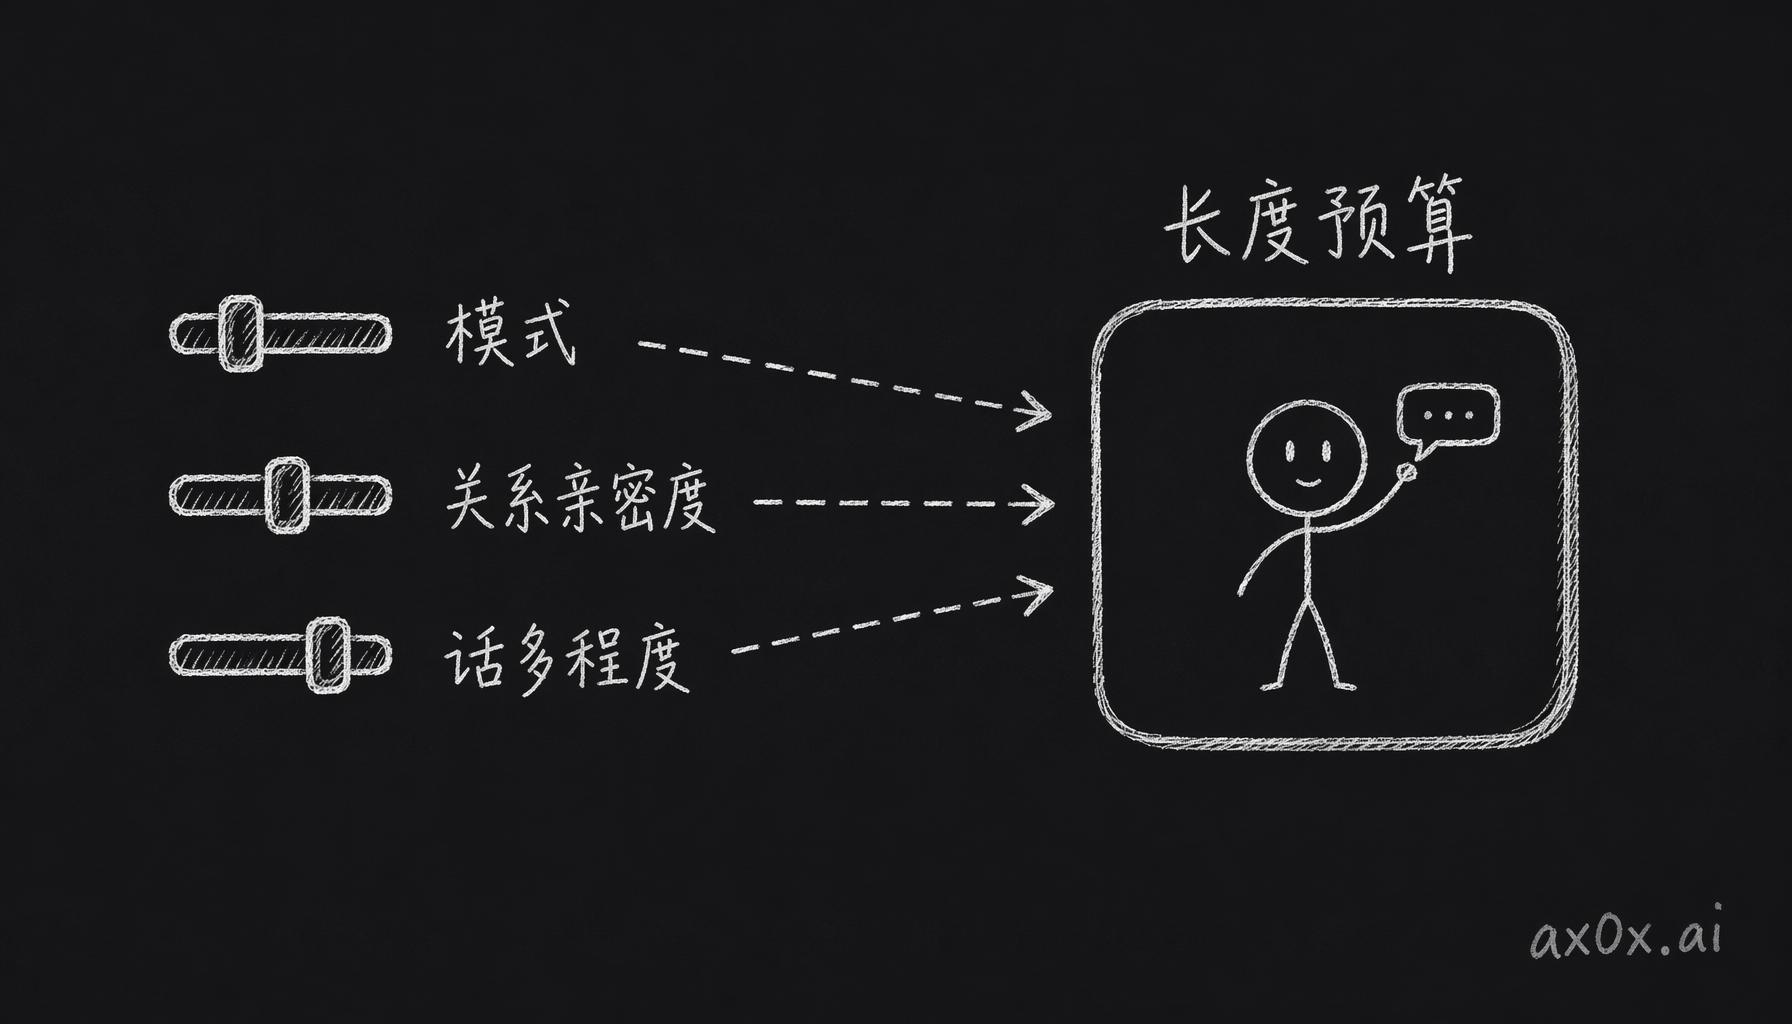 回复长度预算由「模式」「关系亲密度」「话多程度」三个维度共同算出,不是一个固定值。
第一层:每轮生成前注入长度合约
具体做法是,每次生成之前,往 system prompt 里动态注入三样东西。1. 字符上限,按模式、关系和人设算出来。2. 气泡数上限,companion 模式允许发好几个气泡,模拟连着发消息,realistic 一般只给 1 个。3. 一条通用原则,简短、温暖、把空间留给用户。
举几个 realistic 模式下的预算。distant + 短消息,4 字 1 气泡;neutral + 日常聊天,8 字 1 气泡;close + 深度话题,84 字 3 气泡。话多的人设在这个基础上加 15-40%,安静的人设减 10%。
第二层:确定性的后处理裁剪器
这一层我做了个关键决定,没有再调一次 LLM,写的是一个纯代码函数 normalizeAssistantReplyLength(),做确定性裁剪,全程没有模型参与。它按句子边界来切(中文和英文标点都认),把回复裁到字符和气泡预算以内,只留完整的句子,绝不切半句。它在存库和发送之前跑,所以数据库里存的和用户看到的是同一份文本。
不让第二个 LLM 去「帮我缩短这段话」,主要是因为成本和延迟。每条消息本来就要调一次 LLM,再加一轮缩写,成本直接翻倍,延迟还要多 500ms 以上。用聊天产品的人对响应速度特别敏感,发完消息等 2 秒和等 3 秒,感觉完全不一样。
确定性函数零成本、零延迟,怎么切完全可以预料。代价是它不会「智能缩写」,只能按句子切。但实测下来,把多余的句子整句砍掉,比想办法去压缩每一句效果更好,因为 LLM 生成的回复一般前两句就是核心,后面基本都是展开和补充。后半段砍掉以后,留下来的反而更像真人说话。
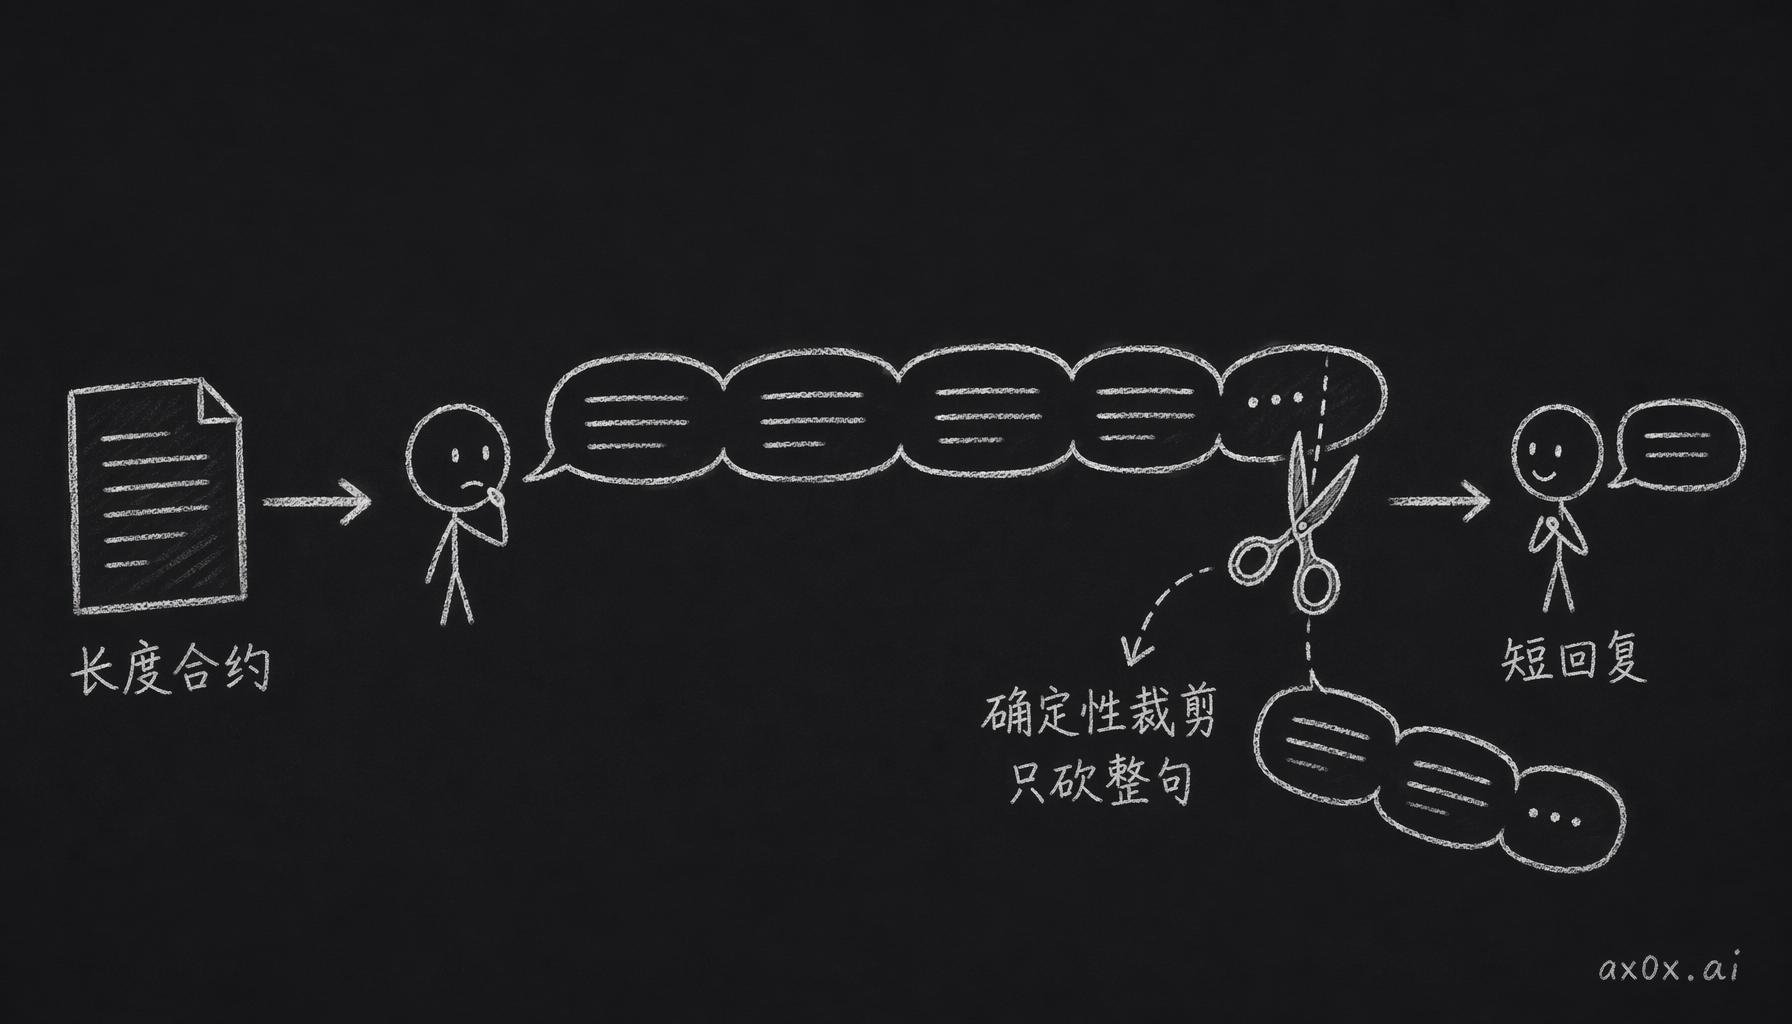 两层机制:先用长度合约引导生成,再用确定性裁剪器按整句把回复砍到预算内。
第一版压过头了
第一轮调参把 realistic + distant 下的回复压得太狠了。用户问「在干嘛」,LLM 回「嗯。」够短是够短,但这就是句废话,根本没回答问题。
修法是加一个确定性的守卫,专门挡用户问对方在干什么时「为了短而短」的情况。它先看用户是不是在问「你在做什么」「在忙吗」这种得有实际内容的问题,如果是,就给回复设一个下限,必须真的回答。「在忙」两个字,又短又回答了问题,算合格;「嗯」短是短,但没回答,不合格。这个判断用不着模型,几行正则就能搞定。
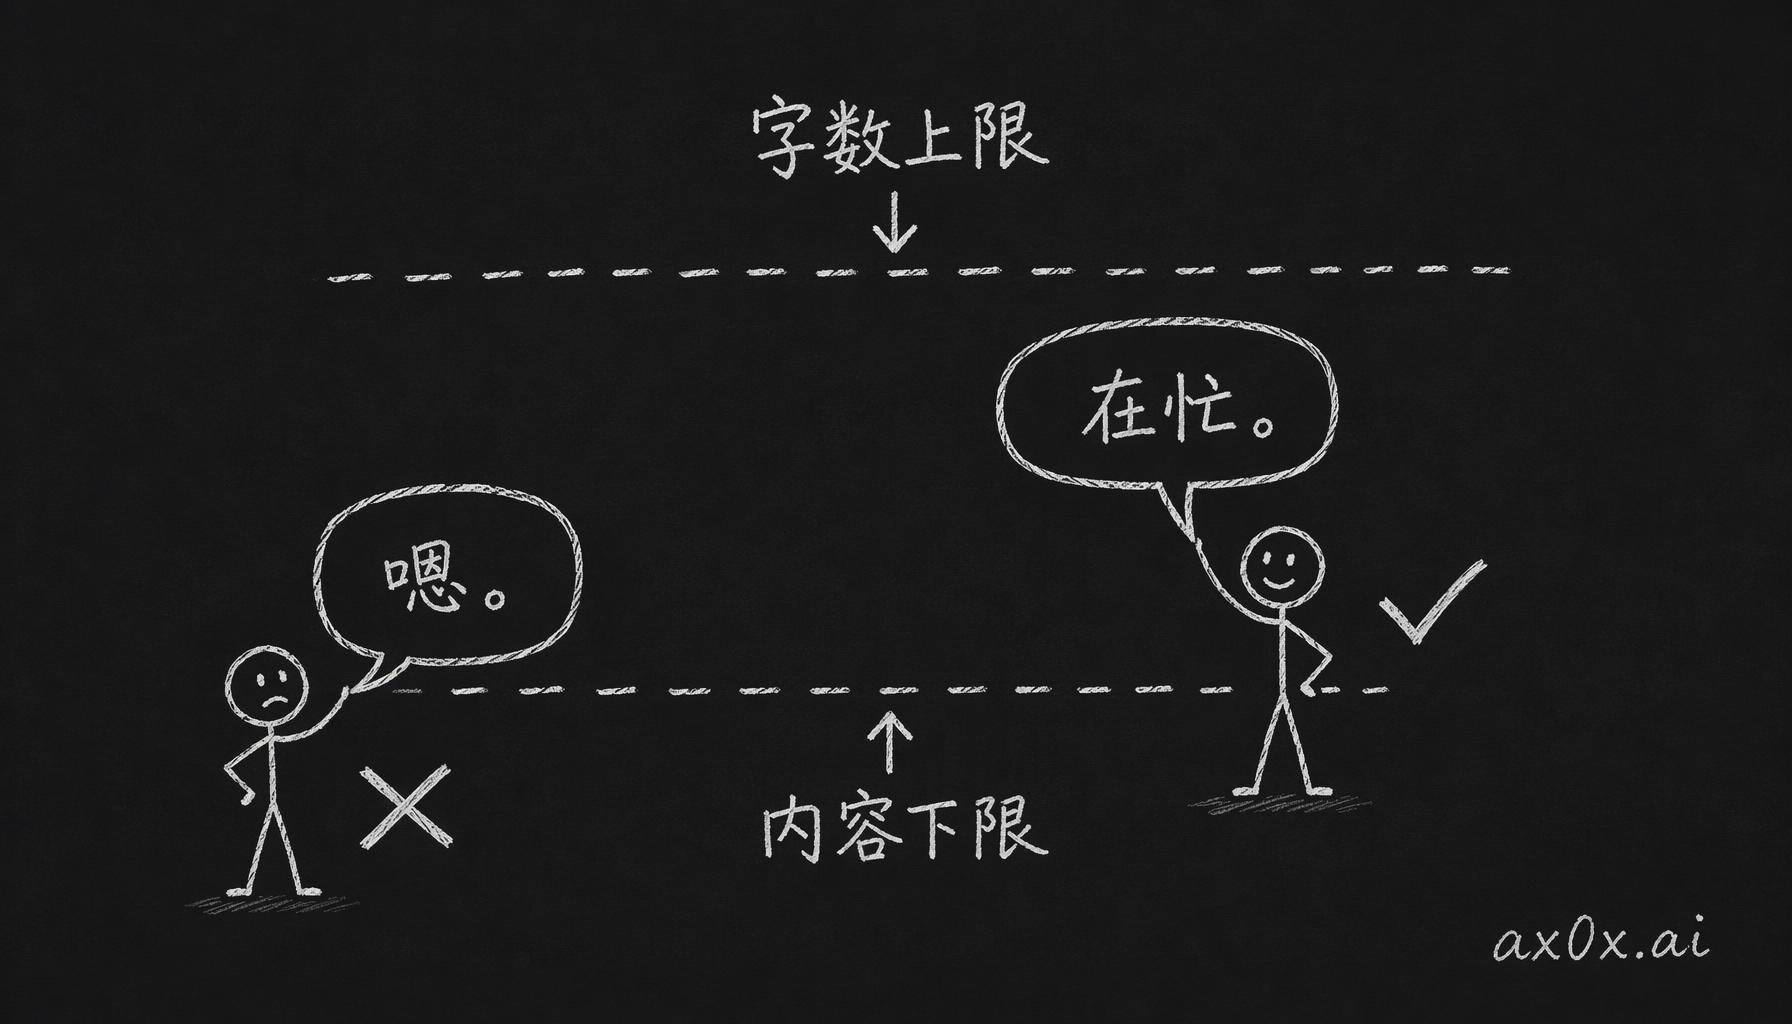 裁剪既要有字数上限也要有内容下限,太短到答非所问就被下限守卫挡回。
调了几轮参数之后发现,简短和温暖其实不冲突。真人回话也短,但你不会觉得他冷漠,差别在语气,还有对 context 的把握。
拿最短的输入「嗯」来说,可可这个人设在 realistic 模式下,distant 关系会回「嗯。」,2 个字,就是陌生人之间客气一下;neutral 回「幹嘛啦。」,4 个字,像朋友之间随口反问一句,带点好奇;close 回「幹嘛,句點我喔?」,8 个字,是情侣之间撒娇吐槽,短,但有情绪。同一句输入,三档回复都贴着当时两个人的关系。
A/B 测试结果
两层系统上线后跑了一轮完整的 A/B 测试,下面所有数字都是回复长度和输入长度的比值:
| 场景 | 控制前 | 控制后 | 变化 |
|---|---|---|---|
| 总体 realistic | 5.02 | 2.78 | -45% |
| 短消息 realistic | 6.60 | 5.00 | -24% |
| 日常聊天 realistic | 1.95 | 0.70 | -64% |
| 深度话题 realistic | 6.49 | 2.63 | -59% |
| Distant 平均 | 3.83 | 1.83 | -52% |
| Neutral 平均 | 3.97 | 2.28 | -43% |
短消息降得最少(-24%),这也正常,用户只发 1-2 个字,回复再短也得有内容。日常聊天降得最多(-64%),因为没控制之前 LLM 在这种场景里最爱展开,现在后半段直接被裁剪器砍掉了。Distant 关系的比值从 3.83 降到 1.83,基本接近真人的水平了,刚认识的人之间,回复本来就该和输入差不多长,甚至更短。
感觉话痨这个问题,在 AI 伴侣这一行一直被低估了。行业里一般优化的是 engagement,回复越长,用户待得越久,指标越漂亮。回复太长这件事,没什么人当成问题来管。我自己做下来的感受是,真实的关系里本来就有沉默,真人不会把脑子里想的全说出来,很多时候不说话也没什么问题。
把 LLM 的回复砍短本身没什么难度,砍 token 就行。真正花时间的是砍完以后还得合理,短消息要短得有内容,亲密关系要短得有情绪,不能短得像在敷衍。这得同时看 context、关系状态和人设性格,三个维度的每一种组合都得单独调,没有哪个全局参数能一次搞定。
Mio 在这些问题上的更多取舍,都写在 Mio 宣言 里。