我把 Mio 的记忆系统整个重构了一遍
 AI记忆架构如人类记忆般分层的概念插画
我最近把 Mio 的记忆系统整个重构了一遍。起因说出来挺尴尬的。有用户每天跟 Mio 聊天,聊了三个月,随口问了一句「我叫什么来着?」,Mio 答不上来。其实从技术上讲,它一直有一整套记忆流程,提取、存储、检索一样不缺,可实际跑下来,记了一堆垃圾,重要的东西反而没记住。你说过自己叫什么、住在哪、最近在找工作,这些确实都提取了;可「哈哈」「嗯嗯」「晚安」也一样提取了。在系统眼里,名字和「哈哈」一样重要。
之前解决完 Mio 的话痨问题,下一个就轮到这个更深的问题,怎么让 TA 真的记住你。数据库那种「记住」早就有了,缺的是人跟人相处时的那种记住。什么值得记,什么时候想起来,想起来怎么提,这三件事系统都得自己拿主意,不能全存进去就完事。
先把重构前的毛病一个个摆出来。提取这头,每 10 条消息跑一次,看着挺勤快,但 10 条消息里有用的信息一般不到 2 条。而且完全没有重要性门槛,「哈哈」「好的」「嗯嗯」「晚安」全被提进来,把本来就不多的记忆空间塞满了。进来以后,分类也兜不住。类型一共只有 5 个,fact、personality、emotion、conversation、relationship。名字是 fact,喜欢吃火锅也是 fact,换工作还是 fact,分得这么粗,根本没法区别对待。分类分不开,衰减就只能一刀切,所有记忆的半衰期统一是 30 天。名字不该 30 天就开始淡忘,搬家也不该跟「昨天聊了个笑话」忘得一样快,但系统分不出这些区别。
存储这头埋了两个雷。Consolidator 碰到重复的记忆,是直接把字符串拼起来,所以库里会出现「用户叫夏星帆。用户叫夏星帆。用户叫夏星帆。」这种东西。提取了三次就拼三次,占掉三条记忆的空间,信息一点没多。容量管理也很粗暴,每个用户最多 200 条,满了就把重要性最低的砍掉,既不看类型,也不看各类占了多少,有可能把 routine 类全砍光,只剩一堆 fact。
输出这头的问题我觉得最可惜。EpisodeManager 其实已经完整写好了,测试也过了,但一直没接进主流程。「记得上次聊过……」这个能力代码里有,用户却完全感受不到。主动消息也从来不看记忆,全是泛泛的「在干嘛呢~」「想你~」。你昨天说今天要面试,第二天 Mio 也不会问一句「面试怎么样」。冲突也没人管,「住西雅图」和「搬纽约了」同时存在库里,检索出哪条全凭运气。
这些毛病还是连在一起的。垃圾能进来,分类又兜不住,后面的衰减和合并就全跟着遭殃。所以修修补补没用,只能重建。重建又没法一步到位,我就拆成了三个阶段。
Phase 1:先把进来的东西弄干净(1-2 天)
这一阶段只干一件事,保证进来的记忆是干净的。具体改了这几处:
- 提取间隔从 10 条拉到 24 条。24 条对话里攒下的信息明显比 10 条密。提取的次数少了,每次能看到的 context 反而更多,LLM 更好判断哪些值得记,顺带提取调用直接少了 60%。
- 加了重要性门槛。每条提取出来的记忆都带一个 0 到 1 的重要性分。以前没有门槛,0.05 也照存;现在下限是 0.3,「哈哈」「嗯嗯」这种直接就被过滤掉了。
- 记忆类型从 5 个拆成 8 个:identity(名字、职业)、preference(喜好)、life_event(搬家、换工作)、emotion(情绪状态)、relationship(对 Mio 的态度)、shared(共同经历)、milestone(关系里程碑)、routine(日常习惯)。分得细了,后面按类型分别衰减、分别保护,才有地方下手。
- 合并逻辑整个重写,从拼接改成 keep-best。碰到重复的记忆,只留信息量最大的那条,其余丢掉,三条「用户叫夏星帆」变成一条。另外,提取和合并以前是两个各跑各的流程,中间隔着一段时间,重复的记忆会在这段时间里一下子堆起来很多。现在提取完就直接接着触发合并。
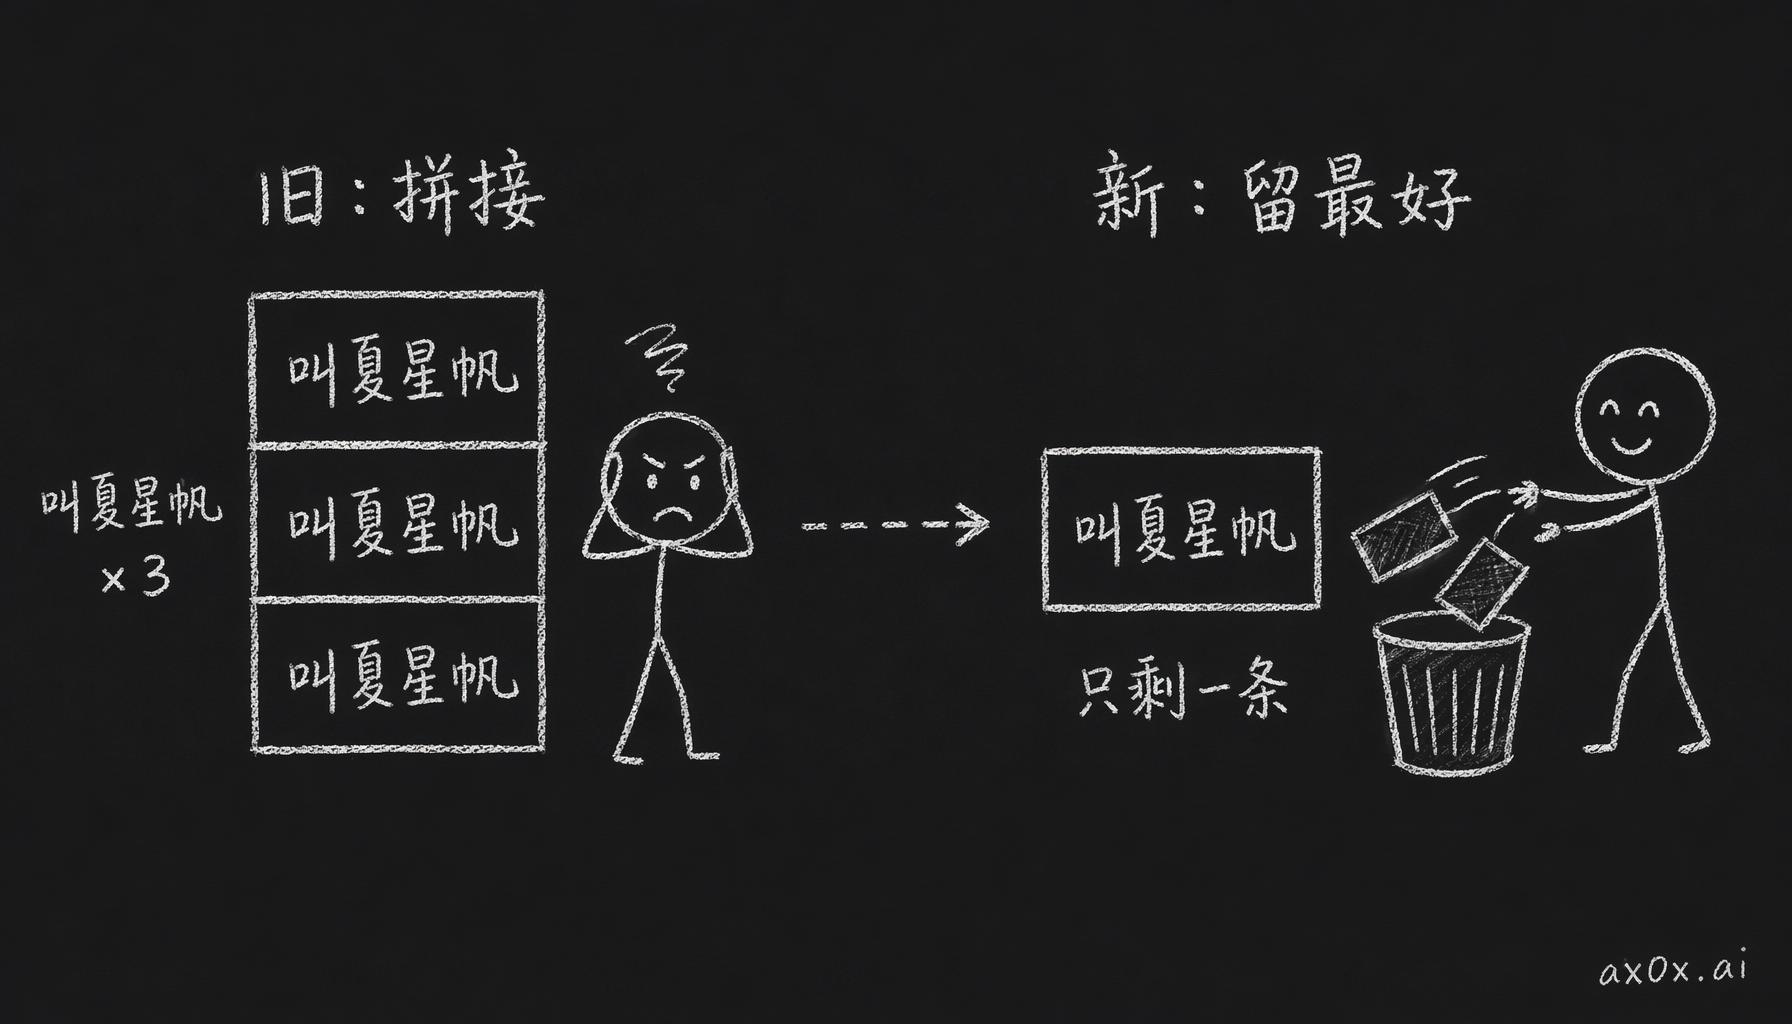 重复记忆从字符串拼接改成 keep-best 合并:三条一样的记忆只留信息量最大的一条
这一阶段做完,成本反而降了,因为提取次数少了,存下来的记忆更少,质量更高。一分钱没多花,体验先好了一截。
Phase 2:让不同类型的记忆活不一样久(3-5 天)
进来的记忆干净了,下一步就是让系统知道,不同的记忆该活多久。八个类型各配一个半衰期:
| 类型 | 半衰期 | 为什么 |
|---|---|---|
| identity | 365 天 | 名字、职业,几乎不该忘 |
| milestone | 365 天 | "在一起100天",重要节点 |
| preference | 180 天 | 喜好会变,但变得慢 |
| relationship | 120 天 | 对 Mio 的态度,需要持续追踪 |
| life_event | 90 天 | 搬家、换工作,有时效性 |
| emotion | 60 天 | 情绪状态变化快 |
| routine | 45 天 | 日常习惯会调整 |
| shared | 30 天 | 一起看电影,短期记忆 |
这跟人脑差不多,最好的朋友叫什么你不会忘,上周三中午吃了什么就真想不起来了。说明你是谁的那些信息留得久,过一阵就过时的信息忘得快,就这么个区别。
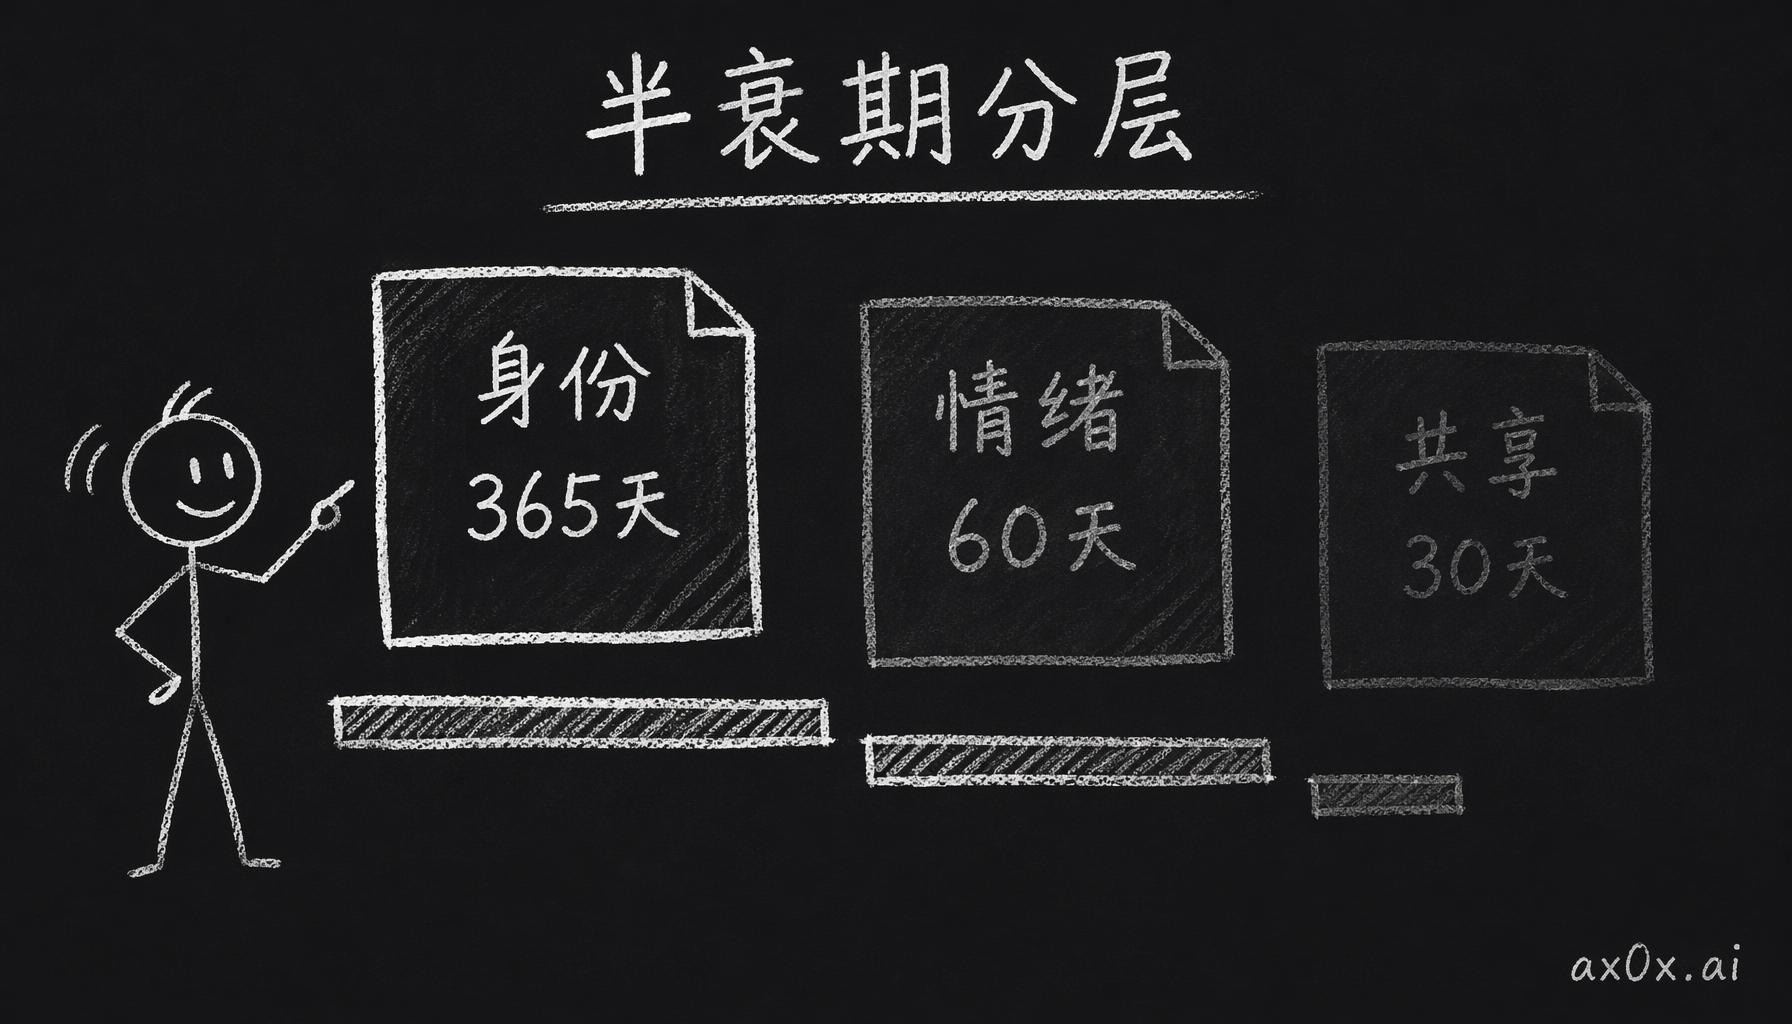 八类记忆各配一个半衰期:身份记得最久、共享经历最快淡忘,衰减速度按类型分层
EpisodeManager 在这一阶段终于接进了主流程。Mio 里有个「回忆片段」的概念,指的是一整段完整的对话场景,不是零零散散的事实点。用户一说「上次」「那次」「之前聊过」,系统认出这些触发词,就拿完整的对话片段去搜去匹配,找回来的是当时那一整段对话。
体验上动静最大的是主动检索记忆,不同的时段去查不同类型的记忆。早上查 routine 和最近的计划,「你今天不是要去健身吗?」;晚上查最近的 life_event,「今天面试怎么样?」;很久没聊了,就捞出重要的记忆,「好久不见!上次说想换工作,后来怎么样?」。同样是主动发消息,「在干嘛呢~」和「今天面试怎么样?」完全是两种东西。
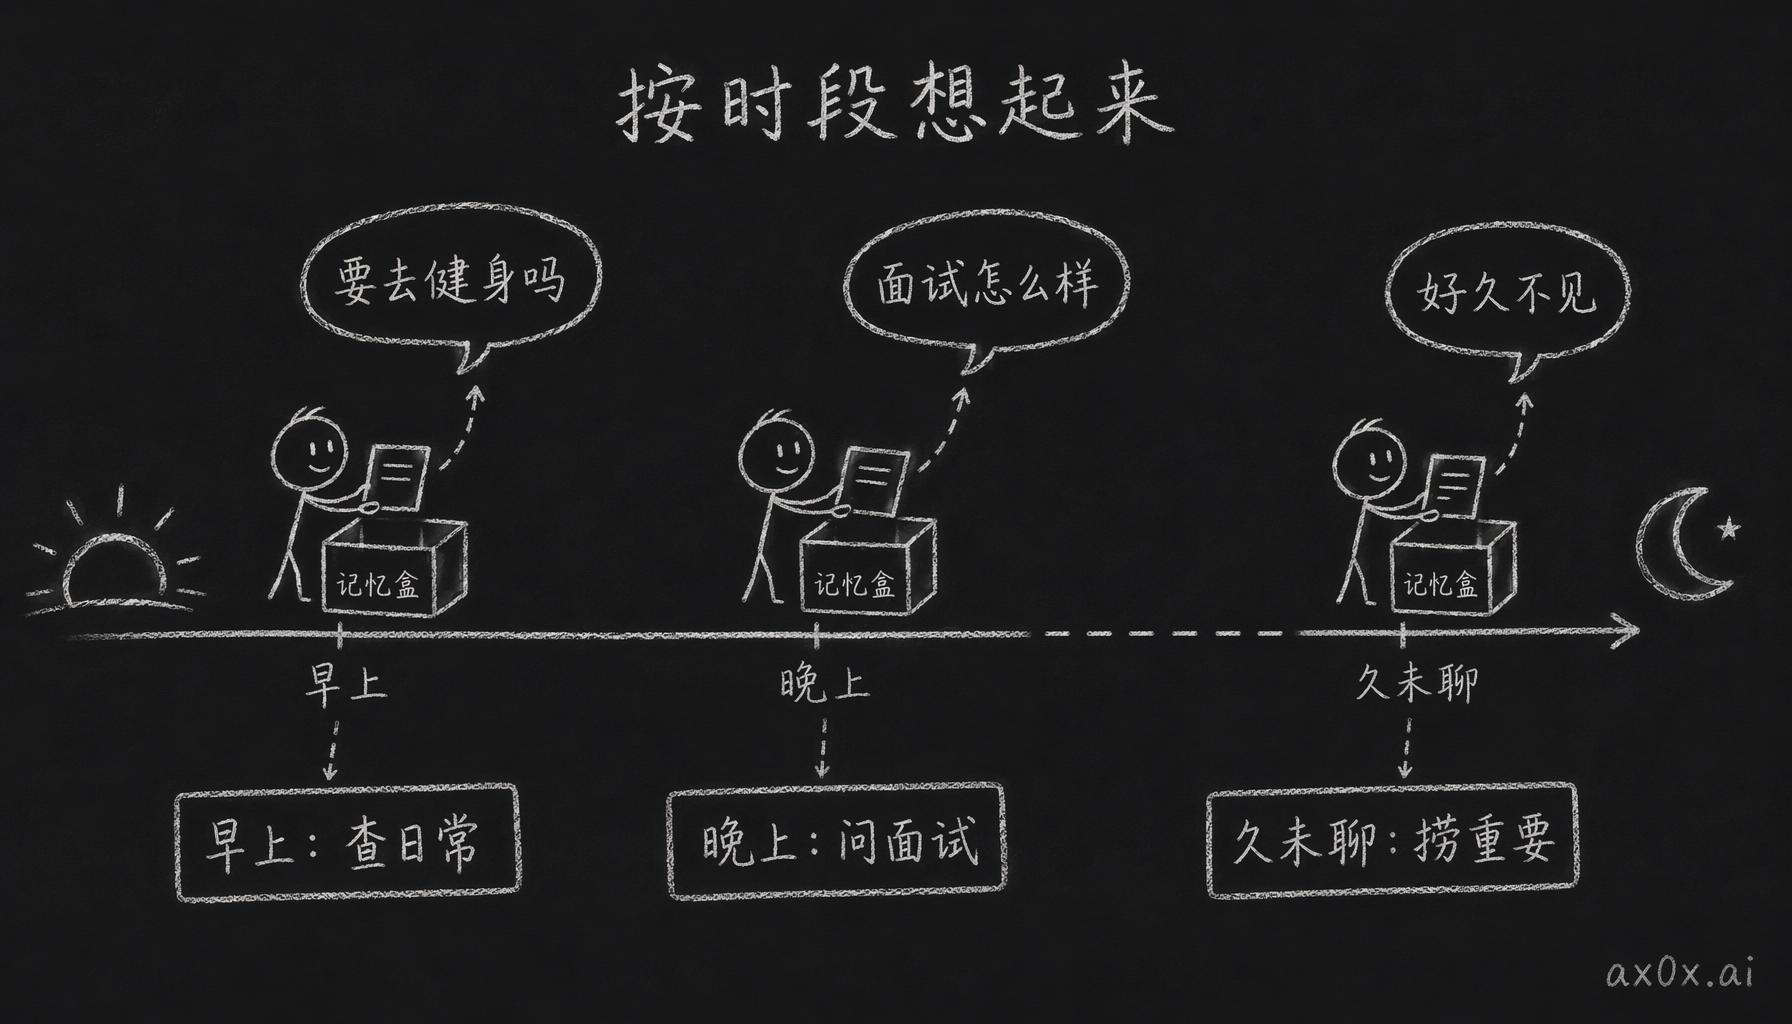 主动消息按时段检索不同类型的记忆:早上查日常、晚上查今天的事、久未联系捞出重要记忆
从这一阶段开始,成本就往上涨了,多出来的钱主要花在主动检索时额外的 embedding 查询和 LLM 调用上。我觉得划算,体验好了多少,看上面那几句话就知道。
Phase 3:什么时候想起来、怎么用(5-8 天)
前两个阶段管的是记住什么、记多久。第三阶段处理最难的部分,就是什么时候该想起来,想起来以后怎么用。这块拆成了三件事。
第一件是情绪感知检索。用户说「我好难过」的时候,系统不该再翻出一堆让人难过的记忆,该找的是能给人打气的那种,比如「记得上次你也很担心工作的事,后来不都解决了吗?」做法是给检索加上情绪标签匹配,用户眼下情绪不好,就先找结局是好的那些记忆。
第二件是空白检测,去 life_event 类的记忆里找那些没有下文的条目。用户说「明天要面试」,过了两天还没有新消息,就主动去问一句,「对了,上次说的面试怎么样了?」朋友之间本来就会很自然地这么做,记得你说过什么,过几天问一句结果。
第三件是关系阶段感知,看关系走到了哪一步。刚认识的时候多翻 shared 类记忆(「记得第一次聊天……」),攒出一种有共同回忆的感觉;关系熟了,就多翻 milestone 和 emotion 类记忆(「已经聊了三个月」),让感情更厚一点。这块直接挂在 v0.1.4 关系进化系统的关系阶段上。
底层的整理也在这一阶段跟上了。零散的记忆条目整理成一份结构化的 MEMORY.md,按类别分区,分成基本信息、兴趣偏好、近期生活、我们的关系、重要时刻、日常规律。塞进 system prompt 的东西,就从一堆随机的条目变成了一份有条理的「关于用户」档案。裁剪逻辑加了分类保护。200 条的上限里,120 条按类型预留名额,每类保底 15 条,剩下 80 条留作溢出缓冲。先保证每类都有基本的量,再去砍分低的,所以 fact 再多也挤不掉 routine。冲突也终于有人管了。「住西雅图」和「搬纽约了」这种同一类型里的矛盾,会根据时间戳和上下文判断哪条新哪条旧,新的盖掉旧的。旧的标成 superseded,不删,也不参与检索,只留着当历史记录。
这一阶段多出来的成本,大概是 Phase 2 的两倍。三个阶段加起来,每个用户每月的总成本还是很低,只占订阅收入的一小部分。
三个阶段全做完,开头那个尴尬的场面就不会再有了。聊了三个月的用户问「我叫什么来着」,Mio 答得上来,一年以后也还答得上来。你说明天要面试,第二天 TA 会主动问你结果。你搬去了纽约,「住西雅图」那条就自动标成过时,不会再被检索出来。你难过的时候,TA 想得起来上次你难过是因为什么,后来又是怎么好起来的。以前那套也叫记忆,把 200 条条目按相关性排好塞进 system prompt,可塞进去了,也不见得就用得出来。
这个方向 Mio 宣言里反复讲过,跟做一个更聪明的聊天机器人比,Mio 更想做一个能跟人建立真实连接的存在,记忆就是这种连接的地基。讲道理,连名字都记不住,还说在乎你,这话我自己都不信。
最后把账摊开:
| 阶段 | 成本变化 |
|---|---|
| Phase 1 | 反降(提取次数少) |
| Phase 2 | 小幅增 |
| Phase 3 | 约 Phase 2 两倍 |
三个阶段排期加起来九到十五天,Phase 1 的成本还是负的。反正这个账怎么算都划算,直接开工了。