ÉLAN 是怎么把一张卡变成四张照片的
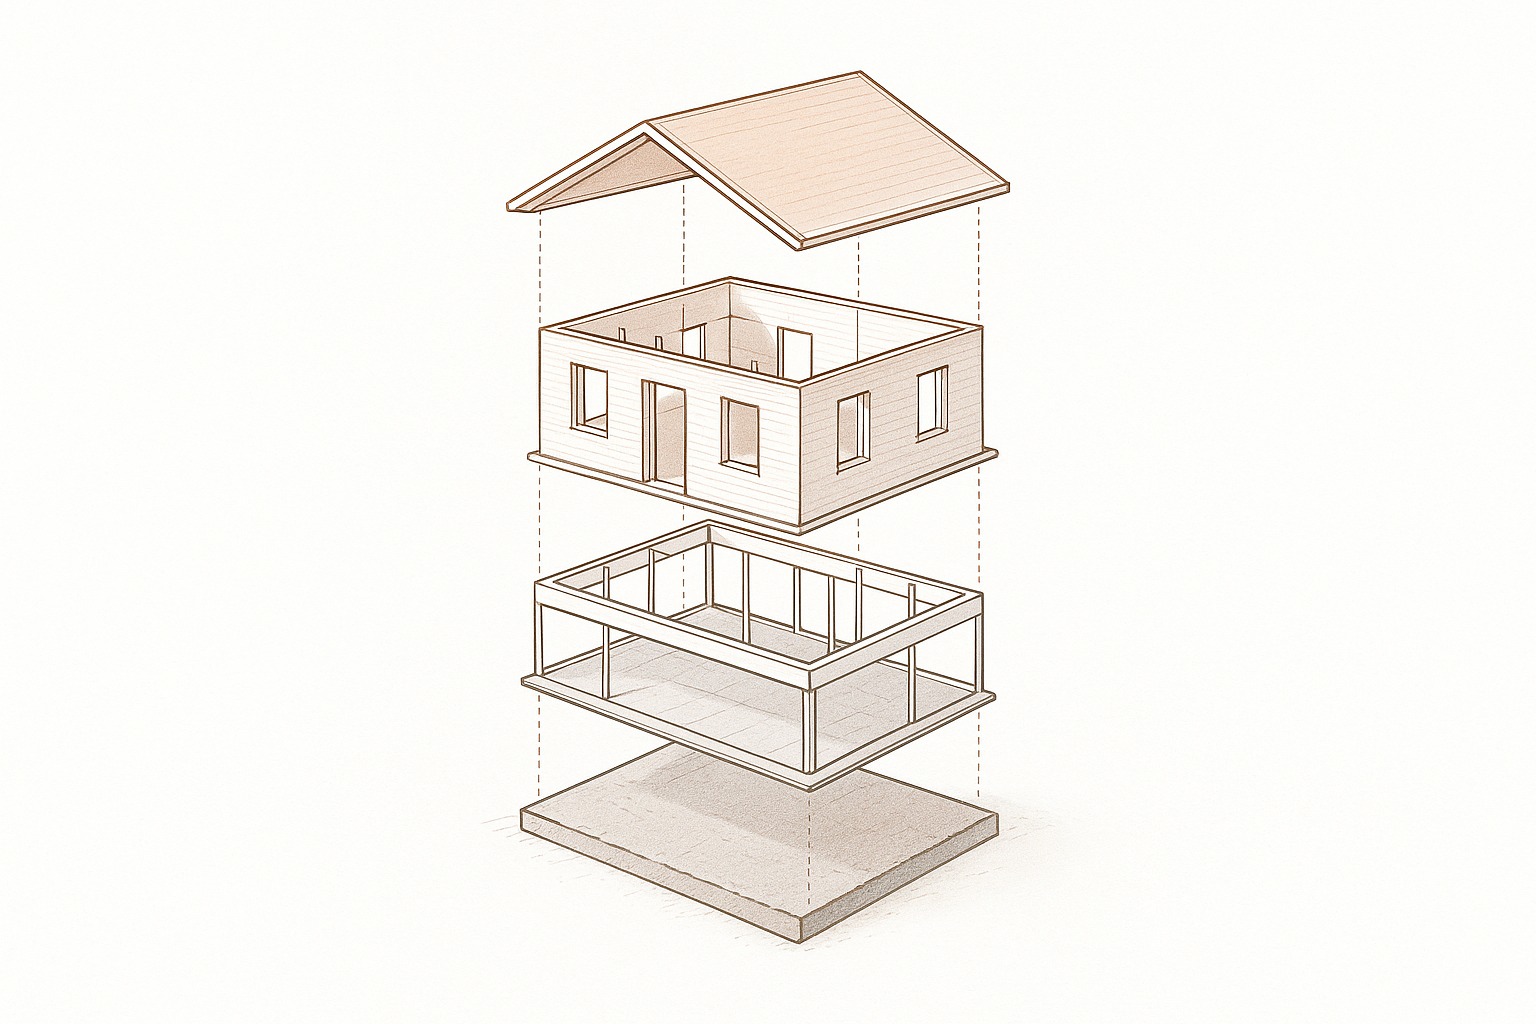 ELAN 多层 Prompt 引擎剖面图
上一篇讲了 ÉLAN 想做什么。它要交给用户一个完整的社交媒体时刻,有照片也有文案,透出那种不经意的高级感。整个产品围着「不经意的优越感」这个概念转,装这个概念的东西是灵感卡。
这篇讲实现。一张灵感卡是怎么变成 4 张照片和一段文案的,prompt 长什么样,结果怎么实时推给用户,一次生成到底花多少钱,挨个讲一遍。
一条 prompt 拼出来有 10 段
每次用灵感卡生成,最后都会走到 buildMuseCardPrompt() 这个函数。它拿一张卡的数据和一个镜头序号,拼出一整段 prompt,一共 10 个段落,各管各的事。
第 1 段是参考图标注,告诉模型它看到的这个人是谁。照片本身是另外发的(按什么顺序发,后面会讲),这一段只负责把身份钉住:
Generate a photo of the EXACT person shown in the 2 reference image(s) above.
Their face must be IMMEDIATELY recognizable — same eyes, nose, lips, face shape, skin tone.
Match their body type and proportions realistically.
这段是故意写这么短的。很早就发现,身份描述写得越多,反而越跟照片「抢注意力」。身份交给照片去管,文字说一句「用那些照片」就够了。
第 2 段是场景,直接从灵感卡的 scene.description 拉过来:
SCENE: 豪华度假村无边泳池,俯瞰无际大海,金色黄昏将水面染成碎金。
LIGHTING: 黄金时刻侧逆光,暖橙色光晕,水面反光形成自然柔光
ENVIRONMENT STYLE: 无边泳池边缘,远景为开阔海面,天边云霞渐变
场景描述全用中文写,这是故意的。目标用户是中国人,看的是中国社交媒体上的审美,所以场景 prompt 直接用中文写,出来的构图比先翻成英文再发给模型对味得多。Gemini 对中文 prompt 理解得还是不错的。
第 3 段是服饰,外加一点奢侈品暗示。暗示都写得很泛,不带品牌名:
OUTFIT: 精致泳衣搭配真丝纱笼,设计师太阳镜随意架于发顶
OUTFIT DETAILS: 真丝纱笼; 设计师墨镜; 精致泳装
COLOR PALETTE: 沙金色, 象牙白, 玫瑰裸粉
我们不会在 prompt 里写「爱马仕丝巾」,写的是「真丝纱笼」。品牌名只放在卡片的 brandHints 数组里,当成 SCENE AESTHETIC 传给模型,让它知道这是什么档次的奢华,但别去画具体的品牌 logo。这跟品牌安全有关,后面细说。
第 4 段是镜头角色。4 张照片,每张在整组故事里都有自己的位置:
SHOT ROLE: establishing — 宽幅全景:泳池延伸至海天交界,人物处于远景左三分之一
COMPOSITION: 超宽画幅,泳池线条引导视线,强调空间的辽阔
标准角色有四个。establishing 是全景,先把场景交代清楚;portrait 是中景,镜头对准人;detail 是某个局部的特写(脚踩进水里、手搭在书上这种);mood/closing 用氛围收尾,一般是剪影或者背影。这样发小红书的时候,四张拼在一起就能讲完一个完整的画面故事。要是四张全随机生成,各拍各的,这个故事就拼不起来。
第 5 段是 pose 和构图。每个镜头可以单独给 pose 指令,没给就用卡片的默认值。
第 6 段是调色,用自然语言说想要什么色调:
COLOR GRADING: golden hour warmth with amber tones, slightly lifted shadows,
               creamy highlights, film-like grain
这里试过两种写法,一种是结构化参数(temperature: warm, saturation: medium 这种),一种是自然语言描述。实测下来,自然语言出来的效果更一致。让模型去理解一个整体效果,比让它同时满足好几个各自独立的约束要靠谱。
第 7 段是情绪,用一句话说整体氛围。
第 8 段是 VANITY_DESIGN_INSTRUCTIONS,ÉLAN 跟别家拉开差别主要靠这段指令,下面单独讲。
第 9 段是收尾的身份锁定,最后再提醒一次脸要保持一致:
FACE IDENTITY: must match the reference photos exactly. Same person, immediately recognizable.
If style conflicts with identity, choose identity.
那句「风格和身份冲突时,选身份」是后来加的。因为模型有时候为了把某个风格做得更到位,会把脸画得没那么准。明确告诉它身份优先以后,效果明显好了。
让奢侈品「不经意」出现
第 8 段的指令实际长这样:
LUXURY PLACEMENT RULES (CRITICAL):
- Any luxury brand items (bags, jewelry, scarves) must appear INCIDENTALLY,
  never centered or prominently displayed
- Brand logos should be partially visible or at natural angles,
  as if the camera happened to catch them
- The photo should look like a candid life moment, NOT an advertisement
- Focus should be on the person and the scene atmosphere,
  not on the luxury items
- The overall feeling should be "this is just my normal Tuesday"
  rather than "look what I have"
五条规则各有各的用处,挨条说一下。先是「不经意出现,绝不放正中」。模型默认会按产品摄影的路子构图,把奢侈品摆在画面正中间,因为训练数据里的品牌物品大多就是这么拍的。这条就是要把这个默认习惯压下去。
「部分可见或自然角度」。logo 完整地朝着正面,一看就是广告。被丝巾的褶子遮住一半的 logo,斜着 45 度随手一放的包,才像真实生活。小红书帖子里的照片就是这么拍的。
「随拍生活瞬间,不是广告」。Gemini 天生爱出杂志风、商业风的构图,打光完美,主体居中,背景干净,看着很厉害,但一眼就是「拍出来的」。目标用户最想躲开的恰恰就是这种感觉,所以得直接跟模型讲清楚,这张照片是拿来干什么的。
「焦点在人和氛围上」。这条告诉模型中间该放什么,就是人的脸、姿态和整体环境。奢侈品往后排,往画面边上放。
「这只是我普通的周二」。这句试了好几种说法。学术一点的说法(project nonchalant affluence 这种)不好使,直接用口语说你想让看的人有什么感觉,效果最稳。
没这段指令的时候,出来的基本就是奢侈品广告大片,人站在正中间举着包,logo 清清楚楚,打光很专业。照片好看是真好看,但发到小红书,谁都能一眼看出来这是广告或者 AI 生成的。加了以后,奢侈品就挪到边上去了。包放在人旁边的椅子上,有半截出了画面。酒店的标识在背景里的杯子上,稍微有点虚焦。焦点全回到了人身上。小红书上真人发的凡尔赛帖子就是这个样子。
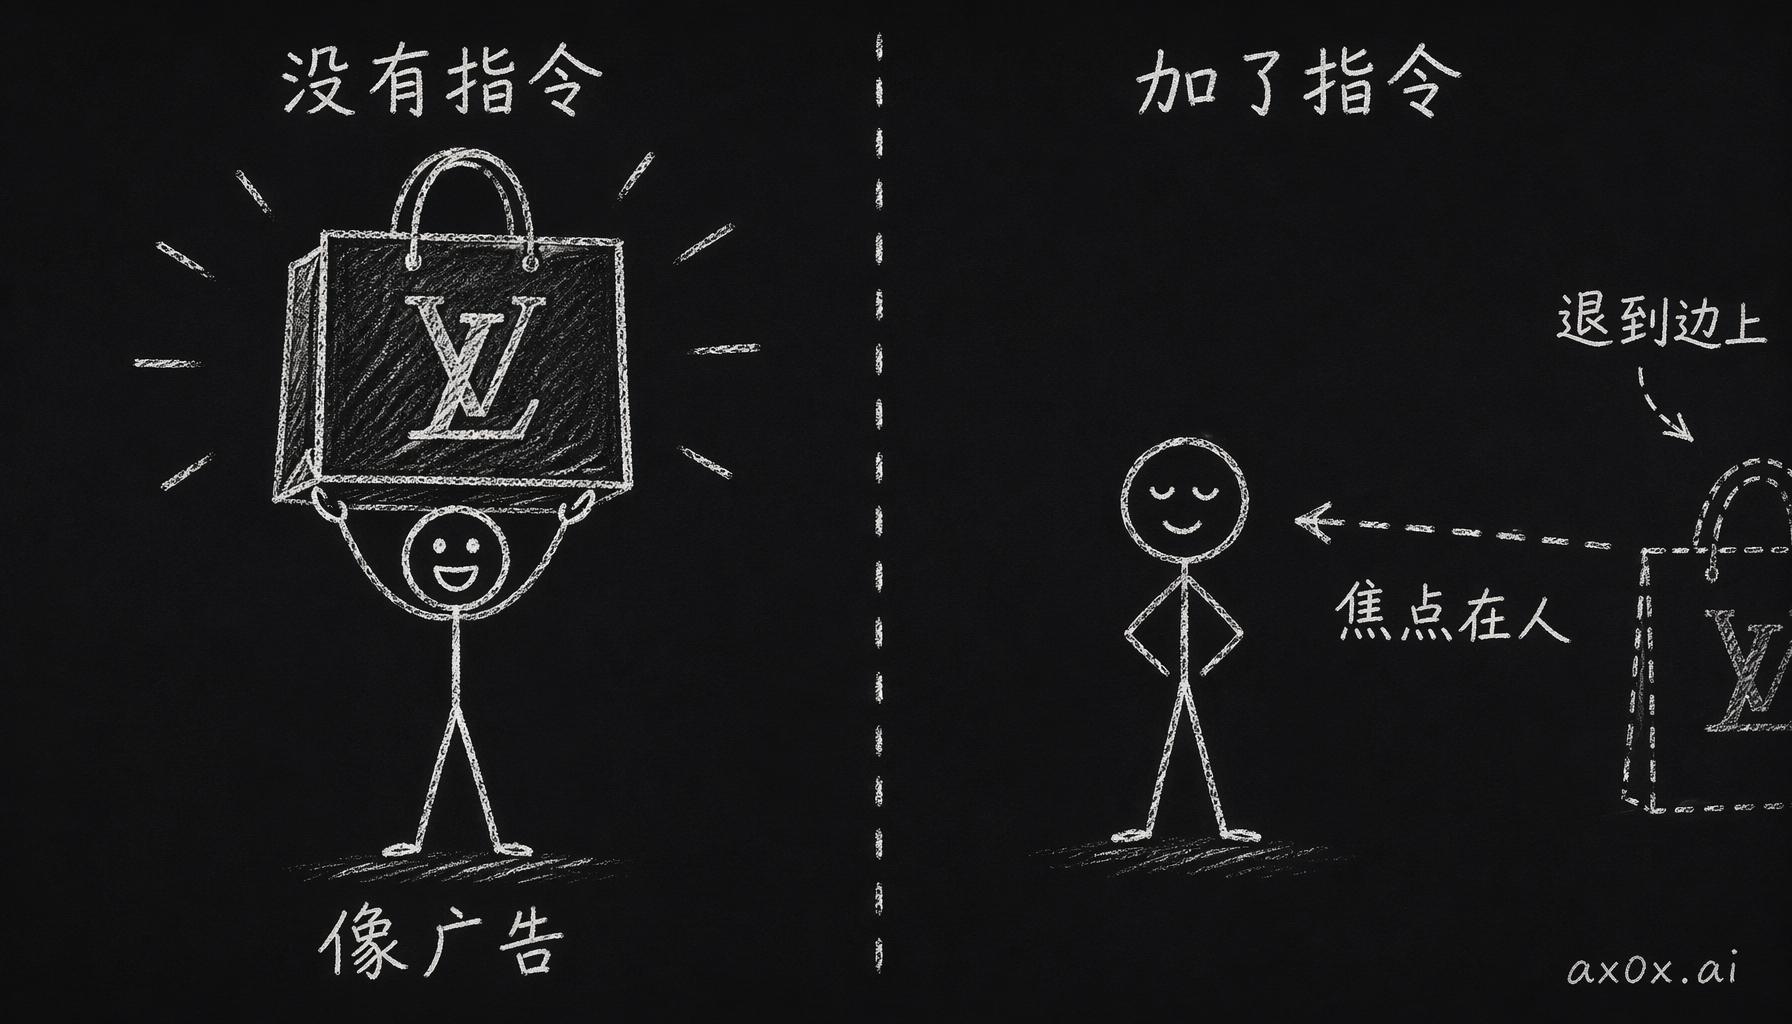 加了 VANITY 指令后,奢侈品从居中的广告位退到画面边缘,焦点重新落回人身上。
参考图要放最前面,还要发两遍
prompt 写得再好,参考图发得不对,人脸一致性照样上不去。做了大量测试以后发现一个规律,Gemini 会明显更看重 parts 数组里排在前面的图片。所以 generate-photo.ts 里的 buildParts() 函数按一个很严格的顺序来:
- 先发参考图,前面不放任何文字。每张图其实发了两遍,为的是加大权重
- 然后是说明身份关系的指令,"Use the uploaded image(s) strictly as the FIXED IDENTITY REFERENCE..."
- 再是场景和风格的 prompt,也就是
buildMuseCardPrompt()的输出 - 如果用户上传了自己的场景照,这张场景参考图放在最后
图片发两遍这个事,一开始我也觉得匪夷所思,会不会把模型搞混?实测下来没有,每张参考图发两遍,人脸一致性明显好了。其实就是给身份信号加了权重,同一个东西喂两遍,模型就更把它当回事。
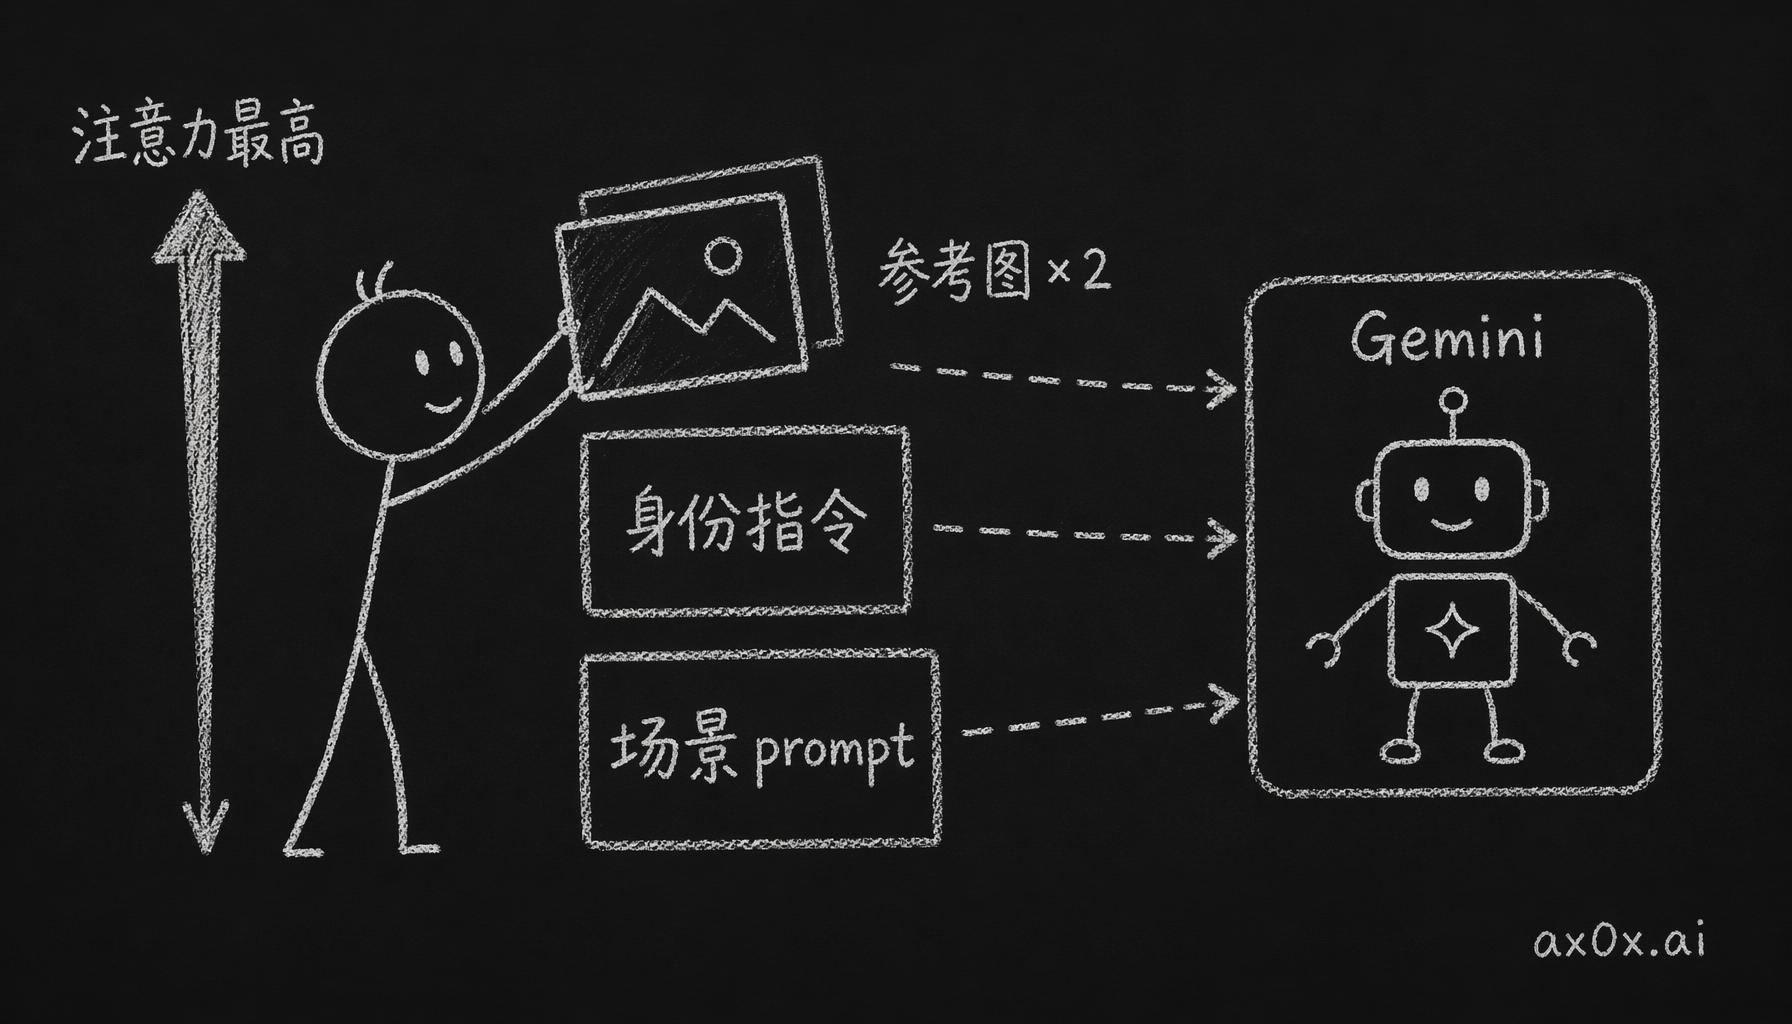 参考图排在 parts 数组最前面并发两遍,拿到最高注意力,人脸一致性因此更稳。
4 分钟的等待怎么处理
用户点了「光影创作」以后,要等 4 张照片生成。每张 15 到 60 秒不等,四张加起来可能要 4 分钟。一个人盯着屏幕等照片,4 分钟是很长的。
推送这块用的是 SSE(Server-Sent Events),没用 WebSocket,原因大概有几个。
一是单向就够了。客户端只管收事件,发完第一个请求就不用再往回发数据了。SSE 本来就是为这种用法设计的,WebSocket 能双向通信,放在这里纯属浪费。
二是基建更简单。SSE 走标准 HTTP,不用另外开 WebSocket 服务器,不用处理协议升级,也不用管长连接池。这点在 Vercel 的 serverless 架构上很重要,因为 WebSocket 得用 Edge Functions,还要加一堆专门的配置。
三是断线自带重连。手机网络掉线是家常便饭,特别是在国内。SSE 自带重连协议,掉线了自动就处理了;WebSocket 断了得自己写恢复逻辑。
实现很直白,API 路由建一个 ReadableStream,4 张照片并行生成:
const stream = new ReadableStream({
  async start(controller) {
    send("started", { sessionId, totalPhotos });
    // 并行启动所有生成请求
    const promises = poses.map((_, i) => generateWithQc({ prompt, index: i }));
    // 每完成一张就推送
    const pending = promises.map(p => p.then(async (res) => {
      if ("error" in res.result) {
        send("photo_failed", { index: i, error: res.result.error });
      } else {
        send("photo_completed", { index: i, imageId, previewUrl });
      }
    }));
    await Promise.allSettled(pending);
    send("completed", { successful, failed, total });
  },
});
SSE 事件就四种,started(session ID 加总数)、photo_completed(带预览 URL)、photo_failed(带错误信息)、completed(最终统计)。客户端每收到一张就渲染一张,不用等全部生成完。
等的这段时间也专门设计过。就算有流式推送,一张 15 到 60 秒还是很长。加载界面没放进度条,因为进度条会让人以为时间估得出来,可这个时间估不出来。界面上放的是灵感卡预览图的轮播,配一句「你的光,刚刚好」。每出来一张照片,就替换掉一个 loading 占位符,带一个入场动画。整体感觉是照片一张一张送到了你手上,用户不用盯着一个「处理中」干等。
人脸漂移和质检
AI 写真最让人崩溃的就是人脸漂移,生成出来的人跟参考照片里的人有点像,但明显不是同一个人。用户对自己的脸太熟了,差一点点都看得出来。
ÉLAN 的做法是在生成之后加一层质检,用的是 Gemini Flash(纯文本模型,又便宜又快)。每张照片出来以后,把它和原始参考图一起发给 Flash,问一个很简单的问题:「这是同一个人吗?」
如果返回 same_person: false,系统最多重试 2 次。重试全都失败,就用最后一张,给用户看一张 80% 像的照片,总比什么都没有强。重试和质检的次数都算进了成本模型。
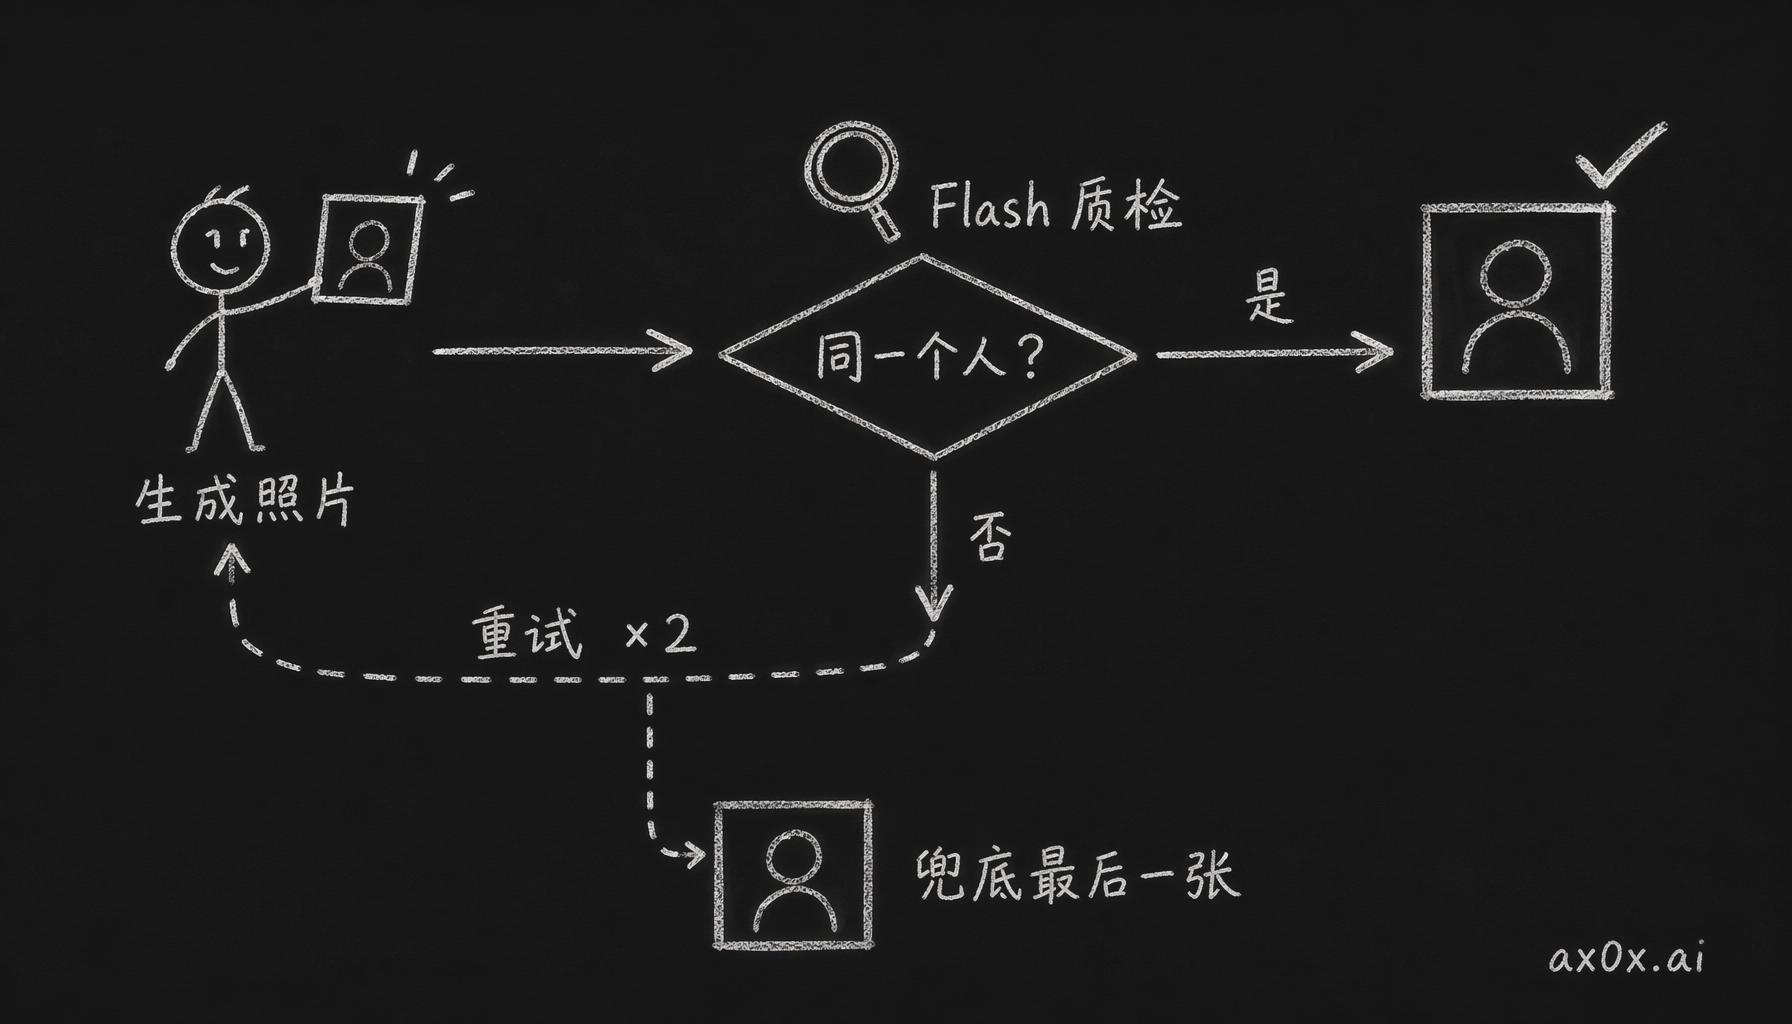 每张生成图交给 Flash 问「是同一个人吗」,不是就最多重试两次,都失败就用最后一张兜底。
质检一次只花几厘钱,多等 2 到 5 秒,能把最离谱的漂移抓出来。实测下来,第一次生成的图大概有 15-20% 会被质检拦下,其中约 80% 重试以后能过。
配文系统
配文跑在另一个模型上,用的是 Gemini 3 Flash,纯文本,比图像生成模型便宜得多。文案分三种风格,各有各的性格。
凡尔赛,就是不经意地炫耀,文案说小事,照片露大事。风格指令是这么写的:
"文案描述一件普通小事或日常瞬间,绝对不能直接提及场景名称、品牌名或价格。照片本身已经在炫耀,文案要显得漫不经心、理所当然。"
示例库里给的例子有「难得什么都不想,泡了一整天的水」和「说好九点起,结果又赖了两小时的床」。
文艺,就是很短的诗。「用感受和意象写,不叙事、不解释。」例子是「水天一色,心也跟着透明了」。
简约,就一句话。「一个极短的中文句子或词组,极致留白。」例子是「泡着不想动」。
每种风格发小红书和发朋友圈,字数和格式的规则也不一样:
| 小红书 | 朋友圈 | |
|---|---|---|
| 凡尔赛 | 200 字,3-5 个话题标签,最多 2 个 emoji | 80 字,不加标签,最多 1 个 emoji |
| 文艺 | 150 字,3-5 个话题标签,最多 1 个 emoji | 60 字,不加标签,最多 1 个 emoji |
| 简约 | 50 字,3-5 个话题标签,不用 emoji | 30 字,不加标签,不用 emoji |
prompt 里让模型一次生成 3 条候选,用 JSON 数组返回。用户默认看到第一条,点「换一换」就能换。话题标签会从文案里抽出来单独显示(只有小红书这么做)。整个配文调用 2 到 4 秒就搞定。
配文 prompt 里还有一条硬规则,禁止提及任何品牌名、酒店名、餐厅名、景点名。这是从凡尔赛公式延伸出来的,文案里一写「住了四季酒店」,那种不经意的感觉就全毁了。所以文案要写得够泛,奢华只让照片去露。
一次出图花多少钱
成本几乎全压在一头。因为图片的 output token 单价是文字的 120 倍,所以钱基本全花在出图这一步上。
一次标准的 4 张出图,钱花在五个地方:输入的文本 token、输入的参考图 token、输出的图片 token、人脸质检和配文生成。光输出图片这一项就占了大概 96%。剩下的 prompt、参考图、质检、配文,加起来都是零头。一次 session 总共花不到一块钱。
分辨率越高越贵,2K 大概是 1K 的 1.5 倍,4K 大概是 2.3 倍。额度系统里的分辨率倍率(1x、2x、4x)大致就是照着 API 成本的比例定的。
漂移重试会让成本浮动。一张图质检不过、重试两次,这张图的生成成本就是 3 倍。最差的情况是 4 张全都重试两轮,一次 session 能到基础成本的将近 3 倍。但实际跑下来,重试多花的钱不算多。
几个真实踩到的问题
品牌安全。早期灵感卡的 prompt 里是直接写品牌名的,「Hermès Birkin 手袋」「安缦度假村的标识」这种。Gemini 有时候真会把认得出来的品牌 logo 和产品画出来,这在法律上是雷区。后来把所有 prompt 都改成了泛泛的奢侈品描述(「真丝丝巾」「设计师墨镜」),品牌名只留在 brandHints 数组里当 SCENE AESTHETIC 用,让模型知道奢华到什么档次,但别去照搬具体的知识产权。
4 张照片之间的人脸一致性。每张照片都是单独生成的,没办法在几次 Gemini 调用之间「锁定」同一个身份。人脸质检能抓住最明显的漂移,但细微的差别还是会有,比如肤色差一点,某一张的下颌线尖一点,眼距有点不一样。发一组小红书照片问题不大,但仔细比还是看得出来。这是现在这套 API 本身的限制,想在多次生成之间把身份彻底锁住,要么做微调,要么换一套完全不同的架构。
2 小时过期。生成的图片存在 Vercel Blob 里,2 小时后自动删掉。这是为了省钱,每张生成图都永久存着的话,存储费很快就控制不住了。但用户有时候生成完一组照片,出去转了一圈回来,照片就没了。Redis 里的 session 元数据也是 2 小时过期。这事跟每个内测用户都解释过,也是大家吐槽最多的一点。把过期时间放长,或者加一个「保存到永久」的功能,已经在计划里了。
输出图片占了 96% 的成本。一开始的计划是内测期间不限次数随便生成。算完一次实际要花多少钱,这个计划就死了,就算只用 1K 分辨率,一天跑一百次,API 账单也很可观。额度系统就是这么来的,跟商业策略没关系,纯粹是不想在测试阶段就把自己烧破产。
prompt 越长,脸越不准,这两头直接冲突。场景、服饰、情绪、构图写得越细,模型分给参考图的注意力就越少。现在的 prompt 是删减过的,早期版本比这长 3 倍。先发参考图再发文字,这个图片优先的改法效果最大,但这个 tradeoff 一直都在。有时候一张照片构图很美,脸却只还原了 80%,到不了 95%。
配文质量时好时坏。一次给 3 条候选有点帮助,但 Gemini Flash 偶尔还是会写得太直白(「今天的泳池好美」这种),或者抽象到看不懂。「禁止提及品牌名」这条规则有时候也会让模型矫枉过正,写得太含糊。正在考虑生成以后再加一层关键词过滤,碰到含违禁词的文案就拦下来重新生成,但这样延迟和成本都会上去。
反正 ÉLAN 跟 Gemini 说话的方式大概就是这么一套:prompt 分十段各管各的,参考图放最前面还发两遍,四张并行生成走 SSE 推,后面挂个质检兜底。每一块都是试出来的,就这么回事。
上一篇讲产品愿景。下一篇会细讲灵感卡的设计,包括现在这 18 张卡是怎么做出来的,每张卡背后是什么数据结构,新卡又是怎么编辑的。
This post is also available in English.