
会议录音又测了两周,本地转写已经够用了
上一篇文章发出去以后收到不少反馈,有人提到可以用 whisper.cpp 在本地转写,有人分享了用硬件混音器的办法。我花了两周把这些新方案都测了一遍,写个更新版。
whisper.cpp,本地转写真的能用了
之前做会议纪要,转写这一步都是调 API,用 Whisper API 或者 Deepgram。花钱不多,但慢,这点挺要命的。三小时的会,录完要上传,等它转写,再把结果拿回来,一趟下来十分钟起步。换成本地模型就省了上传和来回等的这一趟,录完直接在本机转。
whisper.cpp 是 OpenAI Whisper 模型的 C++ 移植版,能用 Apple Silicon 的 GPU 加速。我在 M2 Max 上跑 large-v3 模型,一小时的音频大概 3-4 分钟转完,准确度跟 API 版差不多。
但它有个很关键的短板,分不出说话人,也就是没有 diarization。Whisper 只管把话转成文字,不知道是谁说的,你得另外再跑一个 diarization 模型,让它去分谁是谁。目前开源里最好的是 pyannote-audio,要跟 whisper.cpp 搭着用的话,胶水代码得自己写。
我实测跑下来的流程大概是这样:录音 → whisper.cpp 转写 → pyannote 做说话人分离 → LLM 生成纪要。全程在本地跑,完全不用联网,录音结束后 5 分钟以内出结果,已经够用了。
虚拟声卡这边也有新进展
BlackHole 的开发者最近更新了 2ch 和 16ch 两个模式。16ch 版能把系统音频和好几个麦克风同时录到不同的音轨上。如果你想让每个说话人都有自己单独的一条音轨,目前免费的就只有它。
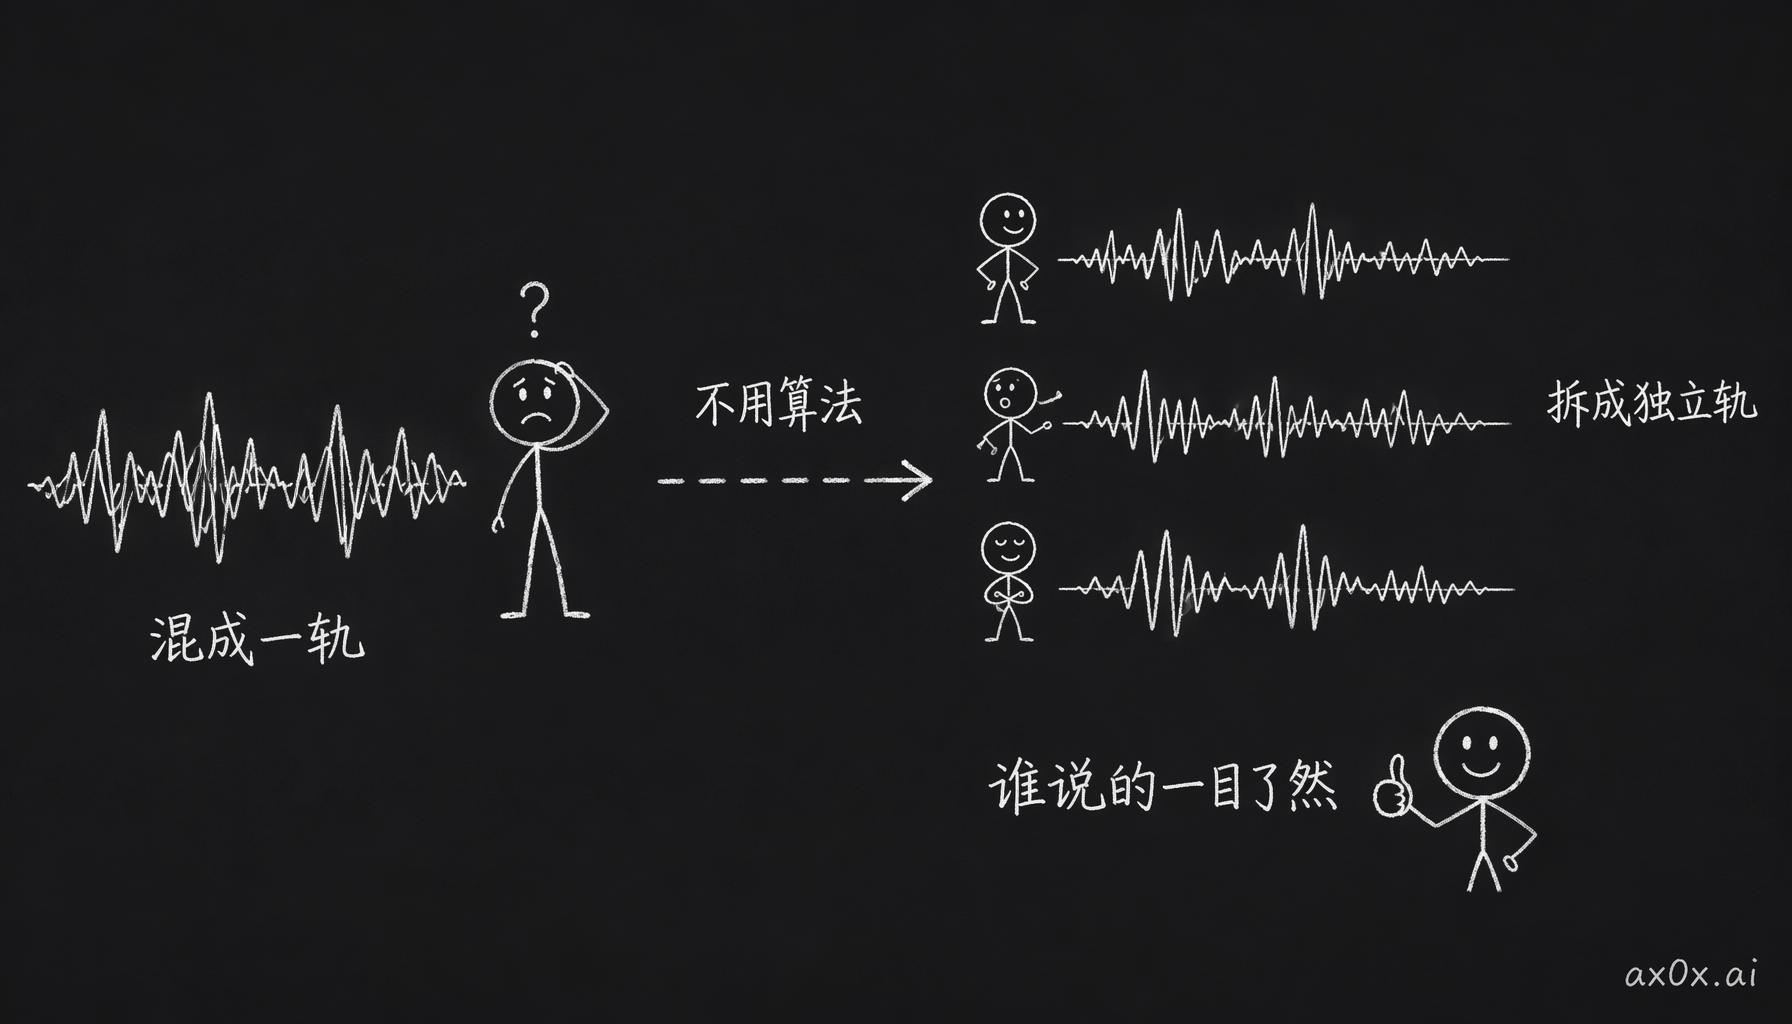 把混在一起的会议声音拆成独立音轨,说话人身份就免费拿到,不用再靠算法去猜谁在说话。
还有个叫 Sunshine 的东西(GameStream 的替代品),最近在 macOS 上也能录系统音频了。做法有点黑,是往系统里装一个虚拟音频设备扩展。它本来就不是给会议录音做的,但实测效果还不错。
物理混音器,最笨的办法最稳定
测软件方案的时候,我顺便试了一下物理混音器的办法,就是在开会那台 Mac 的耳机孔上插一根 AUX 线,另一头接到录音的手机上。听着是最笨的办法,但实测下来,所有方案里就它最稳。
好处是不用给任何软件权限,也不挑系统版本,苹果的音频安全策略随便怎么改,这根线都照样能用。缺点也有,AUX 走的是模拟信号,会有底噪,而且你得多准备一台手机专门录音。
还有,用硬件录音,隐私的问题也顺手解决了。线插着就是在录,拔了就是没录,用户自己看得见。软件写的隐私声明,最后还是得靠用户去信那段文字。一根实实在在的线就没这个问题,录没录就摆在那儿。
现在的推荐方案
轻量用户:QuickRecorder + ScreenCaptureKit。什么都不用配,系统音频直接录。
技术用户:whisper.cpp + pyannote + BlackHole 16ch。全在本地跑,能分说话人,还能多音轨。
对隐私极度敏感的:硬件混音器 + AUX 录音。物理上就隔开了,也不用操心软件权限。
我自己现在每天用的是 QuickRecorder + whisper.cpp 本地转写 + claude 生成纪要。开完会五分钟以内,手上就能有一份有结构的纪要。反正对我来说,这个体验已经很接近理想的样子了。