
prompt 前面的东西,比 prompt 本身重要
最近在弄 Clawd 的记忆系统,碰到一个挺有意思的现象。用户说「我好累」,我这边性格档案、记忆数据、模型全都没动,只是把喂给模型的 context 换了种组织方式,回复质量就差出去很多,不是差一点半点。prompt 一个字没改,改的是 prompt 前面那堆东西的排序。就这么个排序的事,效果能差这么多,我觉得值得讲一下。
prompt 只占总输入的一小部分
所有 prompt 教程都在教你怎么把指令写得更好,角色扮演、few-shot、chain-of-thought,反正全是在优化 prompt 这段文字本身。但你真去看一次完整的请求就知道,prompt 在整个输入里就占一小截。真正决定模型怎么表现的,是 prompt 前面那一大块,性格档案、记忆片段、用户画像、对话历史、系统设定都在里面。我把这些东西叫 pretext,就是 prompt 之前铺垫的那些东西,pre-text,字面意思。
模型是个什么角色,脑子里装了什么,现在处在什么状态,这些都是 pretext 决定的。prompt 管的其实很窄,就是这一轮让它干嘛。大部分人把九成精力花在指令上,一成花在 context 上,我只能说这个比例搞反了。
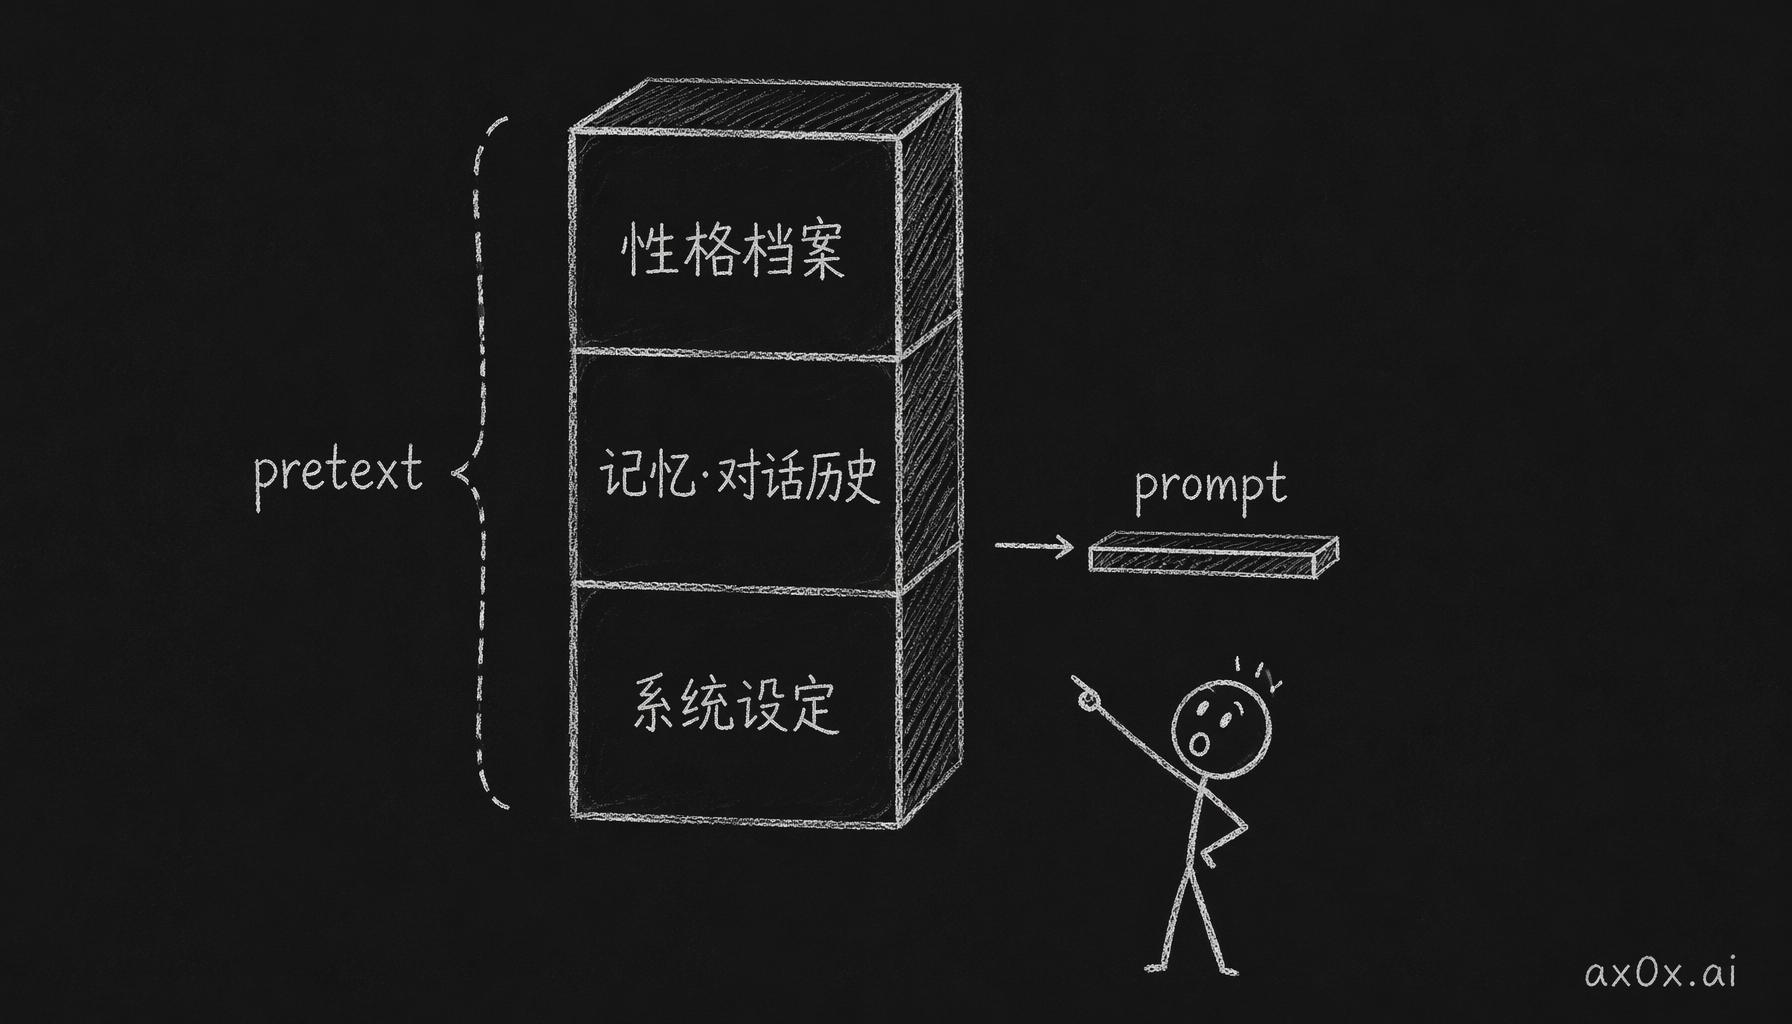 喂给模型的输入里,prompt 只占一小截,性格档案、记忆、对话历史这些 pretext 才是大头。
一个 A/B 测试
我拿 Clawd 的记忆系统做了个 A/B 测试,具体是这样的:
- A 组:pretext 按「长期记忆 → 短期记忆 → 对话历史」的顺序排。
- B 组:pretext 按「性格档案 → 对话历史 → 长期记忆 → 相关片段」排。
然后让同一个用户说「我好累」。A 组的回复偏回忆,会说「你昨天也是凌晨一点在写代码」,整个围着记忆转。B 组的回复偏性格反应,直接来一句「又在赶 deadline 啊笨蛋」,先把角色摆在前头。
这个实验里模型和 prompt 都没动过,只是把 pretext 的结构和顺序换了一下,输出就往两个方向去了。而且差的不是一点语气,是整个回复的重心都不一样了。
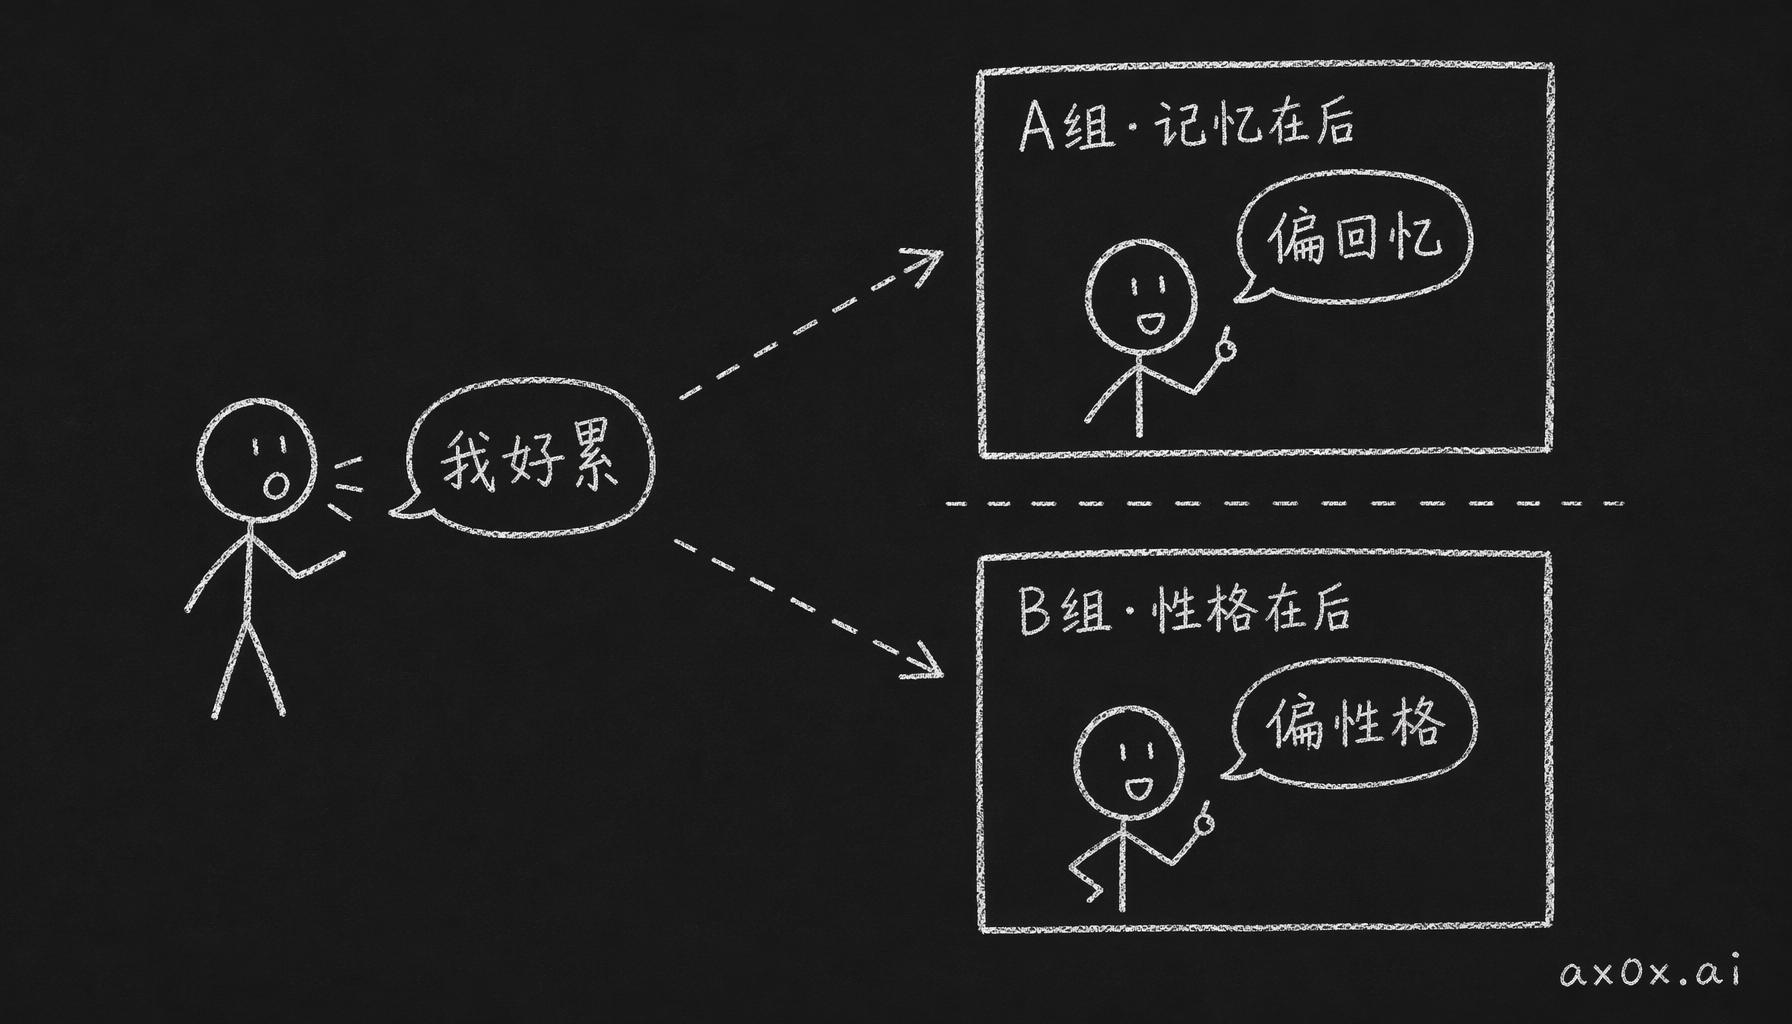 同样一句「我好累」,pretext 排序不同(记忆在后 vs 性格在后),模型回复的重心就走向两个方向。
调 pretext 的三个点
- 顺序。模型的注意力有 recency bias(越靠后的内容权重越高),这个很多人应该都听过。所以最想让模型「记住」的信息要放在最后。但要注意,放最后的应该是「最该影响这一轮回复的」信息,它跟你心里觉得「最重要」的信息经常对不上,因为重要的东西这一轮不一定用得上,这两件事得分开想。
- 格式。同样的信息,你用 JSON 写、用 markdown 写,还是用自然语言写,模型理解起来是不一样的。感觉 JSON 会让它进到处理数据的状态,冷冰冰地做结构化的活,换成散文去写,它就更像是在理解一个人。所以选格式的时候可以顺便想一下,你到底想让它用哪种方式去想这件事,再决定怎么写。
- 不给什么。这个也很关键,我甚至觉得跟给什么一样关键。Clawd 的 pretext 里故意没放「当前任务」这种描述,「请作为一个友好的 AI 助手」这句也没有,因为我们就是不想让它进到助手模式里去。
大家现在管这个叫 context engineering
大家现在也慢慢意识到了,光靠 prompt,能优化的地方已经不多了。真正拉开差距的,是你怎么搭模型每一轮实际看到的那一整份输入,哪些东西放进去,顺序怎么摆,还有哪些故意不给它看。行业里现在管这个方向叫 context engineering,也是因为这个。
pretext 工程干的就是这件事。反正我的结论是,同样的精力花在组织 context 上,回报要大不少。你要是也在搭这种带记忆、带人格的系统,可以先把 pretext 的顺序摆一摆试试,很多时候比接着抠 prompt 管用。