从珠宝扩到七个品类,改的只有 prompt 层
 七品类统一内容生成管线
上一篇讲了识川是怎么起步的。一开始它是个珠宝专用的 MVP,六个编辑级模板,pipeline 是 Gemini 先分析再生成,一天就部署上线了。商家传一张产品照,就能拿到六张风格图加文案,99 块。
跑是能跑了,但当时最早提出「做云佩戴」的那个朋友看了一圈,问了一句:「为什么有的不做全链路呢,infra 不通用吗?」
我之前大概是这么想的,珠宝的 prompt 已经打磨好了,食品的还很粗糙,那就先给食品少开几个功能,等 prompt 成熟了再加上去。她的意思是不用这么搞,pipeline 是一样的,模板也是一样的,换个词就行了。我想了一下,确实是她说得对。后来整个产品方向,基本就是被这一句话改掉的。
先把模板系统重构成 7 个品类
具体做法是把模板系统重构成 7 个品类,珠宝、美妆、时尚、食品、家居、数码/虚拟产品、通用。每个品类都走同一套 6 模板的 pipeline,变的只有 prompt 层。
重构的时候,这 6 个模板本身也重新捋了一遍。珠宝 MVP 里这 6 个模板都是用摄影术语起的名,Hero(主图)、Constellation(星图)、Color DNA(色彩基因)、Craft Detail(工艺微距)、Lifestyle(场景)、Size Reference(尺寸参考)。放在珠宝上完全说得通,但换到食品上就不对了。「宝石星图」是什么意思?「尺寸参考」放个硬币?
捋下来发现,这 6 个槽位跟摄影技法其实没什么关系,它们是说服消费者的 6 个角度:
| 槽位 | 说服角度 | 珠宝 | 食品 | 虚拟产品 |
|---|---|---|---|---|
| 1 | 第一印象 | 棚拍主图 | 摆盘美照 | 课程封面 |
| 2 | 专业拆解 | 宝石星图 | 食材解构 | 课纲结构 |
| 3 | 视觉识别 | 色彩基因 | 制作步骤 | 品牌情绪板 |
| 4 | 品质证明 | 工艺微距 | 质感特写 | 学员成果展示 |
| 5 | 生活场景 | 佩戴场景 | 餐桌/分享 | 学习场景 |
| 6 | 决策信息 | 硬币比尺寸 | 营养/份量 | 价格对比 |
举两个例子。食品的「色彩基因」变成了制作步骤,槽位没变,目的也没变(都是展示产品背后的过程),只是画面整个换了一套。虚拟产品的「尺寸参考」变成了价格对比卡,也是同一个槽位、同一个目的(给买家决策信息),只不过虚拟产品连实物都没有。
架构上保持得比较干净,就一个 TemplateRegistry,按品类加槽位找到对应的 prompt 函数。加一个新品类,就是写 6 个 prompt 函数再注册一下,pipeline、流式、存储、UI 全都不用动。变的只有 prompt。
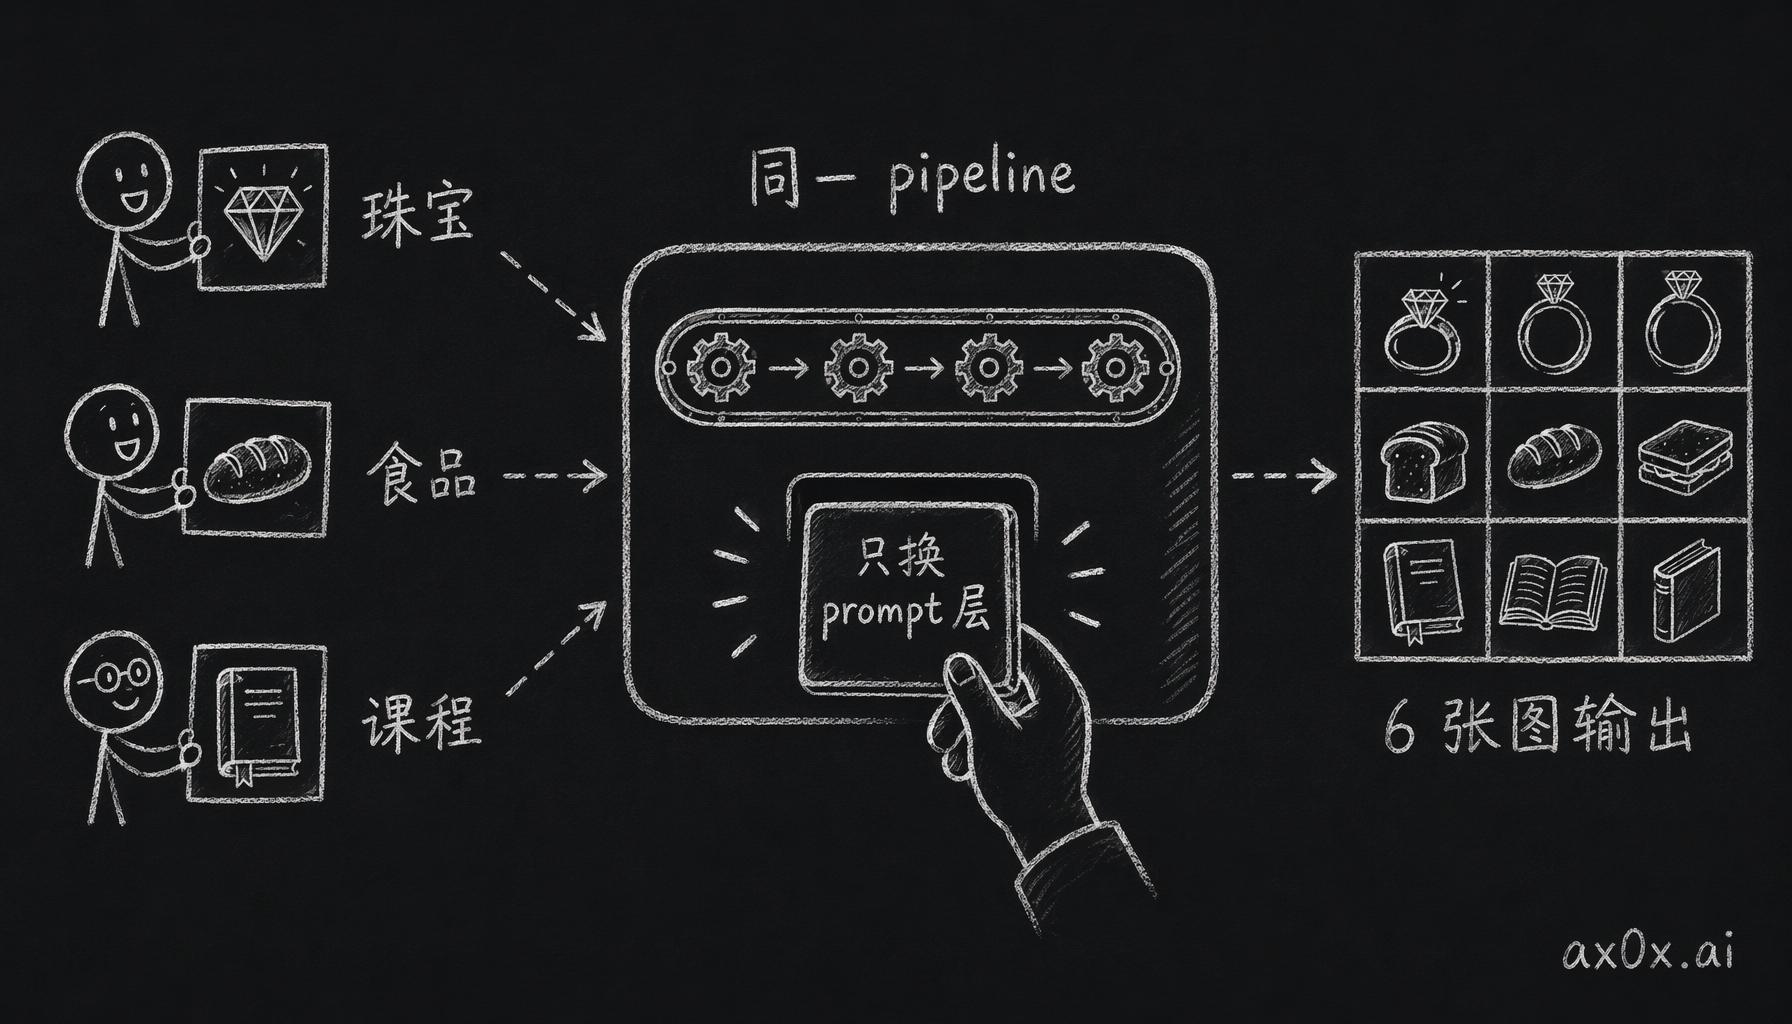 同一套 pipeline 不动,加新品类只换 prompt 层,就能从一份输入产出 6 张图
然后是小红书文字卡
做这块之前研究了一堆卖货效果好的小红书帖子,发现 9 图轮播里通常只有 3-4 张是产品图,另外 5-6 张是穿插在中间的文字卡,有卖点总结、成分指南、尺码规格、FAQ,还有一张带钩子标题的封面。
这块现在基本没人做,竞品的精力全放在 AI 生图上。但你去翻卖得好的帖子就会发现,轮播的转化主要是这些文字卡在扛,这算是 AI 内容工具最大的一个盲区。
渲染管线是用 Satori 搭的,流程大概是:
- React JSX 定义卡片布局(标题、要点、图标、品牌色)
- Satori 把 JSX 转成 SVG,纯服务端,不需要浏览器
- Sharp 把 SVG 转成精确尺寸的 PNG
一共五种卡片:封面卡(钩子标题 + 产品图)、卖点卡(3-5 个核心优势)、指南卡(成分表或使用方法)、规格卡(尺寸/材质/保养)、FAQ 卡(3 个常见问题和回答)。
比较妙的是,这套卡片的 AI 成本是零。因为分析那一步本来就要调 Gemini,卖点、材质、保养说明、规格这些数据早就提取出来了。卡片只是把这些结构化数据按版式排出来,纯套模板的活,不用再多调一次模型。所以一套完整的小红书 9 图(4 张 AI 产品图加 5 张文字卡)里,文字卡那部分等于是分析步骤白送的,整套的生成成本低到可以忽略。
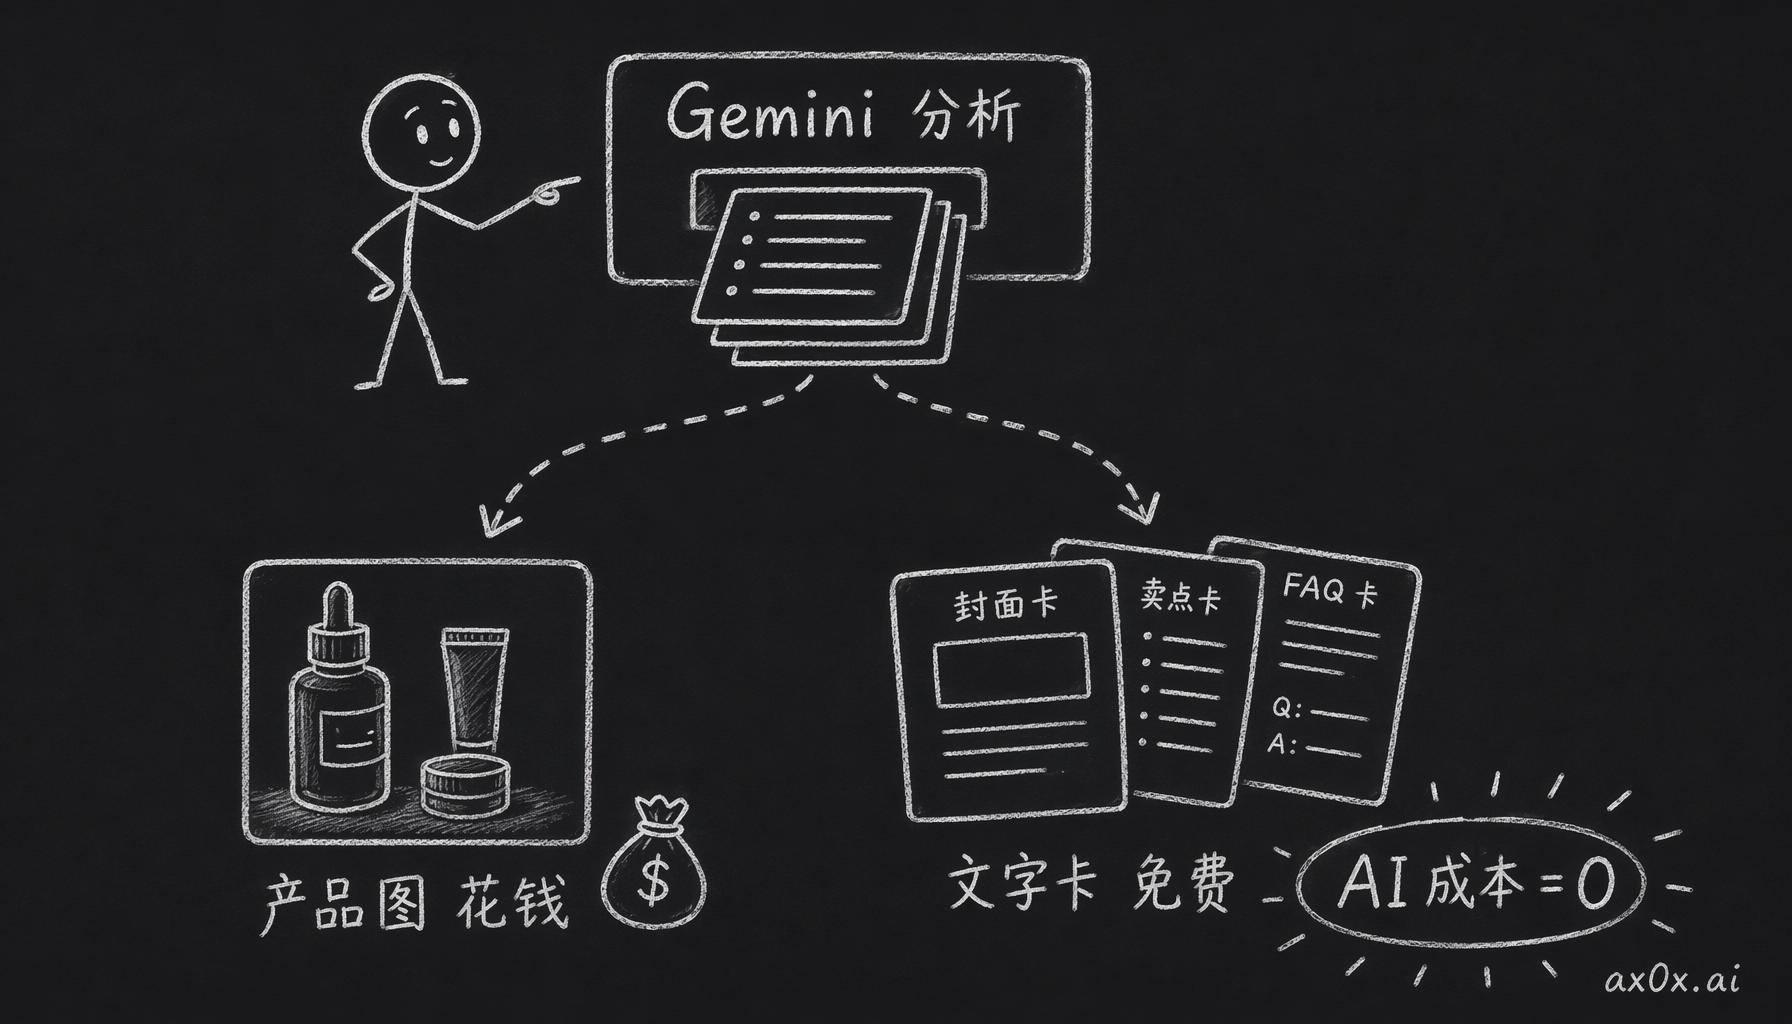 同一次 Gemini 分析调用的结构化输出同时喂给要花钱的产品图和零成本的文字卡,文字卡是分析步骤的免费副产品
平台裁剪
不同平台要不同的比例:
| 平台 | 比例 | 尺寸 |
|---|---|---|
| 小红书 | 3:4 | 1080 x 1440 |
| 抖音 | 9:16 | 1080 x 1920 |
| 淘宝 | 1:1 | 1080 x 1080 |
| 通用 | 4:3 | 1440 x 1080 |
之前商家生成完图还得自己去裁,现在只要在下拉框里选个平台,Sharp 就会把所有输出,包括 AI 图和文字卡,自动裁成对应的比例。实现上很简单,就是 Sharp 的 resize 加 extract,按重心裁,但用起来差别很大。一个同时做小红书和淘宝的商家,生成一次就能直接拿到两套图。
视频放在浏览器里做
轮播图有了,下一步自然就是视频。抖音和小红书上,产品短视频越来越重要,但大多数商家不会剪辑。
服务端渲染的方案(云端 FFmpeg、Remotion Lambda 这类)都考虑过,最后全否掉了。主要是成本,复杂度也是个问题,反正 MVP 阶段撑不起这种架构。所以最后是全推到了客户端:
预览用 Remotion Player 直接在浏览器里渲染视频序列,封面卡 → AI 图片 → 卖点卡,带 Ken Burns 推拉和交叉淡入淡出。其实就是一个 React 组件在播已经生成好的图片,服务端零成本。
导出用 FFmpeg.wasm 在浏览器里直接编码 MP4。用户点「导出视频」,编码就在他自己的浏览器里跑,跑完下载文件。没有渲染农场,没有队列,服务端一分钱成本都没有。
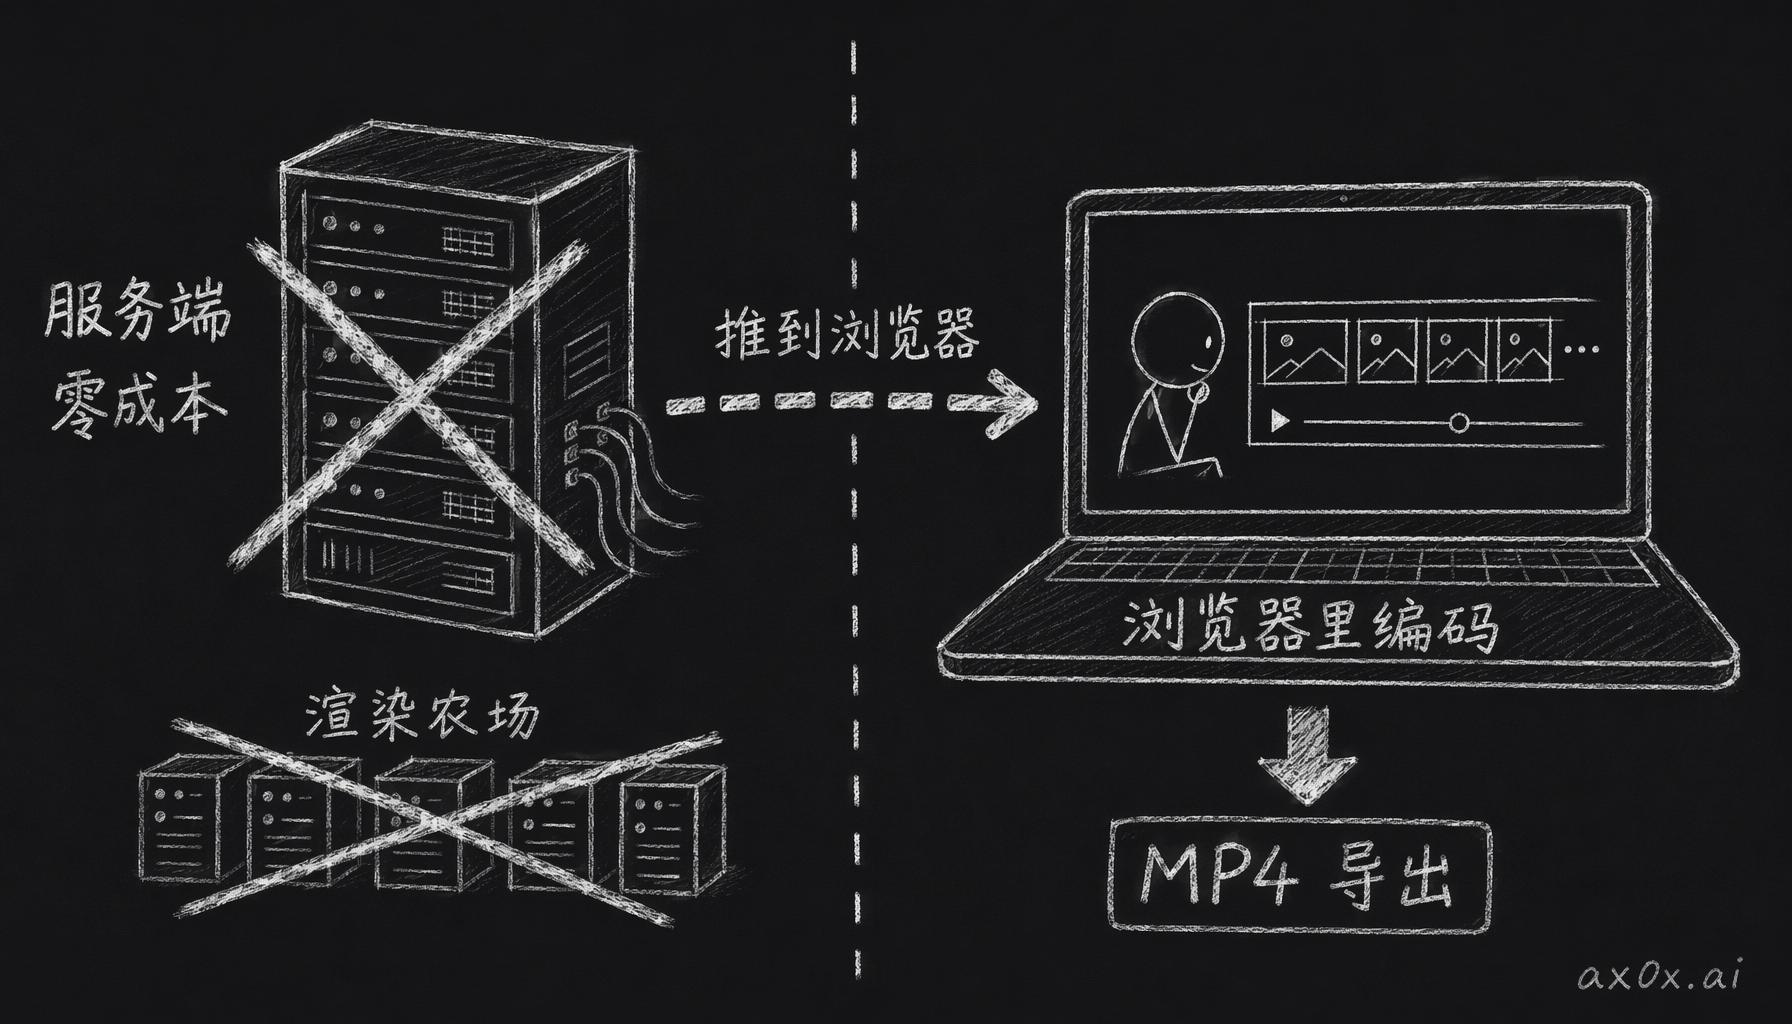 把视频预览和编码全推到用户浏览器里跑,绕开服务端渲染农场,服务端零成本
视频序列按抖音/小红书的惯用结构排:
- 封面卡 + 钩子标题(1.5 秒)
- 产品主图(2 秒)
- 材质/食材拆解(2 秒)
- 细节特写(1.5 秒)
- 场景图(2 秒)
- 卖点卡(2 秒)
- 结尾卡 + CTA(1.5 秒)
加起来 13 秒左右,放在短视频平台上刚好。FFmpeg.wasm 有个坑,后面讲 audit 的时候再说。
拿一个真包测了一遍
品类引擎好不好使,得拿一个真实的时尚单品跑一遍才知道。选的是 Longchamp Le Pliage,这个包材质混搭(尼龙包身、皮革翻盖、金属五金),品牌辨识度强,价位中端。
说实话,我之前有点担心 Constellation 这个模板,「宝石标本博物馆陈列」这种概念怎么套到一个包上?结果 Gemini 对时尚品类的「材质星图」有自己的理解。它把 3 种材质(尼龙面料、牛皮、黄铜五金)分出来,每种生成一个近距离的质感色块,在深色背景上排成一块材质板,看着就像设计工作室的面料样卡。
从珠宝那边带过来的编辑美学,也就是那种博物馆画册的感觉,搬到时尚品类上比我想的要自然。同一套 prompt 结构,放在珠宝上出来的是宝石星图,放在时尚上出来的是材质板。AI 泛化的是概念本身(把材质拆开,当成标本来摆),而不是某个具体品类。
Color DNA 也转得很顺,宝石色系的水彩晕染,换成了从包的藏青尼龙、干邑皮革、金色五金里提取出来的色块。概念没换,只是换了个产品,取出来的调色盘就不一样了。到这里,时尚品类算是验证通过了。
没有实物的品类怎么办
其他所有品类都默认你手上有一张产品照。但课程、电子书、软件、模板这些东西没有实物,也就根本没有照片。
所以「数码/虚拟」品类走的是另一条路。它不分析照片,直接收文字描述,比如「Python 数据分析课程,40 课时,涵盖 pandas/numpy/matplotlib,目标群体是商业分析师」。只给文字,pipeline 照样能生成六个槽位:
- Hero:代表课程主题的抽象概念图(数据流穿过神经网络之类)
- Constellation:课纲结构可视化思维导图
- Color DNA:品牌情绪板 + 建议配色
- Craft Detail:功能亮点 + 图标化展示
- Lifestyle:理想学习场景(现代工位 + 课程素材)
- Size Reference:价格对比卡(这门课 vs. 训练营 vs. 学位)
整个过程不用照片。分析那一步先从文字生成一份详细的产品画像,生成那一步再根据画像出视觉内容。
虚拟品类的视觉风格是故意做得比实物品类更抽象、更有创意的。珠宝的星图很精确,是具体的宝石按具体的方式排好;课程的星图偏概念,是一组组主题用流线连起来。给了 Gemini 更多发挥空间以后,出来的东西确实更多样,偶尔也更惊艳。
从 demo 到生意
7 个品类上线以后,下一步就是把它从 demo 变成能算账的生意。为这个做了几件事。
token 追踪
MVP 阶段估 Gemini 成本,用的是每次调用的平均值,很粗,不够准。Gemini 的 usageMetadata 会返回每次请求实际的输入/输出 token 数,所以就改成按实际的记,每次 API 调用都记下真实用了多少 token,再挂到触发它的用户和那套图上。
这个挺重要,因为不同品类的 prompt 长度差得很多。珠宝的分析 prompt 带着材质和灯光的指令,大概 2,000 tokens,食品的大概 1,200。用平均值算,食品会被高估,珠宝会被低估。
额度系统
用户买额度,每次生成按实际成本扣(向上取整到最近的额度单位)。余额存在 Upstash Redis 里,扣的时候用原子递减,保证不会重复扣费。
管理后台
成本看板看四个东西:每日 API 花费(总量 + 分品类)、每用户累计成本、分品类的平均每套成本、利润分析(每套营收减 API 成本)。
数字跑出来,上一篇的定价假设是对的。99 元一套,API 成本只占很小一部分,毛利非常健康。而且文字卡不花钱,混着算下来,成本比纯 AI 图的套装还要低。
单位经济模型
| 项目 | 说明 |
|---|---|
| 每套营收 | 99 元 |
| AI 图片生成成本 | 营收的很小一部分 |
| 文字卡生成成本 | 无额外 AI 开销(纯服务端渲染) |
| 平台裁剪成本 | 无额外 AI 开销(服务端图片处理) |
| 视频生成成本 | 无额外 AI 开销(客户端编码) |
| 毛利率 | 非常健康 |
| 替代方案价值 | 1,100-3,100 元 |
| 价格比 | 1/10 到 1/30 |
替代方案要 1,100 到 3,100 元,识川的价格是它的十分之一到三十分之一,API 成本又只占营收的零头。价格便宜到商家不用犹豫,毛利也高到能撑住增长。
上线前跑了一遍 audit
宣布 v2 完成之前,把系统整个 audit 了一遍,扫出来 22 个问题,其中 8 个是严重的。
安全这边修了三个:
- 邀请码生成从
Math.random()换成crypto.randomInt()。Math.random()不是密码学安全的,邀请码能被猜出来,别人就能免费用。 - 所有 API 路由加上鉴权校验。之前好几个生成端点没有 auth 检查,任何人拿到 URL 就能烧 Gemini key。
- 堵上了图片上传流程里的 SSRF 漏洞。原来的代码做「链接上传」时什么 URL 都收,也不校验目标地址,攻击者可以拿识川当代理去扫内网。
可靠性这边也是三个:
- 生成失败退额度。之前 Gemini 中途报错的话,用户的额度已经扣掉了,现在加了自动退回的逻辑。
- FFmpeg.wasm 的竞态条件,就是前面说的那个坑。视频导出的流程是先启动 FFmpeg,再开始写帧,然后调
ffmpeg.run()。但写帧是异步的,帧还没写完run()就开跑了,所以在慢一点的机器上偶尔会导出坏掉的视频。修法是等所有帧都await写完了再跑编码。 - Zustand store 的闭包过期 bug。有几个 React 回调抓的是渲染那一刻的 store 值,没在回调里用
useStore.getState()去拿最新的。这是很经典的 React 坑,而且真出了 bug,生成进度条卡在 33%,其实后台还在接着生成。
代码质量也修了一批。有几个 Zustand store 的 action 直接 mutate 了 state,改成了展开再替换的写法。只做珠宝那会儿留下的死代码,还有没走品类注册表、直接写死的 prompt 字符串,都清掉了。Remotion Player 补上了 error boundary,视频预览崩了,不该把整个页面一起带崩。
22 个问题全部修掉了。代码库从「正常使用没问题」变成了「想搞坏都难」。
回头看
整个过程里最要紧的,就是那句「为什么不是全品类全链路」。它让我看到自己掉进了一个思维陷阱,我把每个品类都当成要定制功能的特例,没意识到结构是通用的,变的只有文字。后来我做 AI 产品基本都照这个思路来,pipeline 不动,要适配新品类就去改 prompt。反正在 infra 这层各品类没什么区别,区别都在 prompt 里。
另一个收获是文字卡,最有价值的功能也可以一点 AI 成本都不花。这套卡就是在服务端用 React 渲染,一次模型都不用调,边际成本是零,偏偏在小红书上最能带转化。视频也是一样的思路,能推到客户端的计算就推到客户端,在浏览器里跑 FFmpeg.wasm,边际成本是零,也不用搭基础设施。
v2 以后,识川从「珠宝内容工具」变成了「电商内容平台」。底下还是同一套 Gemini pipeline,同一套 ÉLAN 基因,但覆盖面从一个品类扩到了七个,从只有图片到图片加卡片加视频,从一个平台到四个。上一篇那个一天上线的珠宝 MVP,就这么长成了现在这个样子。
This post is also available in English.