
一套 prompt 通吃三个品类,是我想多了
 三个品类各自的模板集
上一篇讲了那套「6 个槽位通吃 7 个品类」的设计,就是一套 pipeline,所有品类都出同样的 6 张图。这套东西跑了两周,被一个 bug 打回来了。有个测试用户传了件牛仔外套,选了「材质拆解」,出来的图是一块白色 slate 底板,上面飘着六颗切面宝石。牛仔外套拆出六颗宝石,挺离谱的。
这篇讲我怎么排查这个问题,为什么最后把服饰和美妆的模板各自推倒重来,还有中间几个判断大概是怎么做的。
先排查:问题出在哪一层
先说 Part 2 那个抽象本身。6 个槽位对应 6 个说服角度,分别是第一印象、专业拆解、视觉识别、品质证明、生活场景、决策信息。这个判断我到现在还认,它没错。
问题出在这个抽象只做到了标签那一层。第二个槽位,珠宝叫「宝石星图」,服饰叫「材质拆解」,美妆叫「成分拆解」,可这三个中文标签指向的其实是同一个 prompt 函数,prompt 里写的还是 "dark slate 上的珠宝样本星图"。所以在类型系统眼里,每个槽位都和品类无关,但 prompt 里写死的视觉语言从头到尾都是珠宝的。标签是翻过来了,底下那层根本没动。
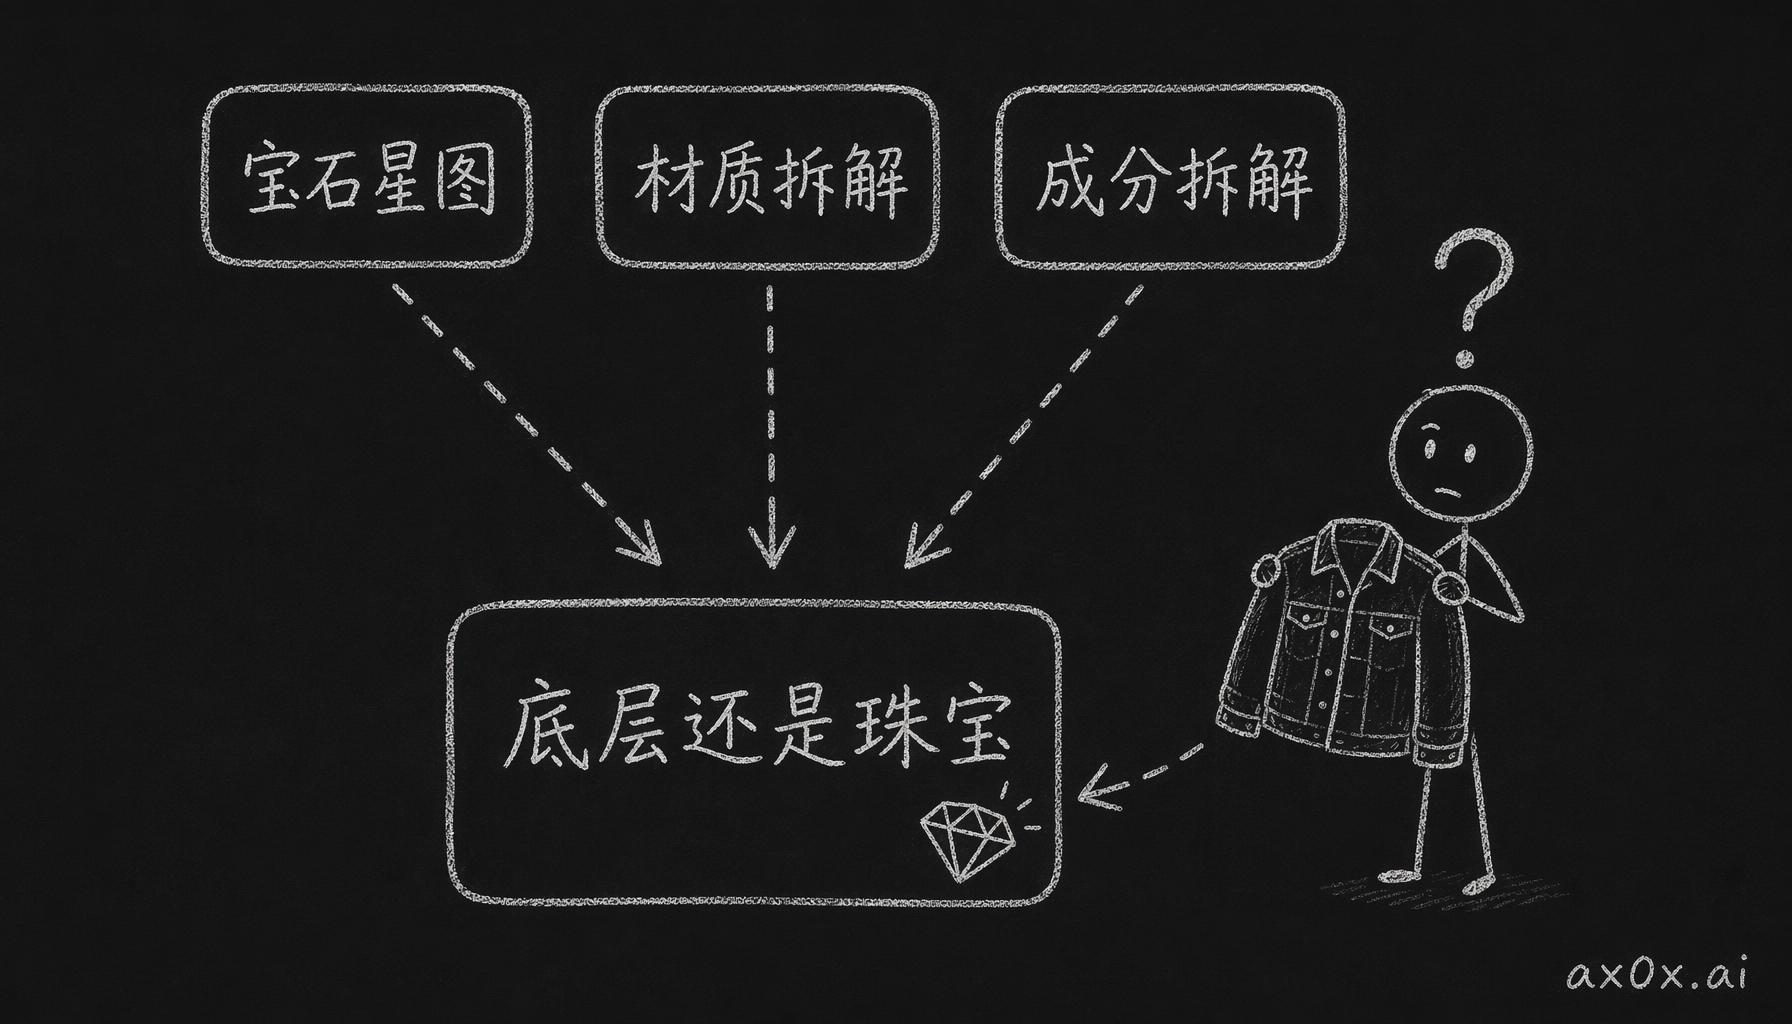 抽象只翻译了标签层——三个不同标签底下指向的还是同一个珠宝 prompt,所以牛仔外套拆出了宝石
这种 bug 挺阴的。类型检查是绿的,eslint 是绿的,UI 上的标签也是对的,非得用户真传一张图进来,看一眼生成的结果,才发现不对。整条链路上没有哪一环能自动把它报出来。
打补丁的方案为什么不够
排查完,我一开始想打补丁,每个 prompt 里加三个品类的分支就完了。后来发现不够,问题比标签错了还要深一层。
穿搭在小红书上的第一个槽位根本不是棚拍图,是 OOTD,就是全身人像占了屏幕 60% 以上的那种。千瓜、jizhil、ebrun 三个行业信源都把 OOTD 算作服饰商家的主力内容,大概占 60-70%。美妆的第一个槽位是试色拼图,五合一那种,品牌图加上唇、掌、指、勺,Colorkey 这类彩妆品牌靠的就是试色内容,占了大约 45%。再比如尺寸参考,珠宝拿硬币来比,穿搭是在模特图上叠身高体重,比如「163cm/48kg 穿 M,微胖建议 L」,完全是两套东西。
所以珠宝、穿搭、美妆在小红书上各有各的视觉语法,或者说各有各的说服方式,在 prompt 里换个标签、加个 if 分支是搞不定的。Part 2 那句「6 个槽位一套 pipeline」让我觉得挺安全,可实际跑出来的,是珠宝那 6 张图套着三个不同的标签在出货。
要不要分阶段上线
原计划是分两步走。Phase 1 保留 6 个槽位,给最弱的 4 个 prompt(星图、工艺细节、尺寸参考、hero)加品类分支,一天就能搞完。Phase 2 给每个品类单独做 6 个模板,大概要一周,哪些模板该进该出,等用户数据来定。
先做 Phase 1 的理由听着很工程师,先发个小的、安全的,等数据回来再大改。但这个产品现在没有用户,不会有数据回来。没数据的时候,Phase 1 和 Phase 2 都是拍脑袋,猜出来的东西一样没谱。区别只在于 Phase 1 做完的 prompt 到了 Phase 2 要全部扔掉,因为给旧的 6 个槽位写的品类分支,换成新模板以后一张都留不下来。这等于多做一轮 rework,换来一个「我在小步迭代」的感觉。所以直接做 Phase 2。
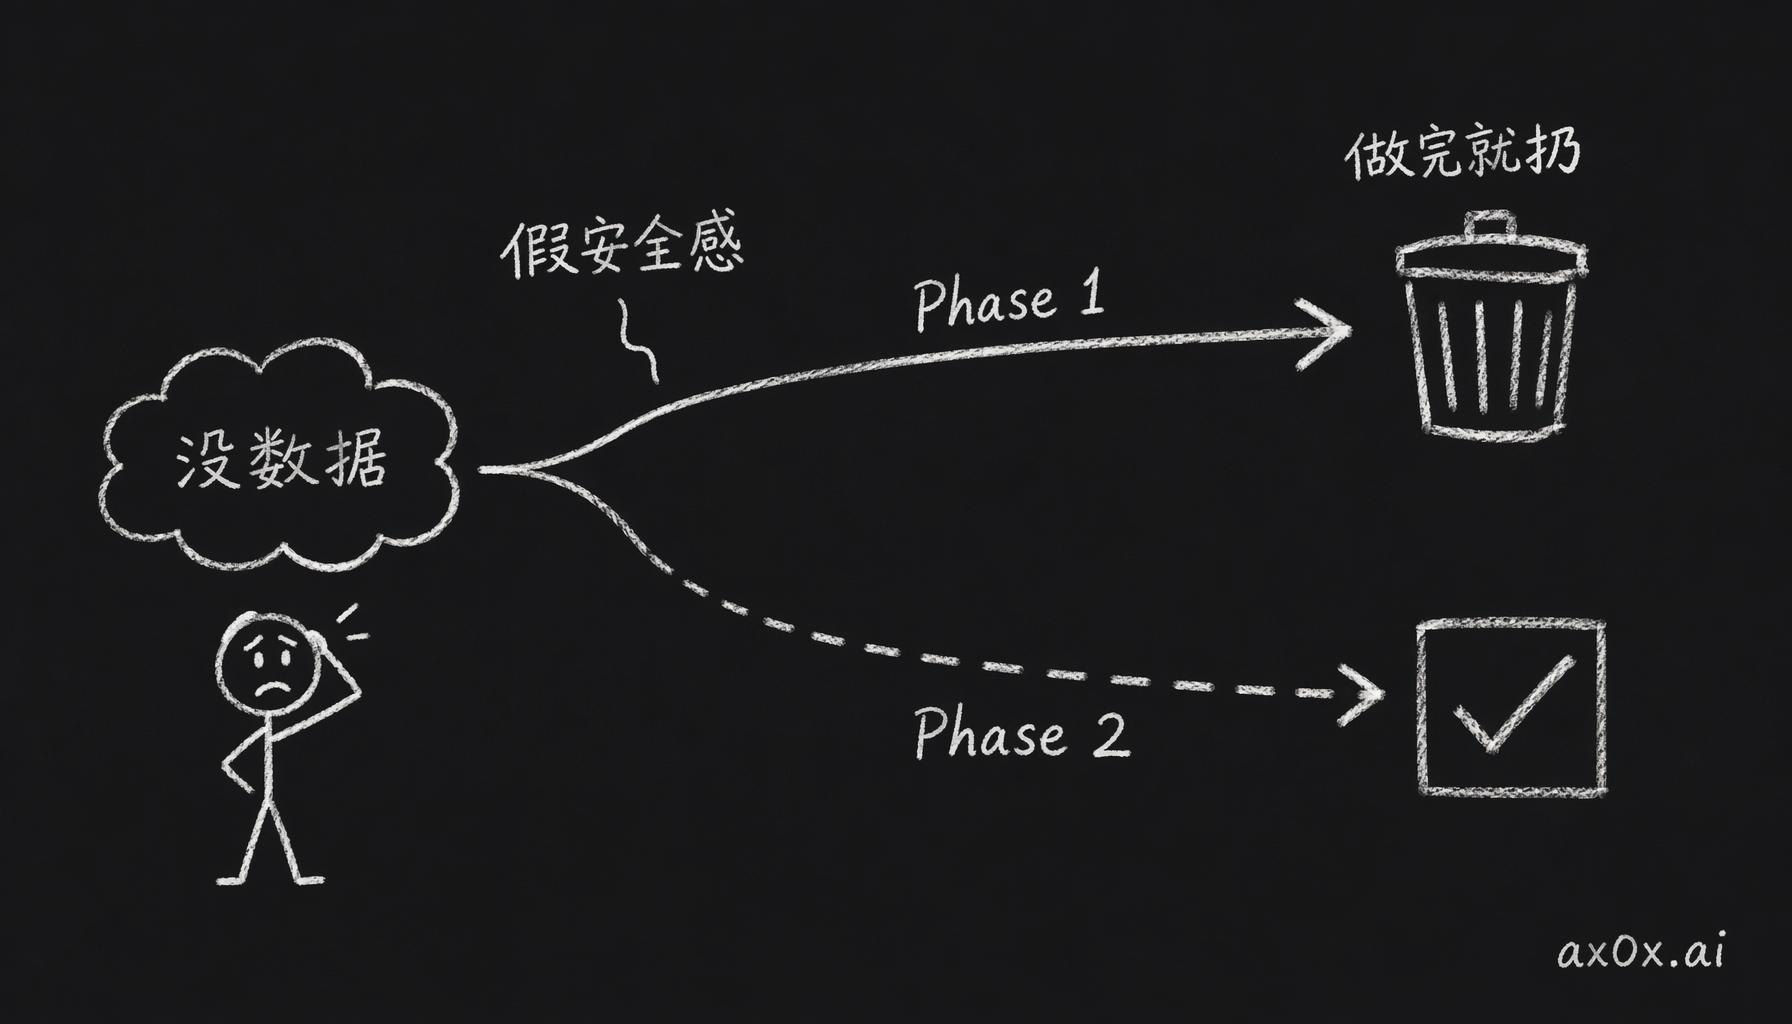 没有用户时分阶段上线是假安全感——Phase 1 和 Phase 2 的猜测质量一样,Phase 1 做完的还全部扔掉
没用户,就让 agent 去挖公开资料
新模板具体该长什么样,没有用户数据,就只能去公开研报和案例里挖。我开了 3 个 agent 并行去查:
- 第一个专盯 fashion,查千瓜、jizhil、ebrun、niaogebiji 的服饰 XHS 研报
- 第二个专盯 beauty,查数英、SocialBeta、品牌星球的美妆和护肤拆解
- 第三个专门看 10 个头部品牌的 XHS 账号做 post-mortem,李宁、花西子、HFP、Colorkey、薇诺娜这些
我还加了一条硬约束,几个 agent 查的话题要有 50% 以上是重合的。因为 agent 会编数据,一个 agent 单独报出来的数字我不敢直接用,得有第二个 agent 独立查到同一个数字才算数,所以交叉验证这一步省不掉。
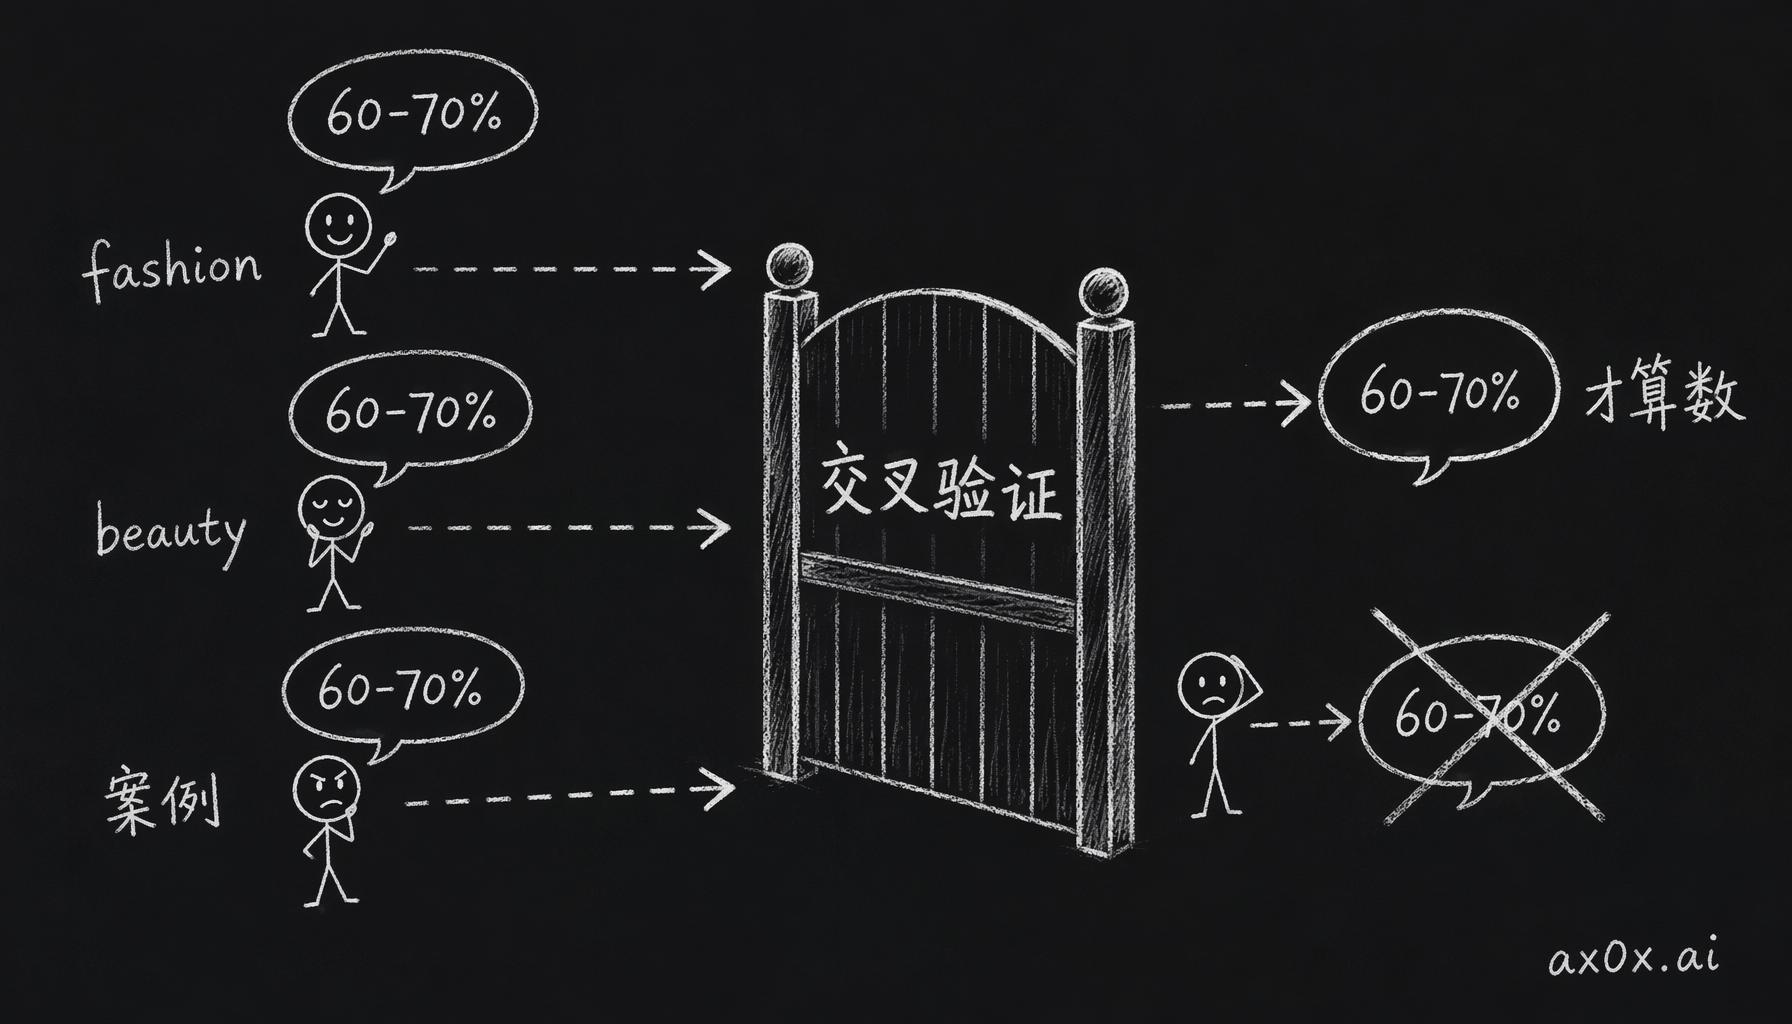 agent 会编数据——一个 agent 单独报的数字不算,要有第二个 agent 独立命中同一个数字才通过交叉验证
最后过了交叉验证、站得住的数据有这么几个:
- OOTD 占 XHS 服饰商家内容的 60-70%,千瓜、jizhil、ebrun 各自都查到了
- 一衣多搭的转发率高 50%。jizhil 有个案例,刘小被儿靠「10 套搭配 × 1 件牛仔外套」做到了 220 万粉
- 李宁的火锅羽绒服靠「场景+产品+人物」的组合,在 XHS 双十一卖了 30 万件、1 亿 GMV
- 护肤 routine 视频笔记的互动占比是 51.32%,数据来自千瓜 2025 年报
- swatch 拼图是彩妆在 XHS 上的标配,五合一,品牌+唇+掌+指+勺,Colorkey 就是靠这一种形式跑出来的
10 个品牌的 post-mortem 还推翻了我一个直觉。头部商家其实很少发纯 hero 棚拍图,爆款都是「产品+人+场景」的组合。所以 fashion 单独的 hero 槽直接砍掉了。
最后定下来的三套模板
服饰 6 张:OOTD 试穿、一衣多搭(四宫格)、场景化穿搭、平铺+上身图、前后对比(「显高 5cm」这种)、尺码建议(模特图叠字)。
美妆 6 张:产品主图、试色拼图(五合一)、使用前后对比、功效大字报、使用步骤(含 AM/PM)、合集榜单(TOP N / 红黑榜)。
珠宝 6 张:保持 Part 2 的原版不动。
基础设施还是共享的,三个品类的 6 张图走同一条 pipeline,API 调用、图片存储、UI 渲染这些都没动,变的只有 prompt 这一层的视觉语法。
砍掉了哪些候选
这一轮最花时间的不是挑哪 6 个,是砍哪些。有一堆候选听着都挺合理,最后都砍了:
- 版型/做工微距:找不到头部商家的爆款证据,只有高端设计师品牌偶尔用
- 身高矩阵(155/160/165/170 同款对比):商家没有请好几个模特的预算,「小个子专精」是博主的 niche,做不成商家模板
- moodboard 穿搭灵感拼贴:这是博主给自己立人设用的,商家卖货用不上,而且「多套组合」这个功能,一衣多搭已经覆盖了
- 成分三栏 infographic:AI 画分子式容易糊,而且像 HFP 这种拿成分当卖点的品牌,实际也是做单页大字报,所以并进了功效大字报
- AM/PM 独立 routine:它就是 routine 的一种,犯不着为它单开一个槽位
- 代言人东方美学大片:花西子那种 niche 高端玩法,普通商家抄不来
这些候选单拿出来看,每个都挺合理。所以我最后定了一条规则来砍,一个模板想占一个槽位,研究里至少得找到一个头部商家的爆款案例当证据,找不到就不进。「每个品类严格 6 个」这条硬约束也一直逼着我往下砍,要是放开到 8 个,上面这些大概全都会进去。
已知还没解决的
- 6+6+6 是 3 个 agent 定性推出来的,没有千瓜订阅账号那种一条条帖子的实测。等有了用户,再用 deselect 率加重生成率做 A/B 验证
- 「通用」这个兜底品类现在还是用珠宝那 6 张。文玩、香薰这种和珠宝差不多的小物件没问题,将来要加食品、家居就得改
- 类型检查过了,prompt 的输出也不见得合格。10 个新 prompt 实际的产出还要在本地过一轮 UAT,下一轮再补一个新旧对比的 A/B smoke test
回头看 Part 2
Part 2 把 pipeline 抽象成了「6 个槽位对应 6 个说服角度」。现在回头看,这个抽象放在基础设施那一层是成立的,因为 API 调用、图片存储、UI 渲染、类型系统、计费,在三个品类里都长得一模一样,一份代码就够,实际也确实只写了一份。到了内容那一层就不行了,小红书上服饰、美妆、珠宝各说各的视觉语言,换个标签是跨不过去的,prompt 只能三个品类各写各的。
反正做这个产品到现在,大概每三四周就得推翻一次自己上一轮的判断。下一轮估计也免不了。


