Day 27,一天上线了三个新产品
盘盘猫日记写到第 27 天,撞上了整个项目到目前为止最高产的一天。一天下来 98 个 commit,ai 起名、配对分析、流年运程三个新产品从零写到上线。能跑这么快,不是这一天突然爆发了,主要是前几周做的两个重构,正好在这一天全派上了用场。
 多臂盘盘猫同时开发多个产品的巅峰产出插画
先说这两个重构
15 条流式路由收敛成一个(PR #16)
之前 15 条 API 路由,每条都自己维护一套 ReadableStream 的实现。PR #16 把它们全部迁到了共享的 createAIStreamResponse() 上,改了 24 个文件,加了大概 1,600 行,删了大概 2,000 行,净减 400 行。顺手还加上了几个生命周期钩子,initEvents、onComplete、onError、refundCreditsOnError。
有三条路由确实收不进去,只能留着各自的处理方式。MBTI 聊天用的是累积缓冲区的差量模式,还要把内部的信号标记从用户看得到的文本里剥掉。梦境长篇解析走的是多步生成的协议。每日运势干脆不走流式,直接在服务端缓存。这次迁移加了 36 个测试,@panpanmao/api 现在一共有 173 个测试。
成本日志集中到一处(PR #21)
另一个是成本日志。之前每条流式路由里都有一段一模一样的样板代码,先建一个 cost logger,再用 as never 做类型断言把记录插进去,好绕开 Supabase 的类型限制。PR #21 用 createRouteCostLogger() 把 20 个文件里的这段代码全替掉了,绕类型的写法只留在一个地方,不用再到处复制。改完以后 1,942 个测试全部通过。
两个重构做完,新加一个 ai 功能,每条路由要写的样板代码从大概 80 行降到了 15 行左右。一天能上三个产品,靠的就是这个 80 到 15 的差距。
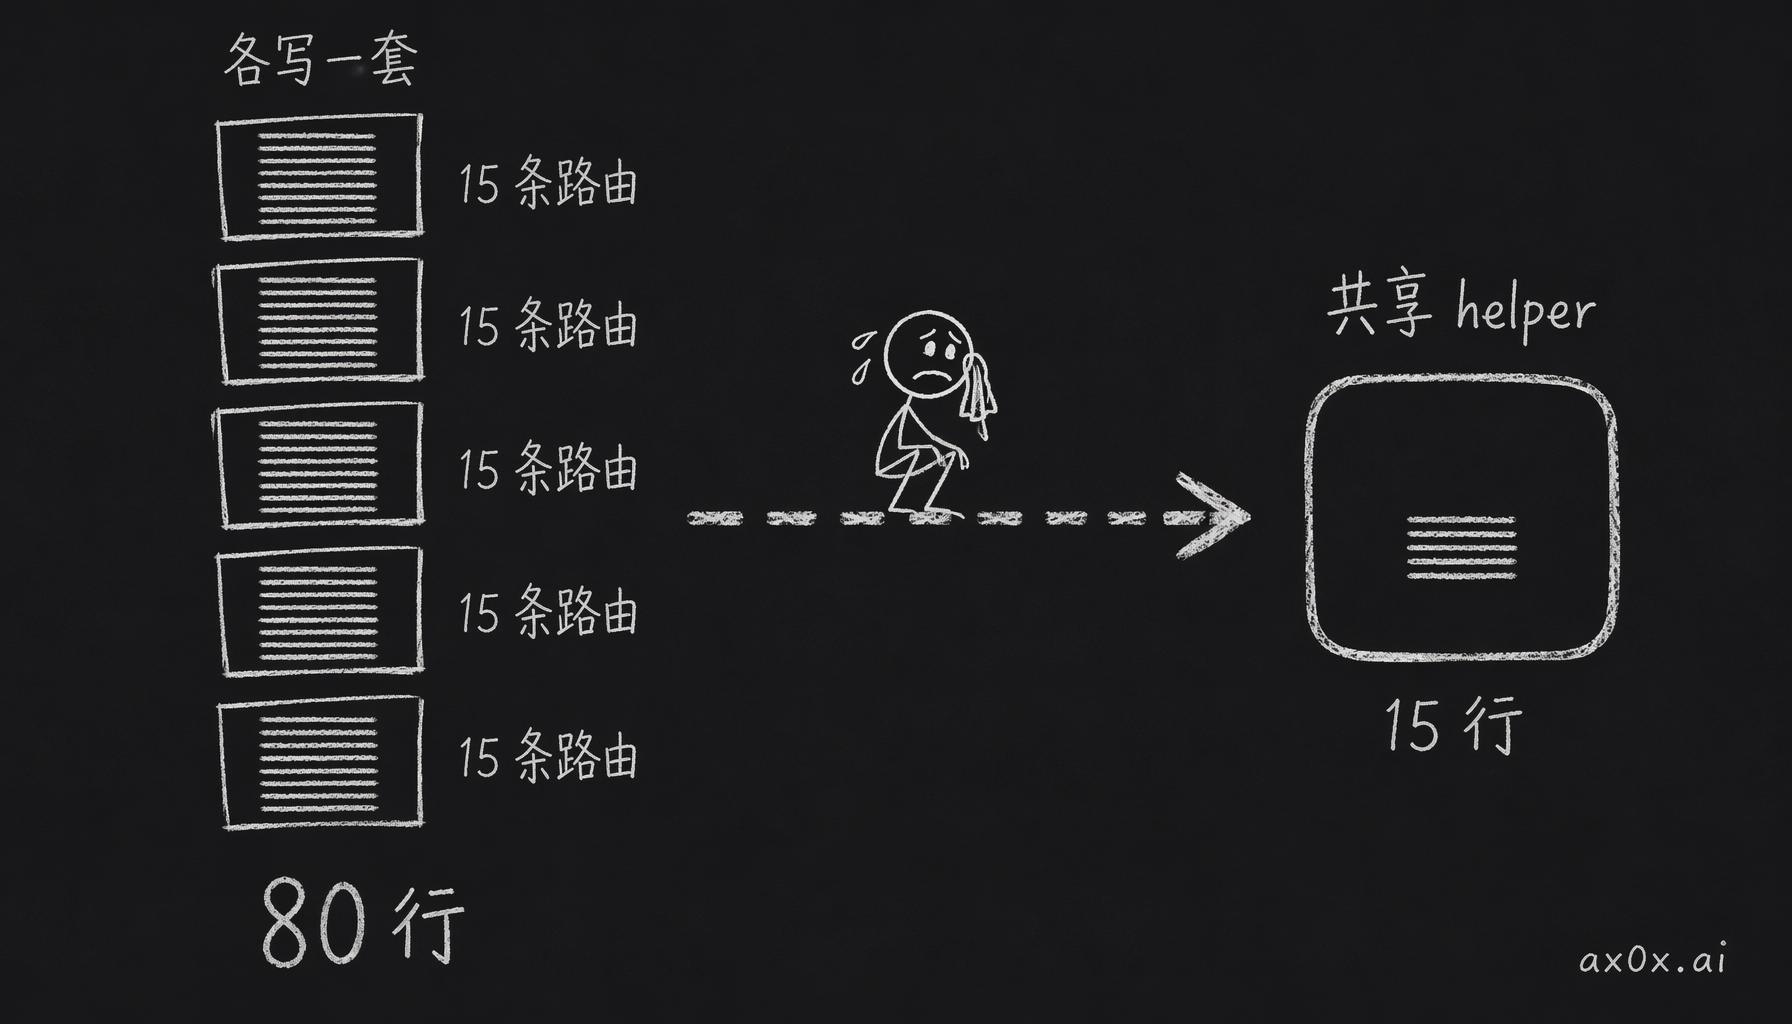 两个重构把 15 条各写一套的流式路由收敛到一个共享 helper,新增功能的样板代码从 80 行降到 15 行
三个新产品
ai 起名,4 个小时从零到上线
中国人给孩子起名挺讲究的。名字要配八字五行,求个平衡,要看笔画数理的吉凶,还得顾着家里的起名规矩。找大师起一次名要 200 到 2000 块。ai 这边是先拿出生数据把五行格局排出来,看哪些元素要加强、要平衡,再去生成名字,让每个字的五行属性、笔画数、音韵、字义都对得上。领域知识包里放的是字-五行映射表、笔画数据库和起名规则。
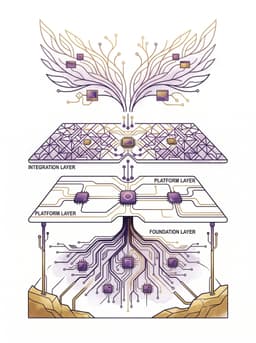
从零到上线大概 4 个小时。这 4 个小时里 ai 写代码其实只是表面,真正省时间的是基础设施。认证、积分、流式传输、错误处理、内容过滤、历史保存,全都直接从共享包里拿。要新写的只有领域知识和 UI,也就是这个产品和别的产品不一样的那部分。
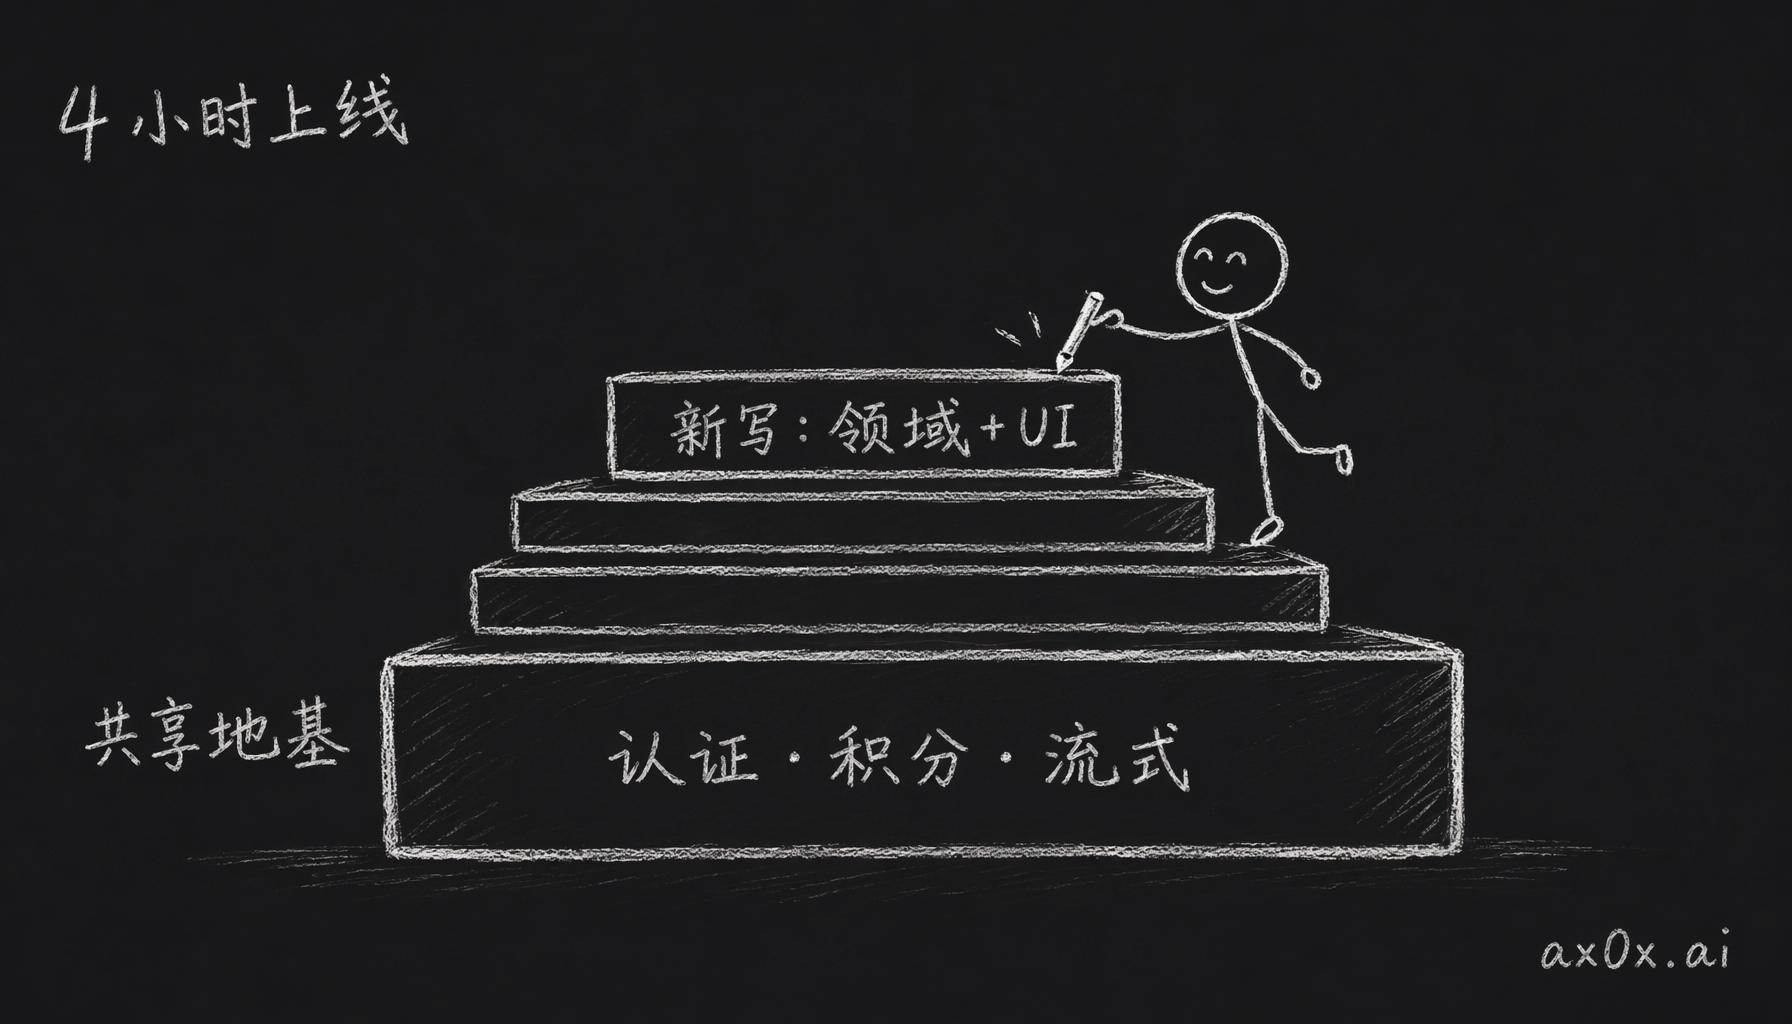 每个新产品只需新写领域知识和 UI 这一薄层,认证积分流式等地基全部复用共享包,所以 4 小时就能上线
配对分析,算命的头号场景
输入两个人的姓名和出生信息,它来分析两人的缘分,给五行相生相克打分,分析日柱和合,再看字这一级的五行怎么互动,结果可以直接分享出去。算命这个市场最大的需求就是感情,所以配对天然就是用得最多的场景。
流年运程,三个里最重的(PR #85)
这个产品新加了一个领域模块 domains/liunian/,里面有计算器(生肖、太岁分析、流年飞星、五行年运)、知识数据包(星曜目录、星曜-年份映射、太岁冲犯规则、生肖性格画像),还有 ai 的提示词模板。一共改了 48 个文件,162 个领域测试都过了。前端做成了渐进式渲染,太岁横幅和流年飞星是纯计算,马上就能显示出来,ai 写的运势内容再走 SSE 一段一段流进来。
后来 PR #96 修了一个挺微妙的 SSE 解析 bug。liunian 的 hook 在主读取循环里,只解析以换行符结尾的完整帧。但最后一帧(chunk 加 done)后面没有换行符,是留在尾部缓冲里到的。结果 hook 把 done 事件丢了,给用户显示了一个网络错误。其实解读早就生成完了,只是最后一帧没被解析到。修法是收尾的时候把 decoder flush 一遍,把尾部缓冲里的 SSE 事件也解析掉。
城市库只有 46 个城市
同一天 PR #34 还修了一个用户报上来的 bug。八字的城市搜索库里只收了 46 个中国主要城市,贵州的用户去搜黔西南、黔东南这样的自治州,找不到自己的出生地。修完以后库里从 46 条扩到了 379 条,全部 333 个地级行政区划都有了,地级市、自治州、盟、地区都算上。每条都带经纬度、所属省份,还有按简称匹配用的别名,另外加了 5 个地理编码的测试。这个 bug 挺典型的,如果测试用户全在北京上海,那永远发现不了。
实际的工作流
翻 git 历史能看到一堆 claude/ 和 codex/ 分支。实际干活的流程已经固定成了六步:
- 我描述产品概念和需求
- claude code 照着已有的
createAIStreamResponse()模式建 API 端点 - 另开一个 session,用共享组件库搭 UI
- 我 review、手动调领域 prompt,然后 merge
- 跑集成测试,注册积分消耗,建 Hub 卡片
- 部署
做到第三个产品,这套流程基本已经是机械操作了。前面几个产品搭得费劲,后面每个都明显轻松得多。
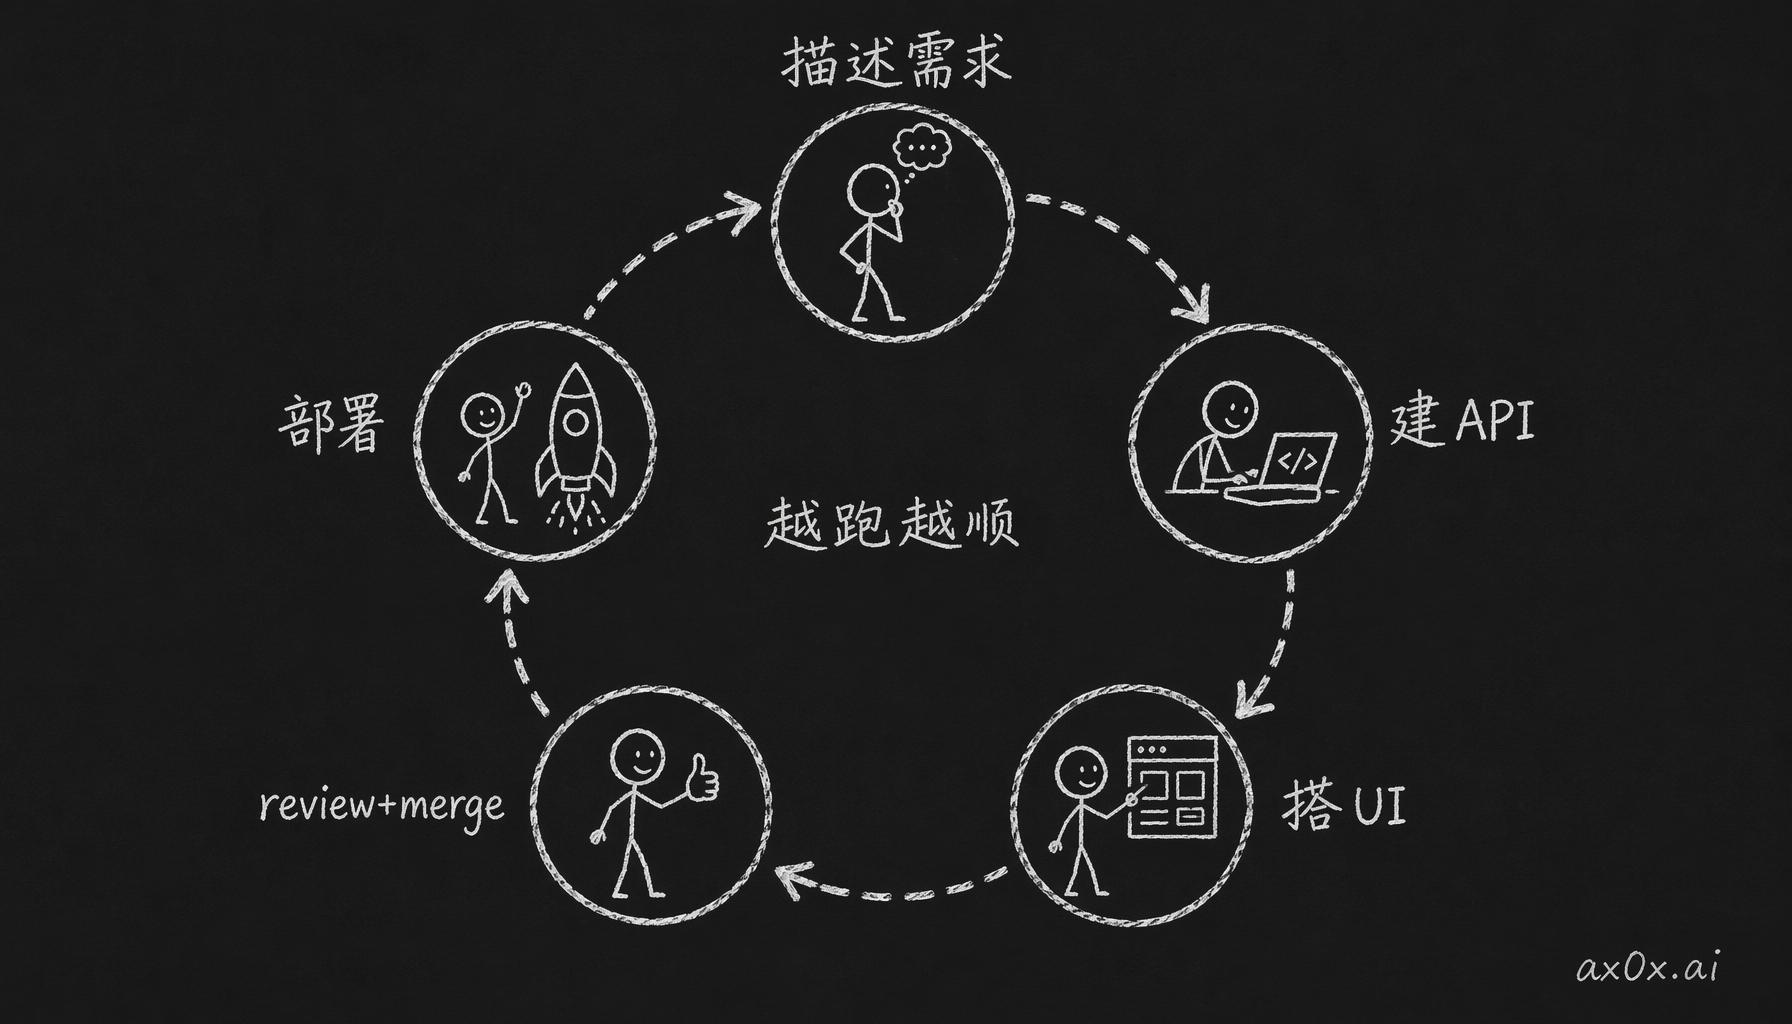 上产品的工作流收敛成固定的机械化循环:描述需求→建 API→搭 UI→review 合并→集成→部署,越跑越顺
保守估计,今天 95% 的代码是 ai 生成的。我干的是做产品决策、review ai 的输出、写领域 prompt、处理集成,实现全是 ai 写的。剩下那 5% 是 prompt、产品判断和集成的胶水,可要是没有这 5%,出来的就只是个 demo,不是产品。
平均 9 分钟一个 commit
98 个 commit 摊在大概 15 个小时里,平均 9 分钟一个。这个节奏肯定撑不了多久。但就算把数字打个折,一天上线三个产品,每个都有完整的业务逻辑、ai 集成、积分经济和数据持久化,这个量还是摆在那儿。而且这个快不是糊出来的,测试一直在跑,用户报的 bug 当天也在修。产品方向到现在攒了 9 个,后面怎么排,到时候再看吧。