盘盘猫做完了,最后两天都在啃基础设施
盘盘猫做到第 29 天,收尾了。系列总结就不单独写了,前六篇日记基本把过程都记完了,这篇就讲最后两天干的活:几块基础设施,一直拖着没动手,最后集中啃掉的。对了,到今天我想查天干是什么,还是得翻资料,29 天了还是没记住。
 盘盘猫坐在代码与产品堆成的山顶,望着夕阳沉思
portal 一渲染,主题就丢了(PR #67)
先说背景。每个应用有自己的 CSS 主题:.theme-hub 是深蓝,.theme-tarot 是神秘紫,.theme-bazi 是传统红,9 个应用 9 套视觉。这套设计被 React 的 portal 搞坏了。
问题出在 createPortal(content, document.body) 上。它会把 DOM 节点直接渲染到 document 根上,等于整个跑到了应用主题 wrapper 的外面。CSS 变量的继承是顺着 DOM 树走的,不管你 React 组件树长什么样。所以挂在 .theme-hub 上的那些变量,modal 和 dropdown 里根本读不到。portal 里的内容在 DOM 上本来就不是 wrapper 的子节点,读不到也正常。
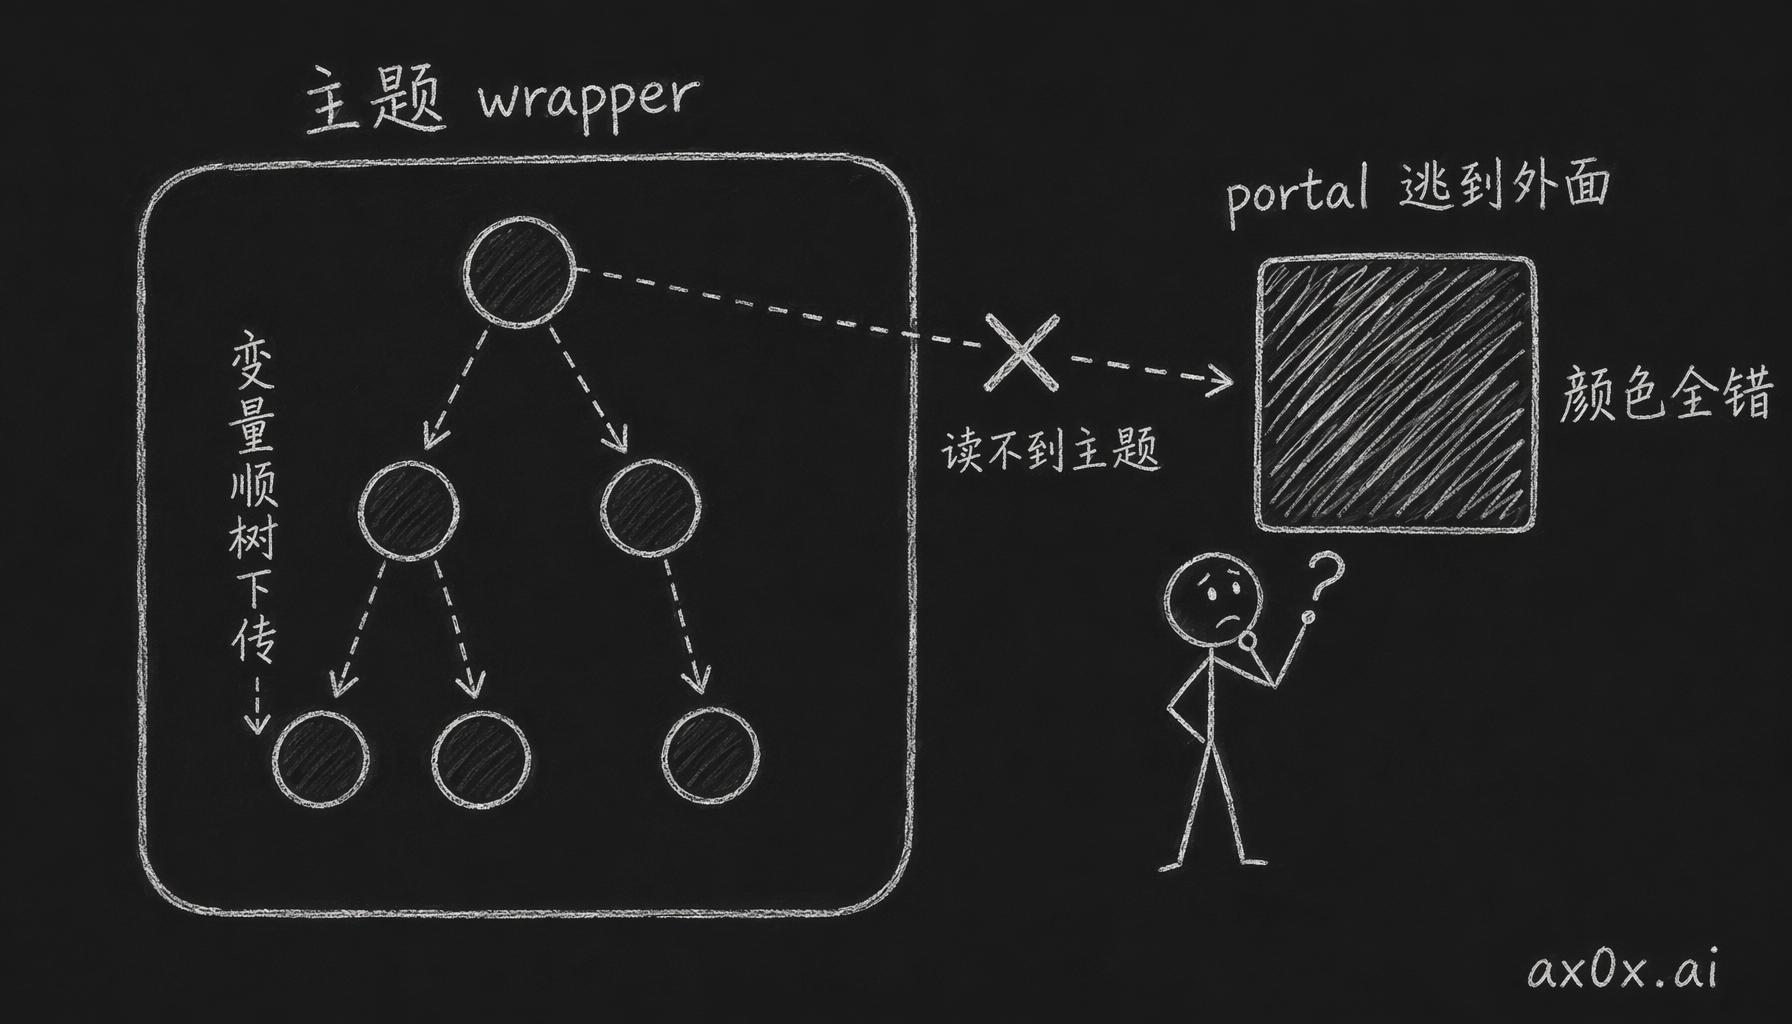 React portal 把 modal 渲染到 DOM 树最外层,逃出了主题 wrapper,CSS 变量顺着 DOM 树下传却够不到它,于是 modal 颜色全错
第一次修是 PR #64,修法很丑:每个 modal 组件自己用 closest('.theme-hub') 去检测自己在哪个主题里,再硬编码一个 .theme-hub-overlay 这样的类。9 个主题、13 个用 portal 的组件,等于只能一个一个打补丁,完全没法扩展。PR #67 才换上正确的解法,大概是三个东西:
-
ThemeProvider:一个 React context,由应用布局声明当前的主题类 -
useThemeClass():从 context 里把当前主题读出来的 hook -
ThemedPortal:替代createPortal(content, document.body),用正确的主题类把 portal 内容包起来,再挂一个 MutationObserver 监听 dark mode 切换
改完之后,9 个应用布局全部更新,13 个 portal 组件迁移完,之前那些逐组件的 hack 全删了。这种 bug 麻烦的地方是开发环境根本看不出来,因为你一次只测一个应用;一次只测一个应用,主题就永远是对的,跨主题的 portal 你根本碰不上。到了生产环境,用户一打开 modal,颜色全是错的。
用户断网了,测算结果不能丢(PR #105)
这是整个项目最大的一个基础设施 PR,动了 56 个文件。问题本身很直接。用户在流式传输到一半的时候断网(手机上很常见,国内网络环境下尤其常见),整个测算结果就丢了,积分还照扣。等于钱花了,什么都没拿到。所以要做到的就一点,连接断了没关系,结果不能跟着一起没了。
方案是在 server 端做流式缓冲,19 条 AI streaming 路由全部接上 StreamBufferManager,把 chunk 顺手缓冲到 stream_buffers 这张表里:
AI Provider ──stream──▶ Server (ReadableStream)
                           │
                    ┌──────┴──────┐
                    │             │
              SSE to Client    Periodic flush
              (real-time)      to Supabase DB
                    │             │
                    ▼           ▼
              User sees      Buffer saved
              live stream    for recovery
client 断开之后,走 GET /api/stream/{id} 就能把完整响应拿回来。消费侧也顺手统一了。原来 14 个组件里消费 SSE 的写法散成 3 种,互相还不一致,现在全部换成一个 useAIStream hook。过期的缓冲交给 /api/cron/cleanup-streams 清掉,这是一个 cron,每 15 分钟跑一次。
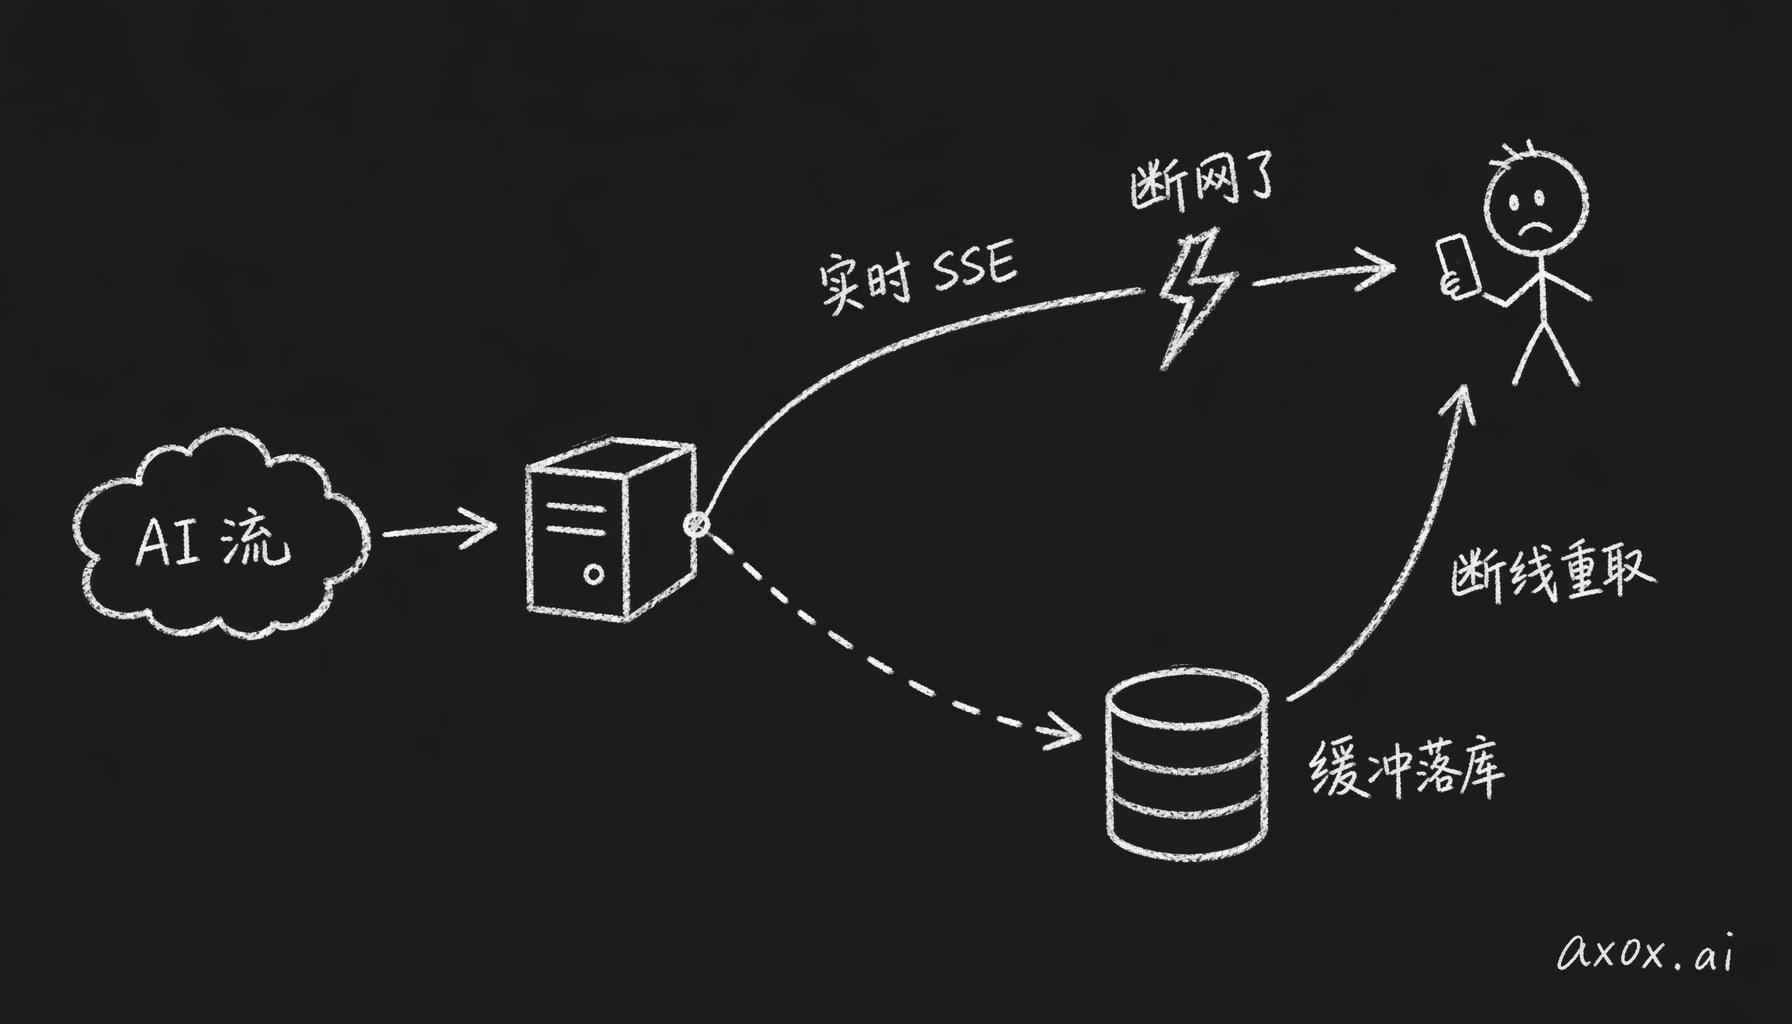 AI 流在 server 端分成两条路:一条实时 SSE 推给用户,一条同时落库缓冲;用户断网后可以从数据库里把完整结果重新取回来
有个地方挺反直觉,加了这么一整套弹性基础设施,代码反而净减了 186 行。主要是换成一个统一的 hook 以后,比同时维护 3 种写法省太多了。反正我碰到这种加功能代码反而变少的情况,一般就觉得方向没走歪。
内容过滤器改到第三版才算对(PR #104)
内容过滤器前后改了三版,每一版都是被用户真实的痛点逼出来的。第一版做完觉得够用,第二版用起来发现好像有问题,到第三版才算终于对了。
-
V1 是 DFA 关键词过滤,消息里含敏感词就整条封掉,简单粗暴。
-
V2(PR #78)改成流感知过滤,遇到敏感词就把整个流截断。这版的问题是用户积分扣了,拿到手的是半截测算结果,体验很差。
-
V3(PR #104)改成行内遮罩:把敏感词替换成
**检测到违禁词**,流不中断。
V3 的架构是双重过滤。输入过滤严格,广告、政治、色情、违法内容在 AI 处理之前就拦掉。输出过滤宽松,分类跟输入一样,但去掉了「广告」这一类,因为算命 AI 自己就会生成兼职、招聘、桑拿这类词,你拿粗暴的关键词过滤去卡,正常内容全被误杀。输入端可以狠,输出端不能狠,两边的松紧不一样。
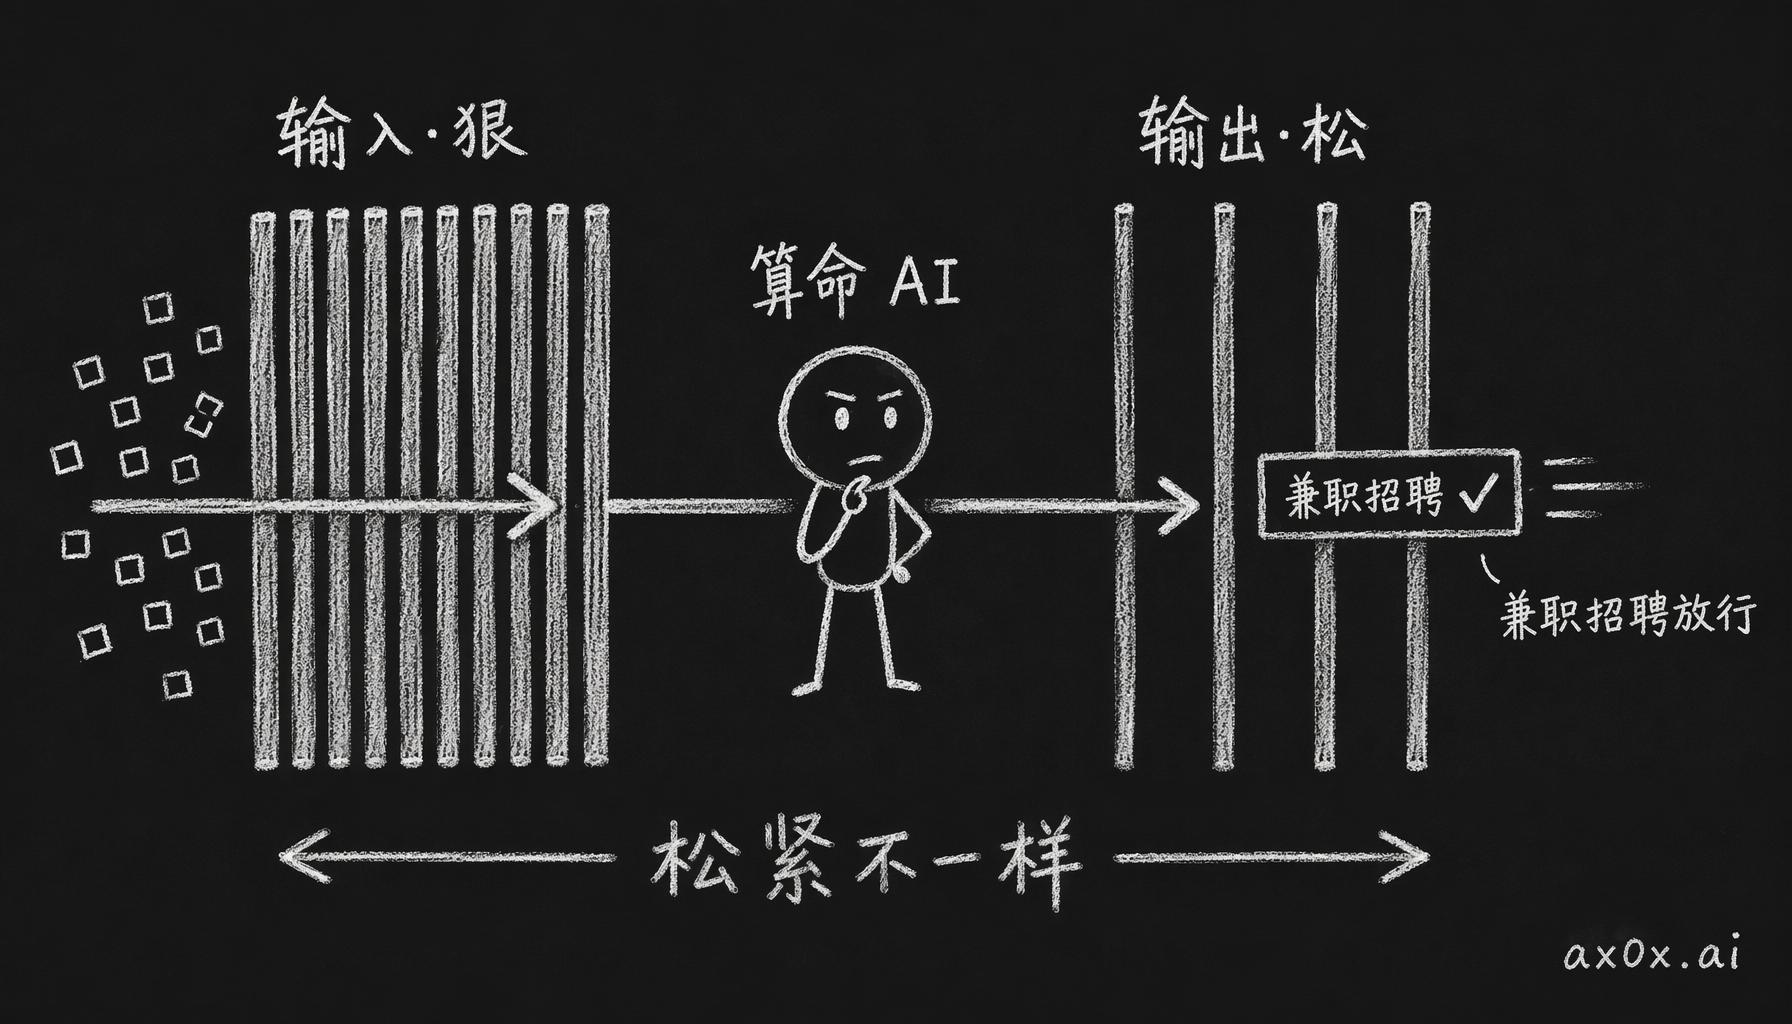 内容过滤两头松紧不一样:输入端狠、什么都拦,输出端松、去掉广告这类,因为算命 AI 自己会正常生成兼职招聘这些词
流式过滤还有个细节,敏感词可能正好跨在两个 chunk 的边界上。所以做法是先把缓冲区完整攒起来,整体做一遍遮罩,再切成两部分,一部分已经可以放出去,一部分还得等着判定,这样跨边界的敏感词也能抓到。这一版配了 6 个测试文件、158 个测试。
i18n 标签全收到一个地方(PR #102)
标签定义原来散在 3 个地方:历史记录弹窗、积分历史映射、历史配置。同样一份 180 行的行内标签映射,每次格式略有不同,重复了三遍。PR #102 把它们全收进 packages/i18n/src/labels/ 下面的两个文件:features.ts 管应用名称、短标签、子类型标签、图标、时间过滤器和历史标题;actions.ts 管大概 60 个积分操作标签。消费方少了 223 行,集中的源文件那边多了 607 行,以后加标签只改一处就行。
中国 AI 法规合规(PR #83)
法律页面拆成了中英文两版,带语言切换 UI 和浏览器语言自动检测。这次新增了《生成式人工智能服务管理暂行办法》《深度合成管理规定》《算法推荐管理规定》三部法规对应的内容,另外补上了 PIPL 跨境传输机制、敏感个人信息同意、自动化决策透明度,还有一套数据泄露应急程序,一共 5 步,里面包括 72 小时内向监管通报。只能说面向中国用户做 AI 产品,这些合规你一条都绕不开。真做起来才知道,每一条都挺费劲的。
这 29 天到底验证了什么
这个项目从立项开始,重点就不在算命上。它要验证的是一个假设:一个工程师带着 AI,能不能在一个完全不懂的领域里,从零做出一个完整的多产品平台。29 天下来,我觉得可以确认了。领域不懂,靠 AI 是能补上的;开发速度也确实快,最后攒下来是 1,134 个 commit、109 个 PR、9 个产品线。把一个产品完整做出来,工程之外的部分也亲手过一遍,反正这几年做过的事里,这件算是最有意思的。