Day 2-4,一半 commit 都是 fix css
这三天一共提了 111 个 commit,讲道理得有一半的 message 都是 fix css。大概是这么分的。Day 2 基本全在修 CSS。Day 3 加了第六个应用,顺手处理了微信浏览器的坑。Day 4 做了统一 API 层,这是整个项目到现在最大的一次架构改动。
 一只炸毛的猫咪被CSS文件和代码碎片的旋风包围
Day 2:全在修 CSS
起因是把 Tailwind 配置统一收进 packages/config。收完之后,凡是用了自定义 design token 的应用,全崩了。
而且崩得不明显。不是那种红色报错页面直接告诉你哪坏了,是背景颜色好像差了一点点,按钮好像小了 2px 这种。这种 bug 最难受,你盯着屏幕知道不太对,但一时说不清到底哪不对。
后来搞明白了,问题出在每个应用都各自长出了一套 CSS 变量命名空间。八字用 --bz-*,塔罗用 --tarot-*,占星用 --zx-*。Tailwind 配置一统一,这几套命名空间就得放在一起还不能打架,每个应用自己的视觉风格也还得保住。所以就有了 38 个 commit,每一轮修掉一批上次漏掉的 CSS 问题,修完发现还有,接着修。
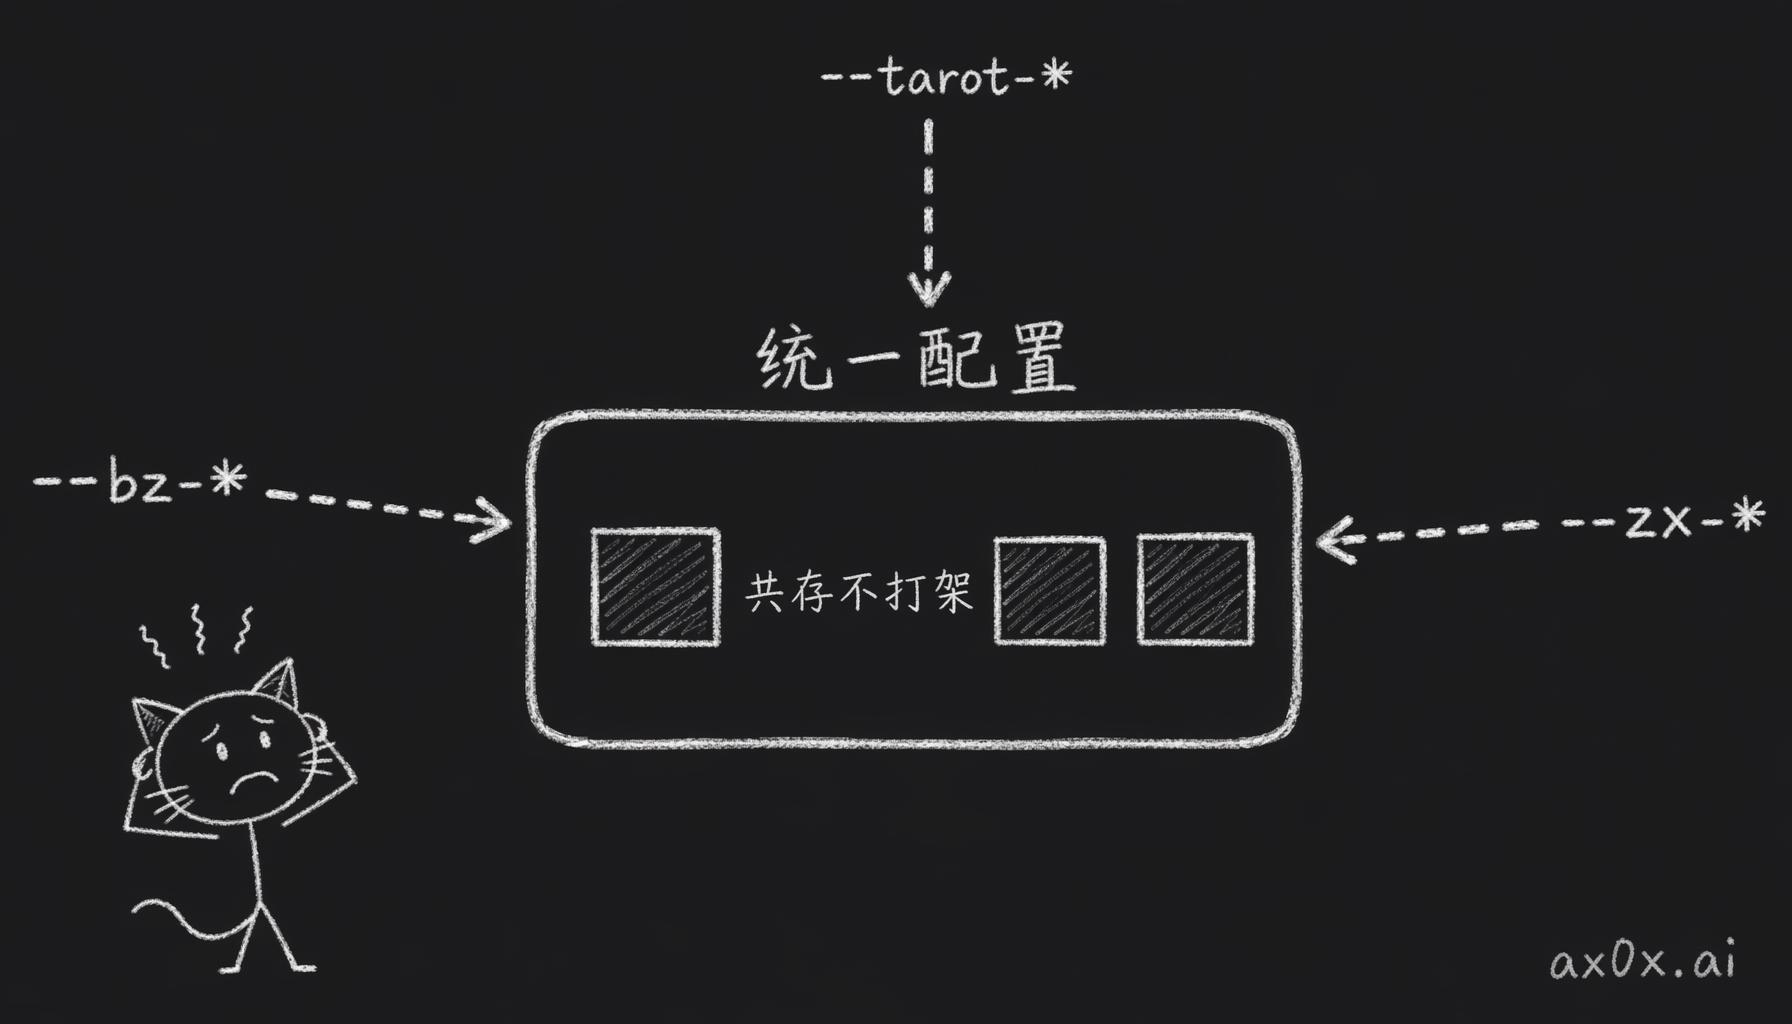 三套 CSS 变量命名空间如何在统一配置下共存不打架
但这个过程里也干了点划算的活。修 CSS 纯是消耗,抽共享包才是真能攒下东西的。顺手抽了 4 个新共享包,分别管 PDF 生成、聊天记录、共享聊天 UI,还有通用的 React hooks。之前三个应用各写了一份自己的 ChatPanel 组件,写法还略有不同。PDF 导出也有三份,走的都是同一套 html2canvas 流程。现在全抽到了 packages/ui 和 packages/pdf 里,修一处,所有地方都跟着好。
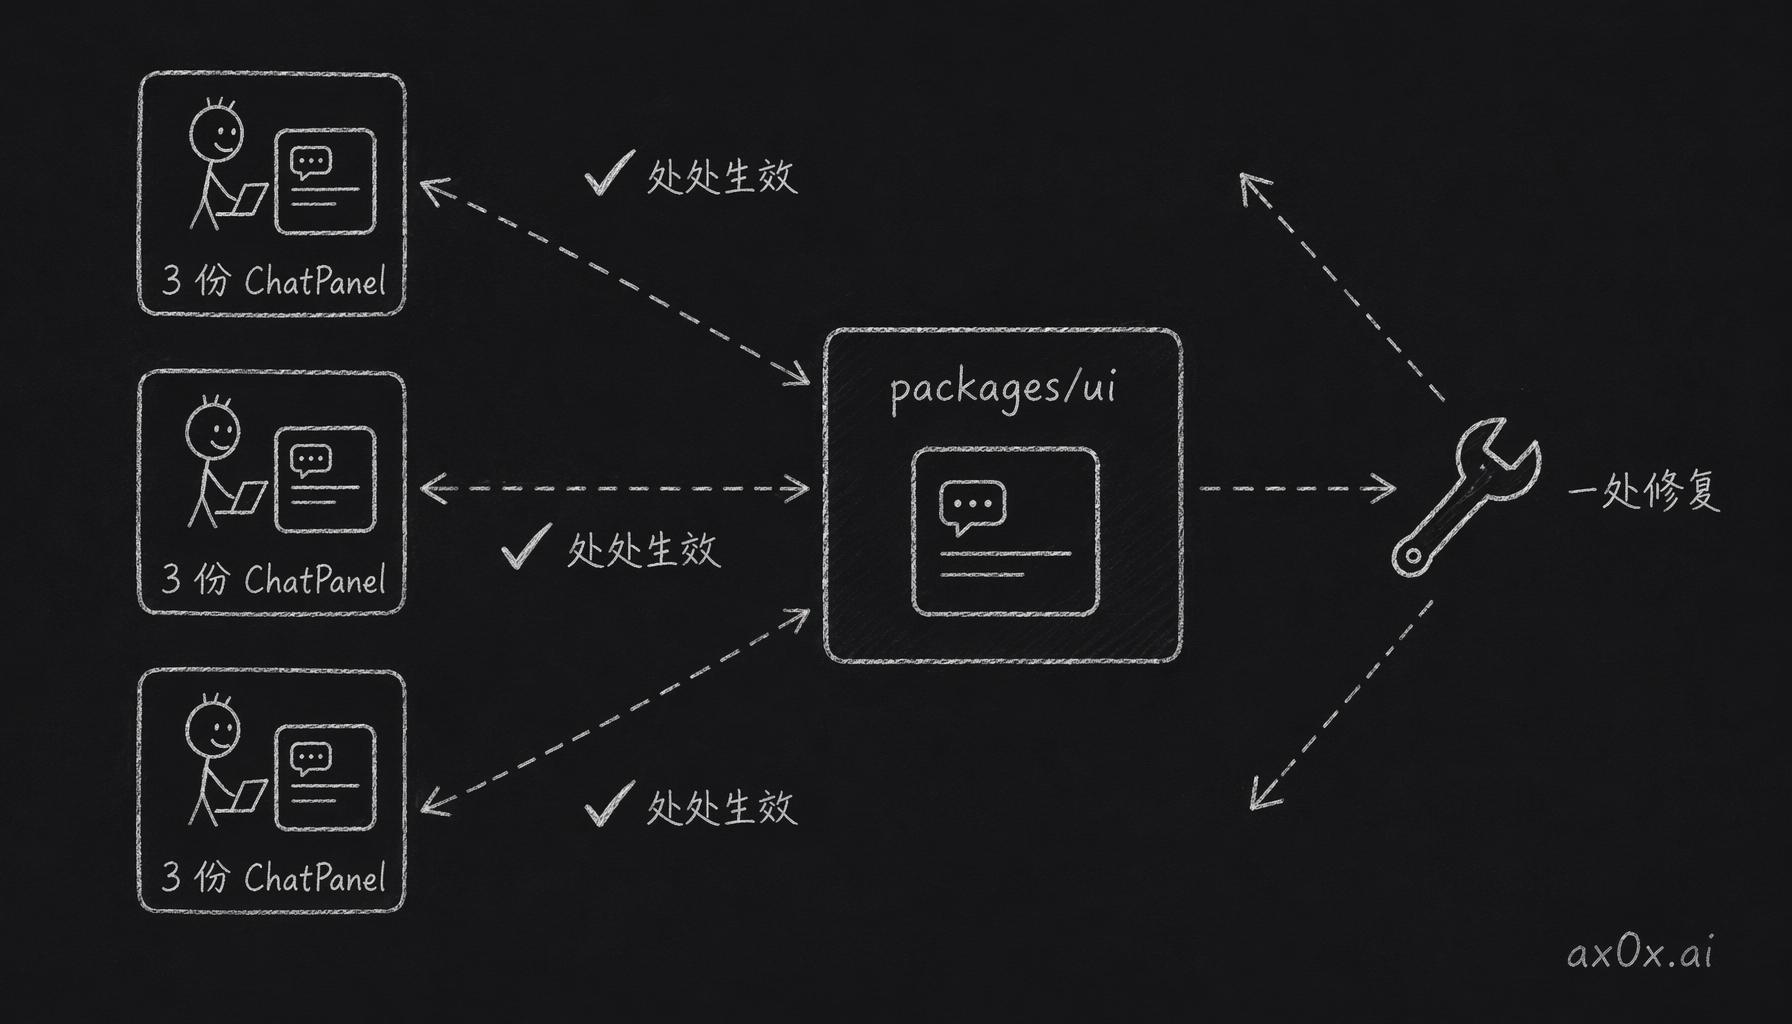 把三份重复组件提取成一个共享包,一处修复处处生效
Day 3:第六个应用,还有微信浏览器
Day 3 提了 17 个 commit,加了一个 MBTI 人格测试,这是第六个应用。这次集成轻松很多,因为它一开始就是冲着 monorepo 做的,直接拿共享包搭起来。
真正花时间的是微信浏览器。反正在中国做 app,微信这关躲不掉,早晚得过。做过中国互联网开发的应该都懂,微信内置浏览器坑非常多。getUserMedia 只支持一部分,OAuth 流程的要求和别家不一样,window.open 也有限制。UA 嗅探要把 Android、iOS、桌面端各个版本的 MicroMessenger 都查一遍,还有企业微信的变体(wxwork)。后来 PR #41 又冒出一个新问题,有些微信版本塞进去的 UA 字符串和文档写的不一样,只好又加固了一轮。
Day 4:统一 API 层
统一 API 包
Day 4 提了 56 个 commit,最大的一件事是做了 packages/api,所有应用和 AI 模型打交道的方式都统一成了一套。我觉得这是整个项目到现在架构上最成功的一步。
之前每个应用都自己写流式路由,大概 80 行样板代码,要设置 ReadableStream,要格式化 SSE 事件,还要处理错误、扣积分。同样的逻辑写了 15 遍以上。
现在换成了一个工具函数 createAIStreamResponse(),传一个配置对象进去就行,里面带这几个生命周期钩子:
initEvents:AI 开始流式输出之前,先把初始数据发出去onComplete:保存结果、记录费用onError:处理失败refundCreditsOnError:流中断了,自动把积分退回去
然后 52 条 API 路由全部迁到了这个模式上。这一步是 claude code 干的,也是 monorepo 加 AI 开发最舒服的地方。模式你只要定一次,往整个项目铺开的活交给 AI 就行。给它看一个迁好的示例,剩下的它自己全改过去,实际大概花了一个小时。这个活要是手动干,至少得一整天。
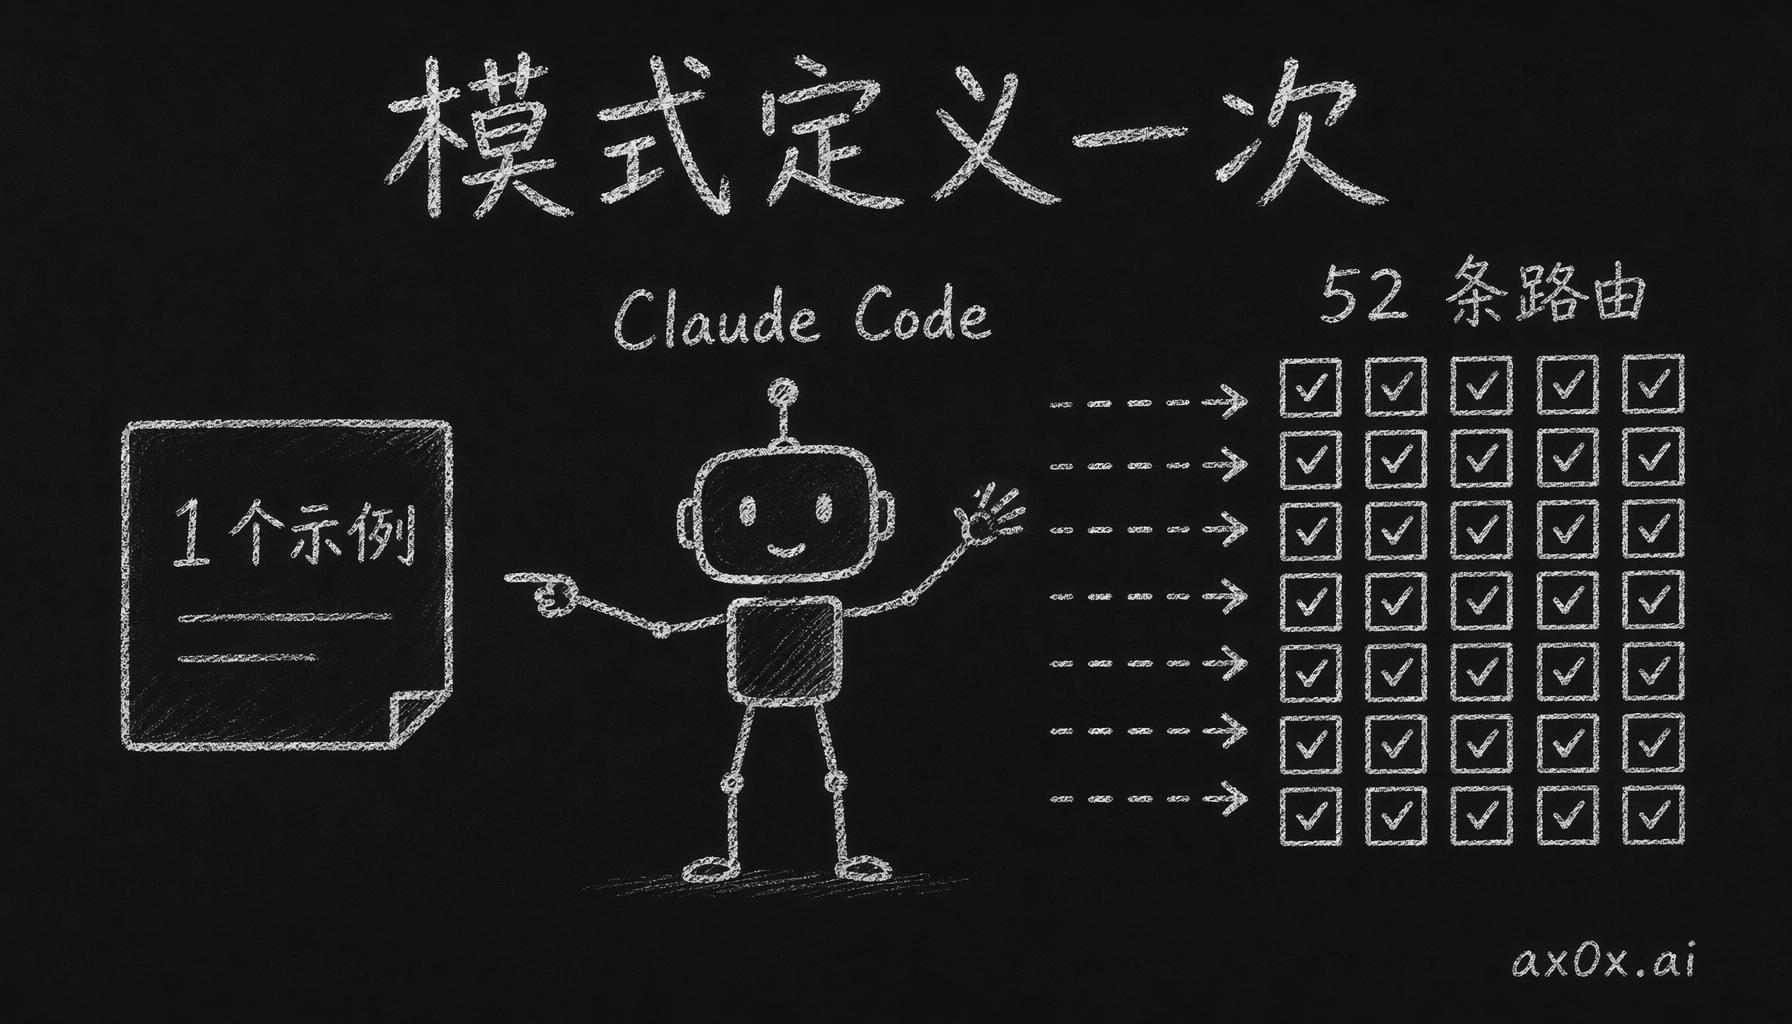 定义一次迁移模式,交给 Claude Code 铺开到 52 条路由
内容过滤器 v1
同一天还用 DFA 做了第一版敏感词过滤器。做中国市场,这东西必须有。但玄学内容有个麻烦,它天生就带一堆会触发简单关键词过滤的词,算命、破财、桃花劫,全是。随便拿一个标准过滤器来,一半正常内容都会被拦掉。
DFA 的做法是先用词表建一棵 trie 树,然后一个字一个字地扫文本。第一版先做最简单的,消息里有敏感词就整条屏蔽,更细的处理留到后面再迭代。
GDPR 和法律合规
还有法律合规的活,要写中英双语的服务条款和隐私政策。这种事没什么好写的,但必须做。后来 PR #83 又整个重写了一遍,拆成单独的中文版和英文版,还加上了中国 AI 监管要求的合规条款。
最后验了一遍
大概晚上 11 点在本地验了一遍。6 个应用同时启动,用同一个账号登录,积分余额在各个标签页之间实时同步,全都是通的。三天前这还是 5 个各自独立的应用,现在账号和积分都共享了,算是合成了一个平台。以后再加新应用,直接拿这几个共享包搭就行。