
硬盘是怎么存数据的
上一篇讲的寄存器、缓存、内存,都有同一个毛病,一断电,里面存的东西就全没了。可你存进硬盘的照片,放十年再打开还在,这是怎么做到的?靠的是另一套完全不同的物理,准确说是两套。机械硬盘靠的是磁,固态硬盘靠的是电子,原理天差地别,一个一个看。
机械硬盘是怎么用磁存数据的
把一块机械硬盘拆开,最关键的零件就两个,盘片和摆臂。盘片表面镀了一层磁性材料,分成一小块一小块,每一小块朝哪个方向磁化,就代表存的是 0 还是 1。电机带着盘片转,我们平时说的 5400 转、7200 转,就是它一分钟转多少圈。
摆臂末端有个磁头,读写都靠它。有件事挺离谱,磁头干活的时候并不碰盘片,它就悬在盘片上方大概 15 纳米的地方掠过去。15 纳米是什么概念?差不多相当于一架客机离地几毫米高速巡航,还不能蹭到地。
写数据好理解。磁头上有个电磁铁,把底下那一小块磁化,电流方向一换,磁化的方向就跟着换。早年间磁化方向是平躺在盘片上的(LMR),太占地方,早就淘汰了;现在都是立起来的(PMR),密度高得多。
读数据就讲究多了,它靠的是一个物理现象,有些材料放在不同的磁场里,电阻会跟着变。1988 年有人发现,把磁性和非磁性的薄膜一层一层叠起来,像肉夹馍那样,这个结构对磁场敏感得吓人,磁场变一点点,电阻就大起大落。这个效应叫巨磁电阻,发现它的两位科学家 2007 年还拿了诺贝尔物理学奖。
有了巨磁电阻,读取头能做得又小又灵敏,磁道就能挨得更密,容量也跟着往上走。可写入头偏偏缩不小,一缩磁力就不够,磁化不动盘片。那怎么办呢?
厂商想了个损招,Redknot 管它叫「卧龙凤雏」。磁道照样做窄,拿宽写入头硬往里写。写这一条的时候会顺手把隔壁那条盖掉,那就先把隔壁读出来,写完这条再给它补回去。一条压着一条,像房顶上的瓦,所以叫叠瓦盘(SMR)。容量确实上去了,但写入速度稀烂,只适合干写得少、读得多的活。所以买盘的时候得留个心眼,如果商家只标 PMR,你得多问一句,是正经的 CMR 还是叠瓦的 SMR,别被文字游戏坑了。
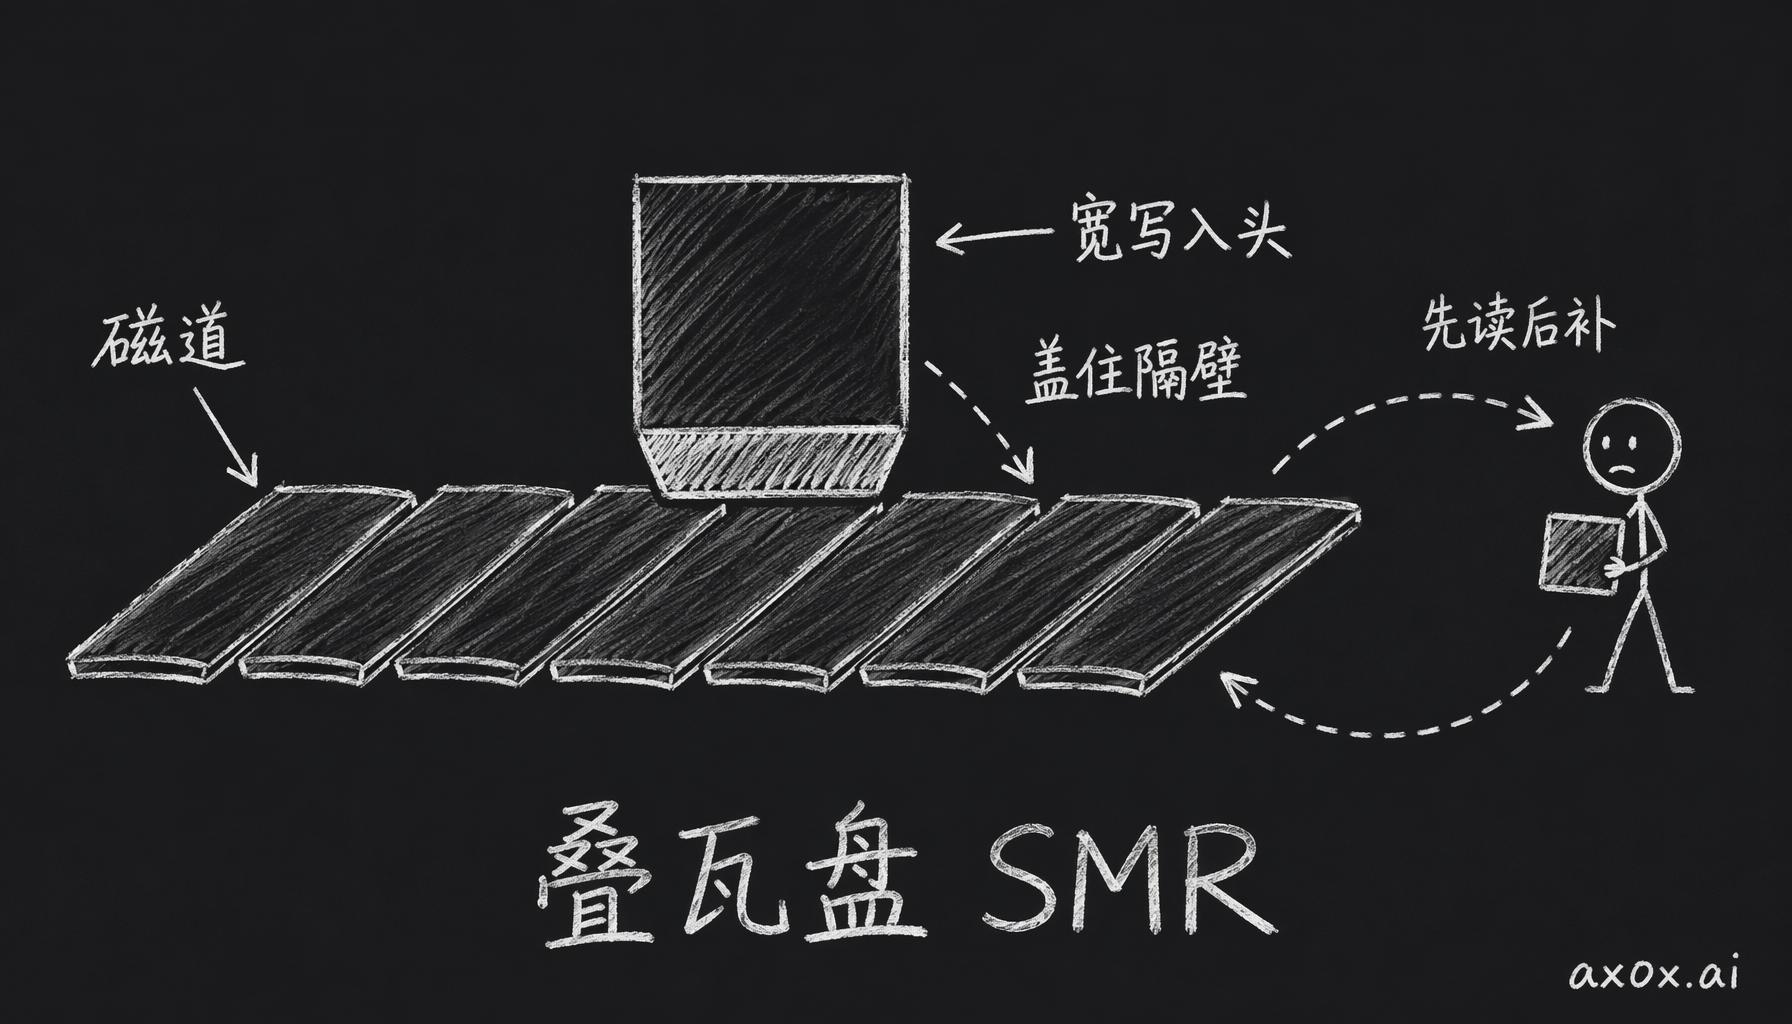 叠瓦盘:磁道故意做窄、宽写入头硬写,像屋顶瓦片一条压一条,写前先把隔壁磁道读出来、写完再补回去
再往后还有热辅助、微波辅助这些花活。热辅助就是拿激光把要写的那一小块先加热到 400 到 700 度,退了磁再写。靠着这些,单盘容量已经能捅破 18TB。
固态硬盘干脆把电子关起来
固态硬盘里没有任何会动的零件,它的思路是直接把电子锁起来。一颗电子面前立着一堵绝缘的墙,按常理它是过不去的。但电场足够强的时候,它有一定概率直接「穿墙」过去,这叫量子隧穿。利用这一点,可以造一个整个被绝缘层包住的导体,叫浮栅。加上强电场,电子就隧穿进去;电场一撤,电子被关在里面出不来,断电放十年也跑不掉。把浮栅塞进 MOS 管的栅极底下,就成了浮栅晶体管,浮栅里有没有电子,就是 1 和 0。
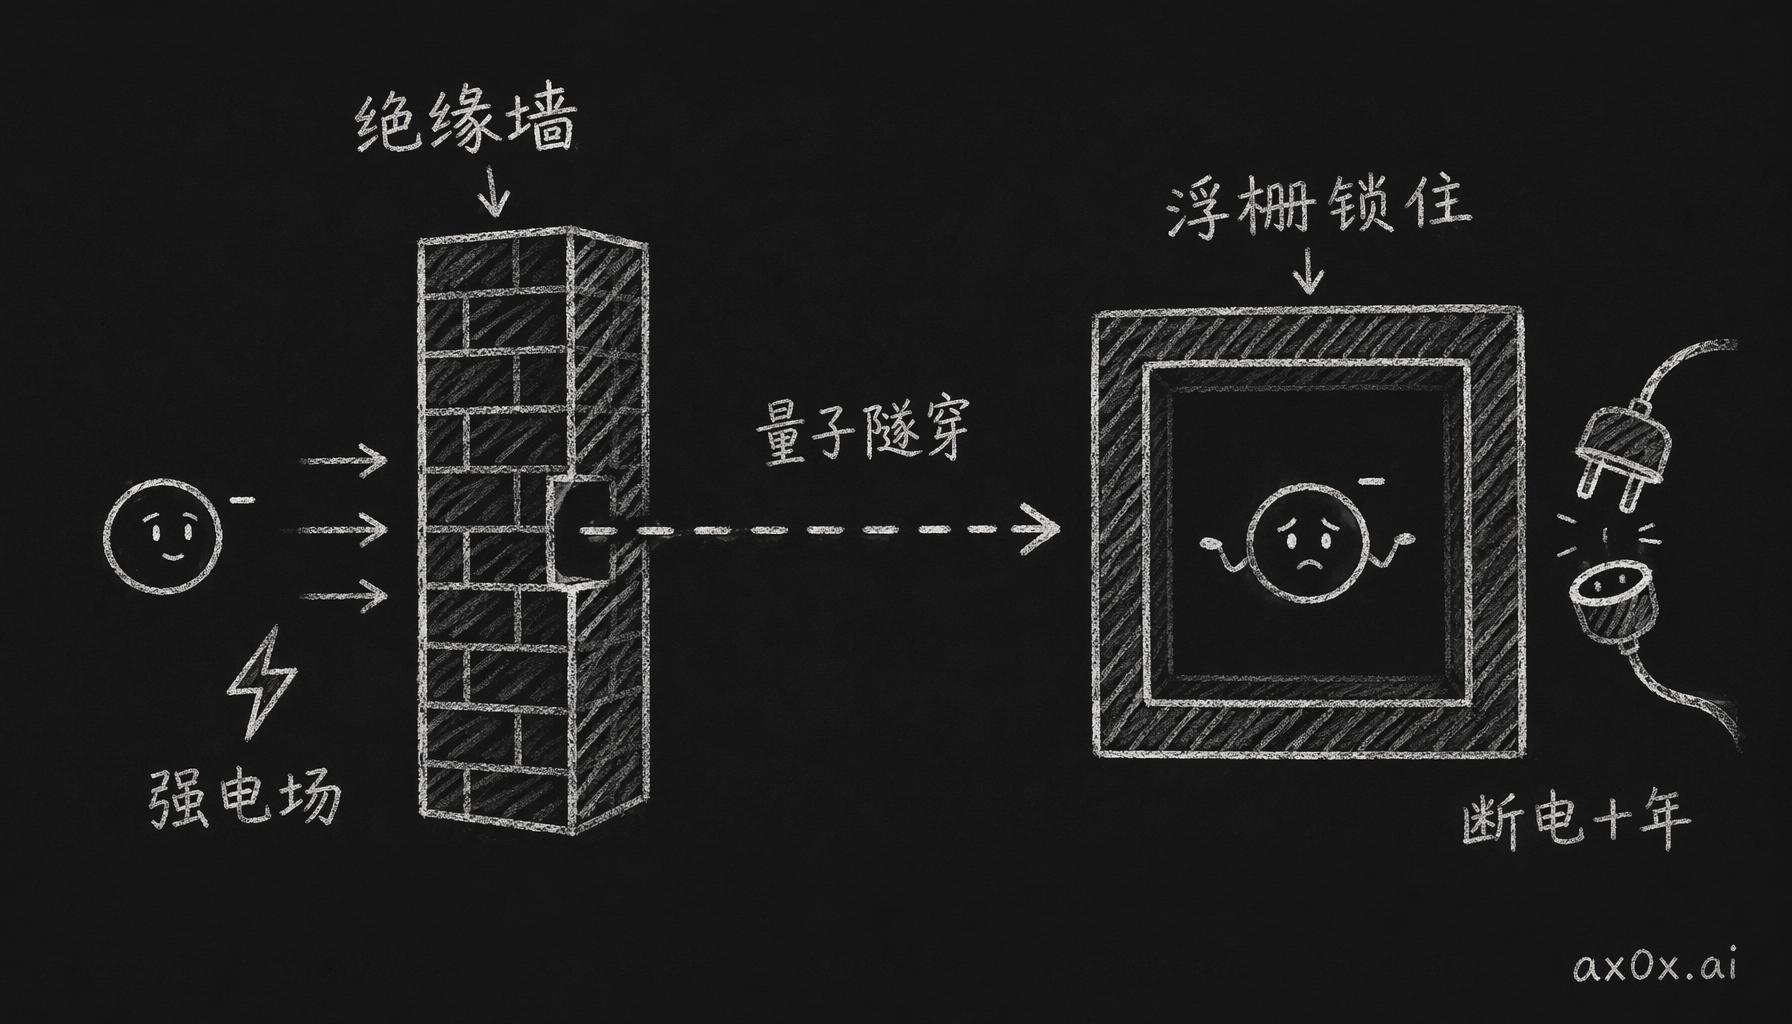 浮栅晶体管:电子在强电场下量子隧穿穿过绝缘墙,被整个包住的浮栅锁在里面,断电放十年也跑不掉
一个浮栅只存 1 比特的叫 SLC,又快又耐用,就是贵。往里硬塞 2 比特叫 MLC,3 比特叫 TLC,4 比特叫 QLC,塞得越多成本越低,但读写越慢,也越娇气。把这些浮栅晶体管串起来组成阵列,串联的接法和与非门(NAND)一模一样,所以叫 NAND 闪存。名字里那个 Flash 是舛冈富士雄在东芝的同事有泉正二起的,因为它擦除数据的过程让他想起了相机的闪光灯。后来 NAND 从平面的 2D 卷到往上叠的 3D,又是好一场厮杀。NAND 演化、3D 堆叠和厂商厮杀,我在「存储为什么是门好生意」系列里专门拆过,讲得更细,这里就不重复了。
一块盘总会坏,那就多块盘组队
盘造得再好也会坏。那怎么办?把多块盘组成一个队,一块坏了别的顶上,这就是 RAID。
RAID 0 最莽,把数据切成块,轮流丢进几块盘,读写一起上,性能直接翻几倍。但只要有一块盘挂掉,整组数据就全报废了,等于拿数据安全换速度。RAID 1 反着来,同一份数据原样拷进每一块盘,坏一块,另一块上还有完整的一份。稳是稳,就是空间上很亏,两块 8TB 的盘只能当 8TB 用,一半纯粹在做备份。
争议最大的是走中间路线的 RAID 5。它也把数据切块分散存,但每攒够一组,就用异或算出一个校验块一起存进去。异或是啥?你可以糙糙地理解成「不进位的加法」。这么干的好处是,随便坏掉哪一块盘,拿校验块加上其余盘上的数据,就能把丢的那一块反推出来,阵列照常跑,换上新盘还能整个重建回来。只牺牲一块盘的空间,就能扛住一块盘损坏,听起来很划算吧?
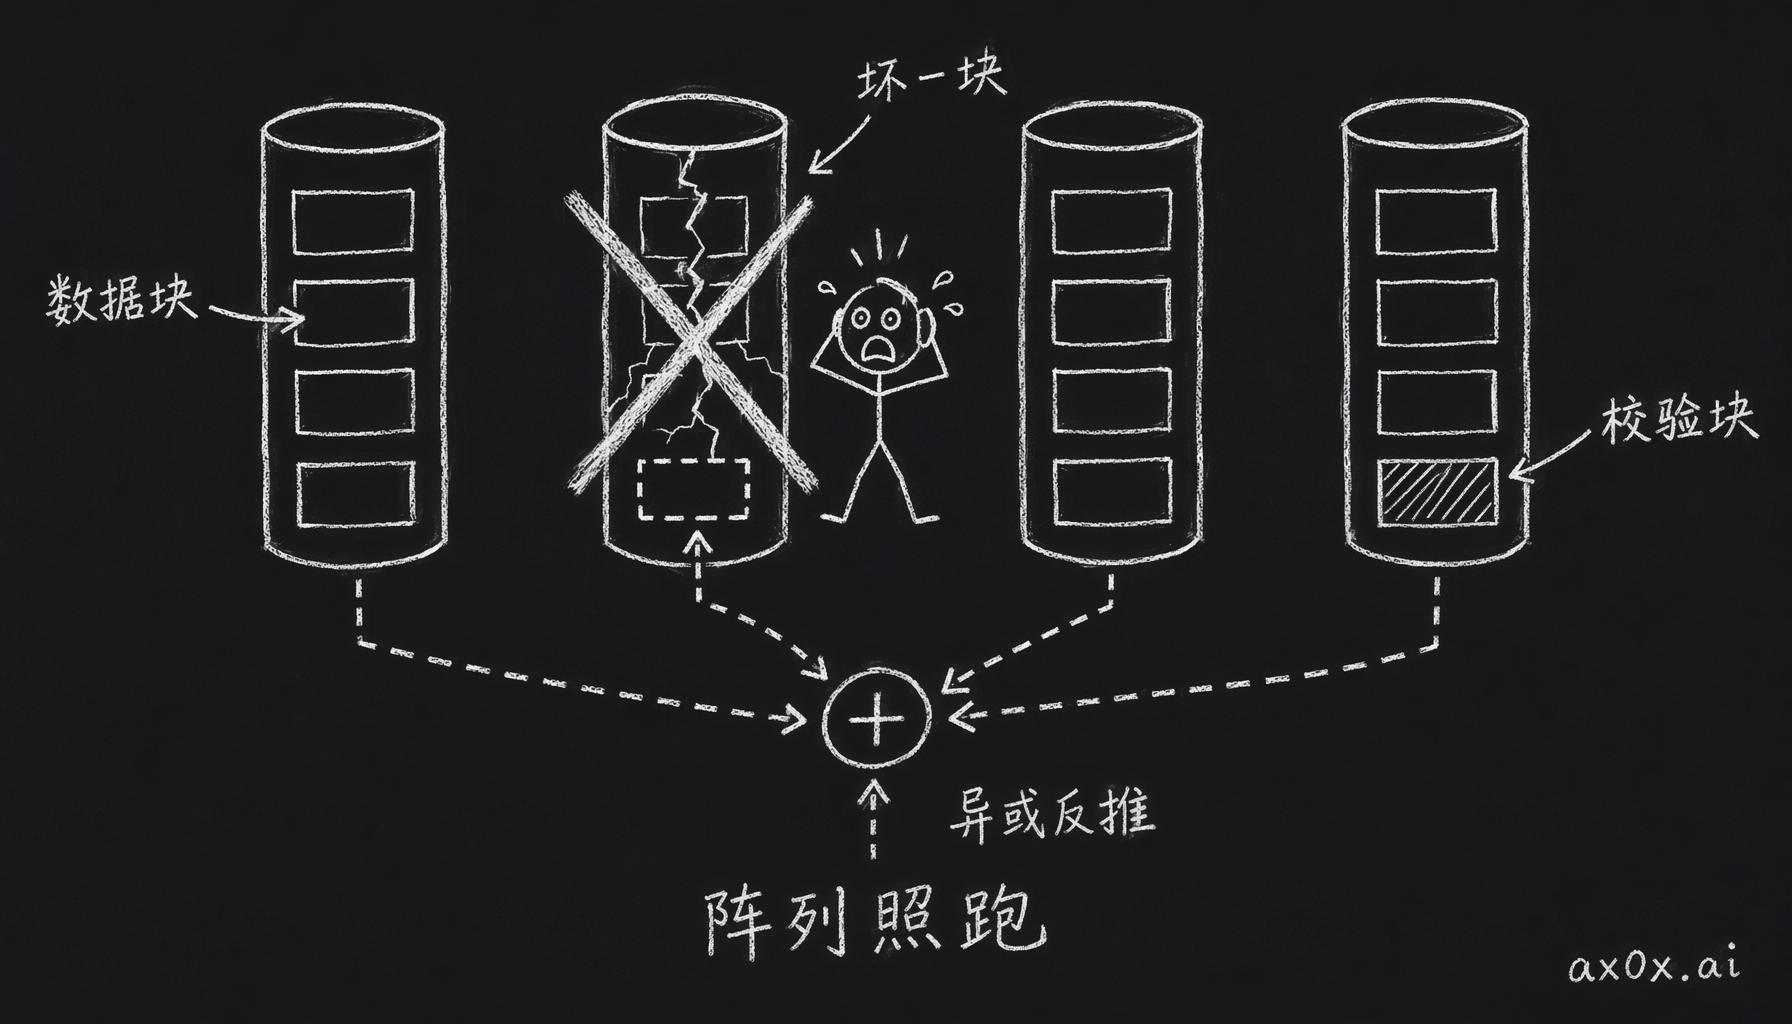 RAID 5:数据切块分散存,每组算一个异或校验块;坏掉任意一块盘,用校验块加上其余盘就能反推出丢失那块,阵列照常跑
那个「重建失败率 99%」是怎么算出来的
RAID 5 有个流传很广的吓人说法,说坏一块盘以后重建,失败率高达 99%。这个数不是瞎编的,真能算出来,先把账摆一遍。
硬盘读数据的时候,有极小的概率把某一个比特读错,这叫 URE,不可恢复读取错误。小到什么程度呢?某款盘的技术文档里写的是 10 的 14 次方分之一。听着确实很小,但换算一下,大概每读 12.5TB 数据就会摊上一次。而 RAID 5 重建的时候,剩下的几块盘要从头到尾完完整整读一遍。假设阵列是 6 块 12TB 的盘,坏掉一块,剩下 5 块加起来 60TB,这一路读下来,撞上至少一次 URE 的概率能飙到 99%。传统阵列一撞上 URE,重建就崩了。99% 的说法就是这么算出来的。
但这笔账算得太狠了。一是厂商文档里的 URE 是个很保守的最大值,实际没那么频繁。第二点更要紧,凭什么一个数据块出错,就要整块盘陪葬啊?问题出在阵列卡干活的那个 RAID 层,它只看得见数据块,看不见文件。撞上一个 URE,它根本不知道这块数据属于哪个文件,对你重不重要,所以企业级阵列卡的最优解就是一刀切,停下重建,喊你过来处理。严格说,URE 不是「让阵列崩溃」,是「让重建停下来等你救」,大部分数据其实都还在。ZFS 的 RAIDZ1 更进一步,它能感知到文件这一层,撞上 URE 会直接告诉你哪个文件坏了,你按文件取舍就行。
真觉得不够保险,那就上 RAID 6。它在 RAID 5 的基础上多算一组校验,两块盘同时挂也扛得住,碰上 URE 也更经得住。但 RAID 换来的只是一层冗余,多花几块盘的钱,买的是坏一两块盘不至于当场丢数据。它替代不了备份,该备份还是得备份。
数据存在哪,到这里就说完了。但要让 CPU 飞快地用上这些数据,中间还隔着内存和显存这道关。它们也是存数据的,但取舍的方向和硬盘完全不一样,下一篇接着讲。
本文整理自 B 站 UP 主 Redknot-乔红 的硬件科普合集。叠瓦盘那个「卧龙凤雏」的吐槽、还有 RAID 5 那套 URE 算账,都来自他的原视频,讲得比我细。本系列只做主题重编与转写。
