TPU 和 GPU 根本不是一回事
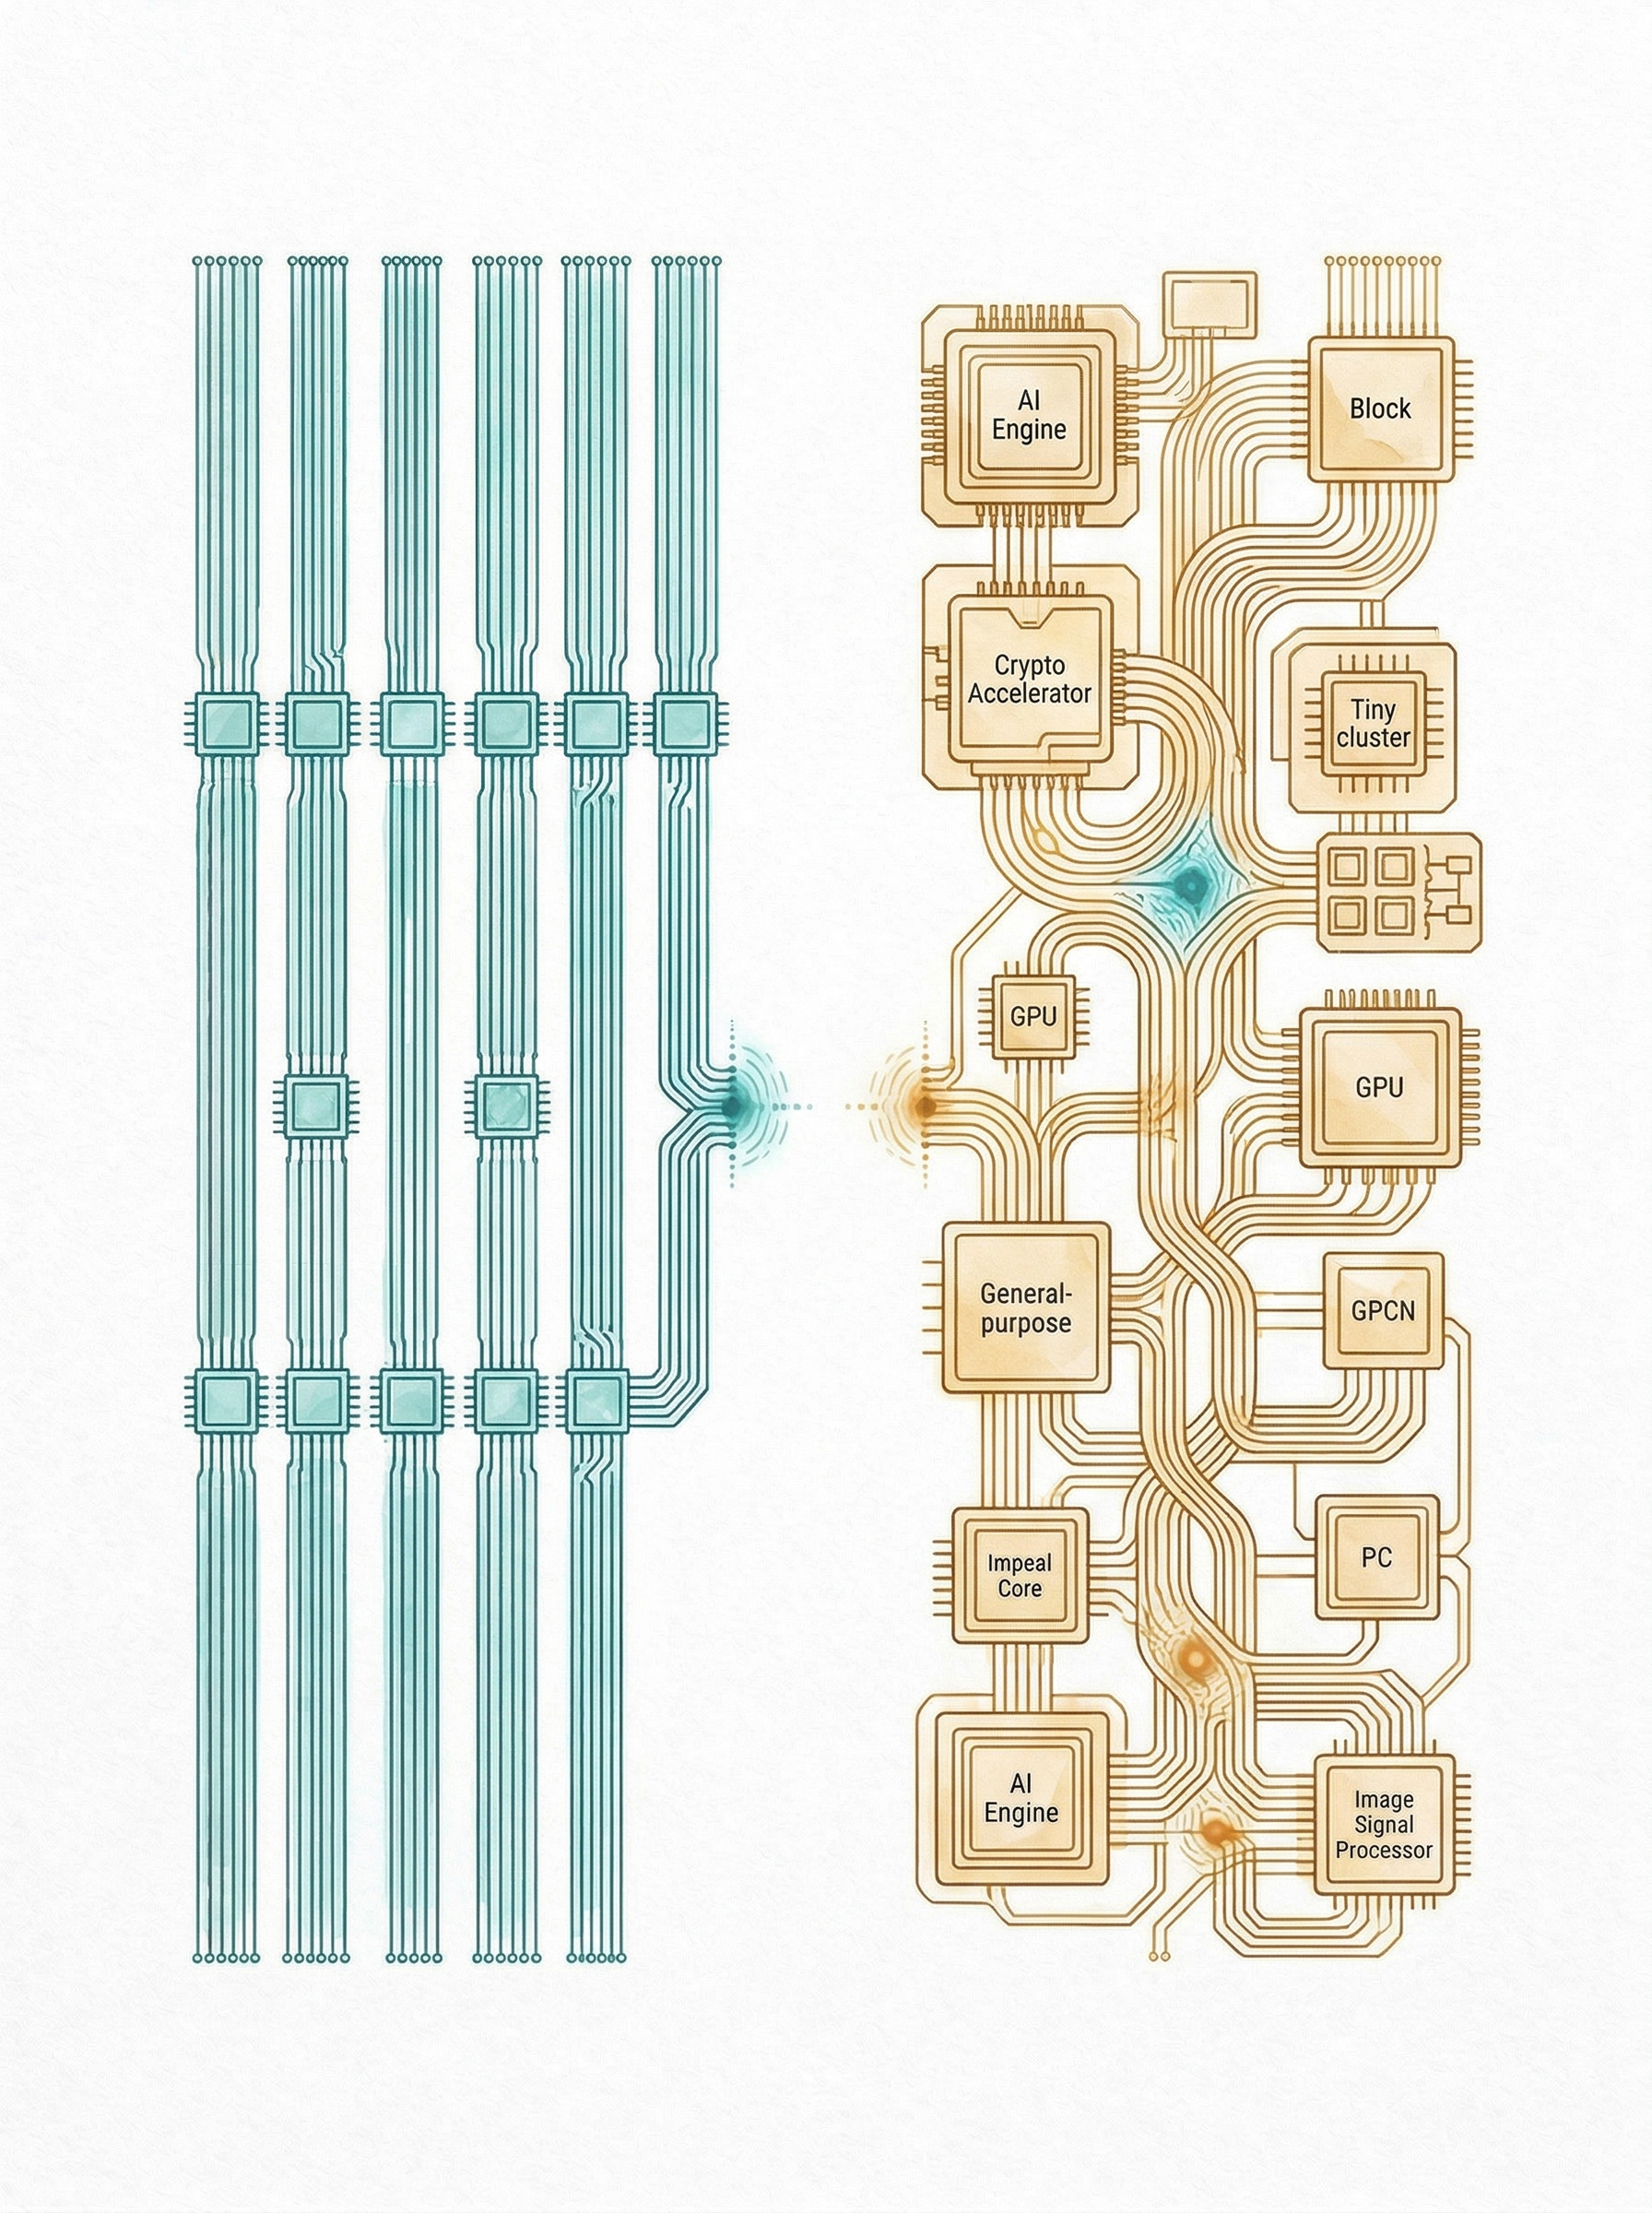 GPU 是一千个大厨,TPU 是一条流水线
前几天听了一期硅谷101的播客,嘉宾 Henry 是前谷歌 TPU 工程师,在谷歌干了六年,V7(Ironwood)和 V8 的研发他都深度参与过。我对硬件一直有兴趣,但不算深入,听完这两个小时,脑子里好多本来很模糊的东西一下就清楚了。
以前我也老看到「TPU 好还是 GPU 好」这种争论,听完感觉这么比不太对。这两个东西设计的时候瞄的就不是同一个目标,走的也不是一个路子,硬要放到一张表里比参数,比不出什么名堂。
Henry 那个厨房的比方
大家可能都听说过 GPU 靠的是大规模并行,但到底是怎么个并行法,TPU 又差在哪,好像都说不太清楚吧?Henry 在节目里打了个比方,我觉得特别好懂。
GPU 就像一个厨房里塞了一千个大厨,每个人自己拿主意,自己去冰箱拿食材,自己做菜,自己上菜。这种「一条指令、一堆线程各自跑」的架构有个名字,叫 SIMT(Single Instruction Multiple Threading)。并行能力确实猛,但毛病也出在这,每个大厨经常得等食材从冰箱搬过来,等的时候就闲着。
TPU 不是这样,它是一条流水线。第一个人从冰箱取菜,做完递给第二个人,第二个人加工完递给第三个人。每人只干一件事,中间不用等,也没有调度开销。为什么不用等?因为软件提前把每一步的数据搬运都安排好了,每个人什么时候拿到什么东西,事先就排死了。
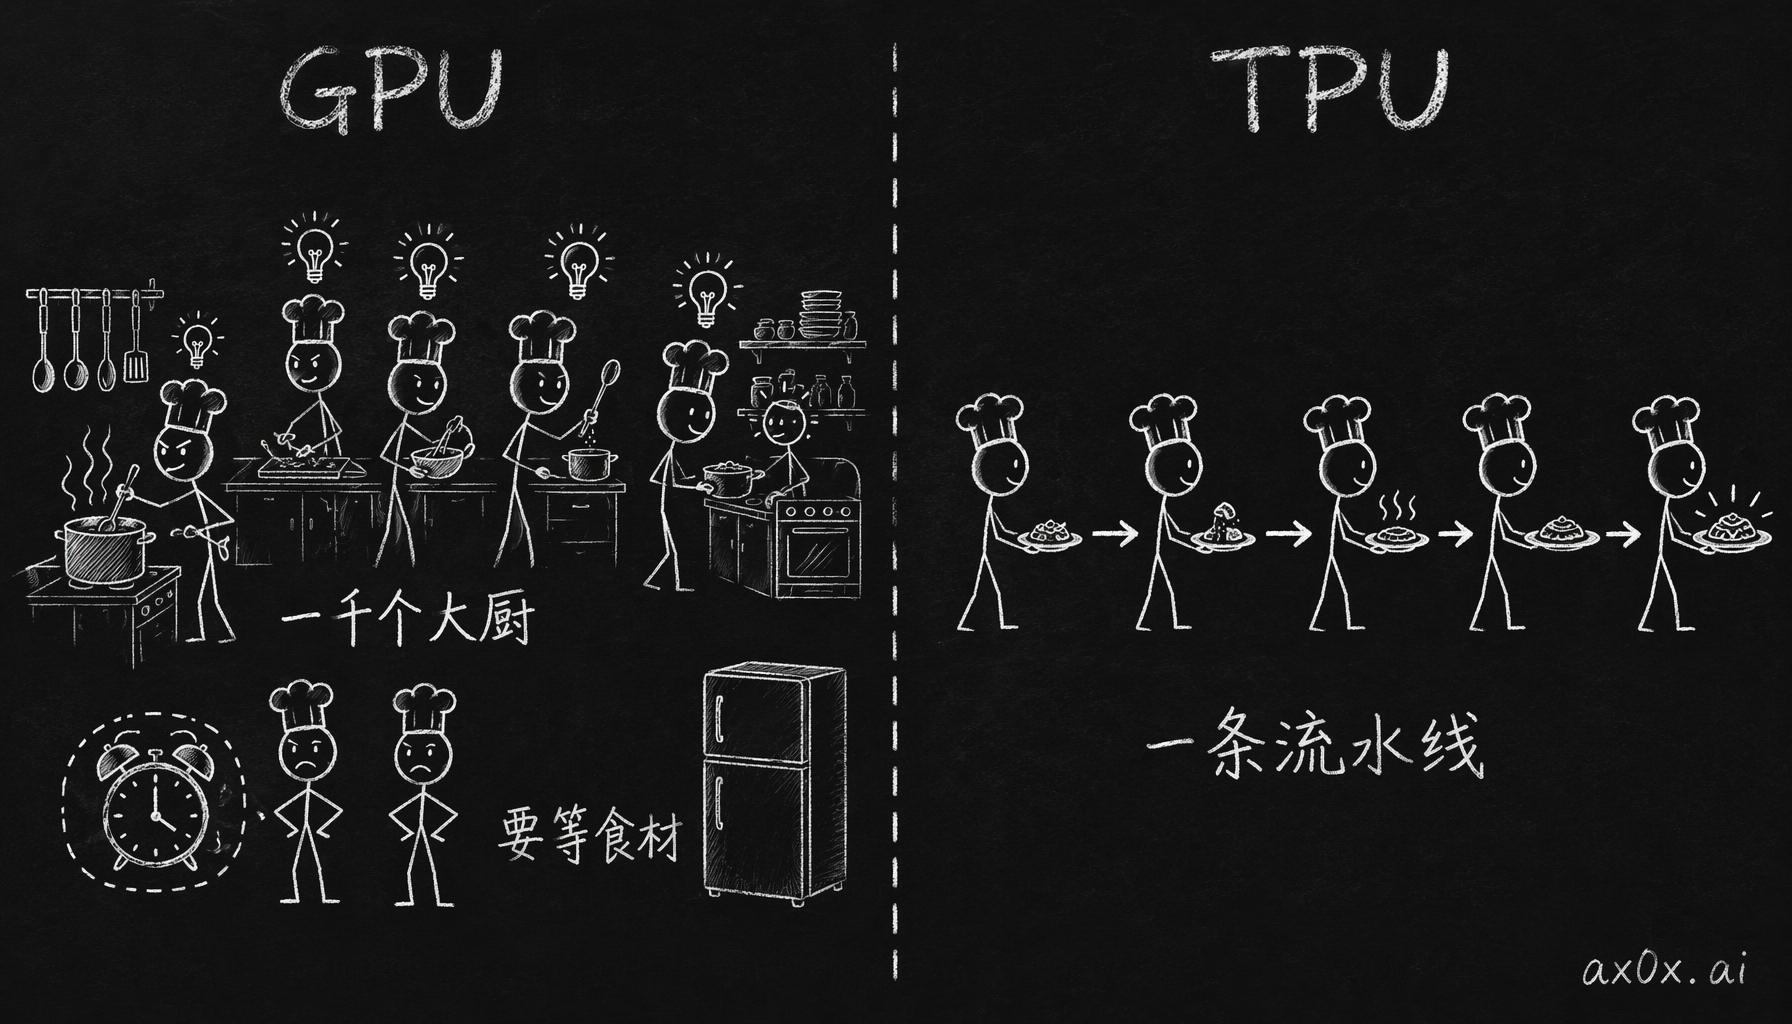 GPU 像一千个各自等食材的大厨,TPU 像一条谁都不用等的流水线
所以这两个东西聪明的地方不一样。GPU 是硬件自己聪明,调度、分工都在芯片里现场解决。TPU 的硬件反而简单,复杂的活全挪给了软件,让软件提前规划。那软件凭什么能提前规划啊?它怎么知道接下来要算什么?
因为 TPU 是一块 ASIC
TPU 是一块 ASIC,也就是专用集成电路,专门为矩阵计算做的,顺着 Transformer 的需求去优化。既然是专用的,workload 就是确定的,你提前就知道这块芯片这辈子要算的就是那类东西,软件当然可以提前把一切安排好,定制芯片也就能拉到接近满载。Henry 说 TPU 的软件就是那个 XLA 编译器,它从全局去规划算子融合、内存管理和数据搬运,相当于开着上帝视角,安排每个计算单元每一秒该干什么。
但这么干有个前提,你得赌对方向,赌你未来几年要算的还是这一类东西。TPU 自己就在这上面摔过一跤。V4、V5 那个年代,TPU 主要跑的还是谷歌内部的推荐系统和排序算法,算的是稀疏矩阵。结果 ChatGPT 出来之后,大模型要算的稠密矩阵一下子暴涨,TPU 的纸面参数一度被 GPU 拉开,一直到 V6、V7 把重心彻底转到大模型训练上,参数才追回来。
那谷歌凭什么敢赌 Transformer 啊?Henry 说得很实在,因为 Transformer 本来就是谷歌发明的,谷歌比行业外的人更早知道这个架构的 workload 长什么样,这个先发优势来自 insider knowledge。但他也坦白说了自己的担心,万一下一代范式不是 Transformer 呢?GPU 通用性强,新算法来了能很快适应。TPU 就难受了,算法那边六个月就迭代一轮,芯片设计一个周期要两到三年,方向一旦赌错,根本追不上。
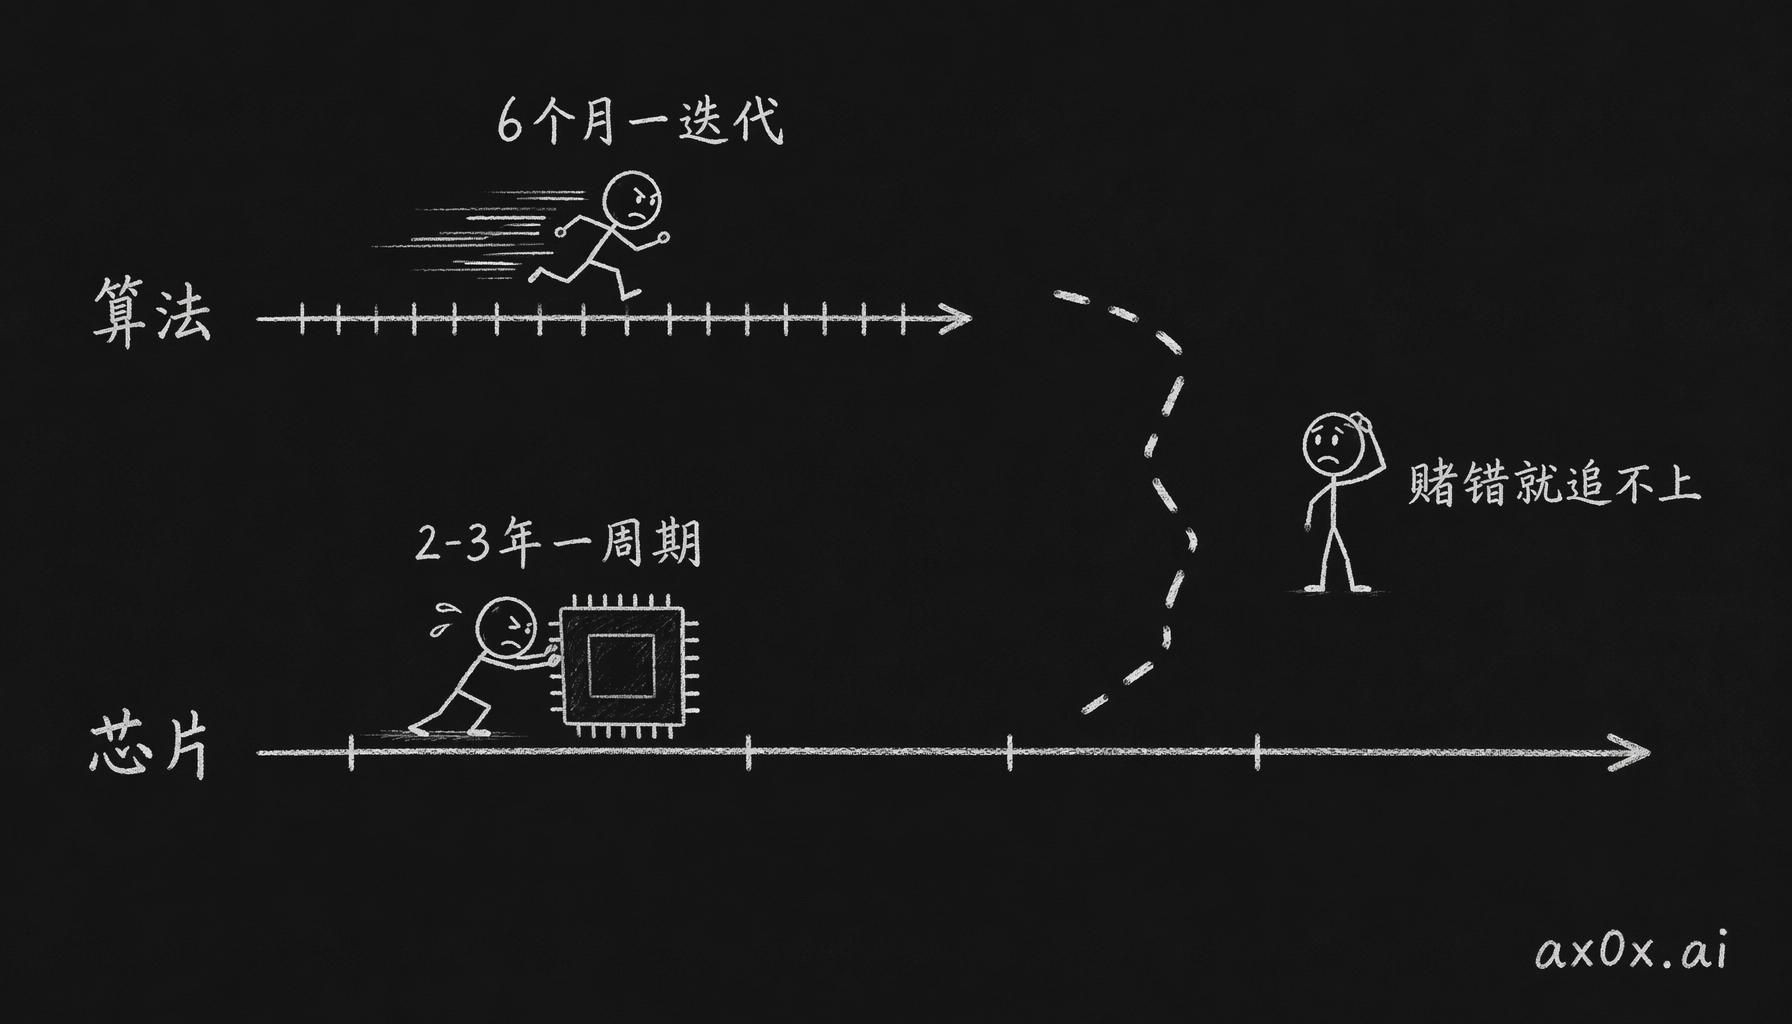 算法六个月迭代一轮,芯片设计要两到三年一周期,方向一旦赌错芯片根本追不上
MOE 就是个很好的例子。早期 TPU 用的网络拓扑叫 2D Torus,每张芯片只能和相邻的芯片通信。可 MOE 要把不同的 token 路由给不同的专家,专家又分在不同的芯片上。在 2D Torus 下想找一个不相邻的专家,中间要跳好多次,堵得一塌糊涂,所以 MOE 在早期 TPU 上根本跑不起来。到 V4 的时候,团队搞了 3D Torus 加 OCS 光纤交换机,通信路径可以用软件重新配置,MOE 的效率一下就上来了。
所以单看芯片,TPU 这条路走得其实挺惊险的。那它现在凭什么抢英伟达的生意啊?就靠赌对了 Transformer 吗?
竞争力其实在系统层面
听下来我的感觉是,不全是。TPU 强的不是单芯片性能,是整个系统,或者说整个集群的设计。
英伟达是一张一张卡地卖,你买了卡,还得买 NVLink、买 NV-Switch 交换机来组网,infrastructure 的成本巨高。TPU 从第一天就是按集群设计的,这个集群叫 TPU Pod,芯片之间用铜线直连,只在关键节点用光纤交换机。用户用起来感觉是「一张卡的性能」,背后其实是几千张芯片在一起干活。
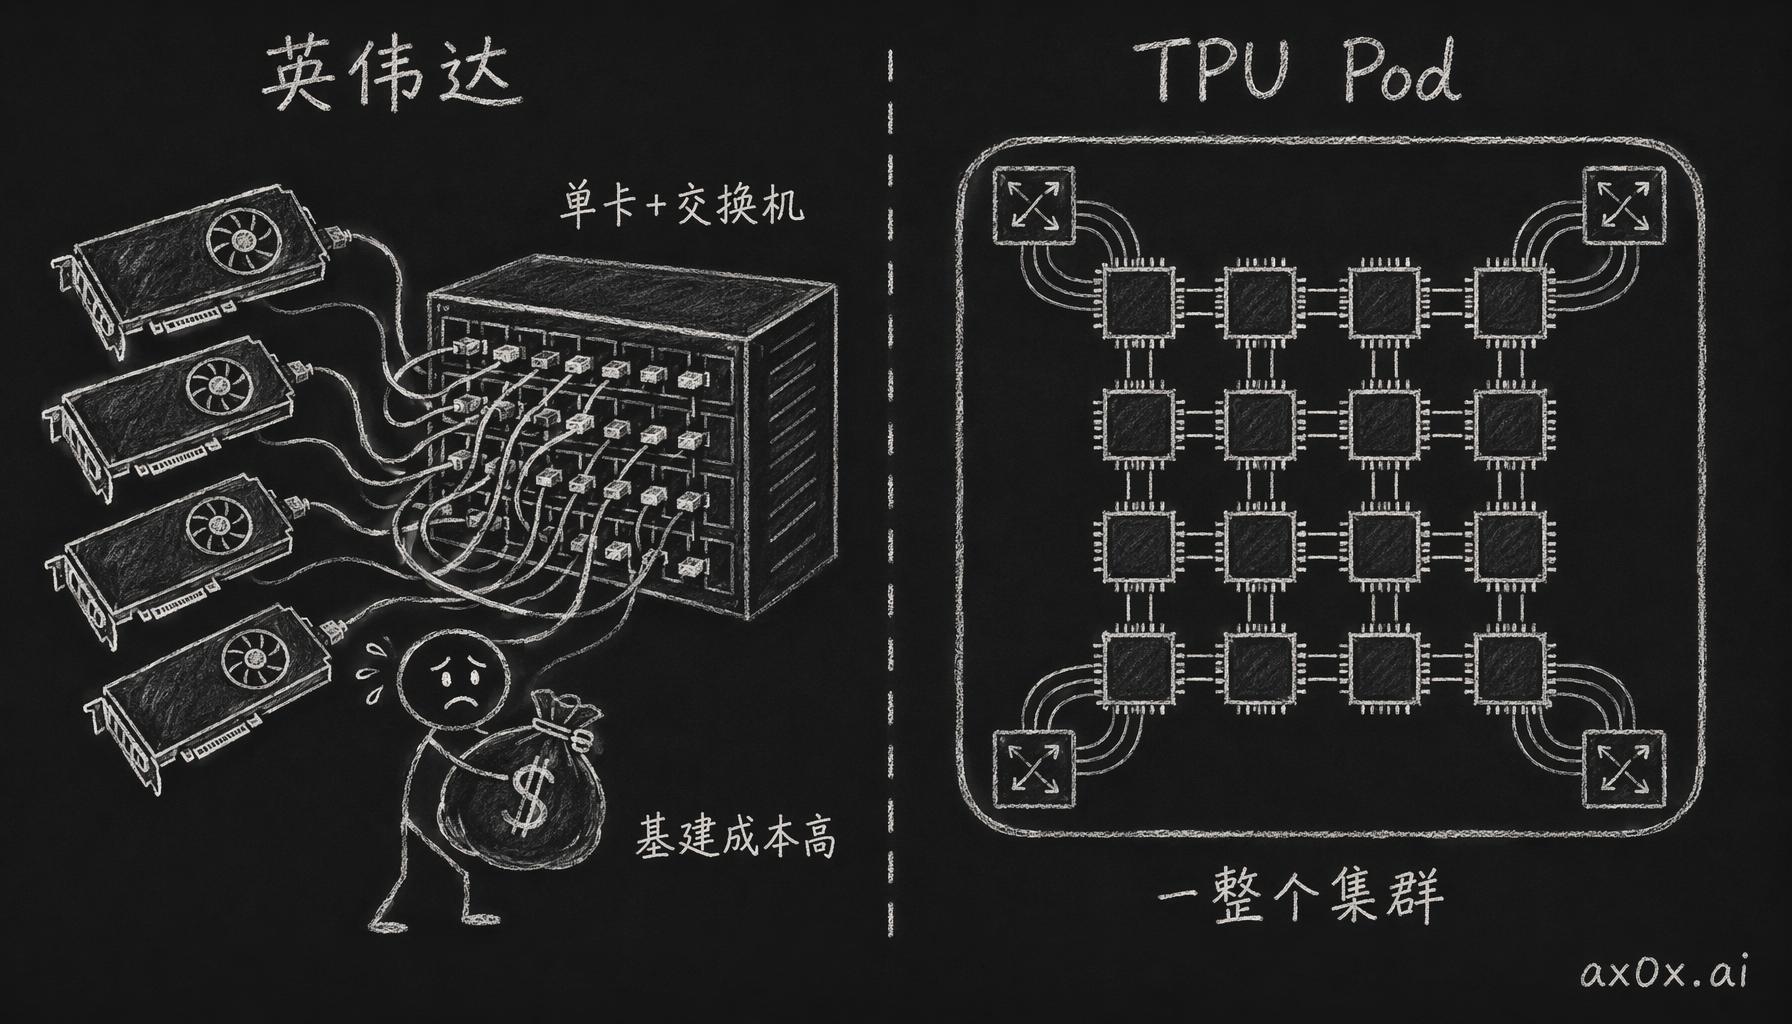 英伟达一张张卖卡还得另买交换机组网成本高,TPU 从第一天就按几千芯片协同的整片集群设计
这么做有两个好处。一是通信便宜,不用去买很贵的交换机。二是训练效率高,因为整个系统是一起优化的。Henry 的说法是,同样训练 Gemini 级别的模型,TPU 的总拥有成本(TCO)比 GPU 更低,前提是你的软件栈能把 TPU 的特性吃透。
问题就卡在这了,什么样的公司才算「能把 TPU 的特性吃透」啊?
想用好 TPU,得有对的人
CUDA 生态有多强就不用多说了,全世界的 AI 研究者和工程师,默认用的就是 PyTorch 加 CUDA,成千上万的算子、库、工具链全是围着 CUDA 建的。用 TPU 呢?你得换成 JAX 加 XLA。
XLA 是个静态编译器。好处刚才说了,它知道整个计算图长什么样,能从整个系统去排最优的调度。坏处是它是个黑盒,出了 bug 很难 debug。Henry 说得很直白,外部开发者基本没法自己修 XLA 的 bug,得去找谷歌的工程师。这东西坏了你自己修不了,只能等原厂来修。跟 CUDA 那种开放生态一比,差距很明显。
所以你看现在把 TPU 用好的都是谁。Anthropic 能用好,一个很重要的原因是它很多工程师本来就是从谷歌出来的,对 JAX 和 XLA 很熟。苹果能用好,是因为庞若鸣(Apple Intelligence 的负责人之一)直接从谷歌把整套软件栈带了过去。其实就是得有对的人,团队里没有摸过这套软件栈的人,这个东西你很难用明白。
那我不折腾机架,直接在谷歌云上租 TPU 行不行啊?Henry 给了一个挺吓人的数字,大概率只能跑到 50% 到 60% 的利用率,但你付的是 100% 的钱,差不多一半的钱是白花的。所以对大多数公司来说,谷歌云上的 TPU 性价比未必比 GPU 好。只有像 Anthropic 那样直接买 TPU 机架、有工程师能深入调优的公司,才真的吃得到 TPU 的红利。
那个一百万颗的大订单
Anthropic 下了 100 万颗 TPU 的订单,价值数百亿美元,这个数字大得吓人。Henry 倒是分析得很冷静,他说了几个原因。
第一,Anthropic 和谷歌绑得很深,谷歌本来就是 Anthropic 的重要投资方,这一单更像内循环,谈不上纯市场行为。第二,Anthropic 的工程团队有能力直接在 TPU 上做深度优化。据 Henry 所知,Anthropic 是目前唯一直接从 Broadcom 手里买 TPU 机架的外部客户,别的公司,苹果、Midjourney、Meta,都还是走谷歌云。第三,claude API 价格大降了 67%,媒体把这个功劳归给了 TPU 训练带来的推理成本优势。
但是话说回来,TPU 在谷歌外面能铺开多少,现在还是特别靠「人」,靠从谷歌出来的工程师带着知识和关系去新公司,一个人一个人地传。这么传能铺多快,我心里其实是打个问号的。
顺便聊聊 Groq
播客里也聊到了 Groq,就是那个被英伟达收购的公司。它的创始人 Jonathan Ross,之前就在 TPU 的编译器团队。
Henry 的评价我觉得很到位,Groq 骨子里是一家编译器公司,不是芯片公司。它的硬件比 TPU 还「蠢」,但编译器能精确到每个时钟周期,安排每个计算单元干什么。Groq 踩准了三个时间点,推理市场爆发、ASIC 兴起、agent 元年。agent 对延迟特别敏感,调用链每一步慢几百毫秒,叠起来整体延迟就没法接受了,Groq 的低延迟正好吃这个场景。
所以我感觉芯片市场不会大一统。大规模训练、高吞吐的推理,这些还是 GPU 和 TPU 的地盘。Groq 这类玩家吃的是对延迟敏感的推理,还有本地部署。至于端侧,那又是另外一码事了,打法完全不同。
最后卡脖子的还是供应链
播客里最让我有感触的,其实是聊供应链的那一段。HBM 就是高带宽内存,全世界只有三家公司做,SK Hynix、三星、Micron。英伟达是最大的客户,产能提前一到两年就锁定了,TPU 一直只能当 secondary customer。CoWoS 是 TSMC 的先进封装,产能也卡着,谷歌做不了,Broadcom 也做不了,只有 TSMC 能做。
还有良率的问题。TPU 很看重芯片之间的通信,所以对芯片一致性的要求极高。GPU 良率不好还能降级卖,H100 可以阉割成低配版接着卖。TPU 不行,每张芯片的架构是定制的,不合格就只能报废。
听到这一段我才反应过来,前面聊的架构也好、编译器也好,都得先过供应链这一关。产能拿不到,芯片造不出来,设计得再漂亮也只是停在纸面上。
对做应用的人意味着什么
GPU 的垄断确实正在被打破,TPU 在里面演了个关键角色。在一些场景下,比如大规模部署、workload 已知、团队有能力做深度软件优化,TPU 确实比 GPU 性价比更高,Gemini 3 就是拿 TPU 训出来登顶排行榜的。
但 TPU 想再往外扩,卡的还是前面聊过的那几件事。最大的一个是软件生态,JAX 加 XLA 学起来太陡,debug 又难,没有 CUDA 那样开放的社区,这个短板短期内看不到怎么补。供应链也悬着,HBM 和 CoWoS 的产能大头都被英伟达锁着。再就是通用性的老问题,算法范式一变,两到三年的芯片设计周期可能就跟不上了。
对我们做应用层的人来说,最实际的一条是,以后的 AI 基础设施会是多元的,GPU、TPU、Groq 这类定制芯片各有各的地盘。做架构的时候别把宝全押在某一家身上,别默认全世界永远只有 CUDA。
感谢硅谷101 第 228 期,主持人泓君和嘉宾 Henry 的这场对谈真的很精彩,对 AI 硬件有兴趣的话,值得完整听一遍。