
所有 AI 问题,拆到底都是算力问题
 算力是一棵大树的根,智能的两条路都从这里长出来
去年做 AI 陪伴产品的时候,被一个很小的功能卡住了。想让角色记住用户说过的话,再根据之前聊过的内容调语气。技术上真没什么难度,把历史对话塞进 context 里就完了。卡住是因为账单,每次对话都带着几万 token 的历史,乘上用户数,再乘上聊天的频率,这个钱根本烧不起。功能就这么压了两个月,后来两件事凑到了一起,才终于上线。一是模型变聪明了,要同样质量的回复,prompt 可以写得更短;二是推理成本又砍掉了一个零。
这事本身挺普通的,功能被成本卡住,成本降了就能上,做产品的应该都碰到过。只是后来我回头看,感觉那两个月我们其实什么都没做,就是在等推理价格往下走,等它降过某个点。一降过去,这个功能自己就做得起了,代码还是那些代码。
后来我拿这个角度去看 AI 圈的每一次「爆发」,发现基本都是同一回事。agent 今年到处都是,是因为 2023 年根本用不起。当时 GPT-4 每一百万 token 输入要三十美元,输出要六十美元,agent 跑一次任务要推理几十次,哪个公司烧得起。过了十七个月,GPT-4 的综合 token 价格从 $36/百万跌到了 $4。Andrew Ng 算过这笔账,一年降了 79%。a16z 给这个现象起了个名字叫 LLMflation,说同等性能的推理成本大概每年降十倍。成本一降过那条线,agent 就到处都是了。
SaaS 的地基在晃,也是一样的道理,定制一套东西的成本塌下来了。不会写代码的人拿 claude code 给自己搓个工具,中间要调几百次推理,这个量放在两年前是天文数字,现在就是日常开销。超级个体这个说法能站住,也是因为并行跑不贵了。你一个人开十个 agent 线程,推理量就是十倍,要是 token 没便宜到今天这个程度,这笔账怎么算都算不过来。
所以我只能说,AI 圈也没有隔三差五冒出什么新趋势,就是同一根成本曲线一直在往下走,走到哪,哪就爆一次。后来我看手头产品的问题,也全按这个思路来。推理太贵,那是成本还没降到那个点;模型不够聪明,那是训练算力还没堆够。不管卡在哪,往底下捅一层,答案就很清楚了。说句不太严谨的话,AI 陪伴、日抛软件、人人都是开发者、龙虾热、印刷术时刻,这个博客快两百篇文章聊过的所有话题,全捅到底,全是算力的事。算力更好,模型就更强,推理就更便宜,能做的事就更多,需求跟着爆,需求一爆,更多钱又砸回算力,就这么转成了一个正反馈的飞轮。
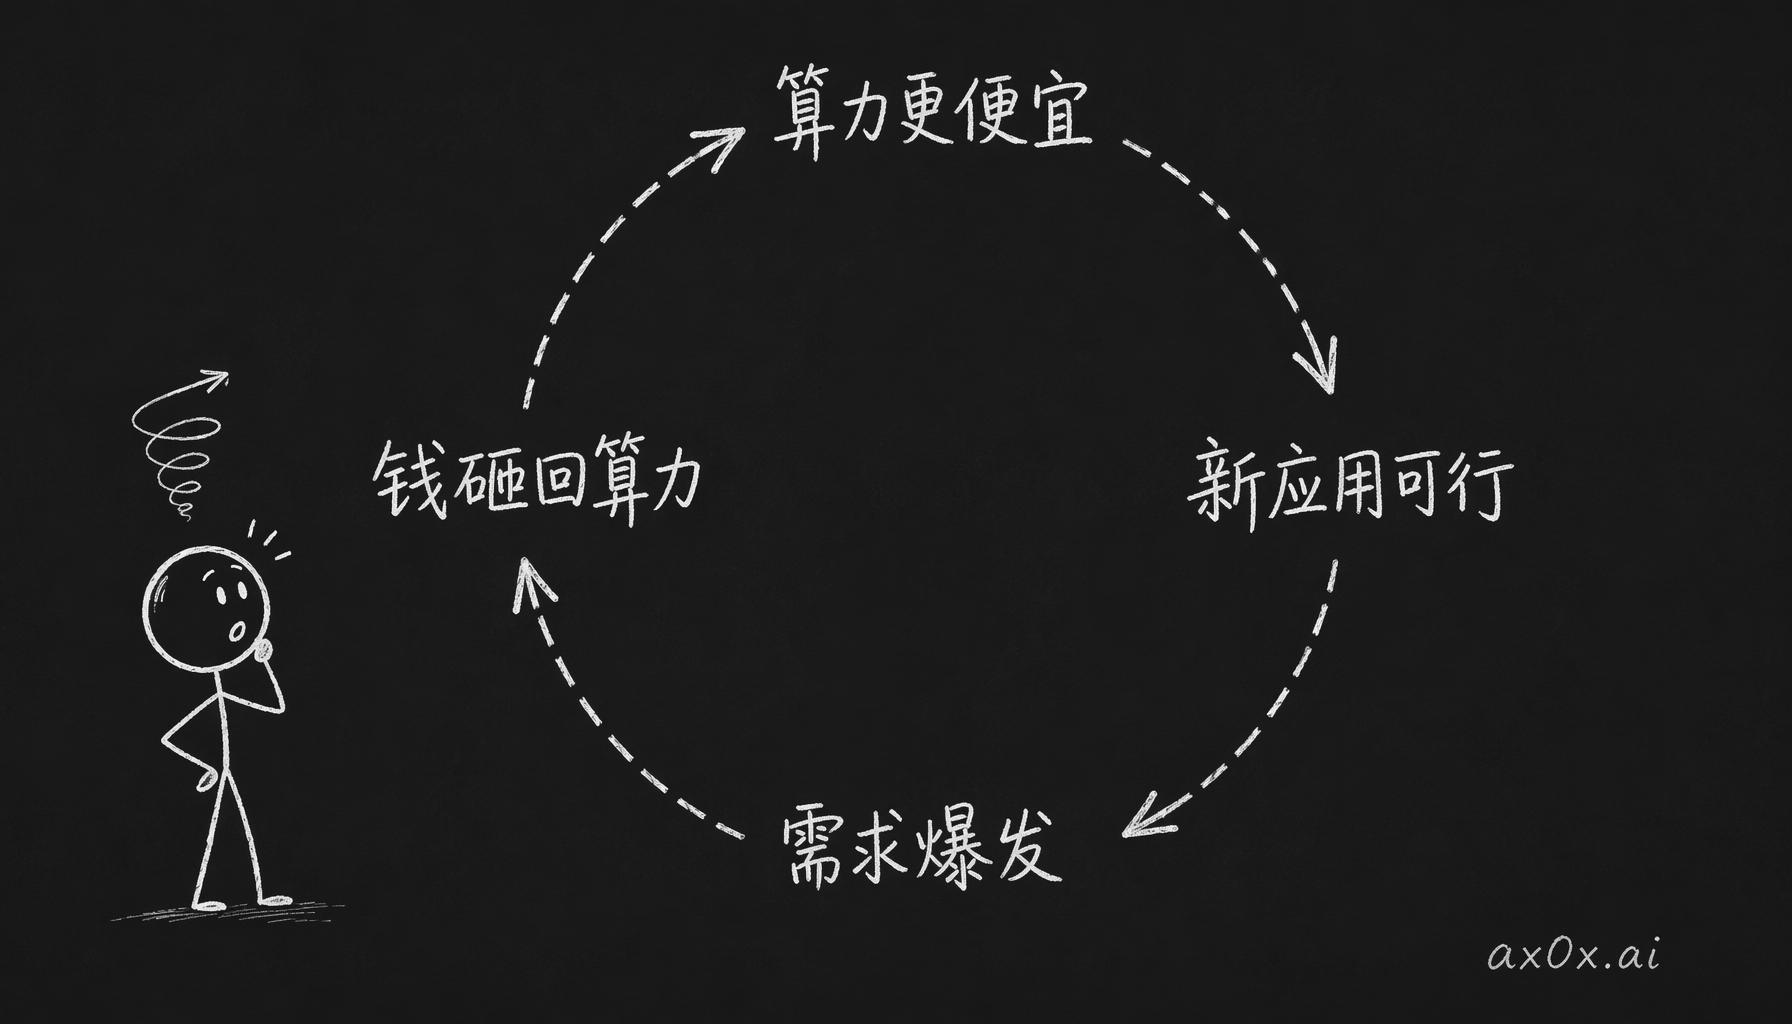 算力成本下降驱动的正反馈飞轮:更便宜的算力让新应用可行、需求爆发、更多钱砸回算力,循环往复自我加速
飞轮需求这一头,最近的数字挺吓人的。上周 Jensen Huang 在 GTC 上说,他看到的 GPU 订单需求已经到一万亿美元了,一年前这个数还是五千亿,一年就翻了一倍。一万亿美元,差不多是四个台积电加起来。买家那边也确实在囤,Meta 手上有三十五万颗 H100,年底要加到一百三十万,微软那边大概是五十万颗的量。Nvidia 这两年卖了大概三百万颗 H100 级别的芯片,新一代 Blackwell 已经卖空到 2026 年中,光积压的订单就还有三百六十万颗没交。所以现在一张数据中心 GPU 从下单到到货,最短也要三十六个星期,长的往五十二周走。小公司和 neocloud 就更别提了,排队等货要排几个月,配额也被压到最低。
但比缺货更值得琢磨的,是钱到底花在了哪。在大集群的总成本里,GPU 其实只占四成左右,剩下六成是网络、电力、冷却和设施。拉一个五年的 TCO(总拥有成本)模型一算就很清楚,一百颗 H100 买下来三百万美元,五年实际要花八百六十万,GPU 本身才占三分之一。底下那层基础设施比芯片值钱,也比芯片持久。
拿模型来比,持久这一点就更明显了。模型贬值的 gradient(斜率)挺吓人的。GPT-4 2023 年 3 月刚出来那阵简直是神,所有产品都抢着接它。结果到了 2024 年 7 月,开源的 Llama 3-405B 在 MMLU 上就超过了它,价格才是它的百分之一。到现在,已经没什么人提这个名字了。前沿模型要做到同样的性能,成本每年降五到十倍;完全商品化的那一层跌得更狠,四十到九百倍。模型的半衰期越来越短。数据中心就不一样了,当年训 GPT-4 的那批 A100 集群,现在分给一百个小模型跑推理,还在老老实实赚钱。
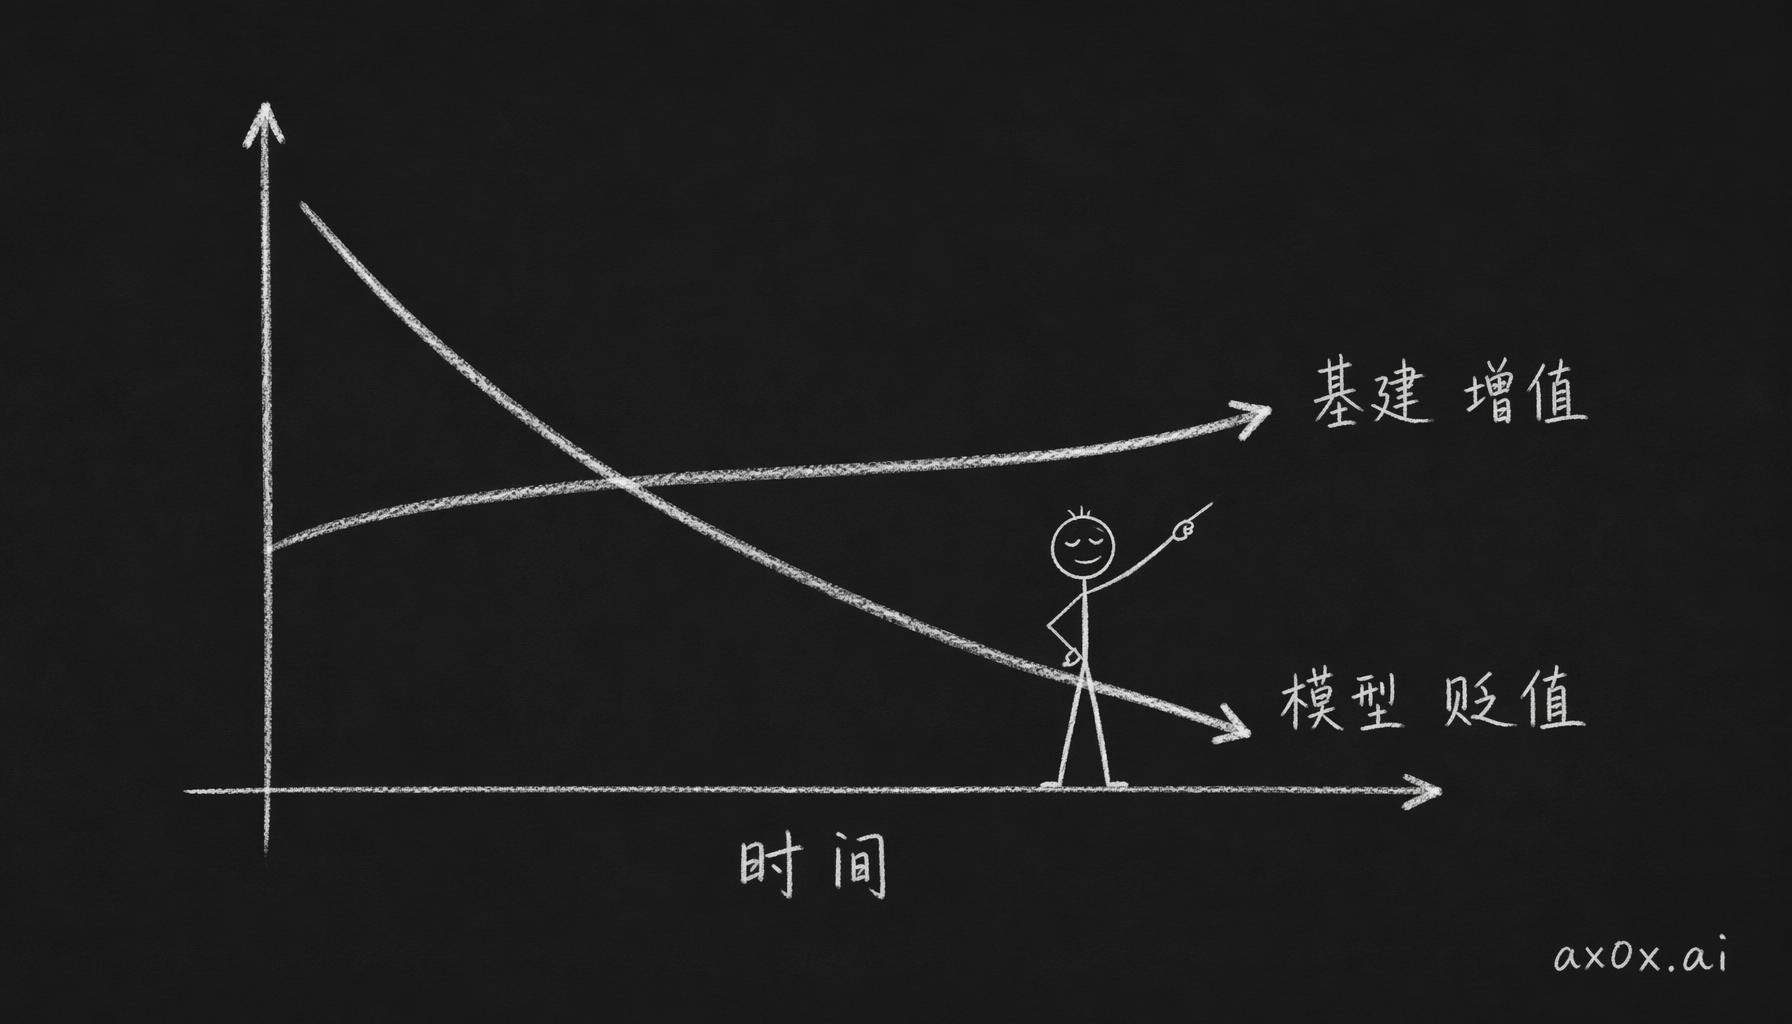 两条相反的价值曲线:模型价值随时间陡峭贬值,算力基建随时间保值增值,同一条时间轴上一条往下一条往上
所以硬件其实更像平台,模型更像跑在平台上的应用。赌某一个模型,跟 1998 年赌某一个网站差不多,押对了赚一笔,押错了就没了。赌算力基建,赌的是整个互联网的骨干网。我们公司做 GPU 融资就是这么想的,AI 不管往哪个方向变,最后总得跑在硬件上。
还有一个更大的变化一直在发生,只是没那么显眼。过去几十年,价值都堆在应用层,Office、Salesforce、Oracle,软件吃掉了世界。到了 AI 时代,钱开始往两头跑。一头是底层的算力基建;另一头我只能叫它认知积累,就是 AI 跟你处得越久就越懂你的那部分,这种理解没法复制。中间那层在被慢慢挤扁,代码、SaaS、大部分中低端模型,日子会越来越难过。开源模型在日常任务上已经不输两年前的前沿模型了。像 opus 4.6 这样的顶级模型,在复杂推理上还明显领先,也还有定价权,但「前沿」这条线一直在重划,今天的前沿,十八个月以后就是白菜价。所以夹在中间的模型这一层在贬值,倒是算力,不管钱往哪头跑,都绕不开它。
芯片这边还有件更有意思的事,跟钱关系不大。GPU、TPU、ASIC 三条路线在抢市场,表面上是 Nvidia 对 Google 对一帮新玩家,但你仔细看每条路线怎么取舍,就会发现它们赌的东西不一样,赌的是「智能到底是什么」。
- 走 GPU 这条路,就是认为智能还在变。既然不知道下一个突破在哪,硬件就得够灵活,什么架构来了都能跑。再加上 CUDA 生态一锁死,就算后面出了更好的芯片,换过去的成本也高到没人敢动。它背后的想法很简单,智能还在发散,未来说不准,灵活才是安全牌。
- TPU 赌的是矩阵运算就是机器学习里最重要的事。这个时间点挺有意思,Google 2016 年发 TPU v1 的时候,Attention Is All You Need 还没出来,那篇论文是 2017 年 6 月的。所以 TPU 立项时能赌的只有矩阵运算本身,后来 Transformer 统治了,刚好踩中。方向对了就往死里优化,定制互联、超大规模、整个系统一起调。这条路的想法正好反过来,智能已经在收敛,最核心的计算方式基本定了,剩下的全是效率问题。
- ASIC 不在前面这两头里面。它赌的是推理是主战场,计算模式已经摸清了,值得专门为它造一颗芯片。前提是计算模式不会再大变,真要变了,专用芯片就直接报废。三条路里它胆子最大。
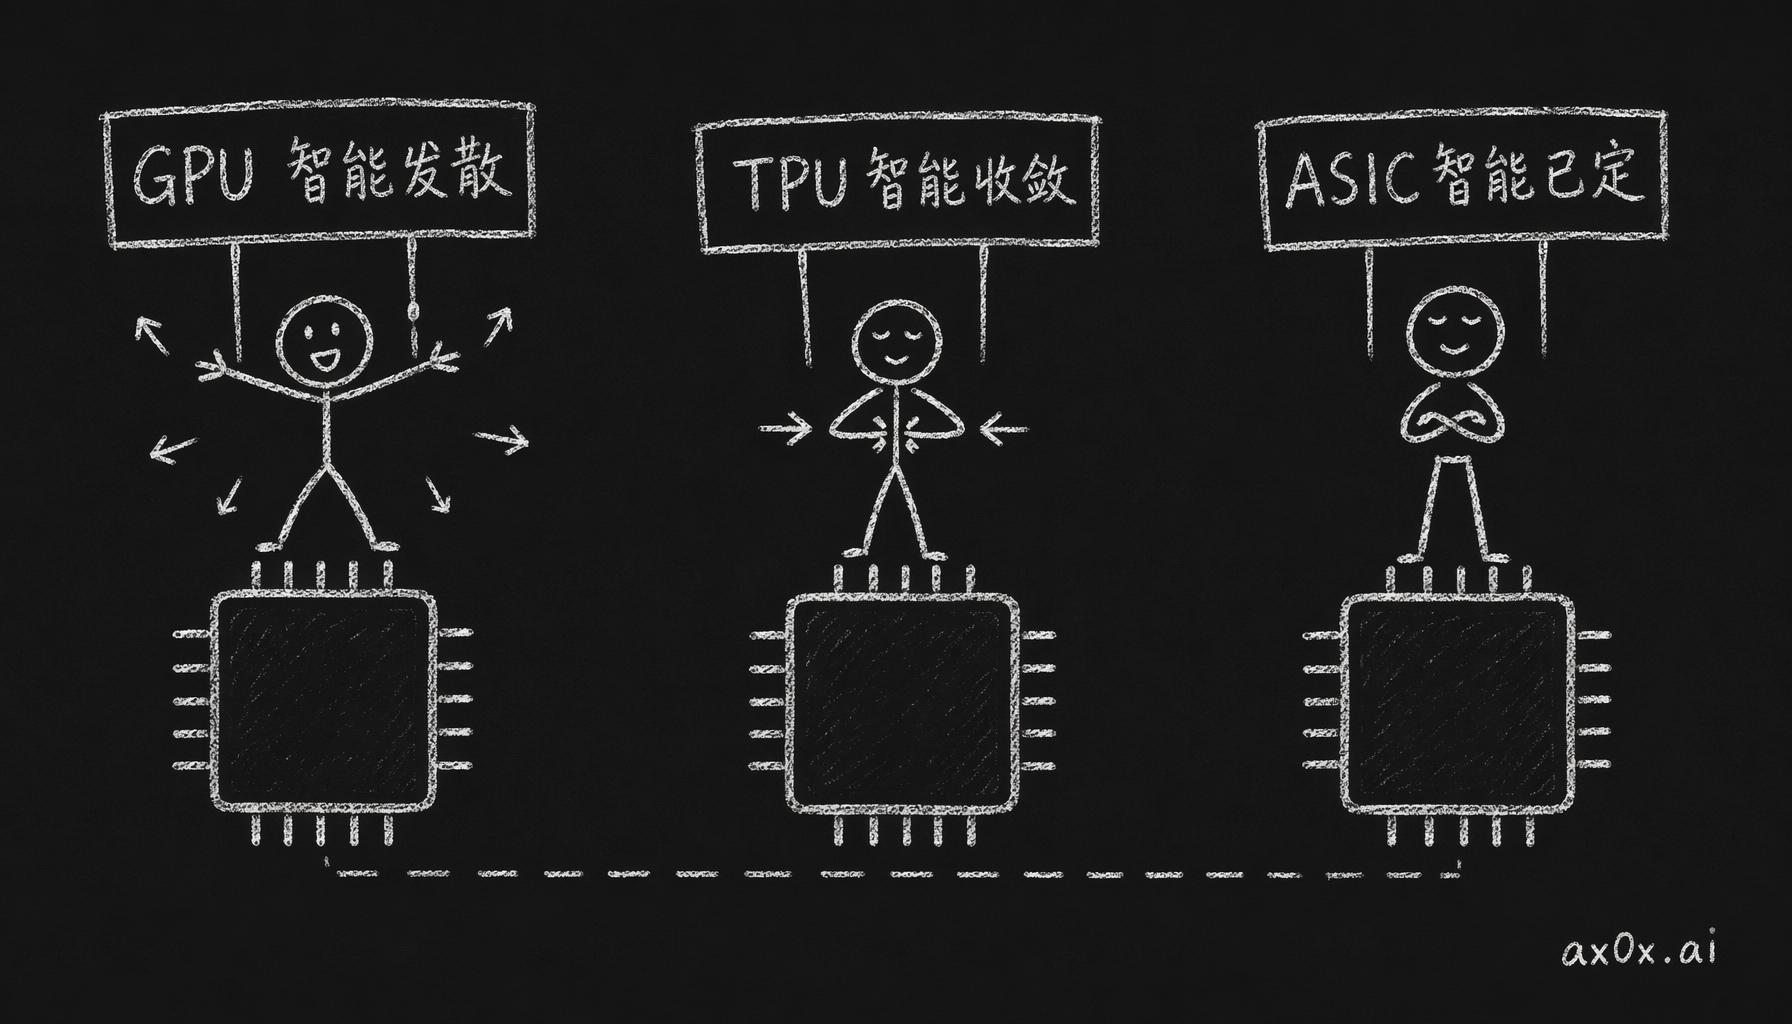 GPU、TPU、ASIC 三条芯片路线各押注一种对「智能是什么」的判断:智能还在发散、智能在收敛、智能已经定型
我觉得短期内 GPU 赢面还是最大,因为生态锁得太深,眼下灵活性最值钱。但 Transformer 从 2017 年一直统治到现在,快十年了,在迭代这么快的领域里,这已经算异数。要是再续上三五年,TPU 那条路只会越走越实。ASIC 风险最高,现在这套范式其实比大多数人以为的要稳,可真要来一次范式转移,它就全没了。最后谁赢,我觉得要看生态,技术倒在其次。
有人问过我一个挺直接的问题,说你白天做算力基建的 CTO,下了班又自己搓一堆小产品,不会精神分裂吗。我觉得正好反过来,两头都摸着,算力这件事在我脑子里才对得上。在 Compute Labs,我能看到成本曲线往哪走,谁家的芯片在迭代,谁在打价格战,推理需求涨得有多快。自己做东西的时候,我知道这条曲线落到地上是什么样子,一个功能做不做得起,一个想法是太早了,还是刚好到了该做的时候。一边让我看到大局,一边让我看到细节,少了哪边,这张图都拼不全。
往后三五年,方向其实挺确定的。模型还会变强,训练算力还在指数级地涨。推理还会变便宜,芯片在迭代,蒸馏在进步,价格战也越打越凶。Deloitte 预测,2026 年推理会吃掉总算力的三分之二,推理芯片市场会从两百亿美元跳到五百亿以上,全球 AI 数据中心的资本开支大概在四千到四千五百亿美元。短期内 GPU 还是缺,所以谁能拿到算力,谁能把算力用得高效,谁就有最硬的竞争优势。
反正我现在看 AI 的任何事,都会先捅到算力这一层看一眼。也不是每次都能捅出答案,但大部分时候,答案确实就在那一层。


