benchmark 分数和干活能力,越来越是两回事了
gpt 5.4 发布那天,我把它的 benchmark 成绩翻了一遍,横扫,数字确实漂亮。看完第一反应是拿个真题去跑一下。过去一年我在 gpt 和 claude 上烧了 30 亿多 token,95% 都是 agentic coding,claude code 和 codex 两边一起用,所以两边的手感我都有。benchmark 考的都是标准化的小题,我更想知道的是,拿一个真实的产品问题,很乱,好几个维度搅在一起,扔给两个模型,出来的东西到底能差多少。
正好做 Mio 的时候碰到一个很关键的选择,是继续走人设角色扮演的路线(每个角色有背景故事、有职业、有作息),还是转成通用的 AI 陪伴。这跟编程题没关系,是产品战略,市场研究、竞品分析、心理学、产品设计都得一起做,还要想清楚工程上怎么改。
测法大概是这样,我在 claude code(opus 4.6)和 codex(gpt 5.4)里敲了一模一样的 prompt。中英混着写,就是开发者自言自语那种,很长也很乱。人真在想难题的时候就是这样,不排版,也不会写「请结构化回复」。两个模型都能看 Mio 的 codebase,设置全用默认,同一个问题交给两个不同的大脑。
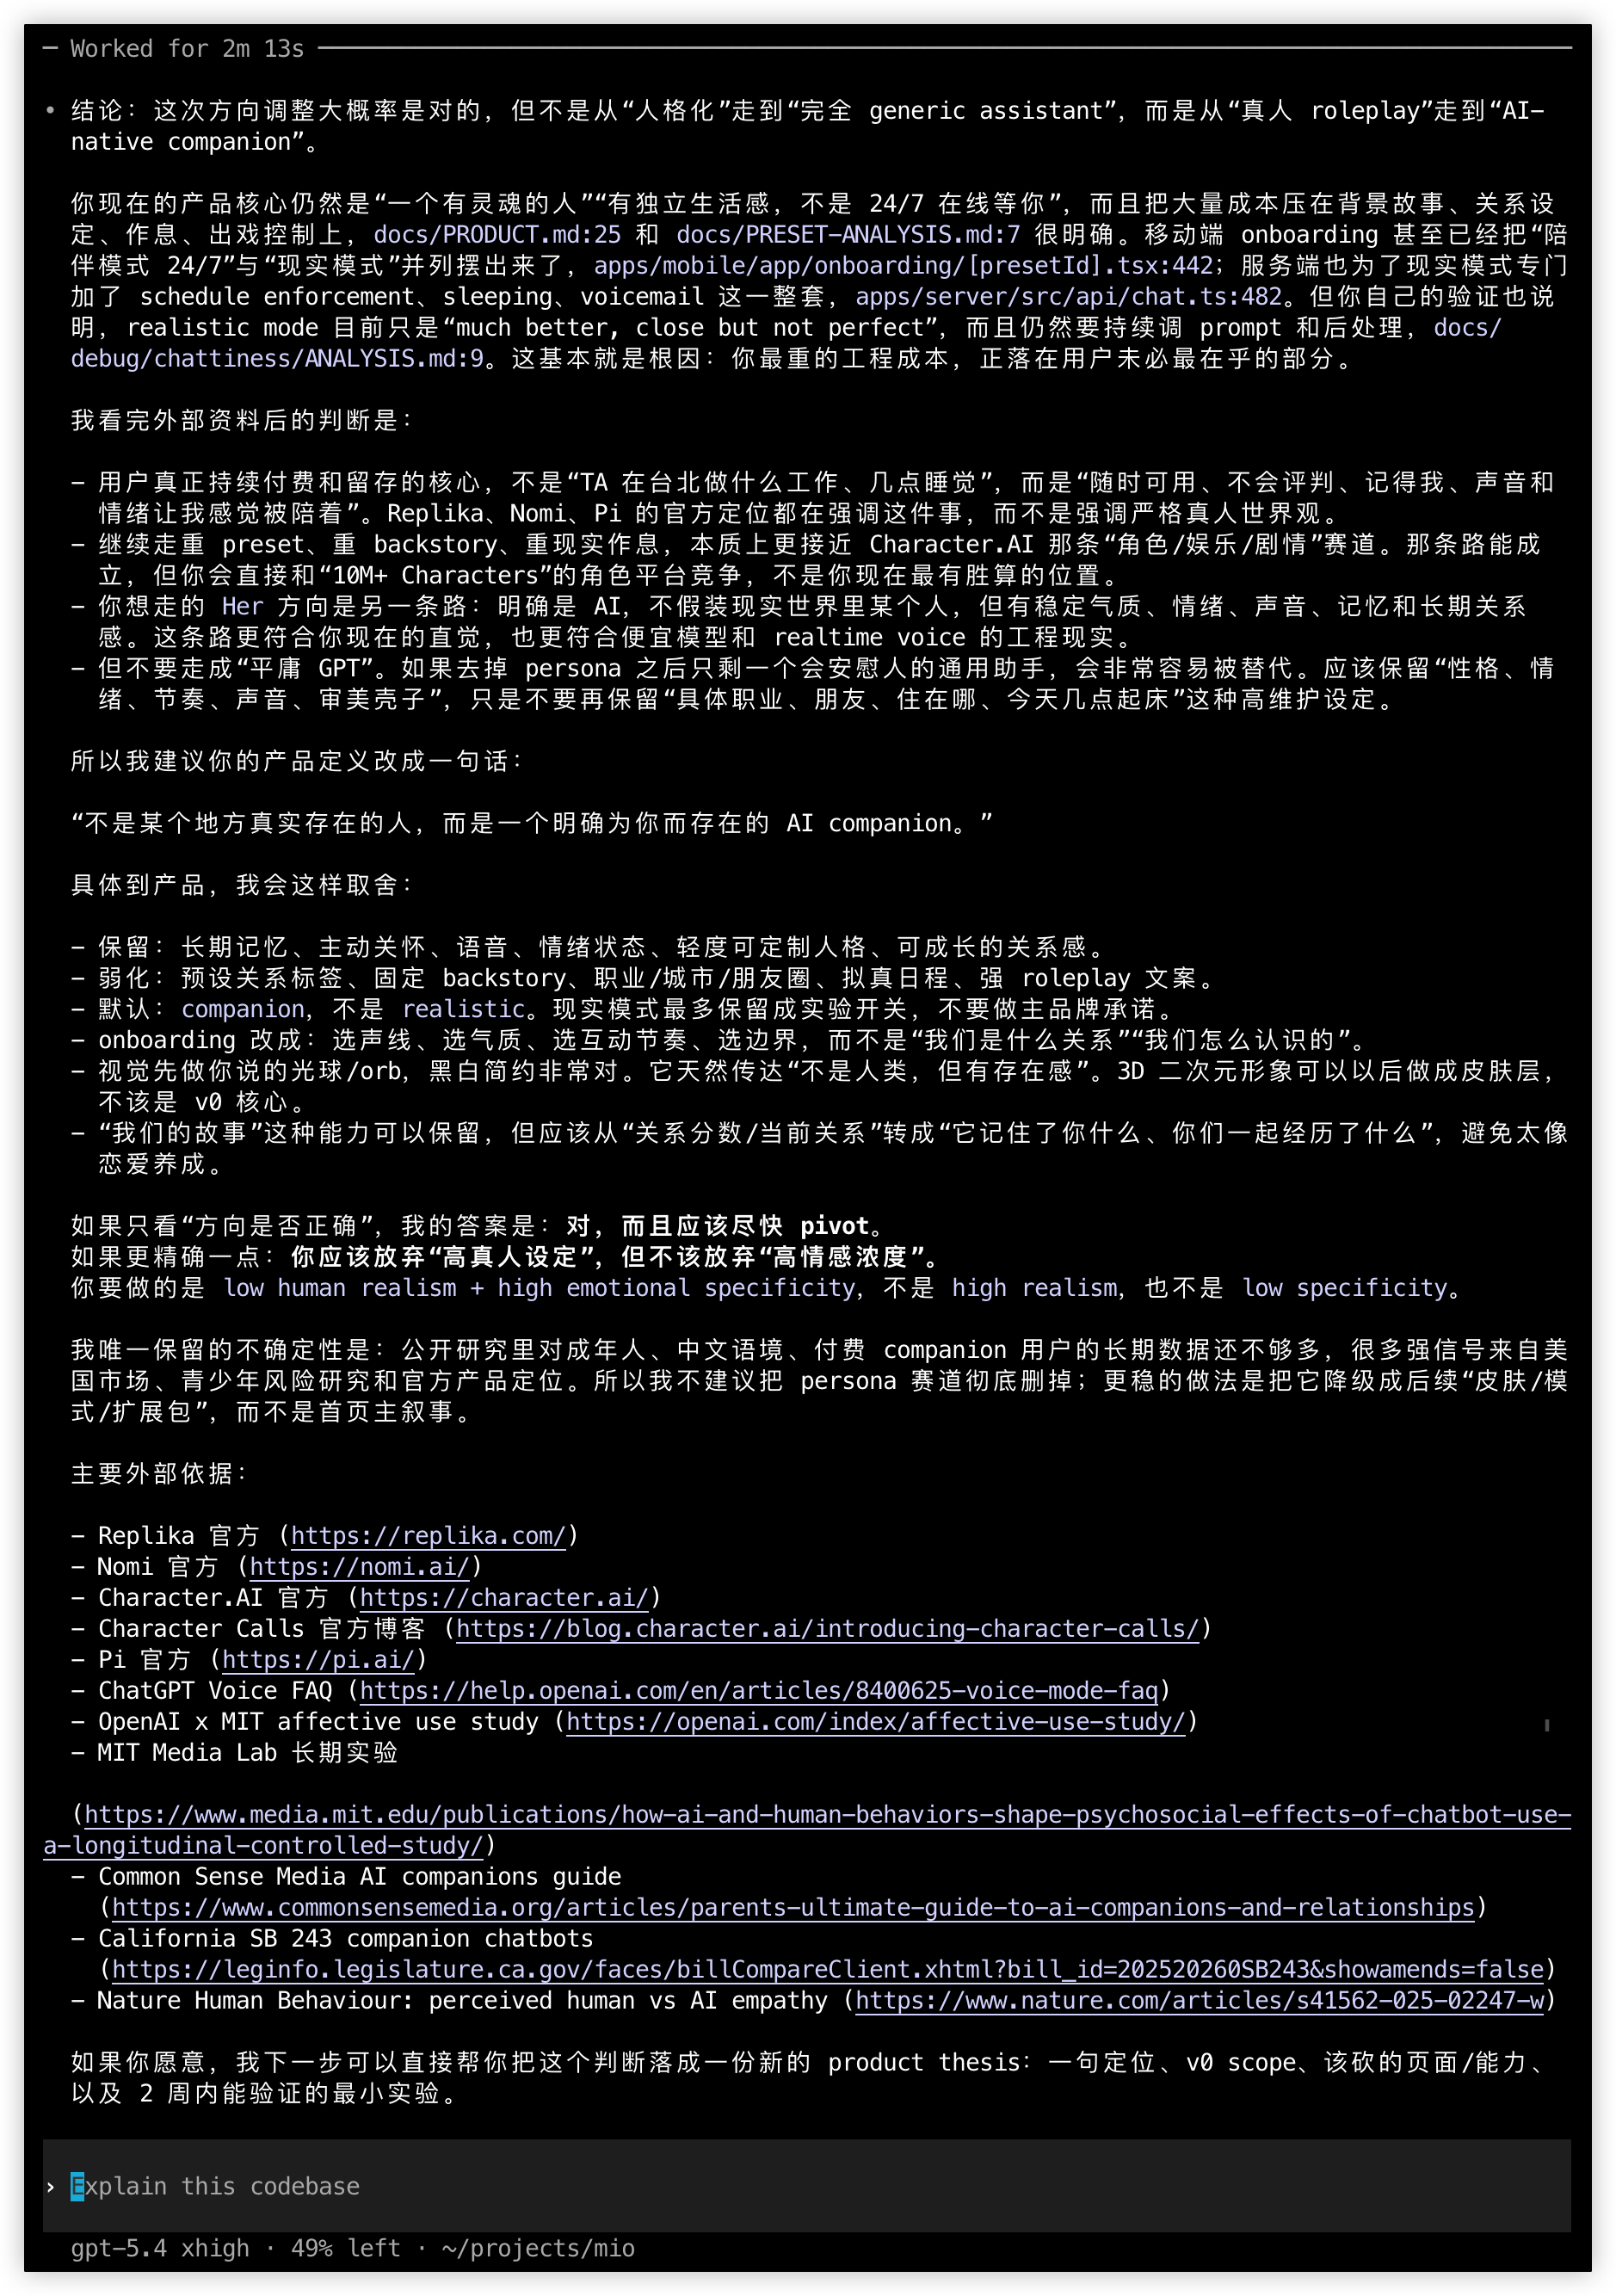 gpt 5.4 在 codex 中的输出
gpt 5.4 在 codex 中的回复——对 codebase 的感知强,市场研究偏浅
先说 gpt 5.4。代码读得很准,引用到了具体文件,像 docs/PRODUCT.md:25、apps/mobile/app/onboarding/[presetId].tsx:442、apps/server/src/api/chat.ts:482,知道东西在哪,引用也没毛病。大方向的结论也是对的,从「真人 roleplay」走成「AI-native companion」。有一句产品定义我觉得说得挺好:「不是某个地方真实存在的人,是明确为你而存在的 AI companion。」它还提了一个框架,"low human realism + high emotional specificity"(低真人感 + 高情感特异性),拿来当速记挺好用。
但紧接着它就开始给自己留退路了,「我唯一保留的不确定性是……」这种。严谨是很严谨,可我这时候要的是能帮我拍板的东西,保留意见帮不上什么忙。
整个输出基本是大段文字,表格少,数字少,外部来源大概引了 10 个。代码读得好,但市场研究和心理学这块没往深了做。只能说,gpt 5.4 给的是一个好顾问的第一轮意见。
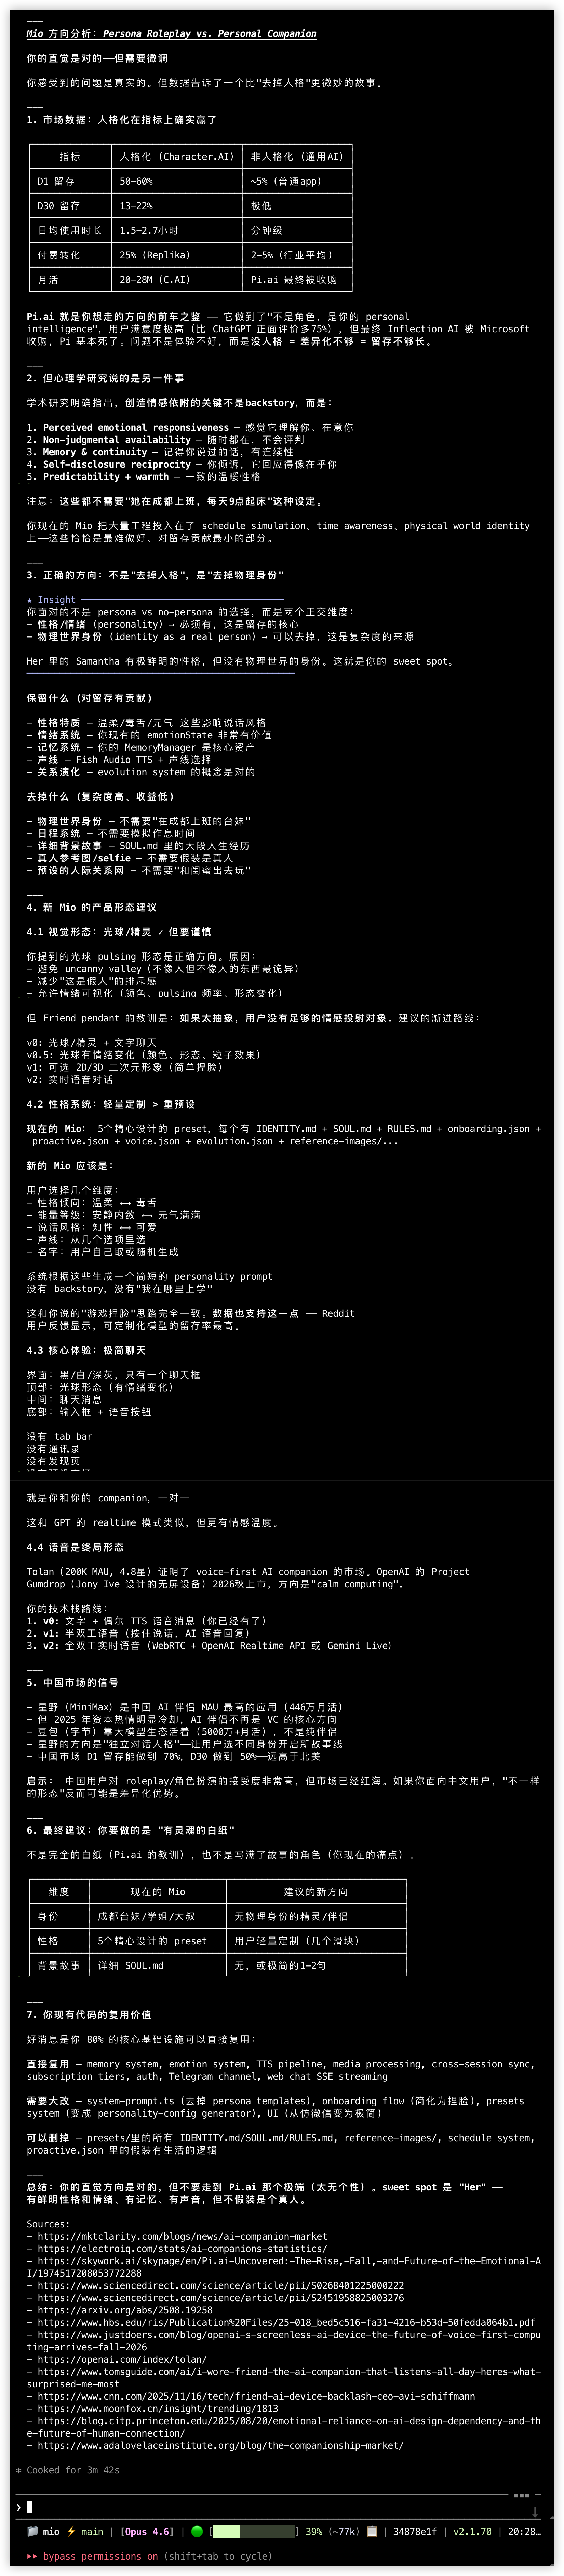 opus 4.6 在 claude code 中的输出
opus 4.6 在 claude code 中的回复——结构化研究,含市场数据、心理学框架和详细产品规格
opus 走的完全是另一条路。它没急着回答我的问题,自己先跑出去做了一轮调研。
第一个是市场数据,带数字的那种。直接甩了一张对比表出来:
| 指标 | Character.AI(人设模式) | 通用 AI 助手 |
|---|---|---|
| 次日留存 | 50-60% | ~5% |
| 日均使用时长 | 1.5-2.7 小时 | 分钟级 |
| 转化率 | ~25% | 2-5% |
你看,这里给的是具体数字,不是「人设类 app 留存通常更好」这种笼统的说法。具体数字我能直接拿去做决定,笼统的说法我还得自己再去查一遍。
第二个是 Pi.ai 的前车之鉴。我在考虑的「去人设」方向,Pi.ai 就是现成的前例,opus 自己把它挖了出来,还告诉我它为什么凉了:对话质量的正面评价比 ChatGPT 高 75%,但 Inflection AI 还是被微软收了,Pi 基本没了。没有人格,就跟别人拉不开差距,留存也就撑不住。拿掉 Mio 的人设,等于把 Pi.ai 走过的路再走一遍,而 Pi.ai 已经证明了「光温暖不够」。这个竞品分析我没要求它做,是它自己跑去找的。
第三个是心理学框架。它从学术研究里列了 5 个关键因素,说的是人为什么会对 AI 产生情感依附:
- 感知到的情感回应性——AI 好像「懂」你
- 无评判的陪伴可用性——随时在,从不批评
- 记忆与连续性——记得你们的对话和过往
- 自我披露的互惠性——也会分享关于「自己」的事
- 可预测性 + 温暖感——一致的人格,让人安心
这个列表里有一点我觉得很关键,这五条没有一条需要「她在成都工作,每天早上 9 点起床」。所以就算不编一个假身份,这五条也一条都不会少。
最值钱的是它把这个决定本身重新拆了一遍。问题不再是「要人设 vs 不要人设」,它拆成了两个独立的维度。一个是人格(沟通风格、情感模式、温暖感),这个必须留着;一个是现实世界里的身份(职业、住址、作息、背景故事),这个可以扔。两个维度是正交的,你完全可以做一个人格鲜明、情感丰富的角色,同时不假装它是个住在成都、每天挤地铁的真人。让人觉得别扭的是那个编出来的物理存在,人格本身没这个问题。
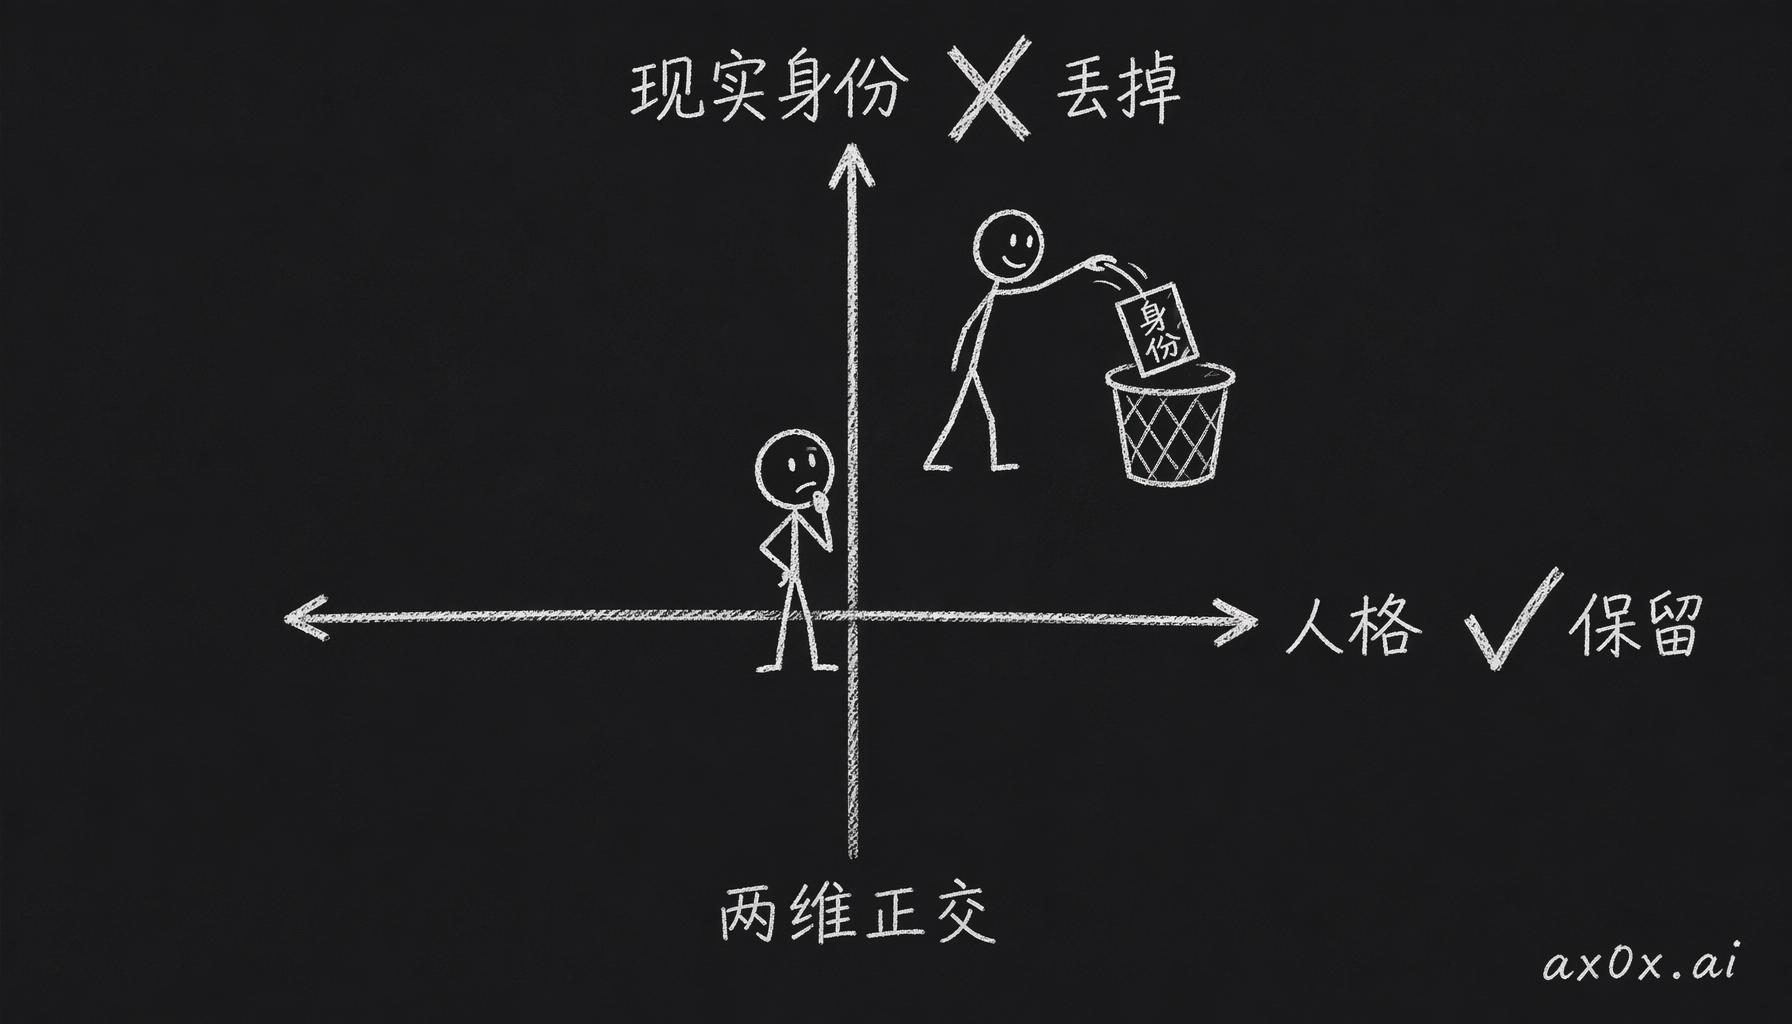 把「要不要人设」这一个决策拆成两个正交维度:人格保留、现实身份丢掉
这么一拆,我对 Mio 转型的想法直接变了。问题从「该不该保留人设」变成了「人设的哪些维度创造依附感,哪些制造违和感」,换成后面这个问法,能下手的地方就完全不一样了。
opus 到这儿还没停,后面又给了具体的 UI 布局、配色方案(黑/白/深灰)、一套把情感映射到光球上的系统、v0 到 v2 分版本的路线图、中国市场的数据(星野 446 万月活),还附了 15 个带 URL 的引用来源。代码这边它也看了能复用多少,哪些模块能直接用、哪些要改、哪些能删。
gpt 5.4 不差。方向判断是对的,codebase 读得准,产品直觉也没问题。要是没有 opus,我拿到 gpt 的输出会挺满意,直接接着往下干了。但两个一对比,差距就挺大了,opus 交出来的东西干脆是另一个品类。
| 维度 | gpt 5.4 | opus 4.6 |
|---|---|---|
| codebase 感知 | 强——引用具体文件和行号 | 强——映射可复用模块 |
| 战略方向 | 正确 | 正确 |
| 市场数据 | 浅——概括性陈述 | 深——表格 + 具体指标 |
| 竞品分析 | 提到了竞品 | 找到精确前例(Pi.ai)及其失败模式 |
| 研究深度 | ~10 个来源 | 15+ 个来源带 URL |
| 心理学支撑 | "情感特异性"(好直觉) | 5 因素学术框架 |
| 结构化思维 | 段落文字 | 表格、框架、正交分解 |
| 可操作性 | "你应该转型" | 具体 UI 规格、配色、路线图、模块映射 |
| 中国市场 | 提到了 | 具体数据(星野 446 万月活) |
再回头看 benchmark 到底说了什么。gpt 5.4 发布当天的数字确实漂亮:
| benchmark | gpt 5.4 | opus 4.6 | 差值 |
|---|---|---|---|
| OSWorld-Verified(桌面导航) | 75.0% | 72.7% | +2.3 |
| GDPval(知识工作) | 83.0% | 78.0% | +5.0 |
| GPQA Diamond(推理) | 94.4% | 91.3% | +3.1 |
| BigLaw Bench(法律) | 91.0% | 90.2% | +0.8 |
| Toolathlon(工具使用) | 54.6% | 44.8% | +9.8 |
| BrowseComp(网页浏览) | 82.7% | — | — |
| SWE-Bench Verified(编码) | — | 80.8% | — |
| ARC-AGI-2(新颖推理) | — | 68.8% | — |
gpt 5.4 赢了 5 个类别,gemini 3.1 pro 赢 4 个,opus 赢 3 个,纸面上 gpt 5.4 就是 benchmark 冠军。但我上面刚跑完一个真实任务,这个 benchmark 冠军交出来的东西明显更弱。为什么会这样?
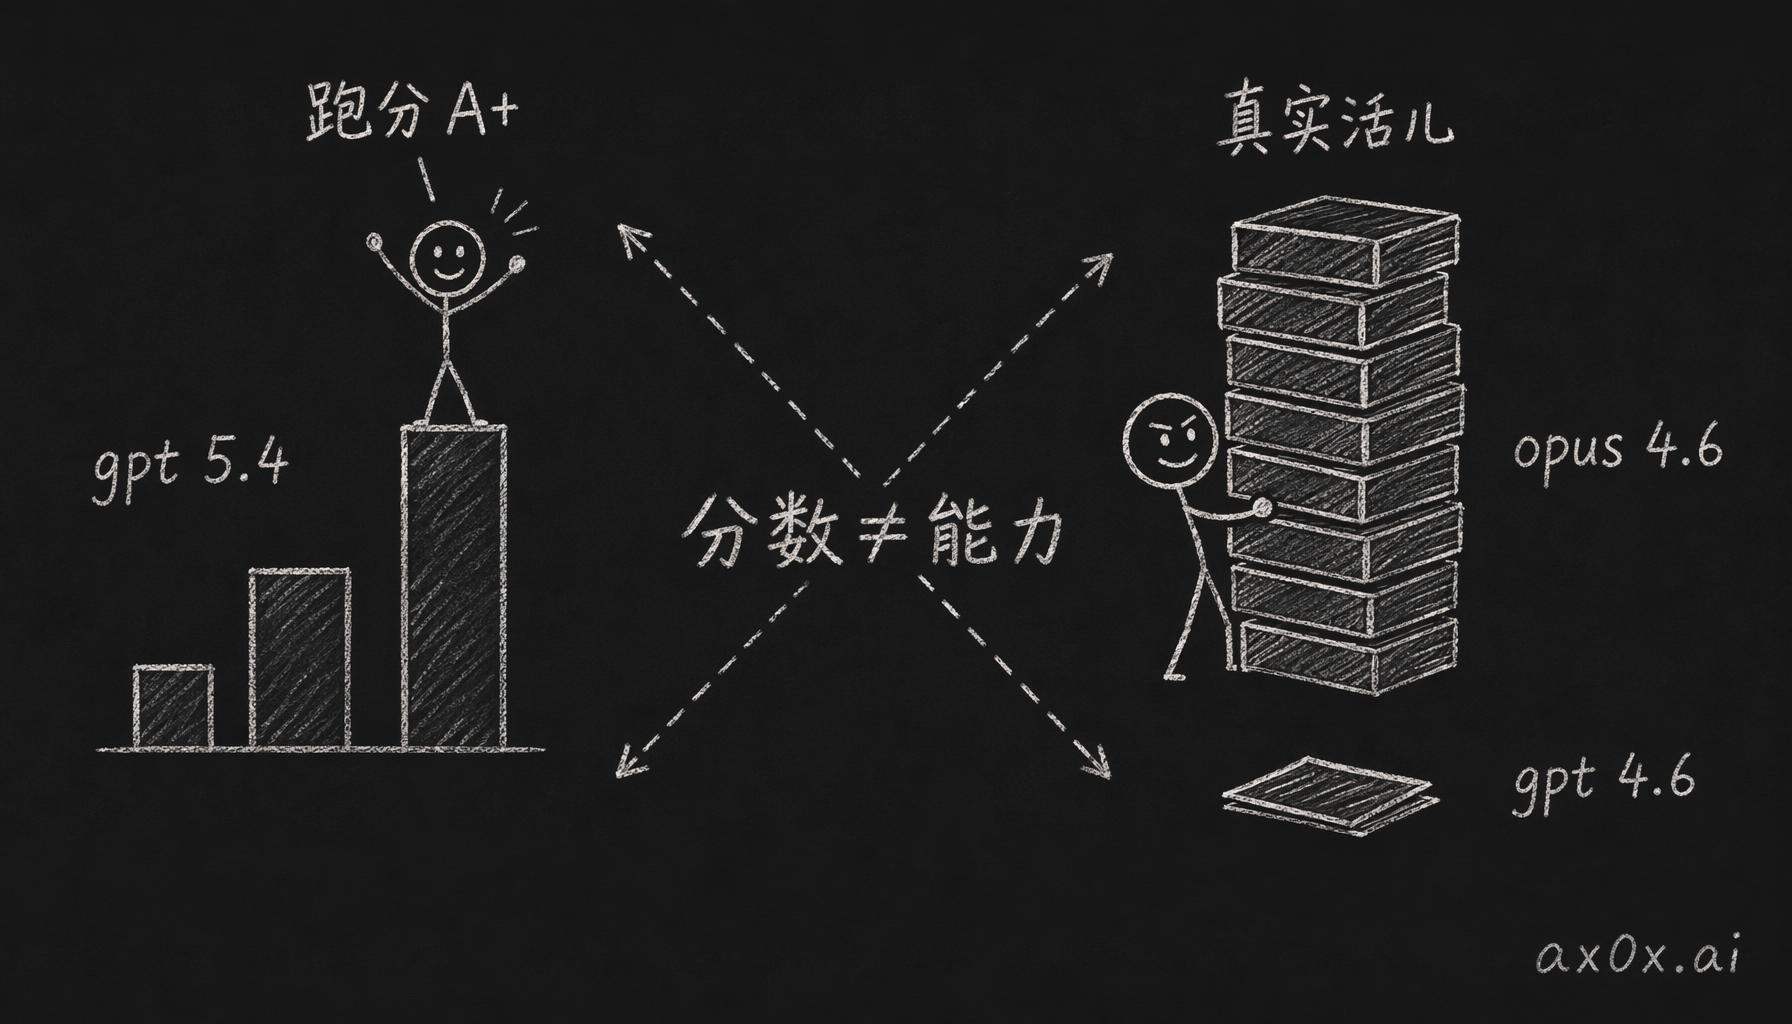 跑分榜和真实干活能力正在分叉——纸面冠军 gpt 5.4 反而在真实任务里更弱
我觉得是 benchmark 这套评估方法本身出了问题,不止「特定任务测不到」这么简单。大概有这么几条:
- 考卷已经饱和了。头部模型在 MMLU 上 88%+,GSM8K 上 99%,所有人都考 A+,这张卷子就分不出高低了。
- 分数和实战经常对不上。Stanford HAI 和 Confident AI 的研究发现,评测里 90 多分的 agent,放到生产环境经常掉到 60 多分。代码生成更夸张,在合成的 benchmark 上表现很好,一到真实 codebase,准确率直接崩到个位数。
- 考题泄露了。有独立分析发现,SWE-bench 大约三分之一的 issue,报告或评论里直接就写着解决方案;另外还有三分之一,测试写得不够,修错了也测不出来。三分之一的题答案就印在旁边,这个分数你能信多少?
- 有现成的反例。gemini 3 pro 2025 年 11 月拿下 benchmark 冠军,两个月之内,前沿编码的活里基本就没人用它了。Nathan Lambert 在 Interconnects 上直接说,这是 benchmark 预测不准最清楚的一个例子:纸面上赢了,实战里输了。他这个观察我觉得挺准的。
- 连裁判都不太靠谱。用 LLM-as-Judge 的时候,同样两个回答换一下位置,前后判断一致的只有 6/10;光靠摆位置,弱模型就能在大多数测试上「击败」强模型。
还有一个变量,benchmark 表格根本测不到。你真干活的时候,用的从来都是模型 + harness + 工具这一整套系统。在 claude code 里,opus 有 web search、file system、parallel tool execution,还有一整套专门为 agentic 工作设计的对话架构;在 codex 里,gpt 5.4 拿到的是另一套工具和另一套 orchestration。同一个模型换个 harness,做出来的东西天差地别。
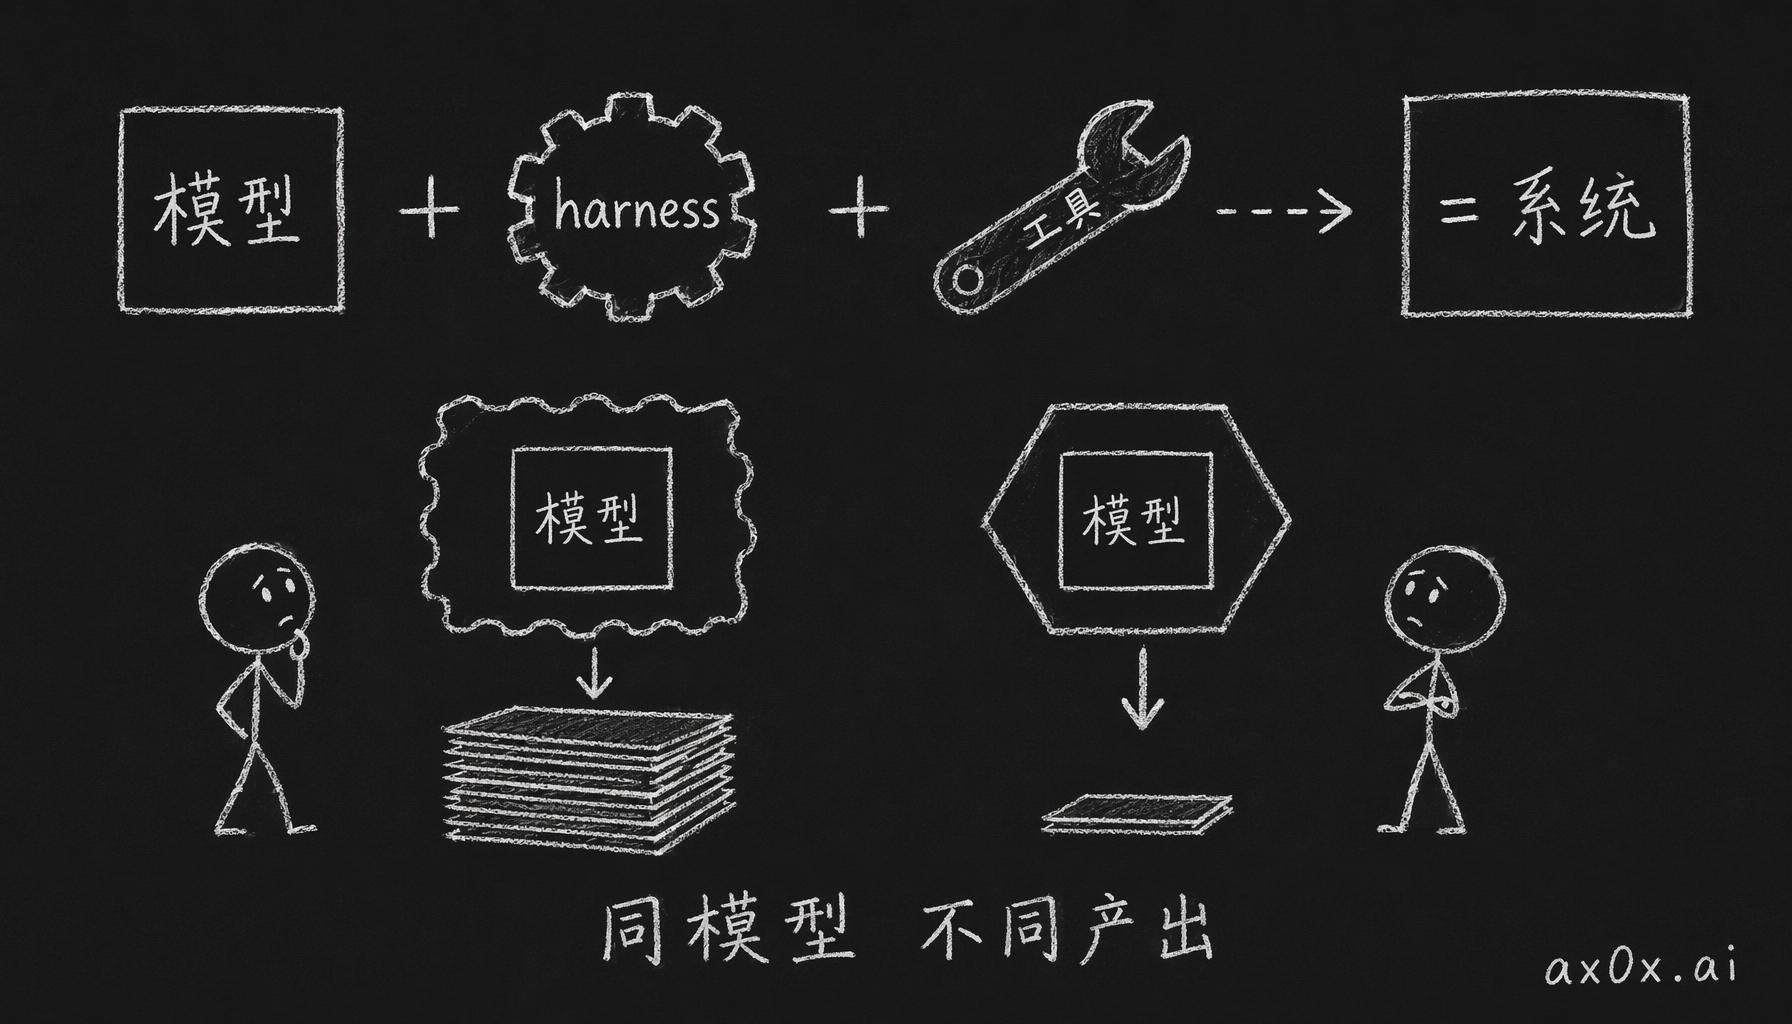 真正干活的是模型加 harness 加工具这一整套系统——同一个模型换个 harness,产出天差地别
Lambert 预测,行业会从比裸模型的分数,转到评估整套系统。我只能说,一线干活的人早就转过来了。我认识的人里,在生产环境跑 AI 的,没有一个关心 GPQA Diamond 的分数。大家关心的是把手头最难的问题扔给这个系统,它能不能吐出一个拿来就能照着做的东西。
我说的 builder,是不只把 AI 当代码生成器,还拿它当思考伙伴去处理复杂决策的人。对这些人来说,我觉得最重要的是两件事。
第一件,模型会不会主动去查你不知道的东西。opus 跑了 web search,找到学术论文,拉了市场数据,挖出了 Pi.ai 这个前例;gpt 是用已有的知识在回答,答得不错,但少了那一步「让我去查查」。做复杂决策的时候这一步很值钱,因为最关键的信息(比如 Pi.ai 是怎么死的)往往就是这一步查出来的。
第二件,输出有没有形状。一份有表格、有框架、有正交分解的输出,跟一大段「一方面……另一方面……」的文字比,好用程度完全不一样。真要做决定的时候,你得有个结构,能把各种取舍一项一项摆出来掂量,光靠感觉不行。
回头看这次测试,opus 给了我新东西,直接改了我对 Mio 转型的想法;gpt 更多是把我大致已经想到的又确认了一遍。
所以我现在是这么用的。gpt 5.4 我不会停用,写代码、快速分析,还有靠模型已有的知识就够的活,它都干得很好;agentic coding 的工作流里两个模型我都在重度用,日常编码用 gpt 完全没问题。但碰到难题,比如产品战略、架构决策、「帮我想想」这种,我会选 opus。倒不是看 benchmark,纯粹是用了一年攒下来的手感。
行业为什么这么执着于 benchmark,我能理解,分数能量化,能放进表格里宣布谁赢了。如果你也要给真实的工作挑模型,我说的不是编程谜题,也不是问答,是那种很乱、牵扯好几个维度、还得去调研的问题,那建议你自己跑一次,把手头最难的问题扔给两个模型比一比。我反正就是这么选出来的。