
几万张 GPU 是怎么连成一台机器的
把几万张甚至几十万张 GPU 摆进一座机房,最怕的是一张慢卡或者一根堵死的网线拖全场的后腿。整个集群跑得有多快,卡在最慢的那张卡和最挤的那根线上,所以机房的网络拓扑从一开始就得跟建筑楼板图画在一起。
上一篇讲了电网一抖机房靠什么撑过去,电是顺着铜排往机柜里灌的,数据走的是另外一套管子。在 AI 机房里,数据挪窝分 3 个尺度。第 1 层在单个机柜里面,叫 scale-up(纵向扩展),几十张卡贴在一起高速互连。第 2 层在同一栋楼的机柜之间,叫 scale-out(横向扩展),把成百上千个机柜连成一张大网。第 3 层跨出大楼,把不同城市甚至不同州的园区连起来。英伟达 2025 年 8 月发布 Spectrum-XGS 以太网时,直接管这一层叫 scale-across(跨园区扩展)。
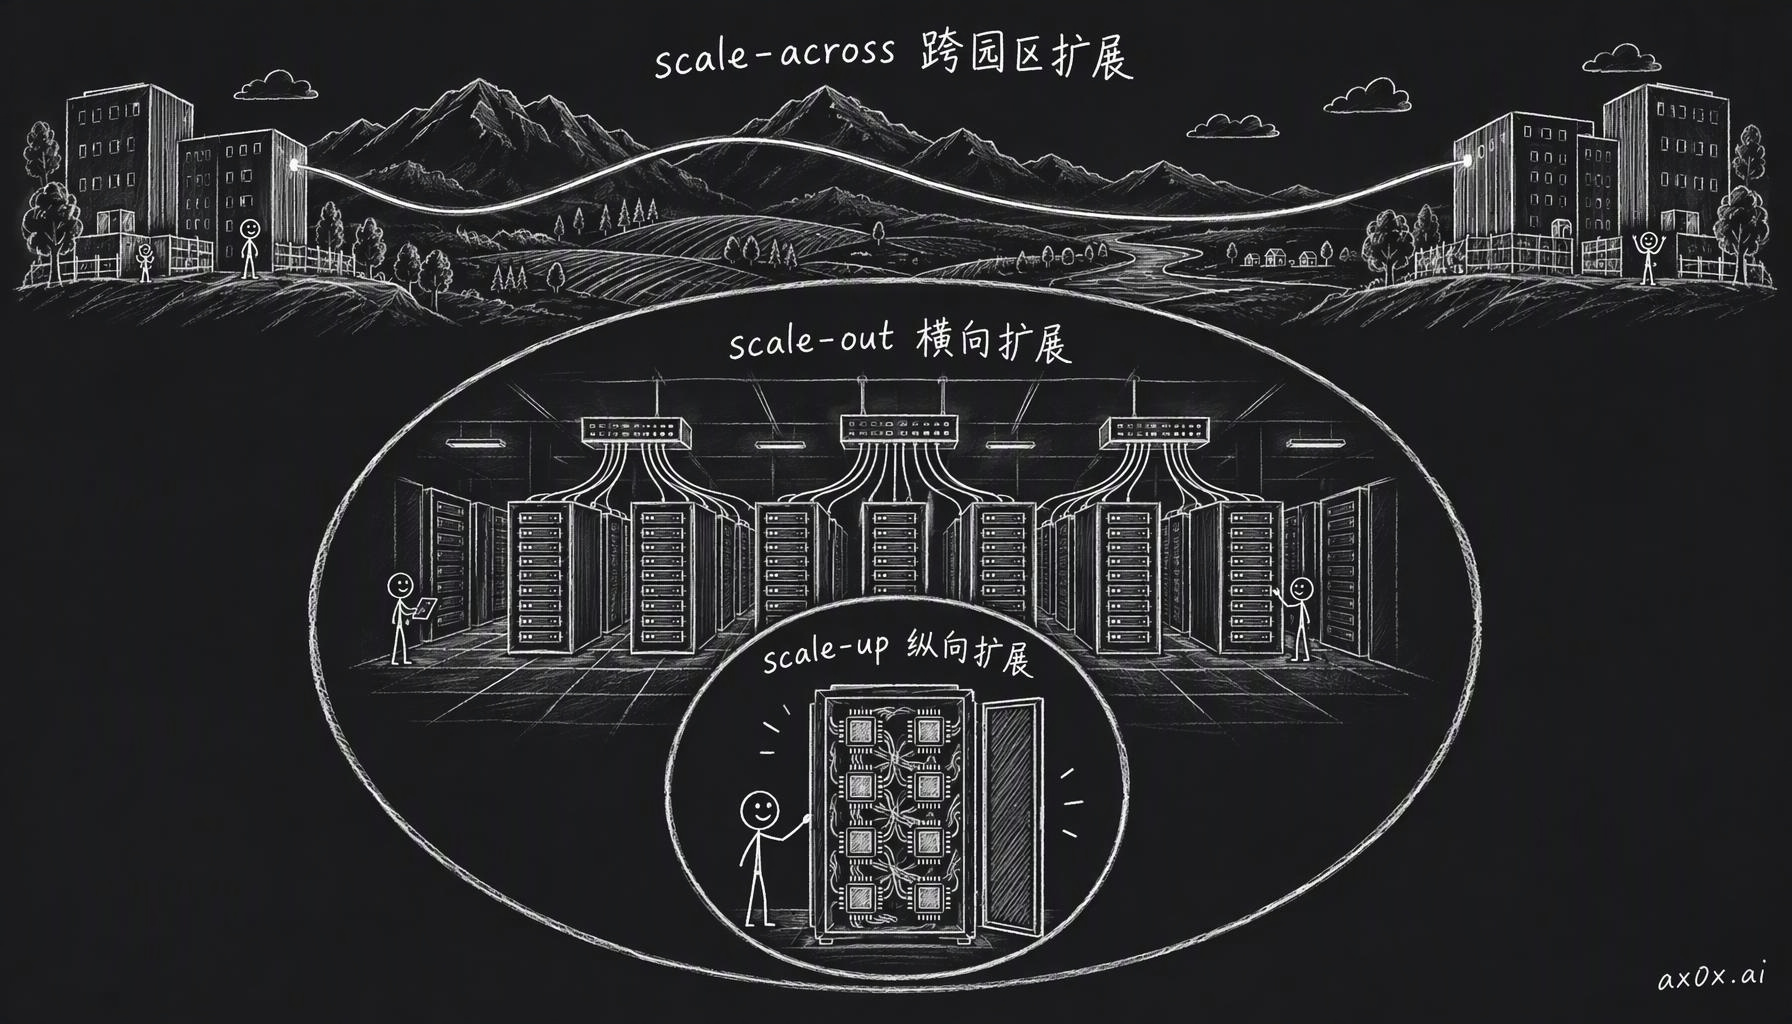 数据挪窝分三个尺度:scale-up 在单个机柜里用 NVLink 高速互连,scale-out 在同一栋楼的机柜之间组网,scale-across 用光纤把不同城市的园区连起来
为什么要分这 3 层?因为跑推理和跑预训练对网络的胃口差得太远了。拿 Moonshot AI 2026 年 7 月发布的 Kimi K3 来算。它是个 2.8 万亿参数的 MoE 模型,按 FP8 每个参数 1 字节算,权重大约 2.8 TB。一台 GB200 NVL72 机柜的 72 张 GPU 加起来有大约 13.4 TB 的 HBM 显存,装下它还绰绰有余。做推理服务,用户多了就多摆几台机柜,多跑几个独立副本。当然,真到大规模上线,像第二篇讲的把 prefill 和 decode 拆开跑,或者把专家并行铺得很宽,也会跨机柜通信。
到了预训练,1 台机柜就远远不够看了。2024 年 Meta 训 Llama 3.1 405B 的时候,在一栋楼里动用了超过 16,000 张 H100 GPU 一起算。上万张卡每算一步都要互相通气,网络搭得好不好,直接决定买来的芯片是在干活还是在干等。
机柜里和机柜外差了 9 倍带宽
先看最里头这一层。单张 GPU 干活的时候,权重、激活值和 KV cache 从芯片旁边的 HBM 显存搬进张量核心(tensor cores)里做矩阵乘法。一旦模型大到 1 张卡装不下,需要 1 台机柜里的 72 张卡合伙算,数据就得走机柜内部的 NVLink 网络。
拿英伟达的 GB200 NVL72 来说,整台机柜就是一个 72 卡的 NVLink 域,机柜中间塞了 9 台 NVLink switch tray(交换托盘)。每张 Blackwell GPU 能拿到 1.8 TB/s 的 NVLink 带宽,整台机柜合起来有大约 130 TB/s 的无阻塞总带宽。72 张卡并没有两两之间各拉一根线,那样背板早塞爆了。实际做法是每张卡都连到那 9 台交换托盘上,任意两张卡说话都只经过 1 跳交换机转发,而且不管谁跟谁连都能跑满全速。
这里顺手拆一个 Kian 在课上拿来打趣的「老黄算术」(Jensen math)。看网络硬件的参数表,有两个坑最容易把人绕晕。第一个是比特(bit)和字节(byte)的差别,1 字节等于 8 比特,小写 b 的 Gb 是千兆比特,大写 B 的 GB 是千兆字节,数字看着差了 8 倍。网络行业几十年来一直习惯按比特报线速,这倒算不上英伟达一家的把戏。但第二个习惯确实是芯片大厂写宣传稿的套路,就是把「发出去」和「收进来」两个方向的带宽加在一起报总数。比如单卡 NVLink 的 1.8 TB/s(这里是字节),其实是 18 条链路、每条双向 100 GB/s 加出来的总和,单看发或者单看收,单向带宽是 900 GB/s。
哪怕按单向 900 GB/s 算,机柜里面的带宽依然富裕得惊人。可数据一出这台机柜,去找隔壁机柜的 GPU,带宽就掉下来一大截。
在今天绝大多数机房里,NVLink 只留在机柜内部。也有少数例外。GB200 NVL36x2 把 72 张卡拆到相邻的 2 个机柜里,合成一个 NVLink 域。英伟达在 GTC 2026 上放的路线图里,2028 年的 Feynman 一代要用光电共封装把 NVLink 拉出机柜,做到 NVL576 甚至 NVL1152 的规模。但在眼下,跨机柜通信基本都走 scale-out 网络,用 InfiniBand 或者以太网。
数据跨机柜的路程要绕得多。它先从 GPU 出来,走进服务器里的网卡(NIC),转成光信号钻进光纤,跑进网络交换机里绕一圈,再顺着光纤进对面机柜的网卡和 GPU。在 GB200 NVL72 上,每张卡一般配 400 Gb/s 的 ConnectX-7 网卡;到了更新的 GB300 NVL72,每张 GPU 配上了 800 Gb/s 的 ConnectX-8 SuperNIC 网卡。注意单位换成了小写 b 的 Gb/s。GB300 的 800 Gb/s 除以 8,换成字节只有 100 GB/s,而且这是单向的数。
按同一个口径比,NVLink 单向是 900 GB/s,网卡单向是 100 GB/s,差了 9 倍。所以 Kian 反复念叨软硬件必须绑在一起设计。像张量并行这种切分模型的方法,卡和卡之间每算一层都要高频交换中间结果,就得死死摁在同一个机柜的 NVLink 域里跑。反过来,盖预训练机房要是在跨机柜网络上省钱,机柜里的 NVLink 再快也没用。上万张卡会有很多时间卡在跨机柜那根慢管子上干等,买卡的钱就白花了一大块。
交换机往上少插一半线,跨组传数据耗时就变成 2 倍
既然跨机柜带宽这么金贵,几万张卡是怎么用网线和交换机拼起来的?拿英伟达上一代 H100 的机房硬件来拆,账最清楚。
一台 DGX H100 服务器里装着 8 张 H100 GPU(一个 SuperPOD 机柜里会塞 1 台、2 台或者 4 台这样的服务器)。每张 GPU 配 1 张 ConnectX-7 InfiniBand 网卡,走 PCIe 5.0 x16 通道连到主板上,单卡速率 400 Gb/s(50 GB/s)。网线从服务器后面拉出来,插进 1U 高的 Quantum-2 QM9700 InfiniBand 交换机。这台交换机前面板上排着 32 个 OSFP 插笼,每个笼子插一个双端口光模块或线缆,分出 2 个 400 Gb/s 端口,整台一共 64 个口。英伟达标的 51.2 Tb/s 总吞吐,又是把两个方向加在一起算的。
1 台交换机只有 64 个口,连几万张卡靠的是叶脊拓扑(leaf-spine)。第一层叫叶交换机(leaf),直接往下连服务器;第二层叫脊交换机(spine),专门在上面把所有叶交换机串起来。同一台叶交换机底下的服务器互传数据,在叶交换机里打个转就到了;要是找另一台叶交换机底下的服务器,就得先往上走 1 跳到脊交换机,再往下走 1 跳到目标叶交换机。Kian 把它比作 CPU 的缓存层级,你在 L1 缓存里拿数据最快,一旦得往上翻一层去 L2 甚至内存里拿,每多走 1 跳,延迟就加一截。
这里最要紧的是叶交换机的口怎么分,多少个往下接服务器(下联口,downlinks),多少个往上接脊交换机(上联口,uplinks)。
下面是 Kian 课上算的简化版。真实的 DGX H100 SuperPOD 用的是「轨优化」接法,每台叶交换机从 32 台服务器里各接同一个编号的 GPU,8 台叶交换机一起管这 32 台服务器。接法不一样,带宽的账是一样的。拿 1 台 64 口的叶交换机,32 个口往下接 4 台 8 卡的 DGX H100 服务器,刚好连满 32 张 GPU;剩下 32 个口全往上连脊交换机。往下是 32 个 400 Gb/s,往上也是 32 个 400 Gb/s,上下带宽比是 1 比 1。这叫无阻塞(non-blocking),底下 32 张卡同时满速往外发数据,往上走的车道也完全够用。
可脊交换机和光模块都是钱。如果往上少插一半线,会怎么样?
跟着 Kian 算笔小账。假设叶交换机底下接了 4 个 400 Gb/s 的服务器口,下联总带宽 1,600 Gb/s;但往上只接了 2 根 400 Gb/s 的上联线,上联总带宽只有 800 Gb/s。上下比例变成 2 比 1,行话叫 2 比 1 超配(oversubscription)。同理,64 口交换机拿 32 个口往下、只留 16 个口往上,也是 2 比 1 超配。
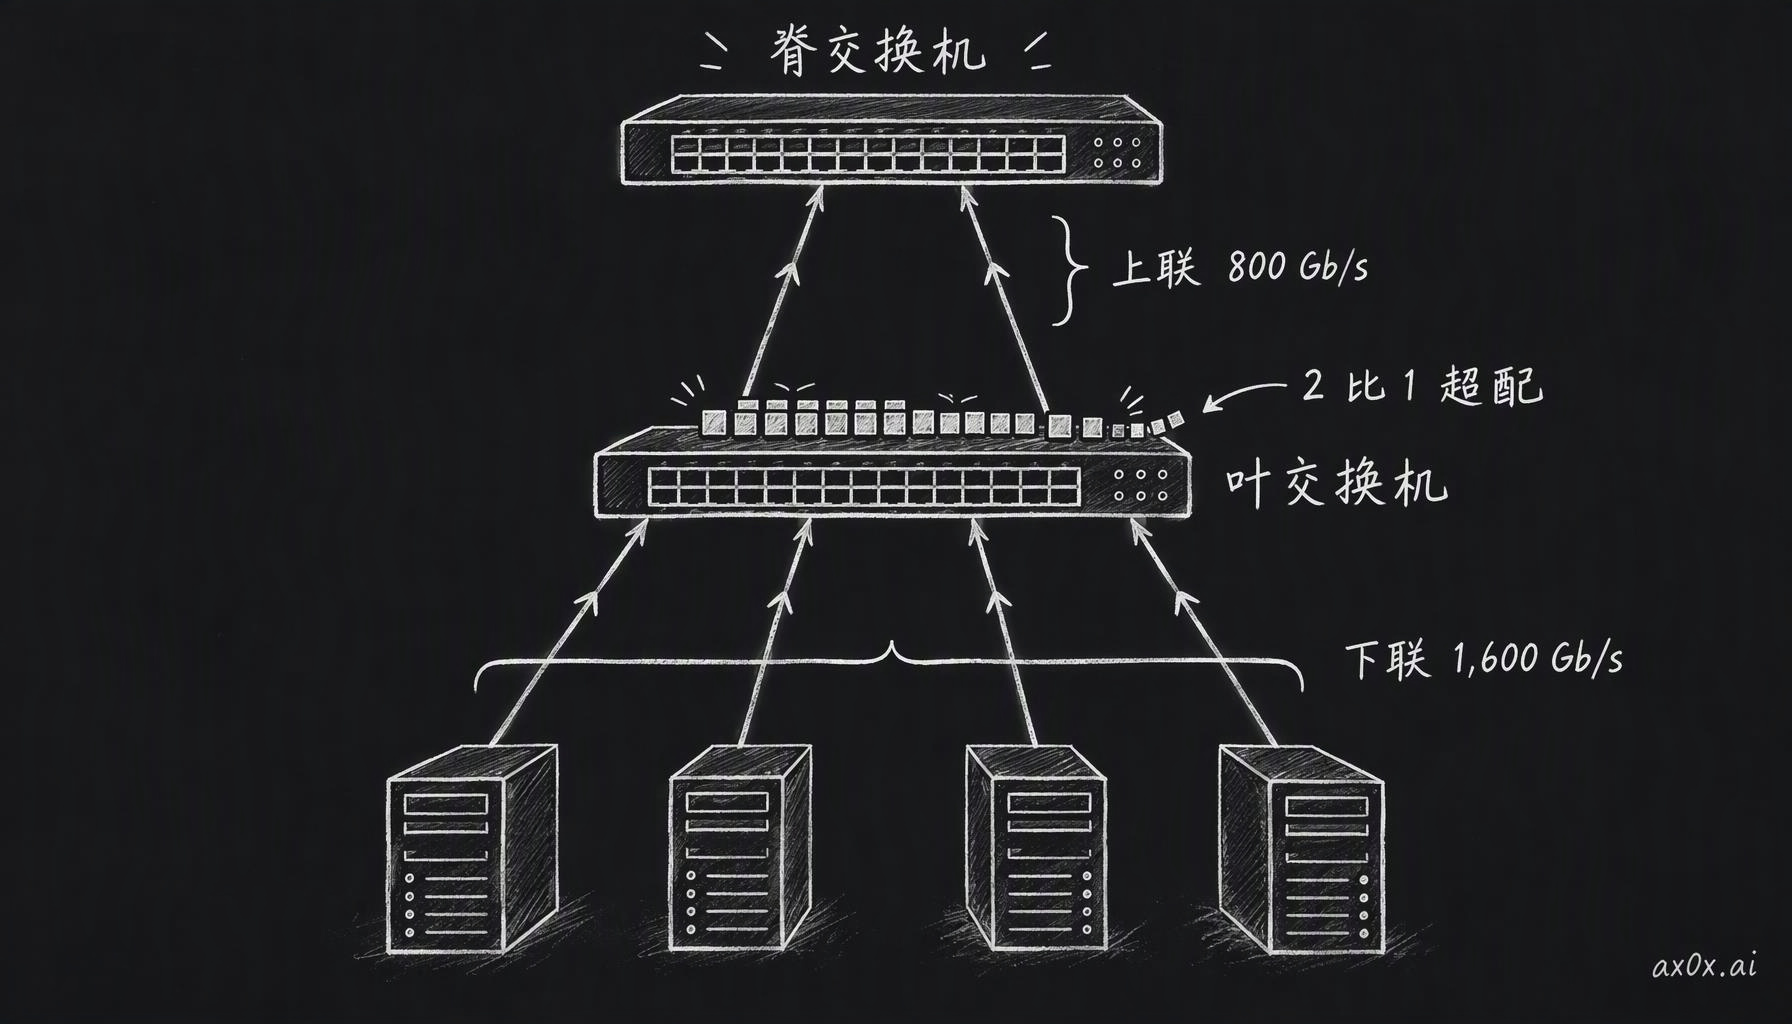 2 比 1 超配:叶交换机底下的服务器下联总带宽 1,600 Gb/s,往上连脊交换机的上联只有 800 Gb/s,大家一起往外发数据时,出口就排起长队
只要底下几台服务器在叶交换机内部互传,超配毫无影响。可要是它们一起往别的叶交换机发一块 256 Gb(32 GB)的数据,1 比 1 满配时出口有 1,600 Gb/s,最快 0.16 秒传完。2 比 1 超配时出口只有 800 Gb/s,最快也得 0.32 秒,时间翻了一倍。这还是不算协议开销的理论下限。要是好多发送端在同一瞬间往同一个接收端或者同一根窄上联口猛灌数据,把交换机缓存撑爆,还会引发排队丢包,叫作 incast(多对一拥塞)。
那超配就一定碰不得吗?我看也未必,得看你往窄管子上放什么流量。
2024 年 3 月,Meta 公开了两座 24,576 张 H100 集群的架构。两座集群单卡都是 400 Gb/s,一座用英伟达的 Quantum-2 InfiniBand,另一座用开放标准的以太网加 RoCE(用 Arista 7800 加 Meta 自己的 OCP 交换机),Llama 3.1 405B 就在那座 RoCE 集群上训出来。两套网络都开了 RDMA(远程直接内存访问),网卡直接把数据写进远端服务器内存,绕开 CPU 拷贝的开销;RoCE 就是把 RDMA 跑在以太网上。
在那个 RoCE 集群里,Meta 就故意做了超配。他们把 24,576 张卡分成 8 个 pod,每个 pod 装 3,072 张 GPU。每个 pod 里面是 1 比 1 满带宽,最吃带宽的张量并行和流水线并行都放在 pod 里跑。把 8 个 pod 连起来的最外层,超配拉到了 7 比 1,往上走的带宽只剩往下的七分之一。这一层主要跑数据并行,它每次迭代最后才同步一回,对延迟宽容得多。Kian 说得很实在,花大价钱买回来的网络到底能用出几成,得看路由选择、拥塞控制、集合通信软件,还有任务摆在哪些机器上,这 4 件事配不配合。
谷歌用小镜子给芯片改道,自研芯片的大厂连拓扑一起改
叶脊网络很常见,但大厂自己造芯片的时候,网络拓扑也跟着一起改。比如亚马逊的 Trainium2,在 16 卡服务器里用 2D 环网(torus,每颗芯片只和身边几个邻居直连,首尾再接成环),在 64 卡的 UltraServer 上用 3D 环网,这套纵向互连叫 NeuronLink。跨机柜横向扩展走的是亚马逊自家的 EFA 网络。
把定制拓扑玩得最绝的是谷歌的 TPU。谷歌的训练集群从 TPU v4 开始就用 3D 环网(3D torus),后面的 v5p、现在全面商用的第 7 代 Ironwood,一直到 2026 年 4 月 Cloud Next 上刚公布的第 8 代训练芯片 TPU 8t,都没换。第 8 代还有一颗推理芯片 TPU 8i,谷歌说两颗都在 2026 年晚些时候全面上线。每颗 TPU 用一种叫 ICI(芯片间互连)的链路,直接和上下、左右、前后 6 个邻居连着。
拿公开细节最多的 TPU v4 pod 来说,1 个 pod 有 4,096 颗芯片,分成 64 个计算块(block),每个块按 4×4×4 排成 64 颗芯片的小立方体(谷歌公开的那张 TPU 机房照片只拍了八分之一个 pod,也就是 8 个块)。把这 64 个小立方体连起来的,是 48 台自研的 Palomar 光路交换机(OCS)。
普通交换机得先把光信号转成电信号,拆包看地址,再转回光信号发出去。谷歌的 OCS 压根不拆包,里面是 3D-MEMS(微机电系统)硅片,每块上造了 176 面微反射镜,挑出最好的 136 面用,做成 136×136 端口的全光交换机。另有一束单独的光打在镜子上,摄像头盯着它来校准镜子的角度。哪根光纤要连哪根光纤,直接转动小镜子把光束反射过去,全程没有光电转换。
我觉得这套小镜子最厉害的地方,是能帮大集群在训练中途绕开坏节点。几千张卡连着训几个月,中间坏几块硬件是免不了的。2023 年谷歌训 Gemini 1.0 Ultra 时,每个 SuperPod 里都留了热备的 4×4×4 计算块,线上哪个块坏了,OCS 在大约 10 秒钟内就能转好镜子绕开故障块,把备用块拼进新的 3D 环网接着训。
不过 3D 环网也有软肋,芯片只连身边 6 个邻居,对角线通信得一格一格跳。到了 2026 年 4 月发布的第 8 代 TPU,谷歌干脆按工作负载把拓扑劈成两半。搞训练的 TPU 8t 继续用 3D 环网,单 superpod 扩到 9,600 颗芯片。推理用的 TPU 8i 换成了 Boardfly 架构,谷歌说它借鉴了蜻蜓拓扑(dragonfly),这种拓扑以前多用在 HPE Slingshot 这类超算网络上。MoE 推理里到处是全员对全员(all-to-all)通信,最怕跳数多。换成 Boardfly 后,在大约 1,000 颗芯片的规模下,最远两颗芯片之间从 16 跳降到了 7 跳。
几米用铜线,几百米用光纤,再省电就得把光引擎塞进芯片封装
拓扑图定好之后,施工拉线选什么介质?规矩很朴素,只要距离够得着,哪个便宜省事就用哪个。
高速电信号在铜线里跑,线一长就会衰减变形。在 400G 速率下,英伟达的 LinkX 无源铜缆(DAC)最长也就 2 米左右,有源铜缆能撑到大约 3 米。无源铜缆便宜又省电,机柜内部够得着的地方大多用它(铜和光的物理分界可以翻看光通信系列的第二篇)。
跨出机柜到了几米开外,就得换光纤加两头的光模块做光电转换。50 米以内,比如同排机柜连叶交换机,用 400G SR4 多模光模块配 OM4 多模光纤。到 500 米以内,比如跨大厅连脊交换机,就得换成 400G DR4 单模光模块配单模光纤。多模和单模里光速一样,延迟都是每公里大约 5 微秒。区别在玻璃纤芯粗细。多模纤芯粗,同一束光进去会沿着好几条角度不同的路径(模式)弹着走。跑远了,各条路径到终点的时间错开,脉冲就糊成一团(模态色散),所以跑不远。单模纤芯极细,只容得下 1 条路径,脉冲跑远了也不散,所以距离一长,单模能跑的带宽比多模高得多。
光在玻璃丝里跑几百米几乎不费电。费电的是交换芯片到面板光模块那一段电路板走线,线路损耗大,两头得靠耗电的电路把信号硬推过去。为了把这段高损耗电通道砍短,行业开始推光电共封装(CPO),把光引擎挪进交换机内部,跟交换芯片封在同一块基板上。Kian 把它跟第四篇里紧贴 GPU 的稳压器(VRM)放在一块比,都是为了把最费电的那段电路径缩到最短。
英伟达自己宣称,他们的 CPO 交换机比插拔式光模块方案能效高 3.5 倍。2026 年 CPO 先用在交换机上。英伟达的 Quantum-X Photonics InfiniBand 交换机已经有客户在部署,Spectrum-X Photonics 以太网交换机 8 月也宣布了全面量产,博通也有自己的 CPO 交换机。CPO 装到 GPU 自己的 scale-up 互连上,按英伟达的路线图要到 2028 年的 Feynman。光引擎和芯片封在一起以后好不好修、总账怎么算,封装之战那篇里讲过。
跨园区的专线图的是路上不堵车
当一个训练任务大到一栋楼的电都喂不饱,就得走到第 3 层跨园区网络 scale-across,把几座数据中心绑在一起。
机房里的光纤先从集群连到路由器,过配线架(patch panel)理顺,再进大楼的运营商交接间(meet-me room),跟 AT&T 等运营商或者云厂商自己的私网光缆接上。这里有个基建上的两难。为了防挖掘机一铲子挖断线,机房会从 3 个不同方向引入 3 条光纤管道。进楼以后要是图省事,3 条线全汇进 1 个交接间,这个房间就成了单点故障。屋子一出事,外面挖 3 条沟的冗余就白费了。想彻底冗余,就得花钱修 3 个独立的交接间。
光纤出了楼,物理定律就卡死了延迟底线。光在光纤里每秒大约跑 200,000 公里,是真空光速的三分之二左右,算下来每公里要 5 微秒。两座机房相距 100 公里,单程就要 0.5 毫秒,往返延迟(RTT)最少 1 毫秒。按谷歌 Jeff Dean 早年那张著名的延迟表,同一数据中心内部往返约 0.5 毫秒,从加州发包去荷兰再回来是 150 毫秒。
微软的 Fairwater 是个现成的例子。它在威斯康星州 Mount Pleasant 的园区 2025 年 9 月亮相,亚特兰大的园区 2025 年 11 月亮相,两地之间拉了一条专用广域网,叫 AI WAN,微软管这套组合叫「AI 超级工厂」。既然光速改不了,微软为什么还要专门强调这条专线?
两地相隔约 1,130 公里(约 700 英里)。就算光纤拉成一条直线,按每公里 5 微秒算,单程也要 5.6 毫秒,往返 11 毫秒起步,真实线路只会更长。微软说它过去一年在全美新增了超过 120,000 英里光纤。这么下本钱,图的是路上不排队,光速它是改不了的。普通互联网上到处是别人的流量,包进路由器得排队。这条专线上只有微软自家 AI 机房的流量,按微软的说法是零拥塞,几乎贴着光速跑。2023 年谷歌跨多个数据中心训出 Gemini 1.0 Ultra,靠的也是自家跨园区骨干网,在单个 SuperPod 内跑模型并行,跨数据中心跑数据并行。
为了压低园区内部延迟,微软还把 Fairwater 盖成了罕见的 2 层楼。AI 机房一般只盖 1 层,一台 GB200 NVL72 机柜就重约 1.4 吨,放到 2 楼得把楼板做得特别结实。微软偏要盖 2 层,省地皮是一方面,官方给的主要理由是延迟。机柜上下叠着摆,线拉得更短,一个园区里几十万张 Blackwell GPU 就能挂在同一张扁平的低延迟网络上。大厂手里的加速卡加起来已经上百万张,但单个园区最大也就几十万张这一档,比如据报道 xAI 在孟菲斯的几个园区加起来在 55.5 万张左右。微软还说,Fairwater 的网络是照着训「几百万亿参数」模型的规模设计的。Kian 对这句挺怀疑,觉得真到模型那么大那天,今天这批机房早就淘汰了,反倒是地下那套不堵车的专用光纤网最实在。
最慢的那张卡拖住所有人,喂数据的存储也得单独规划
为什么延迟多几毫秒就值得这么折腾?因为分布式训练是所有人绑着腿跑,最慢的那个节点决定全队的速度。
在数据并行训练里,每轮反向传播算完梯度(gradients)后,所有服务器要做一次全员归约(all-reduce),把梯度汇总求平均才能往下走。Kian 举了个算例,4 台服务器一起同步梯度,3 台花 20 毫秒传完,第 4 台因为网络拥塞花了 50 毫秒。那前 3 台只能停在原地干等,这一步全员耗时就是 50 毫秒。放大到几万张卡的集群里,只要 1 个上联口堵了或者 1 张网卡慢了,几万张芯片就得一起停工陪它罚站,功耗还会瞬间掉下去,拉出第五篇讲过的那种让电网头疼的锯齿波。
除了卡间通信,机房里还有一套专门给 GPU 喂数据的存储网络。如果每次训练都临时去慢硬盘里翻数据、现做清洗,GPU 照样得饿肚子。Meta 2022 年 1 月公布 Research SuperCluster(RSC)时,第一期装了 6,080 张 A100,背后配了三级存储,最大的一层 175 PB,缓存层 46 PB,还有一层 10 PB 的高速共享闪存。Meta 用自家的 AIRStore 把数据集清洗一次,之后反复用。Kian 提醒说,这两百多 PB 存储和专用网络自己就要吃掉一大块机房面积、供电、散热和走线预算,做预训练必须单独规划,只做推理的机房则会轻松很多。
落到你自己用 AI 上,你平时调 API,背后的一个模型副本多半就待在 1 台机柜里,卡和卡之间走 NVLink,用不着出柜。训下一代模型就不一样了,几万张卡每走一步,都得等最慢的那张把梯度传完。我觉得这套网络的大头开销,主要是训练在付。几万张 GPU 全速跑起来,热量又往哪儿排?这是下一篇要算的冷却和水耗账。
本系列整理自 freeCodeCamp 上 Kian(@neuralkian)的课程「Inside an AI Factory – Power, Cooling, and GPUs Explained」(课程原名 From Watts to Tokens,讲义在 kiankyars.github.io/gigawatt)。框架和大部分例子是 Kian 的,我按主题重新编排、核对了数字,理解有偏差的地方锅在我。文中提到的公司只是例子,不构成任何投资建议。