
模型长什么样,机房就得长什么样
很多人以为盖 AI 数据中心是土木和电工的活,先把水泥浇好、把机柜摆满,再去管上面跑什么模型。这个顺序其实是反的。模型怎么服务用户,决定了每个用户要吃掉多少显存和带宽,水泥还没浇下去之前,工作负载就得先定死。
上一篇讲到,现在卡住机房上限的最细那根管子是电。黄仁勋在 2026 年 6 月初的 Computex 2026(也叫 GTC Taipei 2026)主题演讲里把话挑明了。他的意思是,给你固定 1 GW 的电,机房能赚多少钱,就看每瓦电能吐出多少 token(throughput per watt)。
这句话听着像一句口号,拆开看全是硬邦邦的物理账。同样是一柜子 72 张卡的 GB300 NVL72,接短问题还是接长文档,给每个用户每秒吐 100 个 token 还是 300 个 token,同时能接待的人数能差出 8 倍左右。Kian 在课上把这件事拆成了 3 个层面的问题,模型自己占多少地方、怎么把 token 喂给用户、底下的耗电曲线长什么样。要算清楚 1 瓦电到底能换几个 token,得先钻进 GPU 里面,看看模型吐出一个字要干哪些活。
吐出第一个字和吐出后面的字,干的完全是两码事
平时大家总把大模型训练和推理混在一块说,其实它们折腾硬件的方式差得很远。训练一个模型,每一步都要走完固定的 3 个动作,先往前算一遍预测结果(forward pass),再倒着算一遍误差梯度(backward pass),最后用优化器更新一遍权重(optimizer update)。单个模型太大,1 张 GPU 装不下,工程师就用各种并行策略把模型切碎分摊到成百上千张卡上。训练是拿海量文本一遍遍去调权重,拼的是整个集群加起来每秒能做多少次浮点运算(FLOPs)。
推理就不一样了。推理不改权重,它的活就是接住用户的提问(prompt),一个接一个往外蹦 token(1 个 token 大致是一个词或者词的一部分)。你平时在聊天框里看 AI 回答问题,看着屏幕上的字往外跳,底下其实分成了脾气完全相反的 2 个阶段,第一步叫 prefill(预填充),第二步叫 decode(解码)。
假设你给模型丢了一篇 1,000 个 token 的文档让它总结。在它吐出第 1 个字之前,得先把你输入的这 1,000 个 token 一口气全塞进模型里过一遍。这一步就是 prefill。prefill 干的核心活,是把这 1,000 个 token 里每个词代表什么意思、和前后文有什么关系,算成两组向量存起来,也就是 Key(键)和 Value(值),合起来叫 KV cache(键值缓存)。你可以把 KV cache 想成模型读完你那段话之后写下的「阅读笔记」,Key 像是笔记上的索引标签,Value 就是对应的内容摘要。
为什么要费劲记这份笔记?因为到了第二步 decode,模型每次只能往外蹦 1 个新的 token。蹦出第 1,001 个 token 之后,它要把这第 1,001 个 token 也塞回去,再去算第 1,002 个。如果没有刚才那份阅读笔记,每多蹦 1 个字,它都得把前面那 1,000 多个 token 从头到尾重新算一遍,算力根本扛不住。有了 KV cache,前面的词不用重算,每次只要拿新蹦出来的那个词去翻之前的笔记就行。
省下了重复计算的算力,就得拿显存空间来换。只要你这轮对话还没结束,这份 KV cache 就得一直死死占着 GPU 的显存(HBM),而且对话越长、吐出的 token 越多,这份笔记就跟着按比例往上涨。
训练吃显存容量,推理把显存切成了零碎的房间
既然不管训练还是推理都要占显存,它们吃的显存到底差多少?拿大家熟悉的 Llama 70B(准确说是 70.6B 参数)把账算一遍就清楚了。
先看推理。如果用半精度 BF16 格式来跑推理,每个参数占 2 个字节。光把模型权重装进显存,就得占掉 70B 乘以 2 字节,等于 140 GB(按 70.6B 算是 141 GB 左右),外加一点运行时的临时工作空间和刚才说的 KV cache。
要是拿同一个 70B 模型去做训练,显存账单要翻好几倍。用标准的混合精度加 Adam 优化器来训练,每个参数除了要存 2 字节的 BF16 权重,还要存 2 字节的梯度。光有这两样还不够。每次更新权重的步子特别小,直接改 2 字节的 BF16,很容易因为精度不够被四舍五入抹掉,所以还得另存一份 4 字节的 FP32 主权重。再加上 Adam 优化器为了记住过去更新的方向和波动大小,每个参数还要存 4 字节的一阶动量(momentum)和 4 字节的二阶矩(second moment)。
这几项加起来,2 加 2 加 4 加 4 加 4,每个参数要吃掉 16 个字节(这就是经典 ZeRO 论文里那笔账)。70B 乘以 16 字节,光模型状态就要占掉大约 1.12 TB,是推理权重(140 GB)的整整 8 倍。这还没算中间激活值(activations)。往前算的时候得把它们存着,等反向传播求导时要用。算上激活值,训练吃的显存差不多是推理的 10 倍。当然真在机房里跑,工程师会用分片和低精度把两边都往下压,但训练要多存梯度和优化器状态,这一大块怎么都省不掉。所以训练集群天生就需要堆多得多的总 HBM 容量和显卡数量。
那推理只要装得下那 140 GB 权重就省心了吗?完全没那回事。在推理机房里,最让人头疼的其实是 KV cache,因为它跟着上下文长度和用户数一起涨。
拿 Llama 3.1 70B 的真实配置算一笔细账。这个模型一共有 80 层,每层 64 个查询头(query heads),每个头的维度是 128。为了省显存,它已经用上了分组查询注意力(GQA),让每 8 个查询头共用 1 个 KV 头,所以一共只有 8 个 KV 头(KV heads)。如果用 BF16 格式存,每个数值占 2 字节。
那每进来 1 个 token,KV cache 要存多少数据?把这几个数乘起来就行,2(Key 和 Value 两份)乘以 80 层,乘以 8 个 KV 头,再乘以 128 维,最后乘以 2 字节。算出来的结果是 327,680 字节,也就是整整 320 KiB(按十进制算大约 328 KB)。
1 个 token 占 320 KiB,听着连半张手机照片都不到。可你乘上上下文长度(context length)和并发用户数试试。假设装完模型权重之后,还留出 64 GB 显存专门给 KV cache 用。显存按块分配会有一点碎片浪费,Kian 说现在的分页管理已经把它压得很小,可以先不管。如果每个请求是 8K 个 token,光「阅读笔记」就要占掉 2.5 GiB。64 GB 除下来,同一时刻最多只能塞进大约 25 个请求。
如果把上下文拉长到 4 倍,变成 32K 呢?每个请求的 KV cache 涨到 10 GiB,64 GB 的显存一下子只能同时接待大约 6 个请求。上下文长度每翻 1 倍,同一批显卡能同时服务的用户数就砍掉一半。
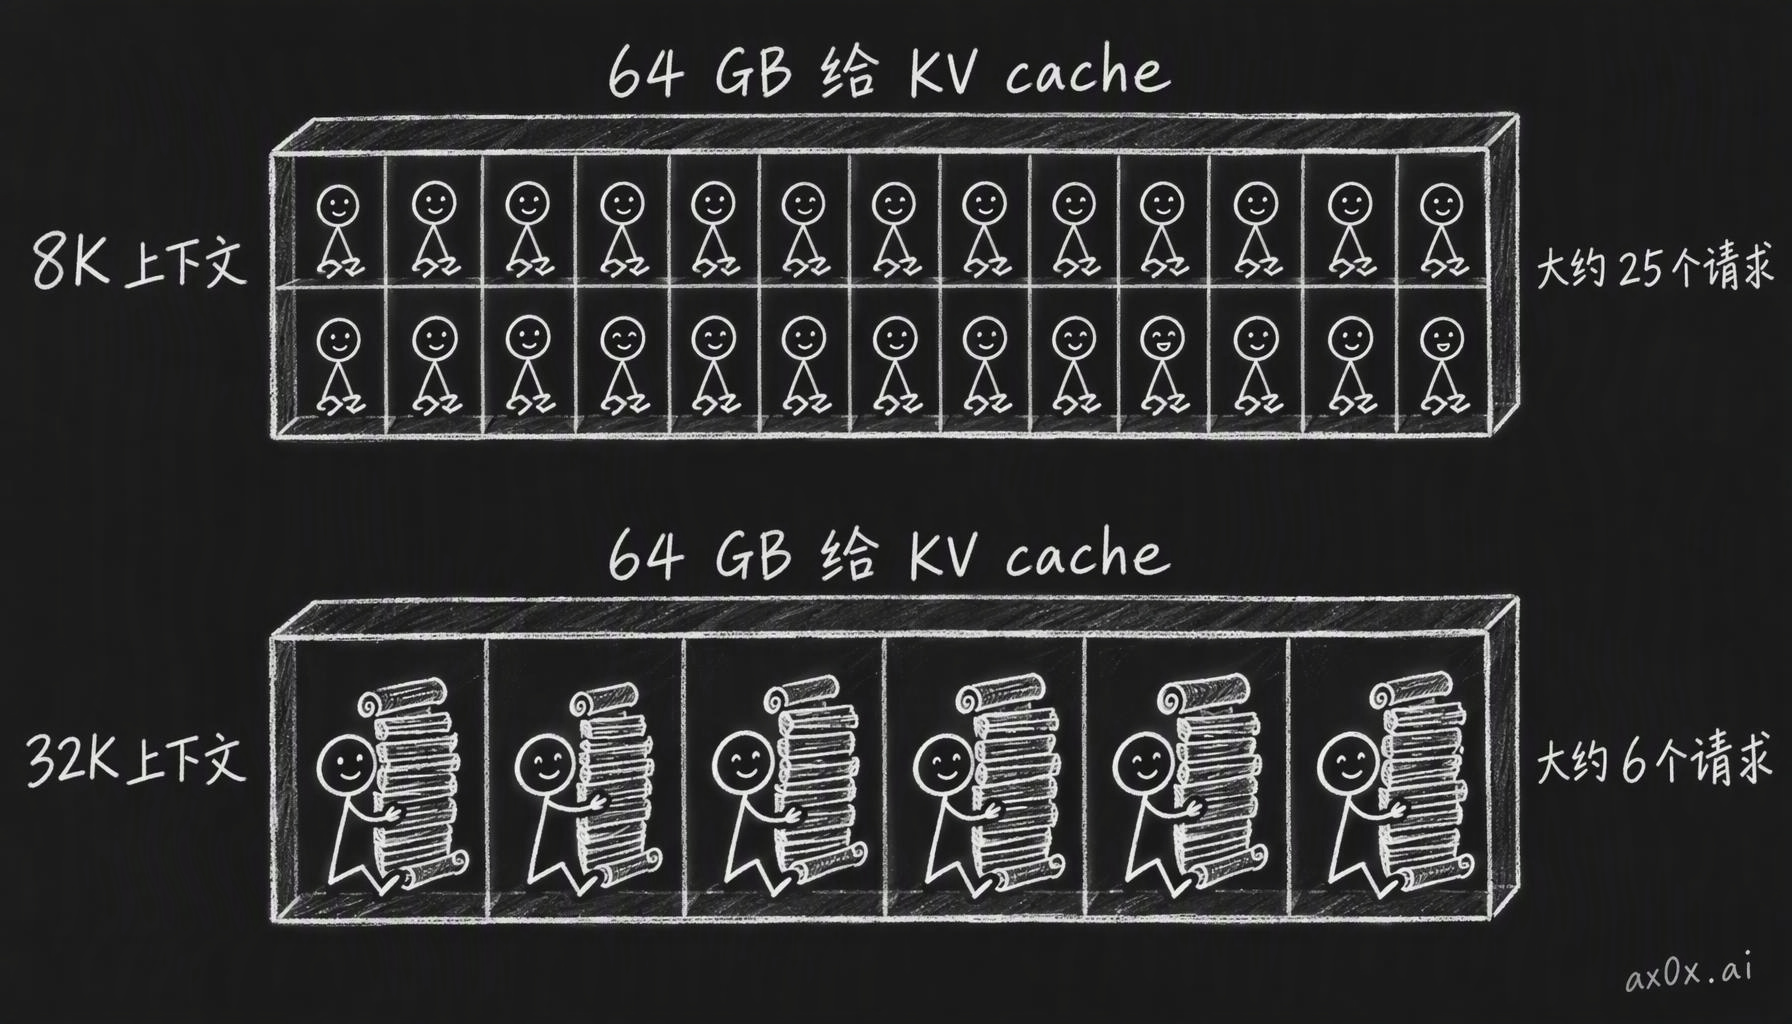 留出 64 GB 显存给 KV cache,8K 上下文的请求能同时塞大约 25 个;上下文拉到 32K,同样的显存只能接待大约 6 个
从 2024 年下半年开始,推理模型(reasoning models)慢慢成了主流。先是 2024 年 9 月出来的 OpenAI o1,然后是 2025 年 1 月发布的 DeepSeek-R1。这类模型在给你吐最终答案之前,自己要先在后台写一长串思考过程。每一个思考 token 都得记进 KV cache,显存就这么被一点点吃掉了。显存为什么跟不上算力、HBM 为什么贵,内存墙和 HBM那两篇讲过。落到机房账本上,KV cache 直接卡死了一张卡能同时接多少人。
被显存逼到墙角之后,做模型架构的人开始拼命给 KV cache 瘦身。DeepSeek 在 2024 年 5 月发布 DeepSeek-V2 时就端出了多头潜在注意力(MLA,Multi-Head Latent Attention),不再老老实实存每个头的 Key 和 Value,改存一个压缩后的低维潜在向量,直接把 KV cache 砍掉了 93.3%(对比自家的 DeepSeek 67B)。
2026 年 4 月 24 日,DeepSeek 放出了 V4 预览版。这回用的是压缩稀疏注意力(CSA)和重度压缩注意力(HCA)混着来,KV 用 FP8 存,原生支持 1M(100 万)token 的上下文。看 DeepSeek 官方报告里拉到 1M token 的对比图就能明白这刀有多狠。上一代 DeepSeek V3.2 原生只支持 128K 上下文。按它的路子硬推到 1M token,一个请求的 KV cache 大概得 50 GB。而在 1M 上下文下,DeepSeek V4 Pro 的 KV cache 只有 V3.2 的 10%,也就是大约 5 GB。同期的 V4 Flash 更省,KV cache 只有 V3.2 的 7%,大约 3.5 GB。
2026 年 9 月 10 日,DeepSeek V4.1 Flash 上线,在 API 里接替了 V4 Flash。它用上了 FP4 的 KV 存储和第二代压缩稀疏注意力,技术报告显示每个 token 的 KV cache 只有大约 890 字节。拿这 890 字节和刚才 Llama 3.1 70B 的 327,680 字节比一比,足足小了大约 370 倍。
另一条路是在一部分层里干脆不存会越变越长的 KV cache。比如阿里在 2026 年 8 月开源的 Qwen3.8-2.4T-A95B,把传统的全注意力层和线性注意力层(linear attention)混着用。线性注意力层用一个固定大小的状态,代替了随字数一直变长的 KV cache。英伟达的博客说,这样就算上下文奔着 1M token 去,显存也涨不了太多。
看到这你可能会觉得,既然单个 token 吃的显存缩水了几十上百倍,机房是不是不用再疯狂堆显存了?Kian 的看法正好相反,他提到了经济学里的杰文斯悖论(Jevons paradox)。蒸汽机烧煤效率变高之后,全社会的煤炭消耗反而暴涨。Kian 的意思是,大模型也一样。单个 token 省下来的显存,会被更长的提示词和更多的 agent 吃回去,比如把整个代码库塞进提示词。所以他觉得,单个 token 是省了,可大家用的 token 涨得更快,机房要的显存总量还是会往上走。
既要吐字快又要接人多,硬件画出的是一条跳水曲线
算完了显存能装几个人,接下来就得算每个人能拿多快的速度。运营一个推理机房,天天盯着看的指标就 4 个。
第 1 个是总吞吐量(throughput),也就是系统每秒钟加起来能往外吐多少个 token。假设机房同时服务 100 个用户,每个人每秒拿到 10 个 token,总吞吐量就是 100 乘以 10,每秒 1,000 个 token。
第 2 个是首字延迟(TTFT,Time to First Token),从你按下发送键,到屏幕上蹦出第 1 个字之间等的那段时间。吐第 1 个字之前必须先把你的提问做完 prefill,再加上排队时间,所以 TTFT 基本就是由 prefill 决定的。
第 3 个是字间延迟(ITL,Inter-Token Latency),第 1 个字出来之后,每两个字之间隔多久。还拿刚才 100 个用户每人每秒 10 个 token 的例子来说,每个用户看到两个 token 之间的间隔是 1 除以 10 秒,也就是 100 毫秒(这笔账千万别拿总吞吐量 1,000 去求倒数,字间延迟看的是单个用户的体验)。
第 4 个是交互速度(interactivity),就是字间延迟的倒数,代表单个用户每秒能拿到多少个 token。字间延迟 25 毫秒,对应的交互速度就是每秒 40 个 token;延迟拉长到 50 毫秒,交互速度就掉到每秒 20 个 token;要是能压到 12.5 毫秒,用户看到的就是每秒 80 个 token 的刷屏速度。系统的总吞吐量,大体上就等于单用户交互速度乘以同时在线的用户数。
这 4 个指标摆上桌,机房最核心的商业矛盾就出来了。你是想让每个用户觉得快(拉高单用户交互速度),还是想让每张卡多接单多吐字(拉高单卡总吞吐量)?这两件事在硬件上是死对头。
英伟达在 2026 年 8 月 12 日发过一篇技术博客,放了一张实测曲线图,横轴是单用户的交互速度(每秒多少个 token),纵轴是平均每张 GPU 的总吞吐量(每秒多少个 token)。测试机器是一整柜 72 张卡的 GB300 NVL72,上面跑的就是刚才提到的阿里开源模型 Qwen3.8-2.4T-A95B。这是个混合专家模型(MoE),总共 2.4T(2.4 万亿)参数,每处理 1 个 token 只用其中 95B。测试用的是 TensorRT-LLM 开箱即跑(out of the box)的成绩,权重用 FP8(1 个参数占 1 字节),还开了多 token 预测(MTP,一次猜好几个词)。每个请求都是输入 8K token、输出 1K token。
这张图的两头差得非常夸张。如果你不管单用户快不快,把每个人的速度压到每秒 10 到 15 个 token 左右(差不多够人眼正常阅读),每张 GPU 的吞吐量能冲到最高点,每秒超过 4,000 个 token。反过来,如果你要把单用户交互速度拉到极限,冲到每秒 350 个 token 以上,那每张 GPU 的总吞吐量就暴跌到每秒 230 个 token 左右了。
云厂商跟客户签服务等级协议(SLA)定价格,看的就是这条曲线。假设客户签的 SLA 要求保证每个用户每秒拿到 100 个 token。去图上找横轴 100 的位置,对应的纵轴单卡吞吐量大约是每秒 950 个 token(比 4,000 多的峰值已经跌掉了大概 4 倍)。950 除以 100,每张 GPU 大约能同时服务 10 个用户,一整柜 72 张 GPU 加起来,大概能同时服务 700 个用户。
要是客户做的是实时代码助手或者高频 agent,要求把 SLA 提到每秒 200 个 token 呢?图上的单卡吞吐量掉到了大约每秒 620 个 token,每张卡只能接大约 3 个人,整柜 72 张卡只能服务大概 220 个人。如果客户再往上加码,非要每秒 300 个 token 的极速体验,单卡吞吐量就只剩每秒约 340 个 token 了,平均 1 张 GPU 只能伺候大约 1 个用户,整整一柜子 72 张卡加起来同时只能接待大约 80 个人。
你看这条曲线掉得有多狠。单用户的速度从每秒 100 个 token 提到 300 个 token,只快了 3 倍,可整台机柜能同时服务的用户数从大约 700 人掉到了大约 80 人,足足缩水了约 8 倍。Kian 提到,这只是开箱即用的第一版数据,英伟达在博客里也说后续还会上 NVFP4 这类深度优化,把整条曲线往右上角推。但我觉得再怎么优化,速度和接人数互相抢资源这一点还在,曲线还是会往下掉。客户要的响应越快,单卡能榨出来的总吞吐量就越少。我觉得高速推理接口卖得贵,根子多半就在这。
一边嫌算力不够用,另一边嫌显存搬得太慢
为什么把单用户速度往上拉,总吞吐量会掉得这么厉害?根子还在 prefill 和 decode 干活的方式完全不同。
先看 prefill。用户把几千上万个 token 的提问一把丢进来,GPU 可以把所有 token 拼成一个大矩阵,和模型权重做一次大规模并行矩阵乘法(在超长上下文下,注意力机制本身的计算量也会跟着猛涨)。Kian 在课上举过一个夸张的假设例子,要是把 10 个每个长达 1M token 的代码请求凑成一批做 prefill,那就是 1,000 万个 token 同时做算术。权重搬进计算单元一次,就能一口气算完一大片数据。这时候卡脖子的是 GPU 每秒能做多少次算术,行话叫算力受限(compute-bound)。
一进 decode 阶段,画风全变了。因为模型每次只能往外蹦 1 个 token,后一个词必须等前一个词算出来才能动手,根本没法把同一个人的几百个输出词一口气并行算出来。假如卡上只跑 1 个用户。每蹦 1 个 token,GPU 都得把模型权重和那份 KV cache 从 HBM 搬到计算单元(MoE 模型只搬被选中的那几个专家)。算完这 1 个词,吐出来,停下。到了算下一个词,又得把庞大的权重从头搬一遍。搬了半天数据,只干了一丁点算术活,计算单元大部分时间都在干等显存送数据过来。所以在日常的服务批次大小下,decode 基本都是被显存带宽卡住脖子的,行话叫内存带宽受限(memory-bandwidth-bound),它直接决定了你的字间延迟(ITL)。
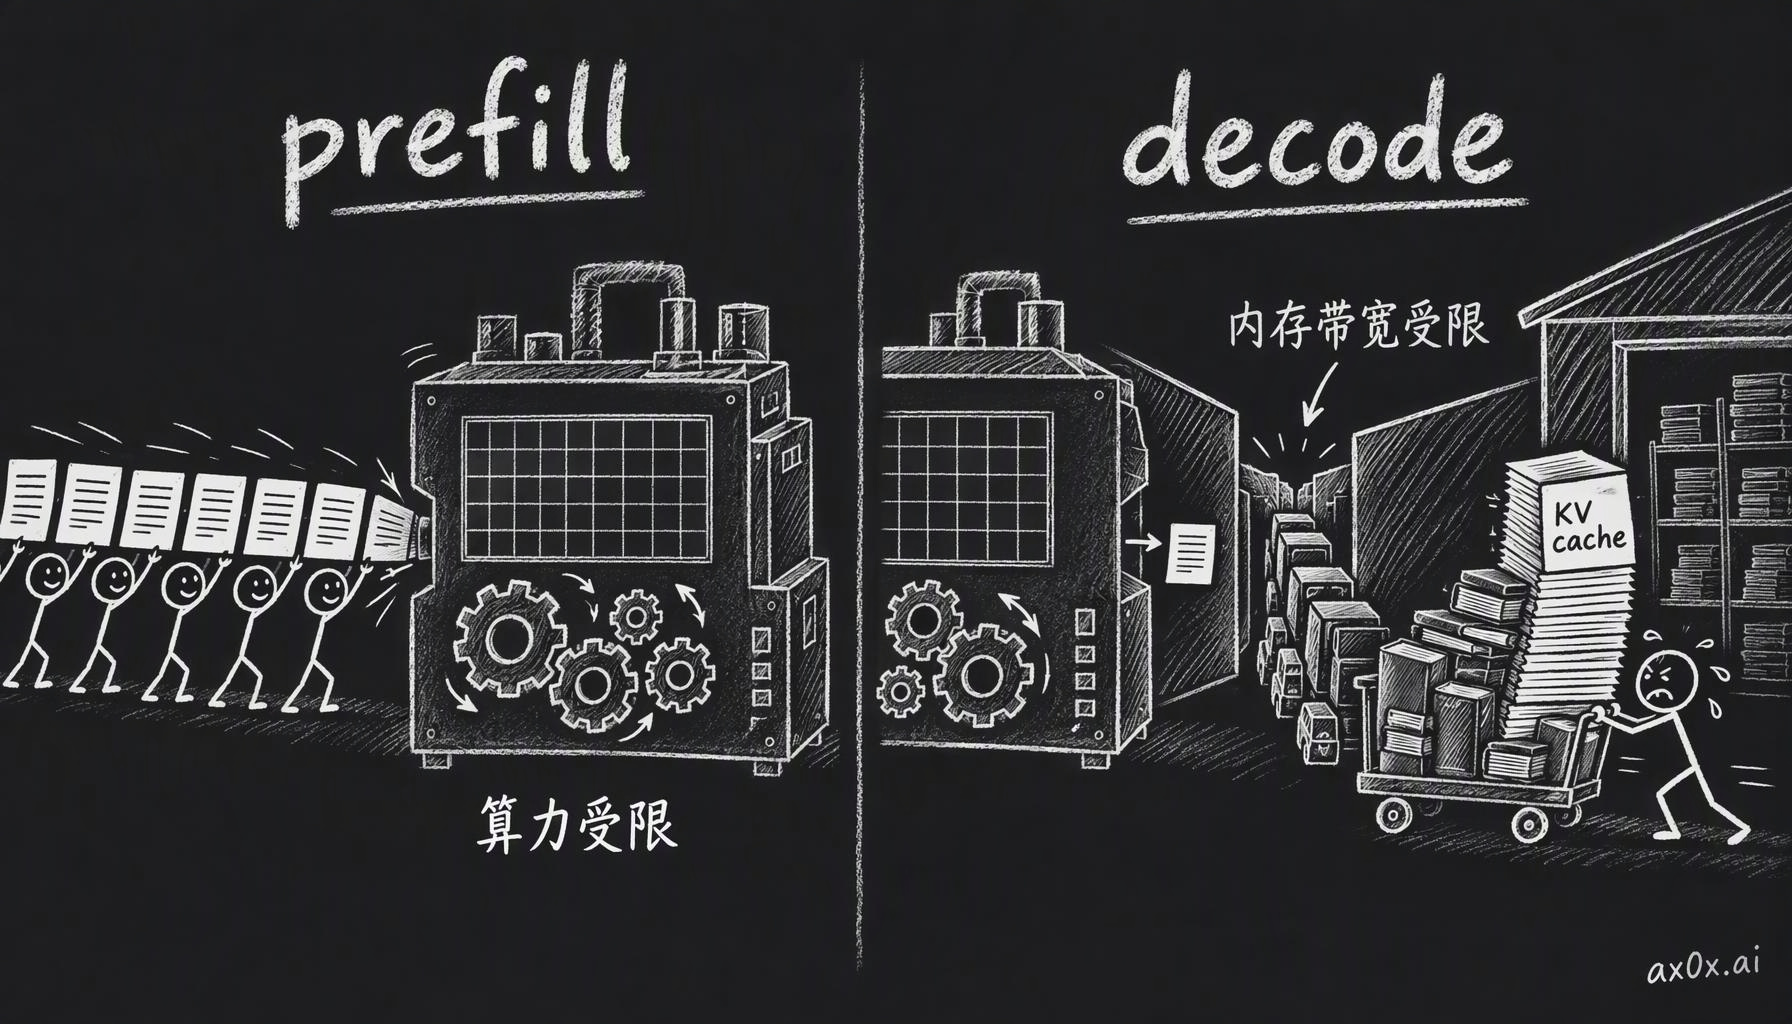 prefill 把整段提问一口气塞进模型,做一次大规模并行矩阵乘法,卡在算力上;decode 每次只吐 1 个 token,每吐一个都要把权重和 KV cache 从显存里搬一遍,卡在内存带宽上
既然从 HBM 里搬一次权重又慢又费电,怎么才能不亏本?办法就是凑单,也就是批处理(batching)。权重从 HBM 读出来一次,只跟 1 个用户的数据做乘法,这趟就太亏了。如果把 8 个用户的请求凑成一捆,读一次权重就能同时算 8 个人的,搬运还是 1 份,算术活多了 8 倍。凑大批次能把读权重的成本分摊掉,把 decode 从卡带宽往卡算力那边推,每瓦电吐出的 token 也就跟着变多。前面英伟达那张图里,只有把单用户速度压低、把并发批次凑大,单卡吞吐量才能冲上 4,000,道理就在这。
凑单这件事本身也有讲究。早期的做法叫固定批处理(fixed batching,也叫静态批处理)。Kian 用公交车打了个比方,一下就能听懂。固定批处理就像一辆死心眼的公交车。起点站拉满一车人出发,哪怕第 1 个乘客坐 2 站就下了,空座也不让路边的人上。非得等坐到终点站的最后一个人下车,车彻底空了,才放下一批人上来。放到推理服务里,同一批进来的 8 个请求,有的人只让模型回答 2 个字,一下就跑完了;有的人让模型写长文,要跑好几秒。短请求跑完之后,占着的坑位只能空转干等那个最慢的请求,算力和显存全浪费在等待上了。
所以现在主流的推理引擎,像 TensorRT-LLM、vLLM 和 SGLang,都换成了连续批处理(continuous batching)。这个思路最早是 2022 年 OSDI 上 Orca 论文里的迭代级调度,后来被 vLLM 带火,TensorRT-LLM 里管它叫 in-flight batching。这就跟街上跑的真公交车一样了,每走一步(每生成 1 个 token),只要有请求结束下了车,排队等着的下一个请求马上就能补进空位里,只有车上所有座位全满的时候才让新来的请求在外面等。
软件把空位填满了,硬件架构师干脆更进一步,把 prefill 和 decode 拆到不同的机器上跑,行话叫分离式推理(disaggregation,比如英伟达的 Dynamo 框架就能把不同阶段路由给不同的工作节点)。
专门顺着高带宽思路造芯片的典型例子是 Cerebras。它把整片晶圆做成一颗大芯片 WSE-3,片上直接塞了 44 GB 的 SRAM(就是之前在CPU 是怎么算数的里讲过的那种靠 6 个晶体管搭出来的超快缓存),片上内存带宽高达每秒 21 PB(21 PB/s),喂 decode 这种渴求带宽的活非常顺手。
另一家把片上 SRAM 做到极致的是 Groq。2025 年 12 月 24 日,英伟达和 Groq 签了一笔非排他性的技术授权协议(媒体报道规模在 $200 亿左右),同时把 Groq 创始人 Jonathan Ross、总裁 Sunny Madra 等核心团队招进了英伟达(注意这笔交易是技术授权加招人,Groq 公司自己还在独立运营 GroqCloud)。到了 2026 年 GTC 前后,英伟达就用这套技术做出了专用低延迟推理加速机柜 Groq 3 LPX,并在 2026 年 8 月 24 日宣布全面量产,由云厂商 Nebius 率先采用。
这个 Groq 3 LPX 机柜是专门配着英伟达下一代 Vera Rubin NVL72(Grace Blackwell 的下一代)一块干活的。一个 LPX 机柜里有 256 颗 Groq 3 LP30 芯片,每颗带 500 MB 片上 SRAM,整柜一共 128 GB,片上总带宽高达每秒 40 PB。
这两台机柜是怎么配合的?按英伟达官方技术博客的说法,它们是在 decode 这一步里面分工的。我猜原因之一是容量。前面算过,Llama 3.1 70B 一个 32K 的请求光 KV cache 就要 10 GiB,而 LPX 整柜一共只有 128 GB 的 SRAM,拿它装 KV cache 多半划不来。KV cache 还是留在 Vera Rubin 的 GPU 显存里。Rubin GPU 既做 prefill,也做 decode 里要翻 KV cache 的那部分注意力(attention)计算。decode 每一步里还有一块活,是要反复读权重的 FFN(前馈网络)和 MoE 专家层,它最卡单用户延迟,这块被拆出来放到 LPX 的 SRAM 上跑。每生成 1 个 token,激活值就在 Rubin GPU 和 LPX 之间来回跑一趟(由 Dynamo 在底下统一调度)。阅读笔记放在容量大的 HBM 里,每一步都要读的专家权重放在快的 SRAM 里,机房里也就多出了一种专门跑这部分活的机柜。
功率压低了,电表反而可能走得更多
把芯片里算术和搬数据的账算清楚之后,最后还得落回机房的电表上。这里有个挺反直觉的坑。很多人以为把机器的功率(power,单位 kW 或 MW)压低一点,就一定更省电。可省不省电看的是电量(energy,单位 kWh 或 MWh,也就是电表上走的「度」)。
Kian 算了一个很直观的例子。假设你要跑完同一批任务,方案 A 让机器火力全开,功率拉到 100 kW,10 分钟(六分之一小时)就跑完了,耗电量是 100 乘以六分之一,大约 16.67 度电(16.7 kWh)。方案 B 把功率压低到 80 kW 慢慢跑,结果花了 15 分钟(四分之一小时)才跑完,耗电量是 80 乘以四分之一,等于 20 度电(20 kWh)。方案 B 的功率虽然低了 20%,但因为跑的时间拖长了,最后反而多烧了 20% 的电。
我觉得这条账在看机房设计的时候最值得记住。把功率压低,任务未必更省电。电费看的是吐出 1 个 token 到底花了几度电。峰值功率管的是变压器、母线槽和散热管子要修多粗。而且 AI 负载的功率从来不是一条平直的线。几万张卡同步训练的时候,所有卡一起算完一步,又一起停下来同步梯度,整座机房的功率会一下子掉下去再猛拉回来。这种功率锯齿怎么折腾电网和机房电池,第五篇讲断电保护时再细拆。所以 Kian 给这一章留的规矩很干脆。供电系统要照着真实负载测出来的功率曲线去设计,峰值、总电量和功率变化有多快都得算进去。只拿一个平均功率画图纸,峰值一来就可能跳闸。
把上面这几笔账串起来,你平时调大模型 API 遇到的那些定价规矩就全能看懂了。为什么有些 API 在上下文超过一定长度之后,单价会贵出一截?我觉得多半是因为显存。前面那笔账里,同样 64 GB 的 KV cache 预算,8K 的请求能塞大约 25 个,32K 的只能塞大约 6 个。你一个人占了好几个人的位置,单价自然要涨。为什么批量接口(Batch API)往往打折,每秒几百个 token 的极速接口却卖得贵?我猜是因为批量接口不急着给你结果,调度器可以把车厢塞得满满的,站在吞吐量曲线最高的那头。你要每秒 300 个 token,按前面那张图,1 张卡差不多只能伺候你 1 个人。卡买回来了,电却还没接上,开发商为了抢时间会怎么找电,这是下一篇要讲的。
本系列整理自 freeCodeCamp 上 Kian(@neuralkian)的课程「Inside an AI Factory – Power, Cooling, and GPUs Explained」(课程原名 From Watts to Tokens,讲义在 kiankyars.github.io/gigawatt)。框架和大部分例子是 Kian 的,我按主题重新编排、核对了数字,理解有偏差的地方锅在我。文中提到的公司只是例子,不构成任何投资建议。