
电脑卡,多半是处理器在等内存
训练过神经网络的人大概都见过这种情况,GPU 利用率在 60% 上下飘,怎么都拉不满。卡是好卡,钱也花了,它就是跑不满。为什么啊?其实那些时间里处理器都在干等,等数据从内存送过来。这种事也不光 GPU 会碰到。你 Chrome 开三十个标签,切过去白屏半秒,翻一个很大的 Excel 卡一下,多半也是同一个原因,处理器在等内存。
先看两个数字
过去五十年,处理器的算力涨了大概 (10^{12}) 倍,DRAM 的访问延迟只降了大概 4 倍。没写错,就是万亿倍对 4 倍。带宽那边也好不到哪里去,内存带宽一年涨 15% 左右,算力需求却一年翻一倍。两边都在按比例涨,可增速差了好几倍,差距拉了二十年,现在还在越拉越大。所以每次你觉得电脑「卡」,处理器多半是闲着的,活全堵在数据还没送到这一步。
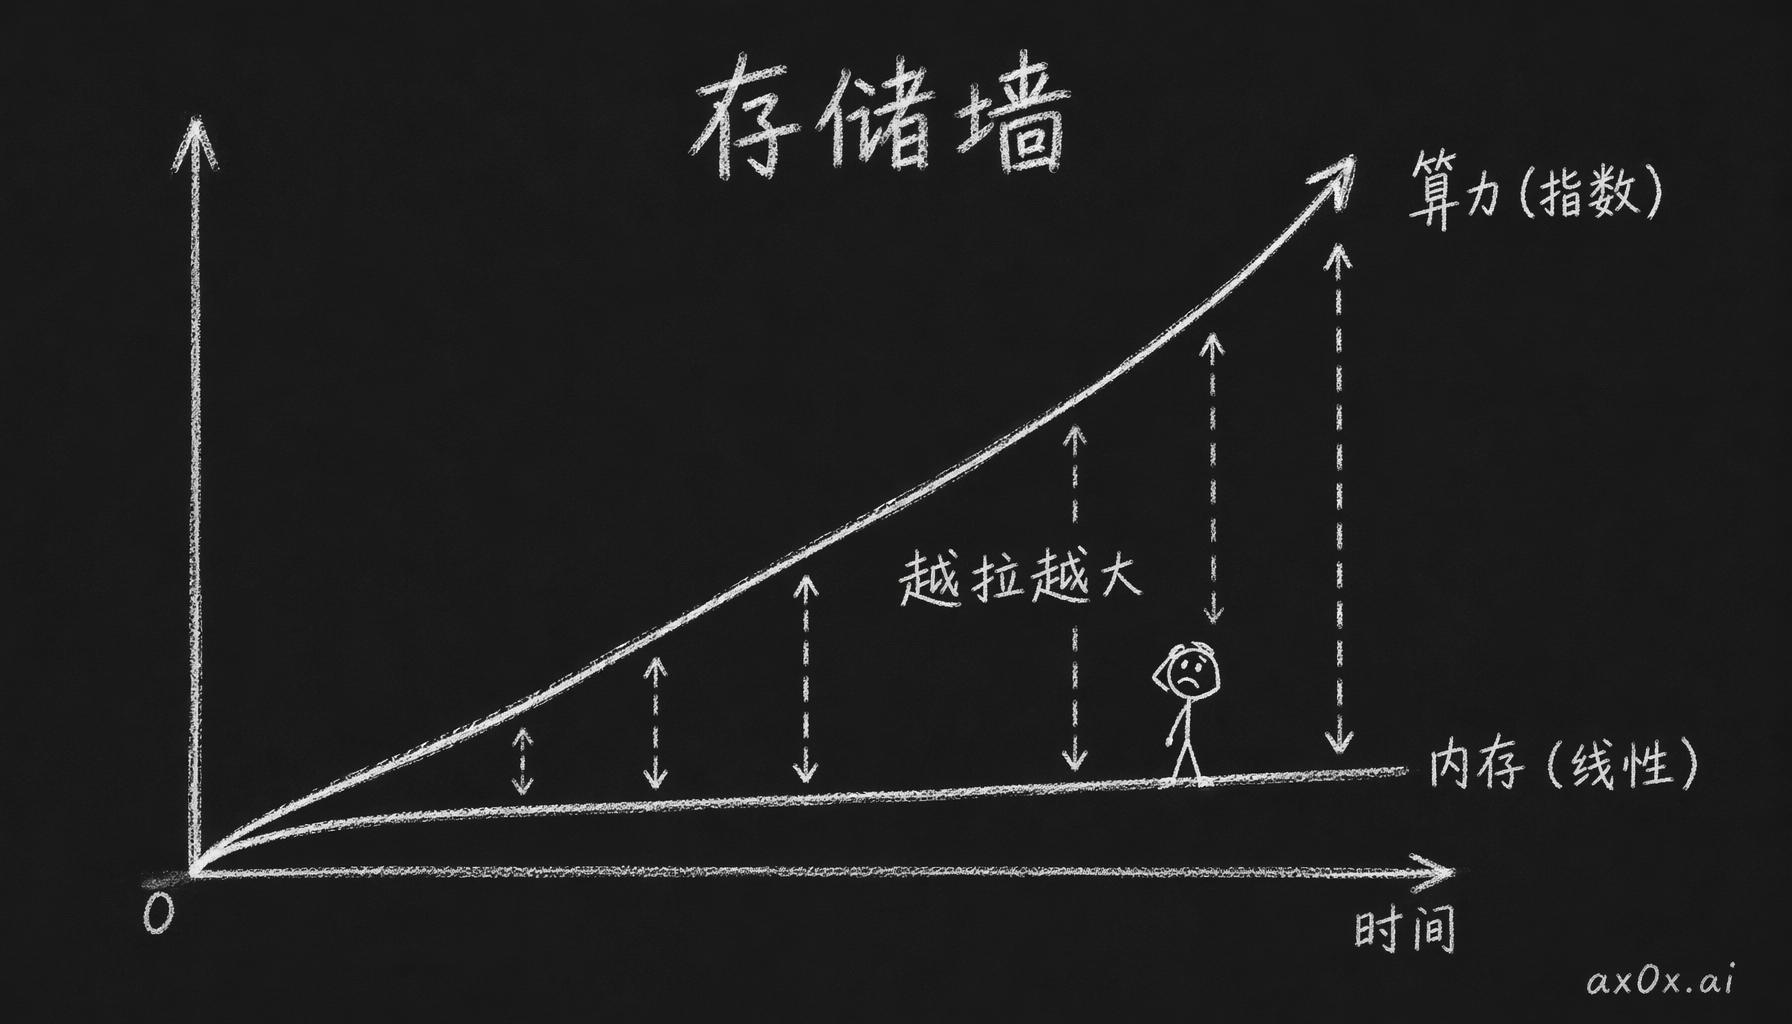 算力涨得飞快、内存涨得慢得多,两条曲线之间的缝隙越拉越大,就是「存储墙」。
这笔账其实早就有人算过。1994 年,William Wulf 和 Sally McKee 写了篇论文,叫 Hitting the Memory Wall。他们说照当时的趋势推下去,用不了几年,处理器的速度就会被内存带宽完全卡死,加再多核心也没用,因为每个核心都在等饭吃。「存储墙」这个说法就是这么来的。这篇论文到现在三十多年了,问题不但没解决,在有些领域反而更严重了。
那内存凭什么就是跟不上啊?
内存为什么跟不上
DRAM 的基本结构从 1970 年代到现在就没变过,一个电容存 1 或者 0,隔一段时间就得刷新一次,免得电漏光了。读数据的时候,先给出行地址和列地址,然后等电容放电,再由放大器把电压读出来。
卡就卡在「等电容放电」这一步。电容放电是个物理过程,快慢是物理定律定死的,几十年下来几乎没什么能优化的。这一步快不起来,你换什么架构它都快不起来。你可以把马路修宽,也就是加带宽,但每辆车的车速提不上去,也就是延迟降不下来。
还有个更根本的矛盾。芯片上的晶体管数量翻倍,是在二维平面里长的,可数据要在不同芯片之间跑,走的是三维空间里实打实的物理距离。所以搬数据花的能量和时间,比计算本身多得多。算这一下花不了多少电,大头全花在把数据搬到能算的地方这一路上。
三层缓存,治标不治本
CPU 的办法大家多少听说过,就是 L1/L2/L3 三层缓存。先猜处理器接下来要什么数据,提前从慢的 DRAM 搬到快的 SRAM 缓存里,处理器直接从缓存拿。
这套办法管用了很多年,但它有个前提,程序访问数据得有规律,你才猜得到它下一步要什么。深度学习偏偏不满足这个前提。神经网络每一层的权重摊在内存各处,每个 token 都要把全部参数访问一遍,注意力机制的访问又稀疏又随机,缓存的预取算法根本猜不准。
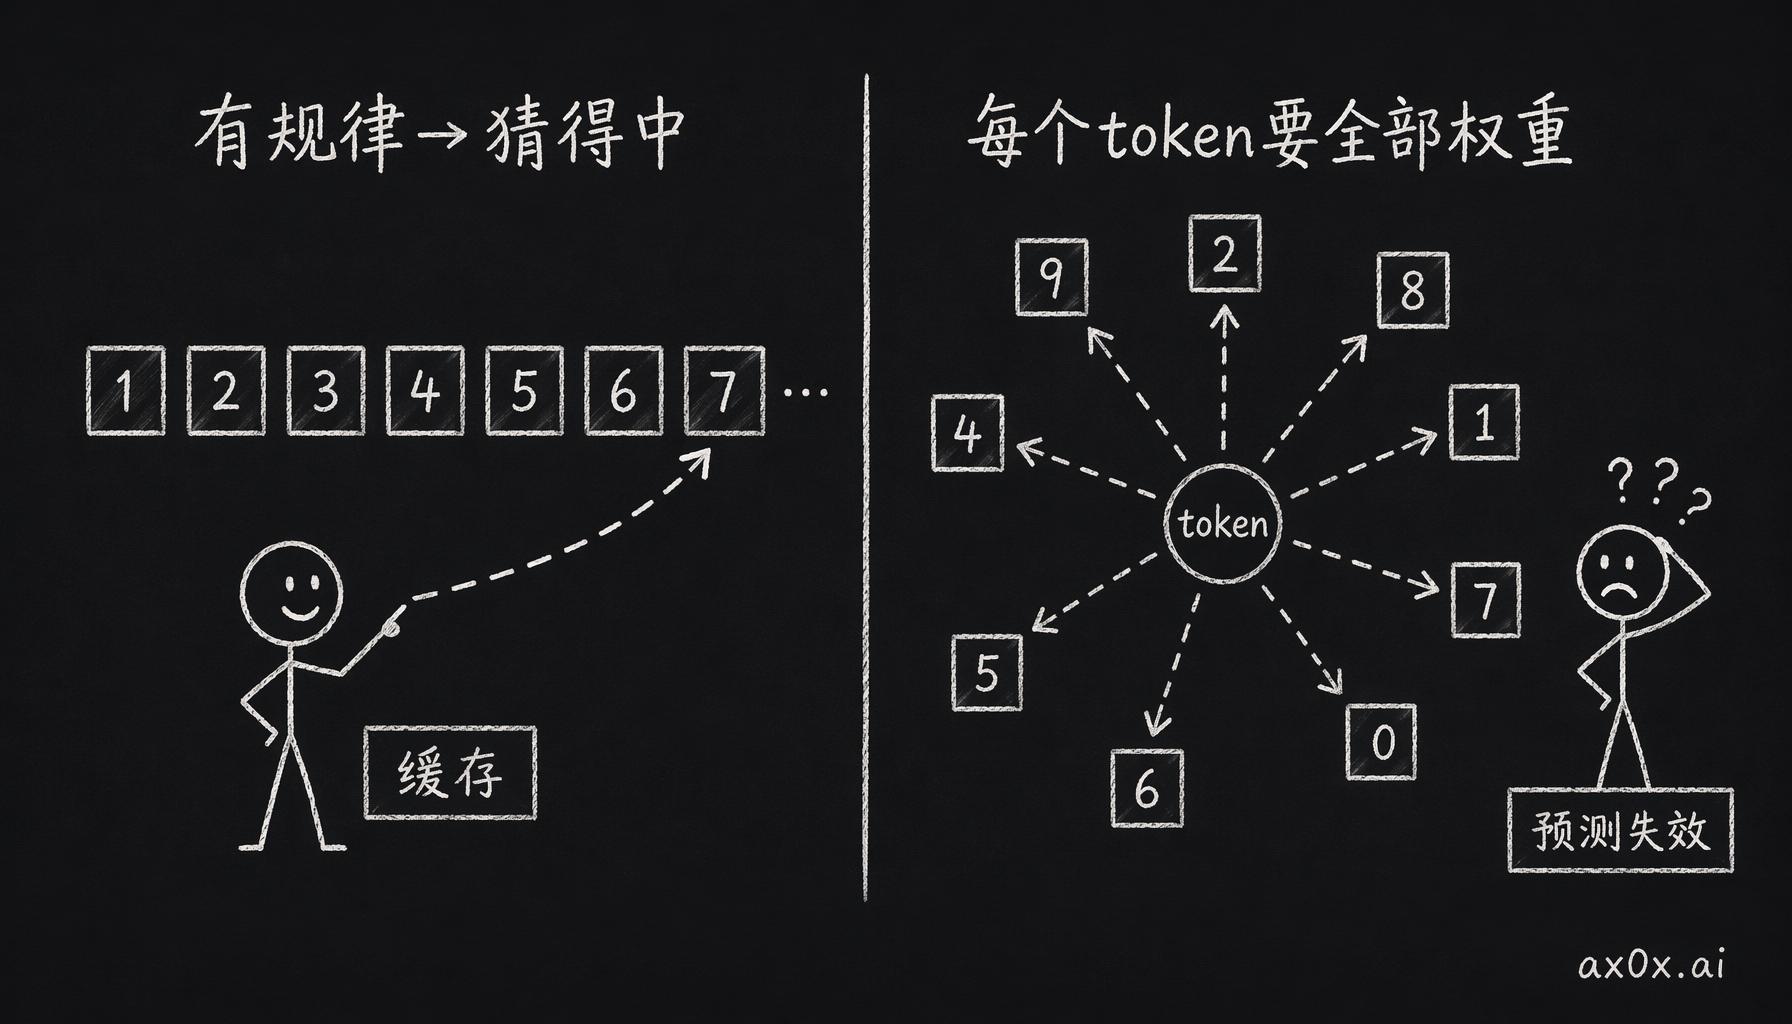 缓存靠预测提前取数据,访问有规律时猜得中;但 AI 每个 token 要访问全部权重,预测彻底失效。
GPU 的思路不一样,它不猜了,直接用海量线程把延迟盖过去。这一组线程在等数据,那就切到另一组先算着。听着挺聪明吧?但前提是手里得有足够多的线程可以切。像实时推理那样 batch size 小到 1 的时候,这招就不灵了。
所以墙还是没绕过去。那它到底卡在哪?拆开看,带宽、延迟、功耗三个地方都堵着。
带宽、延迟、功耗,三个地方都堵
最常撞上的是带宽。GPU 的 FLOPS 早就够快了,实际能跑多快是内存带宽说了算。H100 的显存带宽大概 3.35 TB/s,听着很大吧?但 GPT-4 这个级别的模型做推理,每个 token 都要把模型参数全部访问一遍。你拿带宽除以参数总量就会发现,模型越大,每秒能处理的 token 反而越少。
再说延迟。就算带宽堆够了,处理器发出请求以后,到数据真的到手,中间那段等待还是省不掉,处理器就在那干等。平时大家都盯着带宽的数字看,反而容易忽略这一块。
再往下挖是功耗,我觉得这个才是最要命的。搬数据烧的电比计算本身多好几个量级。同一颗芯片上两个晶体管之间搬一下,跟跨芯片、跨板卡搬一趟比,能耗能差 (10^3) 到 (10^4) 倍。AI 数据中心的总功耗里,有 40% 到 60% 都烧在搬数据上,真正用来算的反而是小头。而且这是物理极限,工艺再怎么进步也绕不开。
HBM 是怎么缓解的
HBM 全称 High Bandwidth Memory,名字听着像是更快的内存,其实它就干了一件事,把内存搬到芯片旁边。传统 DRAM 焊在 PCB 上,数据要走好几厘米才到芯片。HBM 用一层硅中介层(interposer),把 DRAM 直接堆在芯片边上,数据要走的路缩到几毫米。路短了,总线就能做得更宽,带宽也就上去了。
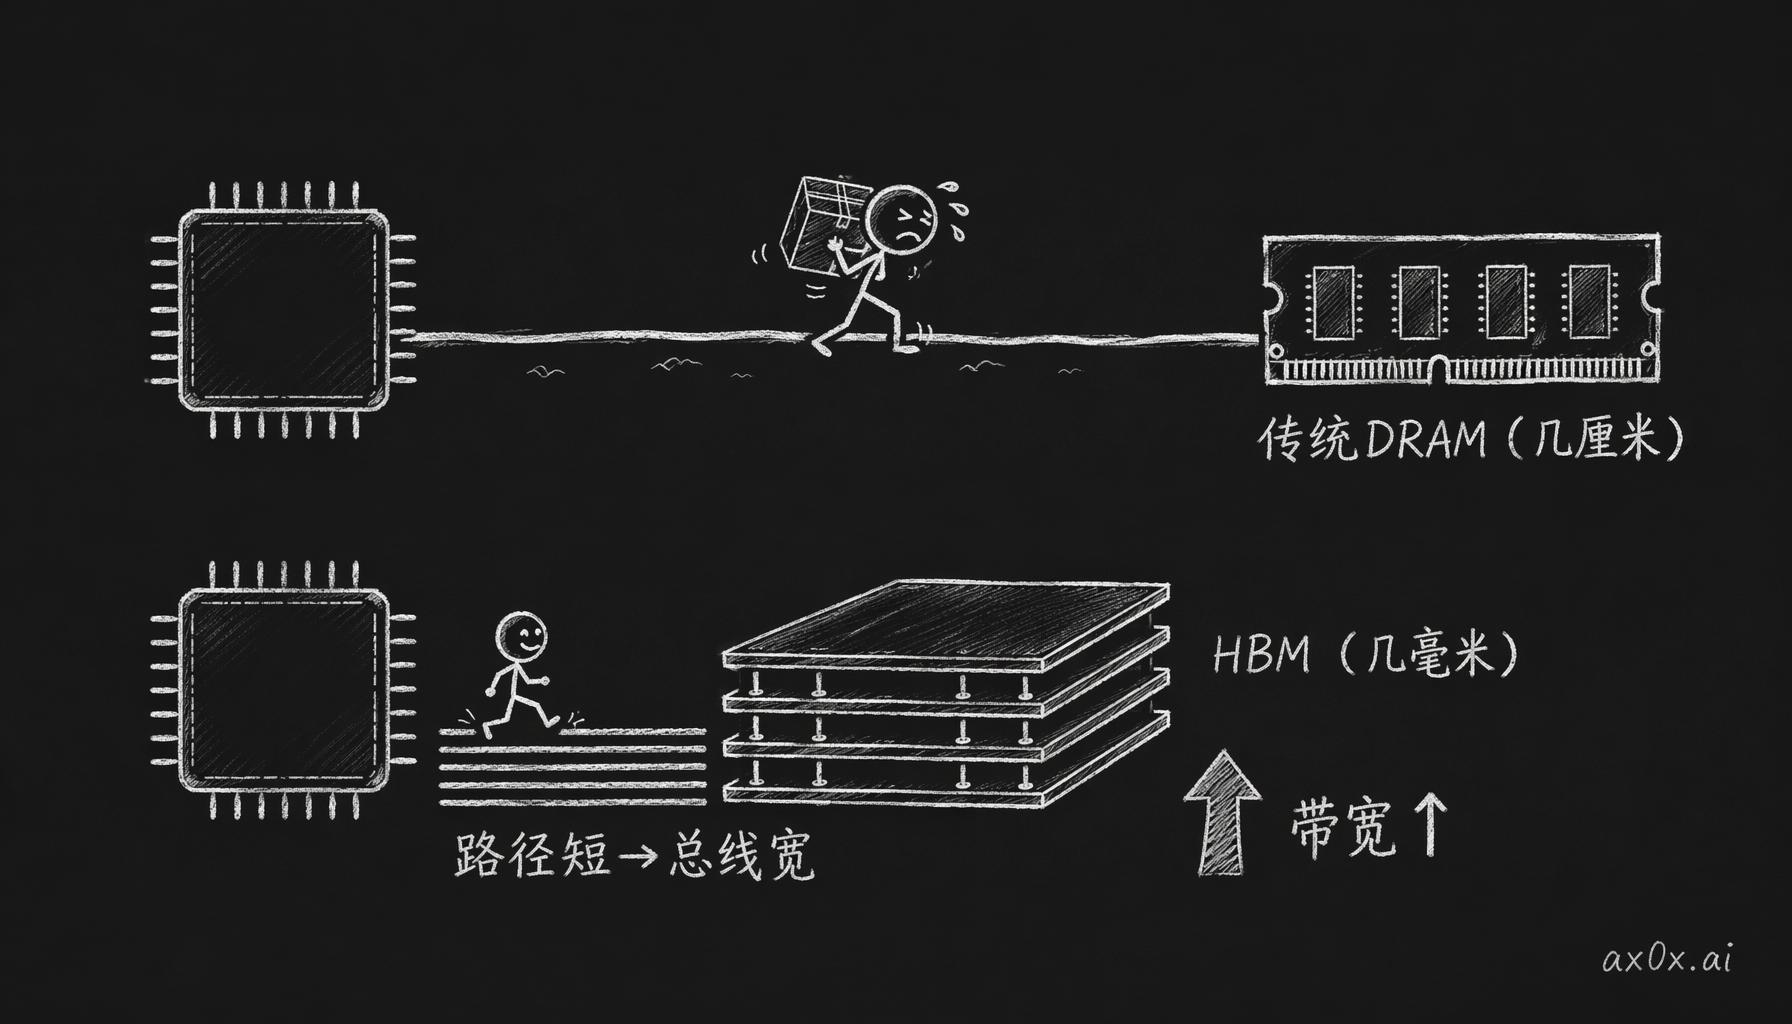 HBM 把内存从几厘米外搬到芯片旁的几毫米处,路径短了总线就能做得更宽,带宽随之提上去。
代价是 HBM 贵得离谱。一张 H100 的成本里,HBM 占了超过 50%。所以真不是 Nvidia 贵,是 HBM 贵。
只能说,存储墙是过去二十年最被低估的技术瓶颈。不管你关心的是功耗、成本还是延迟,追到最后基本都会追到内存上。那 HBM 到底是怎么造的?良率为什么那么低?为什么全世界能量产的只有三家?这背后的产业链又在怎么博弈?后面的文章一个一个讲。


