
HBM 这波涨价其实是推理带起来的
HBM 这个市场最近涨得挺吓人的。我去翻了下数,2024 年整个市场一年也就 50 亿美元左右,大家对 2027 年的预测直接给到了 400 亿往上,等于三年翻了八倍。一个半导体细分市场能这么涨,很少见。
八倍是从哪来的啊?大家都知道 AI 缺芯片,但具体缺的是什么,好像没多少人说得清吧?其实背后是 AI 的重心正在从训练挪到推理。训练是把模型造出来的那一步,要花几亿、几十亿美元,听着很吓人,但就发生那么一次。模型造出来之后呢,剩下的全是推理,全世界每一次调用都是推理,你每问它一句话,它都在做推理。Deloitte 预测 2026 年推理会占掉总算力的三分之二,推理芯片市场会从两百亿美元跳到五百亿以上。
推理除了要 GPU 算力,还要内存,而且模型越大,推理吃的内存越多。为什么会这样?得看推理这个活具体是怎么干的。
推理为什么这么吃内存
训练和推理干的其实不是一种活。训练一个 GPT-4 级别的模型,要访问整个模型的参数、激活值、梯度和优化器状态,一个训练 batch 能同时处理几千个 token,所以 GPU 那一大堆并行核心都能喂得很满。
推理不是这样。每个用户的请求单独处理,一次只生成一个 token,自回归地一个一个往外蹦。这时候 GPU 的并行计算核心大量闲着,可模型参数呢,每生成一个 token 都得完整读一遍。算力多得用不完,卡住的是把参数搬进来的速度。算力有富余、唯一的瓶颈是带宽,这种状态有个名字,叫 memory-bound。小 batch 推理就是典型的 memory-bound 任务。
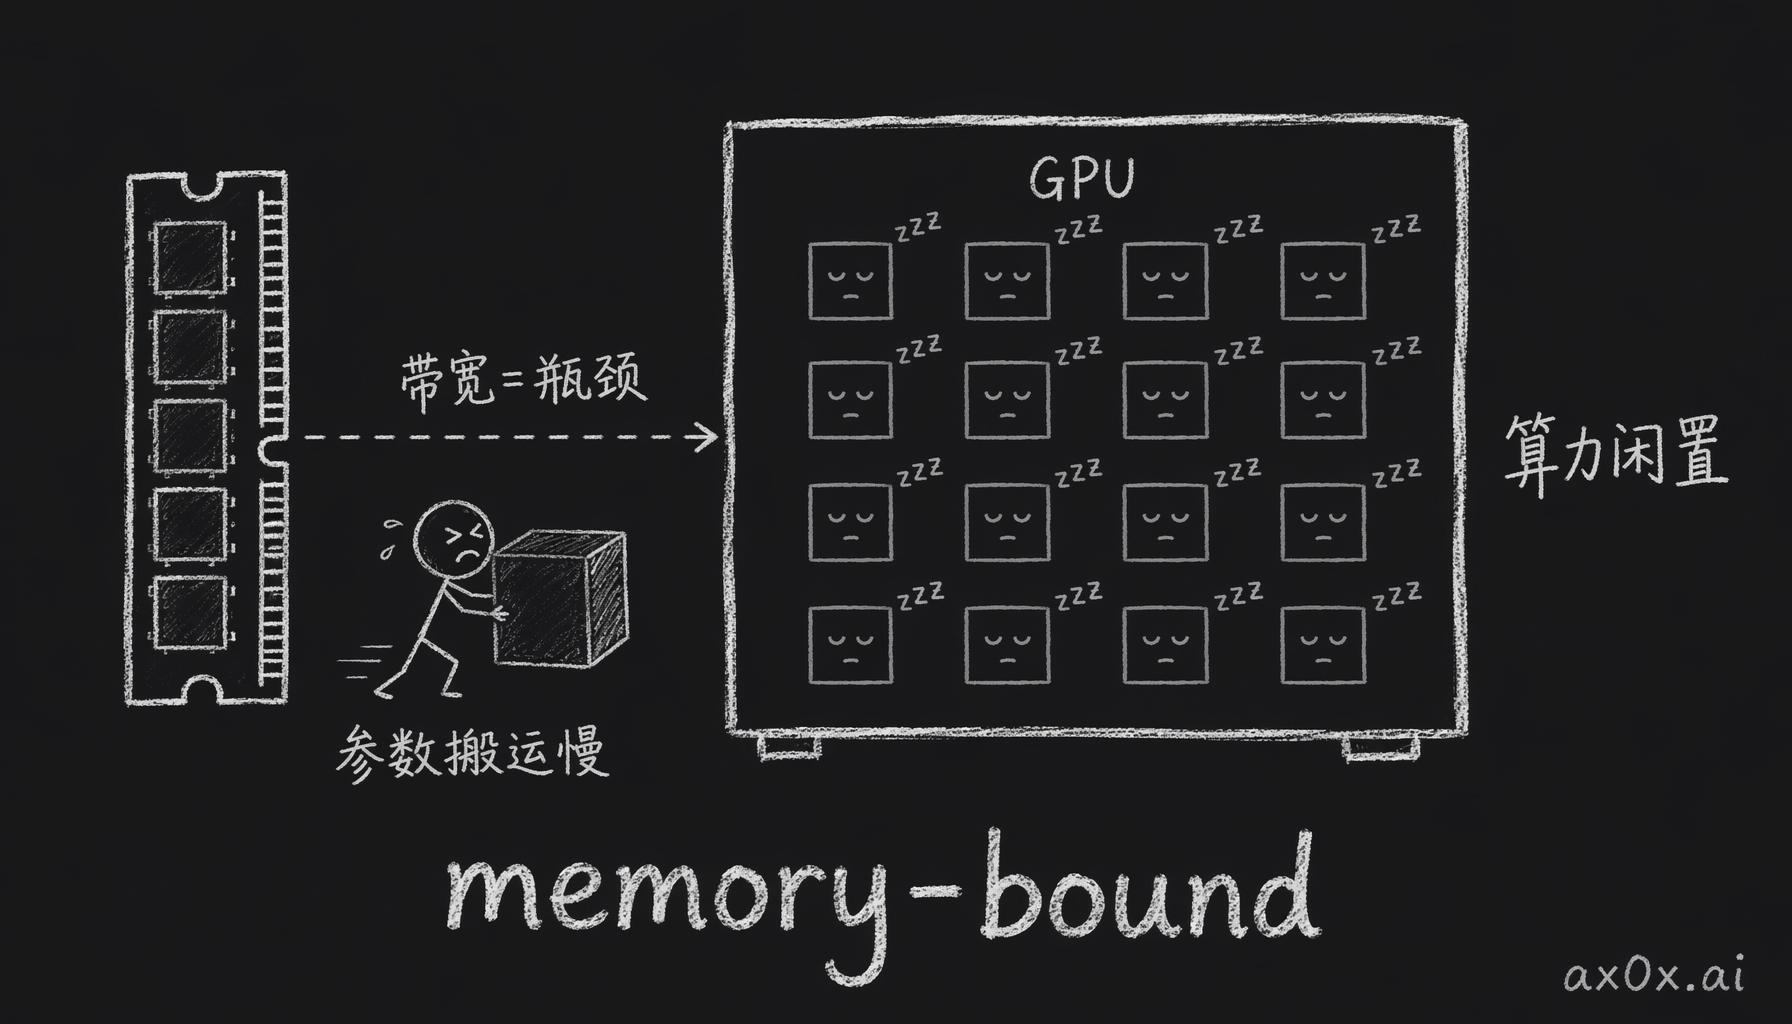 推理时 GPU 的算力大量闲置,真正卡脖子的是把模型参数从内存搬进来的带宽——这就是 memory-bound
模型越大,这个问题就越突出。GPT-5 级别的模型有数万亿参数,哪怕只推理一个 token,光把参数完整读一遍就要占掉几 TB 的内存带宽。所以看推理卡不能光盯着 TFLOPS,最该看的是 HBM 带宽。需求那边是这么个情况,那供给呢?产能跟不跟得上啊?
产能为什么扩不动
现在全球 HBM 一个月大概能产 15 到 20 万片(12 英寸等效),SK 海力士占 55% 左右,三星 35% 左右,美光 10% 左右。需求远远超过供应,2025 年的 HBM 产能已经全被订完了。
那为什么不赶紧扩产啊?其实 DRAM 颗粒根本不缺,全球 DRAM 产能反而是供过于求的,全卡在封装上了。HBM 是把好多层 DRAM 叠在一起,层和层之间要打几千个垂直的孔把上下连通,这个工艺叫 TSV,对良率和精度要求极高。TSV 产能扩一轮要 12 到 18 个月,比 GPU 芯片本身扩产慢得多。
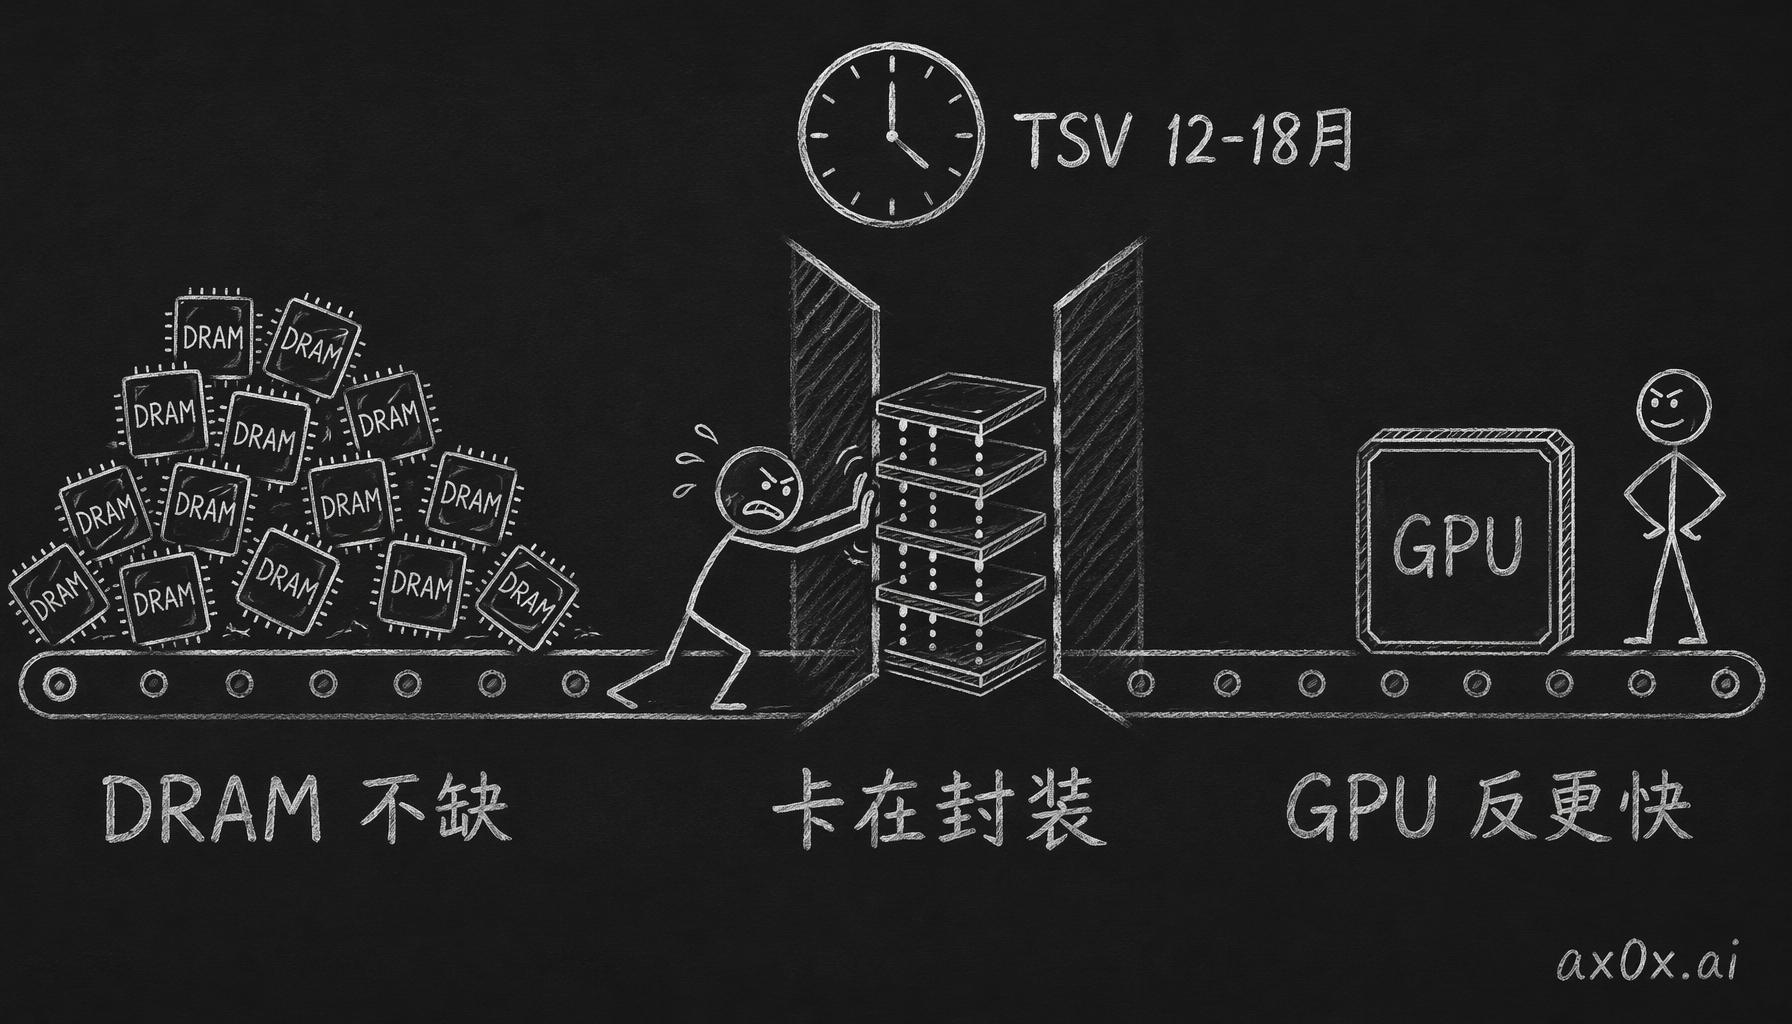 HBM 扩不动不是因为缺 DRAM 颗粒,而是卡在 TSV 封装这道工序,扩一轮要 12 到 18 个月,慢到 GPU 都比 HBM 先到货
所以就出现了一个挺离谱的情况,GPU 交货比 HBM 还快。B200 芯片在台积电 4nm 的产能是够的,可给 B200 配的 HBM3e 不够。GPU 有算力,内存配不上,也只能干等着。
中国存储产业在什么位置
美国对华芯片制裁,主要卡的是先进逻辑芯片(7nm 以下)和计算 GPU,存储芯片管得相对松一些。三星和 SK 海力士在国内的 NAND 和 DRAM 工厂,现在也还拿得到进口设备的许可。
国内厂商的进展只能说超出预期。DRAM 这边,长鑫存储(CXMT)的 DDR5 已经量产,LPDDR5 也开始给手机厂商供货了。长存(YMTC)的 NAND 做到了 232 层,追平了国际主流。
但 HBM 这块差距还是很大。HBM 要 TSV 封装,要硅中介层,要多层堆叠,这些技术国内做得远不如标准 DRAM 成熟,到现在还没能量产 HBM2e 及以上级别的产品。美国制裁下一步要卡脖子的,多半就是这块。
最后说说我怎么看这个周期。这轮存储超周期不是一次短期的芯片短缺,底下推着它的,是 AI 的重心从训练往推理挪,而且挪过去就不会回来了。推理需求跟着 AI 应用的渗透率走,渗透率涨它就涨,甚至涨得更快。产能那边不是这个节奏,前面说了,TSV 扩一轮就要 12 到 18 个月,只能一个台阶一个台阶往上走。所以往后拉长看,这个缺口会一直在。要说谁受益,我自己会盯 HBM 产业链上的那几环,设备、封装和材料。做算力基建的朋友应该早就有体感了,在 TCO 模型里,内存成本已经是占比最大的单一项。


