
租一张 GPU,电费其实只是零头
前面七篇大部分时间在跟电、热和网线较劲。大家看到了怎么抢燃气轮机,怎么把高压电一路降到低电压,还有怎么拿冷却水把热量搬出机房。看多了这些重工业设备,很容易觉得电费是 AI 机房最大的开销。
其实把一张 GPU 每小时的账本摊开,电费只占一毛到三毛多美元。租这张卡一小时,要两美元到四美元多,看是哪一代卡。所以算力生意的钱,主要看合同怎么签,谁锁价,谁来兜底。
先跟着 Kian 在课里的算例把电费账算一遍。假设一张 GPU 满载功耗是 1 kW,在 100 个小时里租出去了 80% 的时间。跑满的那段时间耗电 80 kWh。剩下闲着的时间,机器待机也要耗掉大约 4 kWh 电。
这两块加起来一共是 84 kWh。摊到收到钱的计费小时上,每卖出一小时算力,大约耗电 1.05 kWh。如果当地电价是 $80/MWh,这一小时电费只有 $0.084。就算电价翻倍到 $160/MWh,每小时电费也才 $0.168。
当然 Kian 这个简化算例没把服务器其他部件和散热算进去。按实际规格算,一台装 8 张卡的 DGX H100 满载功率是 10.2 kW,摊到每张卡大概 1.3 kW。到了新一代机柜,一柜 72 张卡的热设计功耗大约 135 kW,每张卡接近 1.9 kW。
再加上散热和配电损耗,按 PUE 在 1.25 到 1.3 之间折算,电表上走掉的电会多一截。上一代卡每小时大约耗电 1.2 到 1.7 kWh,新一代每张卡大约是 2.3 kWh。按前面的电价折算,一张卡跑一小时的真实电费在 $0.10 到 $0.37 之间。这么算下来,电费还是几毛钱的零头,卡的租金是两到四美元多。
成本大头全在 GPU 硬件本身,背后还叠着英伟达 75% 的毛利率(2027 财年二季报数据)。像 CoreWeave 这类新型 GPU 云(neocloud),在运营层面是能赚钱的。2025 年三季度 CoreWeave 的调整后营业利润率是 16%,但算上利息这些开销,调整后还是净亏损。
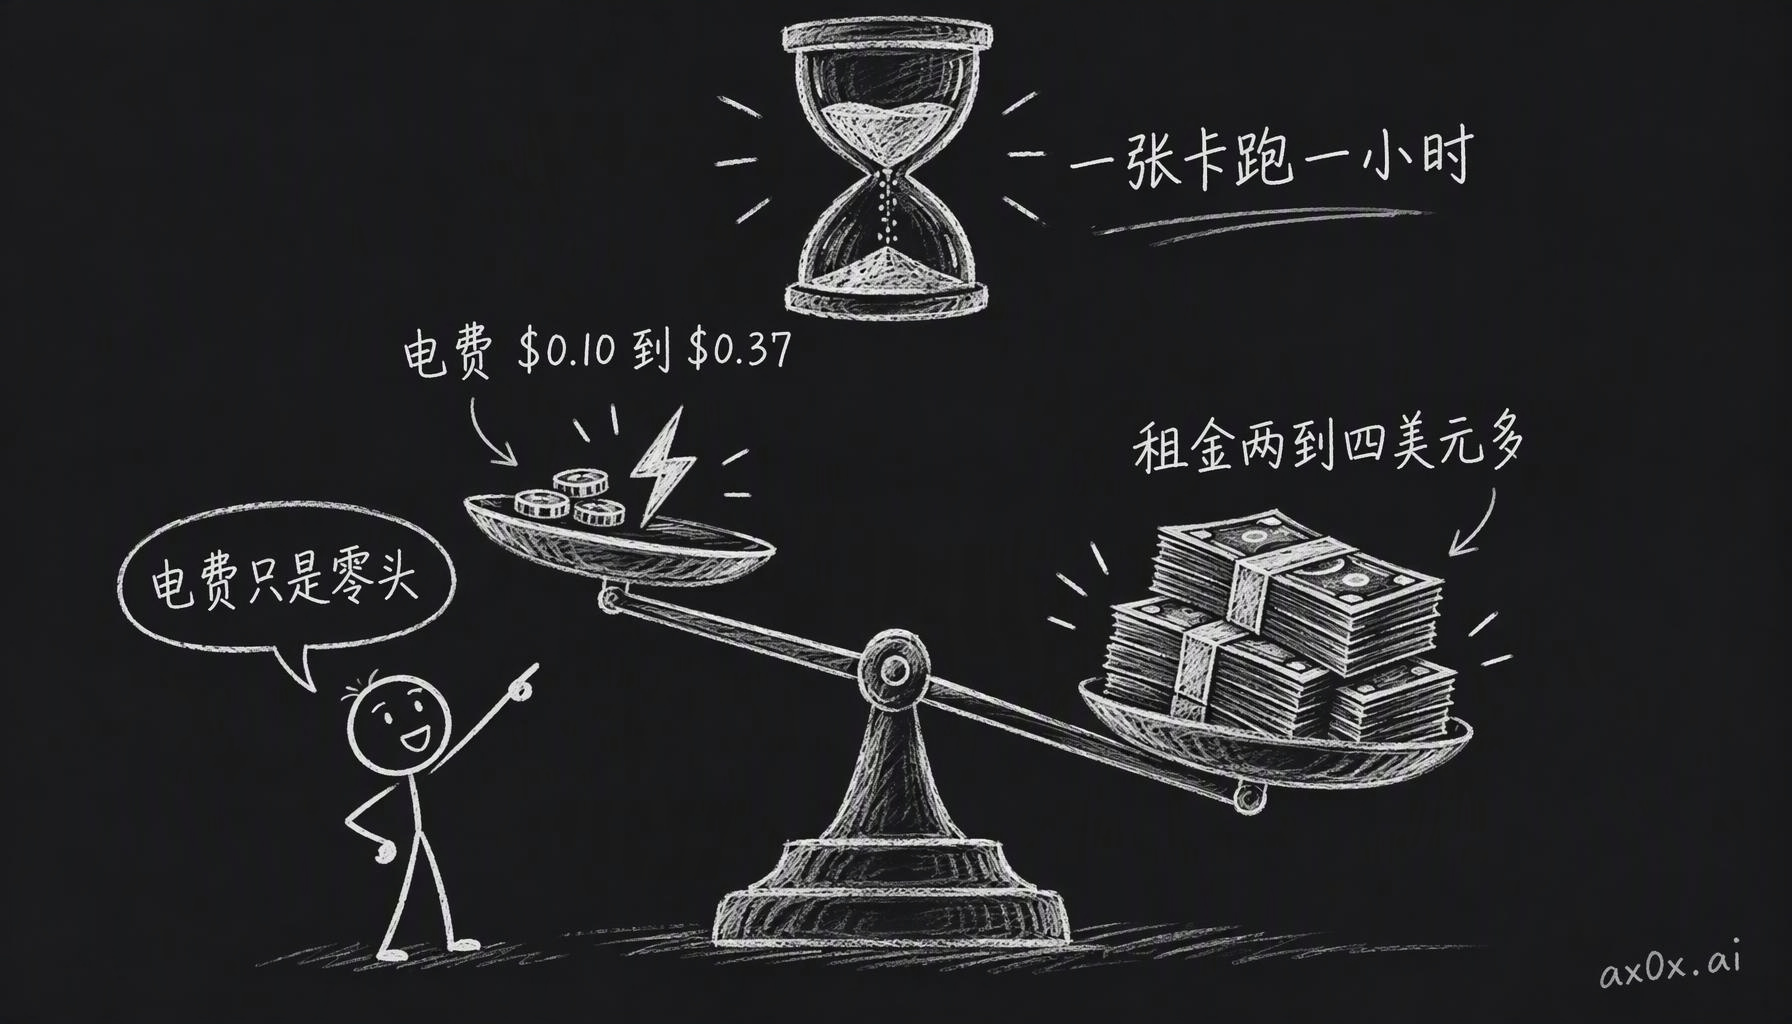 一张卡跑一小时,电费只有 0.10 到 0.37 美元,租金要两到四美元多,电费只是零头
至于电价波动的风险由谁来扛,合同里通常有两种写法。一种是固定全包价,电价涨跌都由云厂商自己吞。找到便宜电就多赚,电价暴涨就自己赔。另一种是电费顺加(pass-through),或者把租金跟电价指数挂钩,电费涨了由客户买单。
租卡和买 token 是一体两面,合同期限在赌未来价格
既然大头在硬件折旧上,GPU 云最核心的事就是把卡租出去。市面上卖算力分两种形态。一种是直接卖 GPU 小时数或集群档期,客户拿到底层机器自己跑训练或推理,再包成 API 卖给用户。另一种是平台自己把模型跑起来,按 token 卖 API。
就算同样租底层算力,相同的硬件也分两种玩法。一种是裸金属自管(bare metal)。扩缩容、更新和推理框架全由客户自己管。按 Kian 的说法,好处是灵活,而且不用上复杂的加密,云厂商也碰不到模型权重。Anthropic 在 2026 年 4 月和 CoreWeave 签了多年期合同,Kian 说他们就是自己管底层。
另一种是托管推理(managed inference)。模型还是客户自己的,但应对流量洪峰的扩缩容和日常维护交给平台。比如 Cursor 那个改代码很快的 fast apply 模型,底层是一个微调过的 70B 模型。它就放在 Fireworks 平台上托管运行,配合投机解码每秒能跑大约 1000 个 token。
如果去租 GPU 小时数,合同又分成三档。第一档是按需实例(on-demand),随用随付,不用签长约,月底想停就停。Kian 拿按量计费的 Claude Code 或 Codex 企业版打比方,用多少付多少。因为客户没给长期承诺,平台又不能随便掐断任务,所以按需的单价最贵。
第二档是竞价实例(spot),云厂商把闲置机器拿出来按市价甩卖,比按需便宜。但合同客户一旦要用,平台只提前很短时间通知就会把卡收走,比如 AWS 只给 2 分钟的中断预警。这种卡只能跑不怕断的任务。拿来跑训练就得频繁存检查点(checkpoint),被收走后才能接着跑。
第三档是承诺容量(committed capacity),双方签死期限和单价,属于照付不议的硬义务,用不用都得给钱。对 GPU 云来说,长约才是命根子。CoreWeave 年报显示,它在 2025 财年有超过 98% 的收入来自长约。而在更早两年,这个比例也分别高达 96% 和 88%。
签长约还是签短约,是在锁定收入和保留涨价权之间做交换,跟房贷选固定利率还是浮动利率一个道理。签五年长约能拿到确定的现金流,但放弃了中途涨价的机会。签一年短约,到期如果算力更紧缺,还能趁机提价。当然要是算力跌价了,短约也保护不了卖家。
正常来说电子产品买回来就在贬值,老卡的租金按理说应该越往后越便宜。但从 2025 年底到 2026 年春天,发生了一件反常的事。SemiAnalysis 跟踪了 H100 一年期合同的价格区间(取市场 25% 到 75% 分位,3 个月以上的合同一般要预付 25%)。
在 2025 年 10 月,这款卡的一年期单价是每小时 $1.45 到 $1.95。到了次年年初,单价微涨到 $1.50 到 $2.05。到了 2026 年 4 月,价格区间冲到了 $2.10 到 $2.70。半年时间里,区间中点从 $1.70 涨到 $2.40,涨了大约 40%。一个本该不断折旧的老硬件,合同价格反倒往上涨了一大截。
Kian 看着这条曲线下了一个判断。他觉得去年签下五年长约的买家等于捡了大便宜,接下来四年都能用远低于市价的成本拿卡。等合同到期续签的时候,这些大买家就得掏一大笔溢价了。作为参考,SemiAnalysis 估算现在 GB300 的五年期长约大约是每张卡每小时 $4.50 到 $4.60。这是更新一代的卡,不能跟上面 H100 的价直接比。
为了看清长约和散租怎么算账,Kian 列了一个算例。假设手里有 1024 张 GPU,一年一共 8760 个小时。如果选方案 A,把整个集群签成每小时 $2.5 的包年长约,全年稳拿 $22.43M 的收入。
如果选方案 B,不签长约,放进散租池按每小时 $4 零卖。要是全年只有 50% 的时间租出去,只能收到 $17.94M,比签长约少赚一截。把两个单价除一下,盈亏平衡出租率是 62.5%。
散租池只要租出去 62.5% 的时间,总收入就能追平包年长约,手里还多出 37.5% 的空闲机器可以机动。如果市场火热,散租池出租率冲到 80%,一年能比签死长约多赚大约 $6.3M。
合同就是抵押品,英伟达为什么要给云厂商兜底
既然散租在行情好的时候能多赚好几百万美元,为什么云厂商还是把绝大部分收入都签成了长约?因为买卡的钱是借来的。
新兴的 GPU 云没那么多现金去买几万张卡,必须找银行或私募信贷借钱。放贷机构不愿意陪你赌散租市场的出租率,只认白纸黑字签下来的长期容量合同。GPU 本身也能抵押,但债权人更看重的是云厂商手里那份客户长约,每个月的进账就靠它来还钱。
而且在债权人眼里,签字的那家客户是谁,直接决定了借钱的利息有多高。翻开 CoreWeave 在 2025 年二季报里披露的贷款条款,就能看到这笔账算得有多细。同样一批 GPU 做抵押,如果背后签算力合同的是指定的投资级大客户,贷款利率是基准利率 SOFR 加 6.00%。
如果签合同的是非投资级客户,利率就变成 SOFR 加 13.00%,利差翻了一倍还多。机房里插着的是同一批卡,就因为买算力的人信用等级不同,借钱的利差差出一倍多。
顺着这个融资逻辑往下看,就能看懂 Bloomberg 在 2025 年 10 月画过的那张英伟达、OpenAI 和云厂商之间的资金循环图。很多人看完那张图,觉得几家公司之间是钱绕了一圈又回来。我觉得把合同条款拆开看,最值得拆的是英伟达给云厂商签的兜底采购协议(backstop)。
2025 年 9 月,CoreWeave 和英伟达签了一份初始金额 $6.3B 的订单。这份订单一直管到 2032 年春天,跨度大约 6.5 年。协议的核心条款就一条,只要 CoreWeave 的算力在市场上没租出去,英伟达就必须按约定价格把剩下的空余容量全买下来。
具体的兜底单价没有公开,Kian 在课里拿每小时 $2 举了个例子。Kian 的说法是,这个保底价会定在市场租金以下,大概在刚好保本或者微亏的位置。这样云厂商才有动力先去市场上找客户,实在租不掉才找英伟达接盘。SemiAnalysis 估算,英伟达 2026 年新签的这类兜底协议里,GB300 的平均兜底价大约是每张卡每小时 $2.35。市场上同款卡的五年期长约是 $4.50 到 $4.60,兜底价差不多只有一半。
Kian 的看法是,有了英伟达这张六年半的保底单,云厂商就能拿着它去找债权人借钱买卡。Kian 还点出了这层兜底带来的另一个好处。云厂商不用为了凑够贷款期限,被迫跟客户签一份锁死五年的低价合同。它可以连着签三份两年期的短约,中间换客户要是出现空档期,直接让英伟达兜底就行,等两年期满还能跟着行情涨价。
英伟达这边也有好处。我猜一个是云厂商借得到钱,就能接着买英伟达的卡。另一个写在财报里,英伟达 2027 财年二季度的季报(2026 年 8 月底提交)说,这类 AI 云协议带收入分成条款,达到约定条件后,英伟达能从云厂商的租金里分走一部分。不过这套做法也出过波折。2026 年 8 月底《华尔街日报》报道、路透社转述说,这个计划推出不到 2 个月,英伟达就暂停了部分带收入分成的协议。英伟达随后出面否认暂停,只说项目还在调整。
底下的风险敞口才是最值得盯住的地方。按英伟达财报和 SemiAnalysis 的梳理,截至 2026 年 7 月,英伟达在「AI 云协议」这一项上的承诺约 $36B,摊在未来大约 6 年里。这只是英伟达几类承诺里的一项。
拿这笔钱去比英伟达现在 $5.2T 到 $5.6T 的市值和家底,Kian 觉得它比扛着巨额租约的 Oracle 保守得多。但 Kian 明确提到,算力供过于求在未来是一个很现实的风险。按 Kian 的说法,真到了算力过剩那天,云厂商租不出去的那部分卡就得由英伟达按约定买下来,到时候英伟达自己也未必用得掉。
选址和买地,快上线的代价都花在看不见的地方
合同和贷款定下来,就得找地盖机房。第三篇算过,早上线一个月赚的租金,足够抵掉简单循环燃机一整年多烧的燃气费。为了抢窗口期,各家在选址上什么非常规招数都用上了。空地从零盖叫绿地(greenfield),像后面的 Abilene 园区,图纸顺手但管线厂房全得新修。接手旧厂房叫棕地(brownfield),图的只有快。
xAI 在孟菲斯的集群就是典型的棕地改造。他们搬进伊莱克斯(Electrolux)留下的旧家电厂,2024 年年中就跑起来了。这个项目直接接上了现成的供水主管和燃气主管,每天最多能取 100 万加仑水。
但家电厂毕竟没打算塞满高功耗 GPU。厂区原来的变电站只有大约 8 MW,而新集群需要约 150 MW。当地电力公司 MLGW 先把旧变电站升级到 50 MW。2024 年底田纳西河谷管理局(TVA)批了全部 150 MW,中间还得新建变电站,缺口先靠现场的燃气轮机顶着。
地基太软也费工夫。Ada Infrastructure 在东伦敦旧油漆厂原址上建 210 MW 园区(3 栋楼各 70 MW)。脚下是松软的河滩沉积层,施工队得往下打深桩,再往土里打大量地基加固柱,机房才不会往下沉。Kian 说桩打到 6 米深,加固柱用了大约 6000 根。
嫌盖楼太慢,有人干脆连楼都不等了。Meta 在俄亥俄州建 Prometheus 园区(目标 2026 年上线约 1 GW)时,永久厂房还没盖好,先搭起防风雨铝架帐篷,配好预制供电散热模块把 GPU 塞进去跑(Kian 估计几周到几个月就能立起来)。Kian 的看法是,先搭帐篷、以后再搬家肯定要花两遍钱,可早几个月跑出 token 赚的钱比这笔折腾费大得多。
同样为了抢上高密度算力,Meta 还拆过半截新楼。2022 到 2023 年间,Meta 在德州 Temple 有一栋按老式低密度方案盖到一半的机房。据 SemiAnalysis 披露,AI 爆发前 Meta 的机柜功率密度在几家大厂里最低,Google 那时候通常已经在 40 kW 以上。发现老图纸装不下新硬件后,Meta 在 2022 年 12 月叫停施工,把盖了一半的厂房拆掉重来。
买地还会撞上法律坑。德州实行「产权分离」(split estate),地皮归你,地下油气矿产权可能归别人,而且矿产权优先。没拿到矿产权利人的放弃声明(waiver),采油公司理论上能开钻机进园区打井。New Era Energy & Digital 在德州 Odessa 附近有一块 493 英亩的地,规划的数据中心约 1.4 GW。按公司 2026 年的最新进展,还差最后一家矿产租赁方签放弃地面作业的协议。
离居民区太近又会惹出噪音。加拿大运营商 Rogers 在安大略省 Owen Sound 的机房紧挨民房和教堂,冷机一开邻居就不停投诉。最后 Rogers 围着冷机搭了一圈吸音墙,跟高速公路边的隔音屏一个思路(Kian 说一共 16 段)。墙挡住往四周传的噪音,头顶留空,让热风往上走。
天灾和外线施工也得防。2017 年 8 月哈维飓风袭击美湾沿岸时,休斯顿积水断路。Equinix 在当地的机房提前备好了行军床、食物和饮用水,6 名员工在机房里住了好几天,整场风暴里机房一直没停。佐治亚州 Suwanee 的 QTS 机房则从不同方向修了好几条独立光纤入口,免得外面施工一铲子把机房断网。
图纸画到一半机柜功率翻倍,预制化和边建边跑怎么救场
拿地后就进了工程、采购和施工(EPC)。工程把开关柜、变压器和管道规格算准。采购去抢变压器这类长交期设备的排产档期。施工负责浇地基、把预制设备钢架(skid)吊装到位、接通管网。
听起来按部就班,可现在建 AI 机房最头疼的是,楼还没盖完,新一代机柜的功率密度可能已经涨了一大截。AFCOM 的行业调查显示,数据中心平均机柜功率密度从 2025 年的 16 kW 跳到了 2026 年的 27 kW。Kian 在课里也引用过一张美银的图表,说机柜密度差不多每隔几年就翻一倍。
Kian 用一个算例拆解了图纸画到一半、机柜密度翻倍会惹出什么麻烦。假设在建一座 20 MW 的机房,分成 10 个 2 MW 的功能区(zone),原设计每个区放 20 个 100 kW 机柜。结果施工到一半,新硬件要求改成单柜 200 kW,每个区只放 10 个机柜。
园区总功率没变,但单柜功率翻倍会把四条线同时撑爆。第一条是电路。电压不变,单柜支路电流翻倍,原按 160 A 选的断路器和母线全部超载,必须重换。
第二条是冷却水流量。进出水温差同样卡在 10 °C,单柜每秒水流要从约 2.4 kg 升到约 4.8 kg/s,直接撞穿原来 3 kg/s 的支路管道上限。
第三条是水压。管道压降跟流量的平方成正比,流量翻倍,压降翻四倍。支路压降会从原来的 20 kPa 涨到 80 kPa,超过了支路允许的 60 kPa 压降上限。第四条是地板承重。同样总重量压在一半的机柜位置上,单点承重也跟着翻倍。一柜 GB300 就重约 1.5 吨。
为了不在工地上临时改管线,现在的办法是把组装尽量挪进工厂,也就是预制化(prefab)。AWS 和 Cupertino Electric 合作的 Project Houdini 在 2026 年春天曝光。他们在工厂里直接造好约 45 英尺长的模块化机房组件,拉到现场拼起来,服务器安装时间从大约 15 周缩到了 2 到 3 周。
预制化把验收测试也搬进了工厂。内部接线保护、管道测漏和控制器模拟测试,出厂前全做完了。到了工地,施工队只需测模块接缝、实际水流量和真实传感器的联动反应。
多家工厂各造各的模块,靠 OCP(Open Compute Project,2011 年由 Facebook 发起的开源硬件组织)定死进出接口就能拼上。比如液冷快拆头统一用 UQD(Universal Quick Disconnect)标准,A 厂插头就能插进 B 厂插座。当然,接头能插上,支路容量也得够用才行。在刚才那个算例里,就算用了标准 UQD 接头,3 kg/s 的支路管道还是喂不饱 4.8 kg/s 的机柜,管径照样得改。
OCP 干的另一件大事是 Open Rack 机柜标准。它把原本分散在每台服务器里的电源模块抽出来,集中放进机柜级的电源架(power shelf),再接到竖着的母线排上。比如 GB300 的一个电源架里插 6 个 5.5 kW 的热插拔电源模块,坏一个直接拔下来换,不用停机。第四篇讲过的 800 V DC 架构,是英伟达先拿出的参考设计,现在 Google、微软和英伟达在 OCP 里一起做标准化。Meta、Google 和微软还在 OCP 里出了一份 ±400 V DC 的侧柜规范,给现有机柜过渡用。
机房按功能区一块块点亮。只有当一个区的供电、冷却水和网络(比如配好 32 下行加 32 上行端口的叶交换机)三条线全完工,这个区才能通电。在 Kian 的算例里,100 个机柜中有 60 个所在的区先凑齐了水电网,这 12 MW 算力就能先开机赚钱。
边建边跑最怕误伤已上线的机房。2025 年,CoreWeave 在 Applied Digital 位于北达科他州 Ellendale 的园区先后租下了一共 400 MW,租期约 15 年,总额约 $11B。第三篇讲过,头两批各 50 MW 分别在 2025 年 10 月底和 11 月底交付。
一期已经在跑客户任务,二期施工绝对不能把一期的电或网弄断。Kian 讲的规矩是,如果二期要开挖的地皮底下正好埋着一期在用的光纤和进场道路,施工队必须先把新路和新光纤修好、测通、把业务切换过去,最后才能动铲子开挖。按 Kian 的估算,挖断一根在跑业务的干线光纤,一天可能就是约 $1M 的损失。
把整套账本装进同一座园区,从头拆一遍 Abilene
讲完合同、融资、选址和施工,最后拿德州 Abilene 收个尾。它是 OpenAI Stargate 计划的旗舰园区,前面七篇讲的物理账和这一篇的钱账,在这一座园区里都能找到。
先看这座园区是谁建的、谁在管、钱从哪来。在 Lancium Clean Campus 这块场地上,一共有三层角色。Crusoe 负责设计、建造和运营底层的机房设施。Oracle 作为租户把场地租下来,部署自己的 OCI 云并持有里面的芯片。最上面的 OpenAI 则是真正跑训练和推理任务的用户。
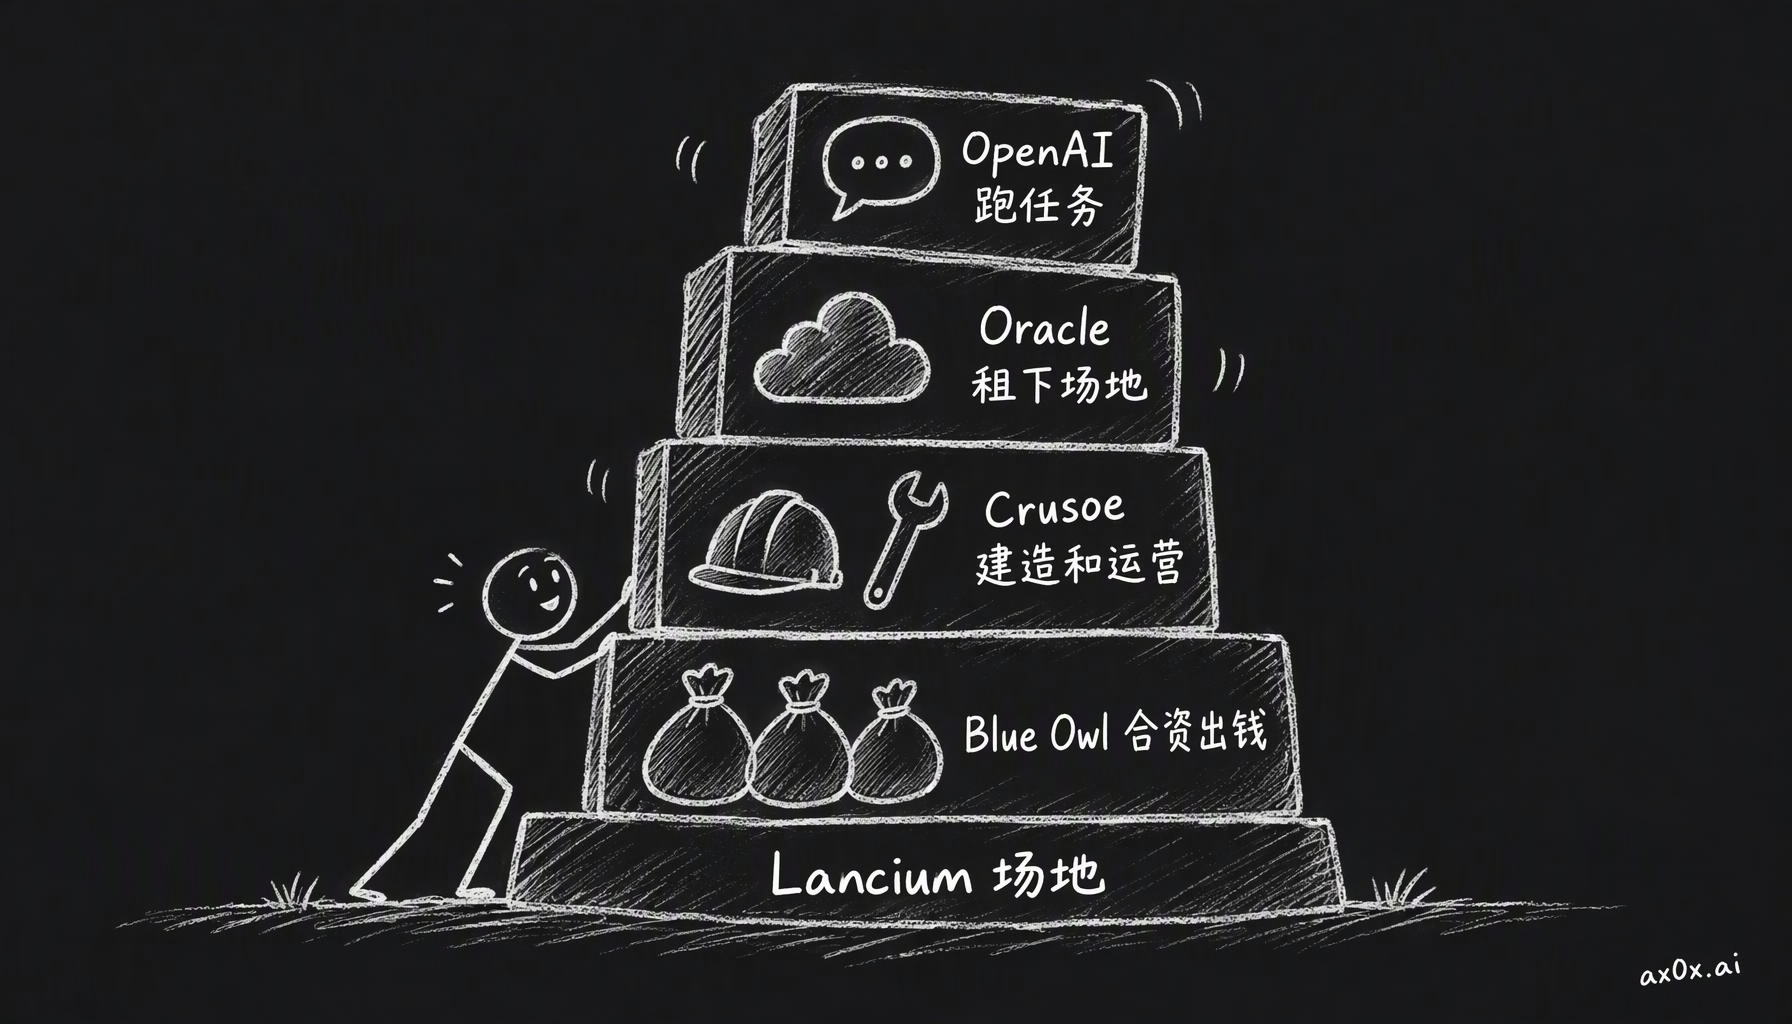 Abilene 园区的层层结构:Lancium 的场地上,Blue Owl 等合资出钱,Crusoe 建造和运营机房,Oracle 作为租户租下场地,最上面的 OpenAI 跑训练和推理任务
盖园区的钱由多方合资筹集。2024 年秋天,Crusoe 拉来 Blue Owl Capital 和 Primary Digital Infrastructure 成立 $3.4B 的合资公司,建一期的约 206 MW。次年春天,三家又把合资盘子扩大到 $15B,用来建二期的 6 栋楼。
整个 Abilene 园区建成后一共 8 栋楼,总规模 1.2 GW。外面常听到的 10 GW 是整个 Stargate 计划的目标,Abilene 只是最先落地的一处。Kian 觉得这种三层结构有点怪,Crusoe 盖好楼本来可以直接租给 OpenAI,中间却隔了一层 Oracle。他的解释是 Oracle 有意揽下了给 OpenAI 供算力的巨额承诺。Kian 也提醒了一句,这套合资加长约的结构能转起来,全靠最顶上的 OpenAI 一直付租金。真到了算力过剩那天,他觉得这套结构未必还稳得住。
站在这块工地上往里看,前面七篇讲的每一环都在运转。首先是第一篇说的三根管子,电从电网和燃机流进来,热顺着冷却水排出去,数据顺着铜缆和光纤跑通。哪根管子最窄,有效算力就卡在哪。
接着是第二篇讲的模型负载怎么决定机房设计。如果只跑普通推理,很多时候装进一个机柜的 scale-up 域里就够用了(当然超大规模 MoE 模型把 prefill 和 decode 拆开跑时也会跨机柜)。Kian 的说法是,OpenAI 会想在这里跨楼跑大规模预训练,数据得跨机柜、跨整栋楼高频同步,所以这种机房从画图纸那天起,供电和网络就得按最重的预训练负载来配。
电从哪来?这就回到第三篇的抢电逻辑。德州电网 ERCOT(Electric Reliability Council of Texas)的大负荷并网排队名单,到 2026 年年中已经涨到了约 474 GW。2026 年 8 月 3 日,德州州长 Abbott 下令对所有 75 MW 以上的数据中心申请做全面审计,ERCOT 随即暂停了这类负荷的通电审批。
为了不在排队名单里干等,Abilene 在场内配了约 360 MW 的简单循环燃气轮机当过渡电源。这批机组在 2025 年初获批,包含 5 台航改型 GE 燃机和 5 台 Solar 燃机,燃气由 Energy Transfer 从主干管网接出来的专用支线供应。按 Crusoe 的说法,园区直接连着 ERCOT 主网,这批燃机最终会留下来替代柴油发电机,当数据大厅的备用电源。
电进场之后怎么一步步喂给芯片?这就是第四篇拆过的降压阶梯。Abilene 二期的变电站接的是 345 kV。往下按美国大园区常见的走法,先降到 34.5 kV 中压分给各栋楼,再在楼边降到 480 V,进机柜变成约 50 V 直流,最后在芯片旁边降到 1 V 左右。Abilene 中间这几级具体是多少伏,没有公开资料。
为了不被长交期的配电设备卡脖子,Crusoe 干脆在俄克拉荷马州 Tulsa 自建了电气设备制造厂。第二座 Tulsa 工厂 2026 年 9 月投产,Crusoe 自己造中压开关柜、低压配电盘和铜母线排,光给 Abilene 就送了数千台配电盘。
电网闪断怎么办?这是第五篇讲过的那场接力赛。训练集群同步时几十 MW 的功率锯齿,第五篇也讲了,主要靠机柜里的电容和 BBU 先垫住。芯片旁的电容、机柜里的 BBU、机房的 UPS、院子里的发电机一棒接一棒,每一棒都在替下一棒争取时间。按 Crusoe 的说法,Abilene 那批燃气轮机将来就是接最后一棒的备用电源。
几万张卡怎么连成一台机器?第六篇讲过机柜内部走 NVLink 铜背板,跨机柜和跨楼走高速光网络(物理账可看铜和光在哪条线上换班和光电转换点该建在离芯片多近的地方)。Abilene 一期两栋楼 2025 年 9 月底就开始跑 OpenAI 的任务,后面几栋还在施工。Kian 提到,OpenAI 跑大规模预训练会想让几栋楼之间互相通信,所以新楼迟早要接进同一张网,接的时候还不能打断已经在跑的任务。
烧掉的电力全变成热,怎么排出去?这就落到了第七篇。西德州气候干燥缺水,园区用了闭环液冷加风冷冷水机组(air-cooled chillers),不靠蒸发水散热。按 Crusoe 的说法,每栋楼的闭环管网第一次注满要大约 100 万加仑水,之后每年维护补水约 5 万加仑。
Crusoe 把这套方案宣传为「为了负责任的水资源管理主动承担了更高的成本」。Kian 对这话只信一半,他觉得这里面有一半是公关包装,因为在缺水的西德州要是上大口喝水的蒸发塔,肯定会惹来当地居民反弹。而且 Kian 认为长远来看,满地机房抢水会让水比电更难拿,只靠电的风冷方案说不定反而更划算。当然反过来看,风冷冷机比蒸发冷却更费电,尤其在德州炎热的夏日下午,压缩机得花更多电才能把热顶出去。
最后看看真实交付进度。前阵子行业里流传一种说法,说美国有一半的数据中心项目都延期或取消了。这个数字本身就有争议。2026 年春天,Bloomberg 引用 Sightline Climate 的统计,说当年美国计划的数据中心产能有 30% 到 50% 延期或者有风险。随后 SemiAnalysis 在 6 月发文反驳,说那个统计把分母算错了。
单看 Abilene 自己的时间表,一期在 2024 年 6 月动工,包含两栋楼、约 98 万平方英尺、200 MW 以上容量。实际进展是,两栋楼在开工一年内通了电,跟原定的 2025 年上半年差不多。Oracle 2025 年 6 月开始往里装 GB200 机柜,9 月底 Crusoe 宣布一期开始跑 OpenAI 的任务。
二期的 6 栋楼在 2025 年春天开工,原定次年年中完工。按 Oracle 在 2026 年 9 月披露的口径,园区约 75% 的容量已经交付,剩下的顺延到了后面几个季度。
独立机构 Epoch AI 用卫星图像追踪给出的估计(2026 年 10 月更新)则保守一些。他们测算当时实际在跑的 IT 功率约 421 MW,预计到当年四季度爬升到约 843 MW,后面几栋楼虽然封了顶,但年中时还没确认投产。两边数字对不上,我猜有一部分原因是口径不同,一边可能按园区总容量算,另一边只算已经点亮的 IT 功率。
Kian 在整门课结束时说了一句很实在的话。在单个机柜里,你跑什么模型决定了要喂多少电、排多少热、插多少根网线。等你把视角拉大到整座园区,这些需求就一级级放大成变电站、户外的冷机群、燃气轮机、大片土地和大笔融资合同。选定一颗芯片,最后长出来的是一整座机房的设计图。
落回平时调 API 的人身上,我觉得这本账能解释一件事,各地电价涨涨跌跌,token 的价格多半跟着动不了多少。按前面的账,一张卡一小时的电费大多在租金的一成上下,你花在 token 上的一美元里,付给电厂的大概也就几美分到十几美分。大头是 GPU 本身,再加上盖楼、配电、散热和长约融资的钱。
本系列整理自 freeCodeCamp 上 Kian(@neuralkian)的课程「Inside an AI Factory – Power, Cooling, and GPUs Explained」(课程原名 From Watts to Tokens,讲义在 kiankyars.github.io/gigawatt)。框架和大部分例子是 Kian 的,我按主题重新编排、核对了数字,理解有偏差的地方锅在我。文中提到的公司只是例子,不构成任何投资建议。