
AI 机房说到底就是三根管子
2025 年底,微软 CEO Satya Nadella 和 Sam Altman 一起接受采访时说了一句大实话。他说微软当时最头疼的问题根本不在芯片供应,库房里甚至堆着一批没地方插电的 GPU,卡脖子的是电,还有离电源够近的机房大楼。
平时看科技新闻,大家最爱聊谁家又囤了几万张卡,或者谁家又签了几百兆瓦的电力合同。可真把机房图纸摊开就会发现,多买几万张 GPU、纸面上多签几百兆瓦的电,离变成用户能用的算力,中间还隔着好几道坎。
一座 AI 数据中心拆开来看,其实就是三根管子在同时跑。第一根管子把电送进来,第二根管子把芯片烧出来的热排出去,第三根管子让数据在几万张 GPU 之间来回飞奔。整座机房能干多少活,上限完全由这三根管子里最细的那根决定。只要有一根卡住,另外两根修得再粗也是白搭。而在眼下这个节骨眼上,全行业最细、最卡脖子的那根管子就是电。
这套从电线一路追到模型的视角,来自 Kian(@neuralkian)在 freeCodeCamp 上开的 16 章长课,他自己说里面大量借了 SemiAnalysis 的硬核研究。Kian 觉得数据中心会是近几年拉动经济增长最猛的引擎,而正是因为到处都在卡脖子,才逼出了那么多软硬件上的奇思妙想。我把这 16 章按主题重新理成了 8 篇,第一篇先把机房的底图摊开,顺着一个 token 往回倒,看看那三根管子是怎么转起来的。
一个 token 背后有三根管子同时在跑
咱们从你每天都会碰到的一幕开始往回倒。你在电脑上打开 Claude Code 或者 Codex,敲下一行提示词按回车,屏幕上开始往外蹦字。这一个 token 是怎么从远处的机房里钻出来的?
先看数据这根管子。你的请求顺着地下光纤一路跑进数据中心园区,穿过园区边缘(campus edge)的路由器,钻进机房大厅,落到某一台机柜(rack)里的计算托盘(compute tray)上。托盘里躺着一台完整的服务器,上面有 CPU、系统内存(RAM)、NVMe 固态硬盘,还有主角 GPU。要是机器刚启动加载模型,比如从 Hugging Face 上拉下来的权重,得先顺着网络进到 CPU 的系统内存,再拷进 GPU 自己的显存(HBM)。真正算的时候,数据流进 GPU 里的 tensor cores,和你的提示词做矩阵乘法。算出来的输出 token,再顺着光纤原路返回你的屏幕。
这根数据管子慢一点,代价比看上去大得多。Kian 在课上算过一笔小账,同样传一块 8 MB(也就是 64 Mb)的数据块,放在 10 Gb/s 的网线上要花 6.4 ms,换到 100 Gb/s 的网线上就只要 0.64 ms,外加比如大约 10 µs 的首比特固定延迟(Kian 随手举的示意数)。单传一小块数据,差几毫秒看着不大。可训练大模型的时候,几千张卡每一轮都要互相同步数据。哪条网线慢半拍,满屋子好几万美元一张的 GPU 就得干等着。
再看电这根管子。GPU 每做一次矩阵乘法都在吞电。这股电从远处的发电厂出来,先升到几百千伏,顺着输电铁塔走。到了机房门口的园区变电站(substation),降成中压。进了大楼的配电室,再穿过不间断电源(UPS)和一层层配电柜,最后进到每个机柜的电源架(power shelf),变成低压直流电送进芯片。供电为什么要走这种树状的分级路线,放着一根超级粗的总电线不用?因为分级配电才能把故障关在笼子里。万一哪根线短路跳闸,断电的只是它下面那一支,不至于整栋楼一起黑掉。
最后看热这根管子。电进到 GPU 里算完题,能量去哪了?几乎一丝不落地全变成了热。贴在 GPU 脑门上的金属冷板(cold plate)里流着冷却液,把热吸走,顺着机柜背后的管路流到机房走道外面的冷却液分配单元(CDU)。CDU 里面的换热器把热倒给大楼的设施水循环,一路送到室外的散热设备排进大气里。
如果你走进一座大厂的 AI 机房,比如 Google 在俄亥俄州 New Albany 的那座数据中心(里面跑着 TPU v5e、v5p 和 v6e 集群),你会发现整栋建筑被切成了两个世界。摆满一排排机柜的大厅,行话叫白区(white space)。头顶走着冷却管道,每台柜子插着黑色电源线。按行业里常说的解释,这么叫是因为大厅得严格防尘,墙面和地板也大多刷成白色。白区四周那些机房和走廊叫灰区(gray space),开关柜、变压器、UPS 电池组、冷水机组、CDU 和备用发电机都在这一片。外行看宣传照,只盯着白区里闪灯的机柜。可管电和管热的设备,大多在灰区。
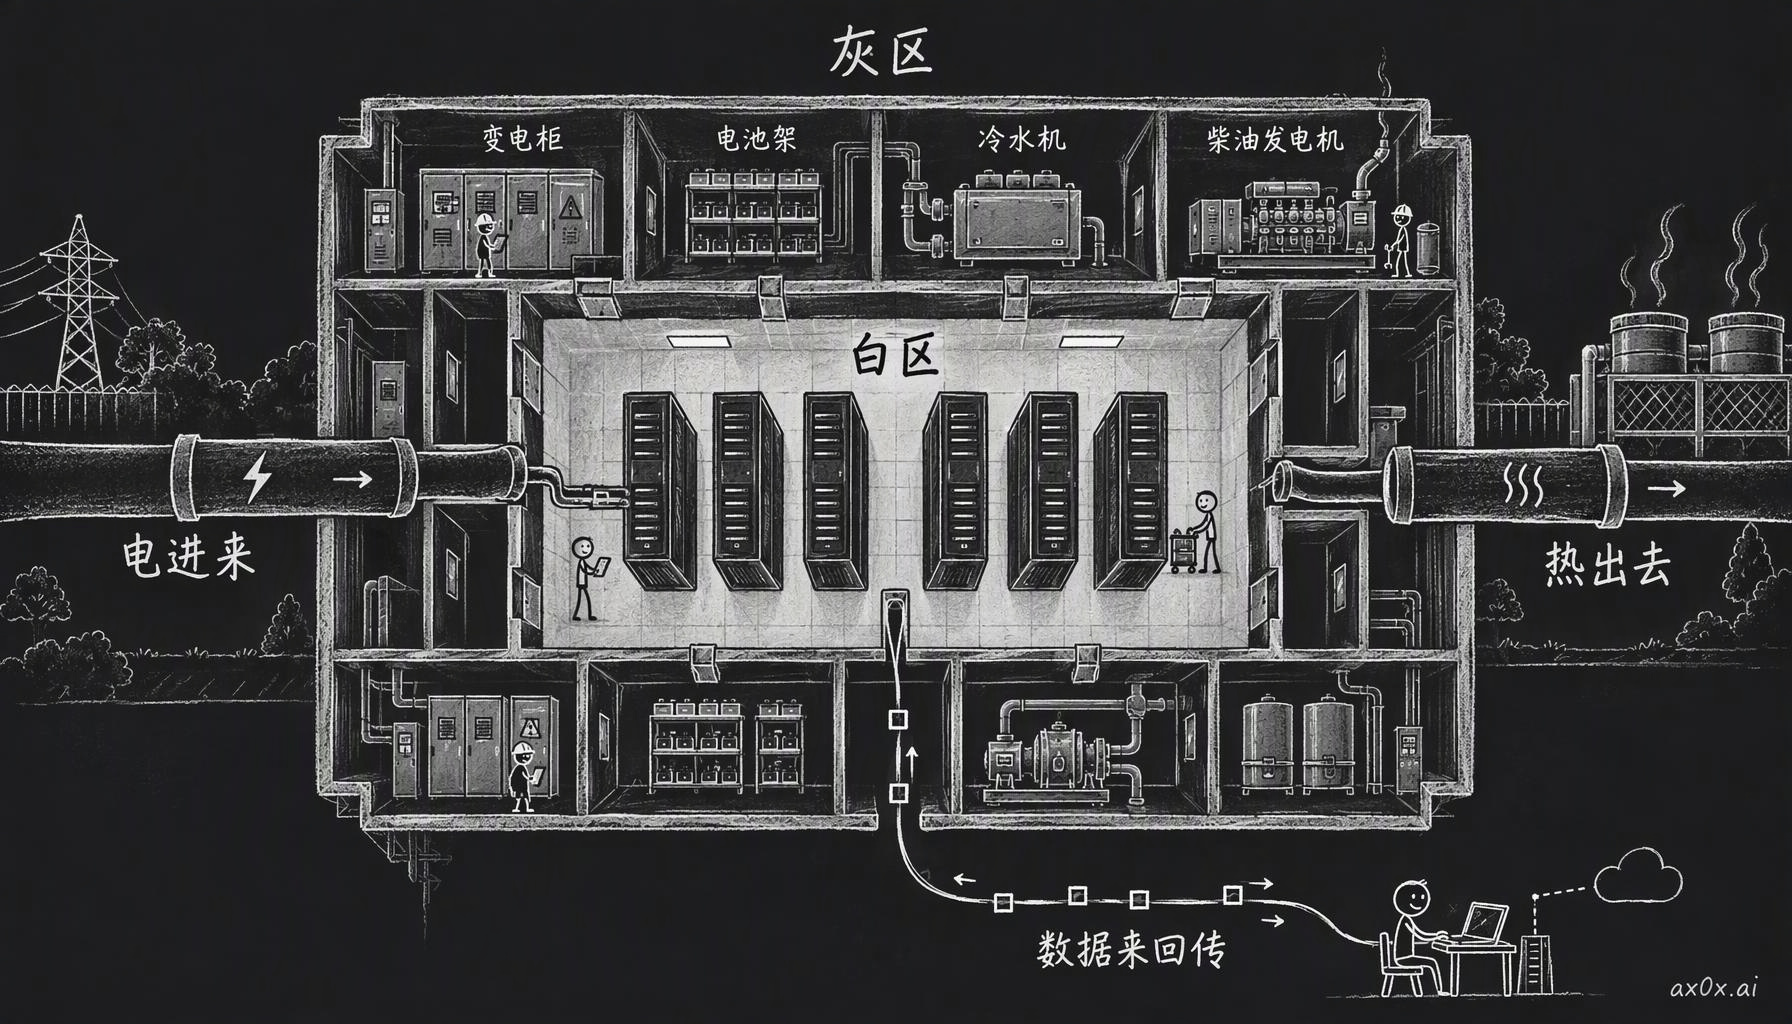 AI 数据中心就是三根管子同时在跑:电进来,热出去,数据来回传。机柜摆在白区,四周的开关柜、UPS、冷水机组和发电机是灰区,大部分限制都出在那里
拆开一台 GB300 机柜看看里面塞了什么
白区里最基本的一块积木就是机柜(rack)。它长得像个高大的铁书架,里面一层层全是能像食堂餐盘一样抽出来的托盘(tray)。整个系列我都会拿英伟达的 GB300 NVL72 机柜当标准参照物,因为它是眼下前沿 AI 机房最典型的一块积木。
先把这串型号拆开认一认。GB 指的是 Grace CPU 加 Blackwell GPU 拼成的超级芯片,300 代表 Blackwell Ultra 这一代(上面那颗 GPU 叫 B300),NVL72 代表整个柜子里的 72 张 GPU 用 NVLink 连成了同一个高速通信域。这么一个柜子里,整整齐齐塞了 72 张 Blackwell Ultra GPU 和 36 颗 Grace CPU。走到这台柜子正面往里看,里面主要是三类托盘。
第一类是干苦力的计算托盘(compute trays),一共 18 个,每个只有 1U 厚,分成上下两组摆在柜子里。每个计算托盘里躺着 4 张 Blackwell Ultra GPU 和 2 颗 Grace CPU,18 个托盘乘以 4 正好凑齐 72 张 GPU。
第二类是夹在计算托盘中间的 9 个 NVLink 交换托盘(NVSwitch trays)。它们干的活,是让柜子里的 72 张 GPU 像长在同一块主板上一样无阻塞地互相读写。靠着第 5 代 NVLink,每张 GPU 的通信带宽能到 1.8 TB/s,整柜 72 张卡加起来的总交换带宽高达 130 TB/s。机柜最顶上那 2 台交换机只管日常运维,GPU 的数据不走它们。GPU 往机柜外面发高速数据,走的是每个计算托盘上的 ConnectX-8 网卡,每张 GPU 配了 800 Gb/s 的出口带宽,直接连到机柜外面的 leaf 交换机上。
第三类是管喂饭的电源架(power shelves)。在英伟达标准的 8 电源架配置里,柜子里分两组塞了 8 个 33 kW 的电源架,每个电源架里插着 6 个 5.5 kW 的电源模块(PSU),整柜一共 48 个 PSU(像联想这些 OEM 厂商也会卖 6 个电源架、总计 198 kW 的非冗余版本)。这里有一笔很夸张的账。按联想的资料,整柜典型功耗大约 135 kW,短时峰值能冲到 155 kW 左右,英伟达自己给的规划上限是 142 kW。可 8 个电源架加起来能供 264 kW,差不多是典型功耗的 2 倍。
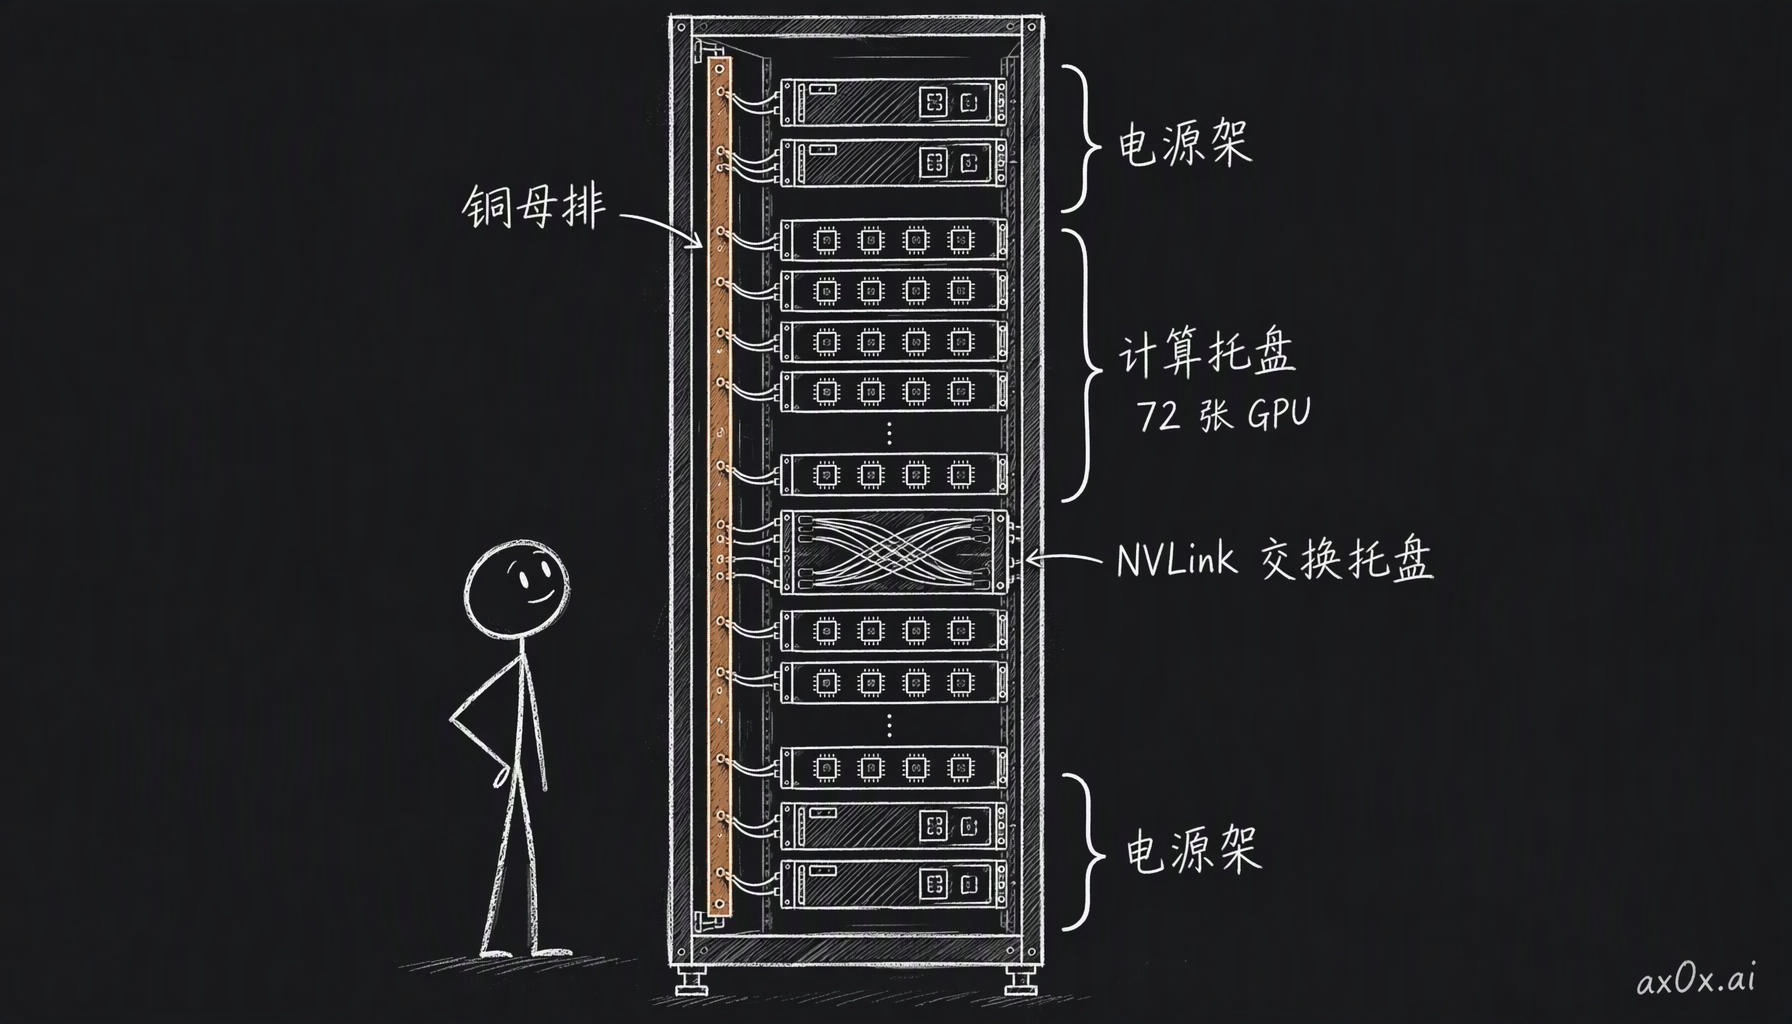 拆开一台 GB300 NVL72 机柜:18 个计算托盘装着 72 张 GPU,9 个 NVLink 交换托盘把它们连在一起,电源架分上下两组,背后一根铜母排给每个托盘供电
为什么要配这么多电源?因为这一个柜子里的每张 GPU 都要好几万美元,绝对不能因为坏个电源就停机。电源配得这么富余,就算整整 2 个电源架同时坏掉,剩下 6 个还能供 198 kW,比 155 kW 的峰值还高,72 张 GPU 照样满血跑。而且这 48 个 PSU 全都支持热插拔(hot-swappable),哪个模块坏了,运维人员趁着机器还在跑,直接拔出来塞个新的进去就行。
绕到机柜背面,你会看到电源架把从机房接进来的交流电转成了大约 50 V 的直流电(计算托盘允许的输入范围在 47.5 到 51.5 V 之间),直接喂给一根从上通到下的实心铜母排(busbar)。所有计算托盘和交换托盘都挂在这根铜排上取电。铜排旁边还绑着防地震的加固斜撑,外加密密麻麻的液冷管路。按联想的技术资料,GB300 NVL72 大约 90% 的热量靠液体带走,剩下大约 10% 还是靠风吹走。把这些芯片、铜排和冷却液全算上,一台满配机柜重达大约 1.5 吨(1.4 到 1.6 吨左右),往机房地板上一放,连楼板承重都得专门设计。
这个系列拿英伟达的机柜当基本单位,是因为它最典型。换到 Google 的 TPU 或者别家的自研集群,底下还是那三根管子,只是打包方式不同。按行业里的叫法,像 NVL72 这样在一个机柜内部用 NVLink 把几十张卡连成一台大机器,叫 scale-up(纵向扩展)。出了机柜,用 InfiniBand 或者以太网把成百上千个机柜连起来,再挂上存模型权重的存储网络,叫 scale-out(横向扩展)。Google 走的是另一套路子。他们 2026 年 4 月在 Cloud Next 上发了第 8 代 TPU(训练用的 TPU 8t 和推理用的 TPU 8i)。往回数 4 代的 TPU v4,是把 4,096 颗芯片连成一个 SuperPod,里面分成 64 个小立方体,每个 4×4×4 共 64 颗芯片。立方体之间用光学电路开关(OCS)连起来。OCS 里面是能偏转角度的小镜子,直接拿光束反射数据,哪条链路坏了,转一下镜子就能绕开故障。2023 年 Google 训 Gemini 1.0 Ultra 的时候,甚至跨着好几座数据中心一起训,机房内部靠 OCS 组网,跨机房则走 Google 自己的数据中心间骨干网。
为什么电网非要拉高电压而机柜里全是粗铜排
顺着电源架往外追,电是怎么一路从发电厂跑进机柜里的?源头当然是各种电站。烧煤和核电站是把水烧成蒸汽去推汽轮机。燃气轮机更像一台喷气发动机,直接拿燃烧的热气推涡轮。水电站(比如装机 22.5 GW 的三峡大坝)和风电则是用水流或风直接推叶轮。只要靠旋转电机发电,发出来的天生就是交流电(AC),电压和电流按正弦波来回摆。北美电网每秒摆 60 次(60 Hz),欧洲和国内是 50 Hz。
反过来,天生发直流电(DC)的电源只有三类。第一类是太阳能光伏,比如青海塔拉滩那座装机超过 15 GW 的光伏基地。第二类是电池储能。第三类是 Bloom Energy 那种固体氧化物燃料电池,不点火燃烧,靠电化学反应直接拿天然气发电。远距离输电倒是常用特高压直流,比如昌吉到古泉那条 ±1,100 kV 的线,能把 12 GW 的电送出约 3,300 公里。可你机房接进去的配电网,清一色是交流电。当年爱迪生和特斯拉、威斯汀豪斯为交直流打得不可开交,交流电能赢下配电网,就因为它用变压器升降压太方便了。
为什么要拼命把电压升上去?这就要搬出整个系列最值得记住的一条初中物理公式了。电功率等于电压乘电流(P = IV),而电线自己发热白白烧掉的损耗功率,等于电流的平方乘电阻(I²R)。
盯紧那个平方。拿 Kian 课上的算例来说,一根 6 Ω 的电线,加 12 V 电压,流过 2 A 电流,发热烧掉 2² × 6 = 24 W。要是把电压翻倍到 24 V,电流翻倍到 4 A,发热损耗就变成 4² × 6 = 96 W。电流才翻 2 倍,电线烧掉的热量直接翻了 4 倍。这个例子只是让你看清电流的平方有多狠。反过来算,送同样多的功率,把电压拉高 2 倍,电流就能砍半,电线上的发热损耗直接降到原来的 1/4。
所以发电厂的电出门第一件事就是用变压器升到几百千伏,比如德州 ERCOT 骨干网常用的 345 kV(现在德州还在往 765 kV 升)。靠着高电压、小电流,电跑完几百上千公里进到园区变电站,路上只损耗 5% 左右(美国 EIA 统计的全美平均数)。这么高的电压直接拉进楼会把空气电离击穿拉出电弧,所以园区变电站先把高压降成中压,进楼后再降成 480 V 的三相交流电。
为什么机房非要用三相电?因为家里插座那种单相交流电,电压每秒过零点一百多次,过零瞬间功率是 0。给手机充电无所谓,喂给上百千瓦的机柜就受不了了。三相电用三根火线,正弦波互相错开 120 度。Kian 给过一个算例,在 480 V 的平衡纯阻负载下,挑三个时刻看三根相线的瞬时功率,分别是 0+15+15 kW、5+20+5 kW、15+15+0 kW。单看哪一根都在起伏,可三根加起来每一瞬间都稳稳等于 30 kW。到了机柜里,每个 PSU 接一根火线和零线,看到的相电压是 480 V 除以根号 3,约 277 V,把 48 个 PSU 平均分到三根相线上就平衡了。这里还得盯紧功率因数(power factor),也就是电压和电流波形有没有对齐。要是波形错位让功率因数掉到 0.8,送同样多的实际功率就得多流 25% 的电流,电线发热又得往上蹿。
可一旦电源架把 277 V 交流电转成 50 V 直流电送进机柜,I²R 这个平方律就会反过来咬你。算一下 GB300 机柜后背那根铜母排的账,按典型的 135 kW 算,除以 50 V,上面流过的直流电流有 2,700 A。电流这么大,哪怕电阻很小,I²R 烧掉的热也很可观,所以机柜最后这一米非得用又沉又厚的实心铜排不可。这也埋下了第四篇的伏笔,为什么英伟达和一大帮合作伙伴在推机柜改用 800 V 直流。
电进机柜前,在灰区还得过备用电源和 UPS 这道关。现在从大电网拿电要排很长的队,很多急着开机的玩家干脆自己拉燃气轮机。比如 xAI 在孟菲斯的 Colossus 集群(xAI 2026 年 2 月并进了 SpaceX,7 月改名 SpaceXAI),一边接当地变电站,一边在电表后面(behind-the-meter)自己点燃气轮机、摆上一排排 Tesla Megapack 电池。Crusoe 在德州 Abilene 的园区主要从电网取电,旁边另建了一座约 360 MW 的燃气电厂,当过渡和后备电源(怎么抢电放在第三篇聊)。哪怕接上了电网,电网也会闪断。机房外面的备用发电机从点火到稳住输出接管负载,大概需要 10 秒钟。
这 10 秒钟的空当,全靠在线式双转换(online double-conversion)UPS 撑着。外行看双转换 UPS 的电路图都会觉得奇怪,电网进来的明明是交流电,它非要先用整流器变直流,再用逆变器变回交流喂给机柜,白白烧掉约 3% 到 4% 的电。多转这两道是有原因的。电池天生只能存直流电,双转换 UPS 把电池直接挂在中间那段直流母线上。外电网断掉的瞬间,不用扳任何机械开关,直流母线上的电池直接接上,切换时间是零。家用的离线式 UPS 要等开关切换,中间会断一下。母线上的电容还能顺手抹平极快的瞬态波动。这套毫秒必争的接力赛,留到第五篇拆到底。
吃进去的每一瓦电最后都得变成热搬走
电流送进 GPU 做完矩阵乘法之后,能量去哪了?按能量守恒,除掉顺着光纤发出去的那点微弱信号,吃进芯片的每一瓦电,最后都老老实实变成了热。一颗芯片吃 500 W 的电,就在原地放出 500 W 的热,也就是每秒 500 焦耳。想让芯片温度稳住,散热系统就得一直按 500 W 的速度把热从那块硅片上搬走。少搬一点,热量就攒在芯片里,芯片很快会过热降频。
偏偏这几年单颗 GPU 的胃口涨得像坐火箭。英伟达这几代主力卡排一排就看出来了。A100 标称 400 W,H100 SXM 涨到 700 W,B200 到了 1,000 W 左右,GB300 里的 B300 最高约 1,400 W。下一代 Rubin,据传单卡奔着 2 kW 左右去了。
单卡越来越费电,可芯片的能效其实一直在涨。按 Epoch AI 的统计,顶尖机器学习芯片的硬件能效每年都在提升约 40%,B200 每瓦特算力大约是 A100 的 3 倍。那为什么单卡功耗还在涨?Kian 说得很明白,芯片变省电的速度,赶不上芯片变大的速度。H100 单裸片塞了 800 亿个晶体管,到了 B200 直接拿 2 颗光刻极限尺寸的裸片拼出 2,080 亿个晶体管。晶体管数量翻着倍往上加,单卡瓦数自然刹不住车。
单卡破千瓦、单柜典型功耗 135 kW 上下,直接把传统风冷逼进了死胡同。按 Uptime Institute 2025 年的调查,全球大多数存量数据中心还在靠风扇吹,液冷普及得没那么快。可到了 GB200、GB300 这一级的前沿 AI 机柜,光靠吹风已经搬不走这么密的热,必须上直接液冷(DLC)。
机房的直接液冷用的是双循环隔离设计。第一圈叫技术循环(IT loop),金属冷板紧贴在好几万美元一颗的 GPU 顶盖上,里面流着经过严密提纯、沿途挂满漏液传感器的冷却液。冷却液从大约 30 °C 流进冷板(GB300 这一代托盘甚至兼容高达 45 °C 左右的温水进水,即 ASHRAE W45 级别),吸饱热后流到白区外面的 CDU。CDU 里的液对液金属换热器把热量隔着金属板传给第二圈,也就是大楼的设施循环(facility loop),再由设施水管送到室外的干冷器、冷却塔或冷水机组排进大气。分两套水路是因为贴着芯片的那圈水一旦漏一点或长水垢,毁掉的就是几百万美元的机柜,外面的设施大水管就算偶发渗漏也好修得多。两圈液体只隔着金属板传热,从来不混在一起。这笔热账和水账留到第七篇细算。
电表上的数字离实际算力还差着好几层
把白区的机柜和灰区的变压器、UPS、水泵全接好,怎么衡量这栋楼建得省不省电?行业里最常用的尺子叫 PUE(Power Usage Effectiveness,电能利用效率)。
算 PUE 之前,得先把机房账本上的三个数分清。第一个是铭牌容量(nameplate capacity),也就是供电局合同允许你拉的最大功率,或者门口燃气轮机的额定最大出力。这是硬天花板,实际规划还得留余量。第二个是 IT 负载(IT load),指机柜、交换机和存储阵列这些干计算活的设备吃掉的功率。第三个是设施辅助负载(facility support load),也就是水泵、冷机、风扇、UPS 损耗和照明空调吃掉的电。
拿 Kian 课上的算例对一下账。假设一座铭牌容量 2 MW 的小机房,摆了 10 台机柜,每台按英伟达给的 142 kW 上限留电(共 1.42 MW),外加 80 kW 的网络和存储,IT 负载正好是 1.5 MW。灰区的水泵和空调再吃掉 300 kW 辅助负载,整座机房总功率就是 1.8 MW,稳稳卡在 2 MW 红线内。
把机房总耗电除以 IT 负载耗电,算出来的比值就是 PUE。按刚才的例子,1,800 kW 除以 1,500 kW,PUE 是 1.2。要是改进散热把辅助负载砍半到 150 kW,总功率降到 1,650 kW,PUE 就压到了 1.1。理想极限 PUE 是 1.0,代表每一瓦电都进了 IT 设备,物理上做不到。按 Uptime Institute 2025 年的全球调查,全行业加权平均 PUE 是 1.54,连着 6 年没怎么动过。像 Google(2025 年全球机房 1.09)和微软(2025 财年 1.17)这样的大厂,能把额外损耗压到一到两成。
电网卡你脖子的时候,卡的是瞬时功率峰值(MW),跟一天用掉多少电(MWh)关系不大。再看课上另一个算例,假设供电上限死卡在 6.5 MW,平时线上推理加散热已经吃了 4 MW 底噪。这时候塞一个大批量评测任务进来,如果按 4 MW 猛跑 12 小时,叠加上去峰值冲到 8 MW,当场把 6.5 MW 上限干跳闸。反过来,如果让调度器把任务拉长,改用 2 MW 慢跑 24 小时,峰值只有 6 MW,就能塞进 6.5 MW 红线里。两种跑法一天烧掉的总电量全都是 144 MWh(底噪 96 MWh 加任务 48 MWh),把尖峰削平就能跑通。
弄懂这几层关系,就不会犯 Kian 在第二章末尾考人的那个经典错账了。假设有人抄电表,看到大楼总电表走了 12 MWh,IT 电表走了 10 MWh,回来写报告说「机房今天跑出了 22 MW 的有效算力」。这话连踩了三个坑。第一,总电表的 12 MWh 本来就包着 IT 电表的 10 MWh,多出的 2 MWh 是散热配电损耗,两表相加纯属重复记账,唯一能算出来的是 PUE 等于 1.2。第二,MW 是功率,MWh 是能量,量纲都搞混了。第三,那 10 MWh 里还有一部分耗在网络交换、硬盘读写和空转等待上,真正花在 GPU 做矩阵乘法上的电不到 10 MWh。至于干了多少有用的活,两块电表都说不出来。
当总功率锁死之后唯一能卷的就是每瓦特产出
把上面的账合到一块,就能听懂黄仁勋 2026 年 6 月 1 日在台北 Computex 的 GTC 演讲里算的那笔账了。他说一座 1 GW 的 AI 工厂,电网给你的上限就是 1 GW,所以在锁死的电力预算下,每瓦特能跑出多少吞吐量,直接决定了工厂能拿回多少营收。
行业里习惯把这个指标简写成 tokens per watt(每瓦特 token 数)。抠一下物理单位,它准确的写法是「每秒每瓦特产出的 token 数」(tokens/s/W),因为 1 瓦特等于每秒 1 焦耳,算的其实是每焦耳电能换几个 token。拿这个每瓦产出乘以机房拿到的总瓦数,就是全机房每秒吐出多少 token。再乘上单价、算上实际利用率,才是机房实打实的进账。客户要的吐字速度越快,单价往往越贵。
每焦耳能换多少 token,靠软件去抠内存墙和批处理调度。电在路上少浪费一点,就得跟 I²R 发热、UPS 损耗和冷却塔风扇一点点较劲。还有人为了早点拿到电开机,干脆在园区边上自己建燃气电厂。我觉得这多少能解释平时调大模型接口碰到的一些限制。高峰期吐字变慢、新模型刚出来额度紧,有一部分原因可能是机房没法说扩就扩,三根管子里总有一根先顶到头。
这一篇先把三根管子和 GB300 机柜这块标准积木摆在桌面上,接下来七篇顺着管子一根根往下拆。第二篇看软件怎么反过来决定土木工程,聊聊为什么模型的 prefill 和 decode 吃的硬件完全不同,逼着人在浇筑水泥前就得把工作负载算清。第三篇去电网排队现场看看,为什么早一个月抢到电比省一年燃气费划算得多。第四篇顺着电线从 345 kV 高压塔跟到芯片里的 1 V,看看电压越降越低、电流越涨越猛的剪刀差怎么逼出 800 V 直流机柜。第五篇讲电网闪断和训练功率剧烈抖动时,电容、电池和发电机怎么跑赢毫秒级的接力赛。第六篇拆数据管子,看几万张 GPU 怎么用铜缆和光纤连成一台机器。第七篇算散热和水账,把机房费不费水、哪个水循环开着口讲透。最后在第八篇,把所有物理账折算成美元,拆开一张 GPU 每小时租金的底牌,再去德州 Abilene 工地看看一座千兆瓦级 AI 机房是怎么拼出来的。
本系列整理自 freeCodeCamp 上 Kian(@neuralkian)的课程「Inside an AI Factory – Power, Cooling, and GPUs Explained」(课程原名 From Watts to Tokens,讲义在 kiankyars.github.io/gigawatt)。框架和大部分例子是 Kian 的,我按主题重新编排、核对了数字,理解有偏差的地方锅在我。文中提到的公司只是例子,不构成任何投资建议。