
电网一抖,机房靠什么撑过去
上一篇顺着电线走了一遍,看 345 kV 的高压电怎么一步步降成芯片里的 1 V。那条路有一个隐含的前提,就是外面的电网一直稳稳当当地供着电。现实里的电网经常会闪一下,有时候还会彻底断掉。对 AI 数据中心来说,哪怕供电断上一小会儿,正在训练的几万张 GPU 就可能整批掉线,进度得退回上一个检查点重来。
机房为了不掉线,在电网和芯片之间排了一整支接力队。离芯片越近的设备反应越快,手里存的能量越少。离芯片越远的设备存的能量越多,启动起来越慢。真到断电那一下,最容易出事的是两棒交接的地方,或者所有备用电源共用的那根母线。
断电后的毫秒到分钟接力赛
把机房里的备用电源按离芯片从近到远排个队,一共分四棒。第一棒贴在主板上,是电压调节模块(VRM)旁边的电容。它们在微秒级就能放电,存的能量也最少。第二棒装在机柜里,是电源模块(PSU)内部的大电容和机柜电池备份单元(BBU)。它们在毫秒级接手,能撑几秒到几分钟。第三棒放在白区外面的灰区机房,是园区级的不间断电源(UPS)和配套电池柜,能顶上 5 到 10 分钟。第四棒立在院子里,是一排柴油或燃气备用发电机,外加现场大型储能电池系统(BESS)。只要油罐里还有油,发电机就能一直转下去。物理上没有哪种设备能同时做到微秒级响应、又能存够几十个小时的能量,所以只能一层层接力。
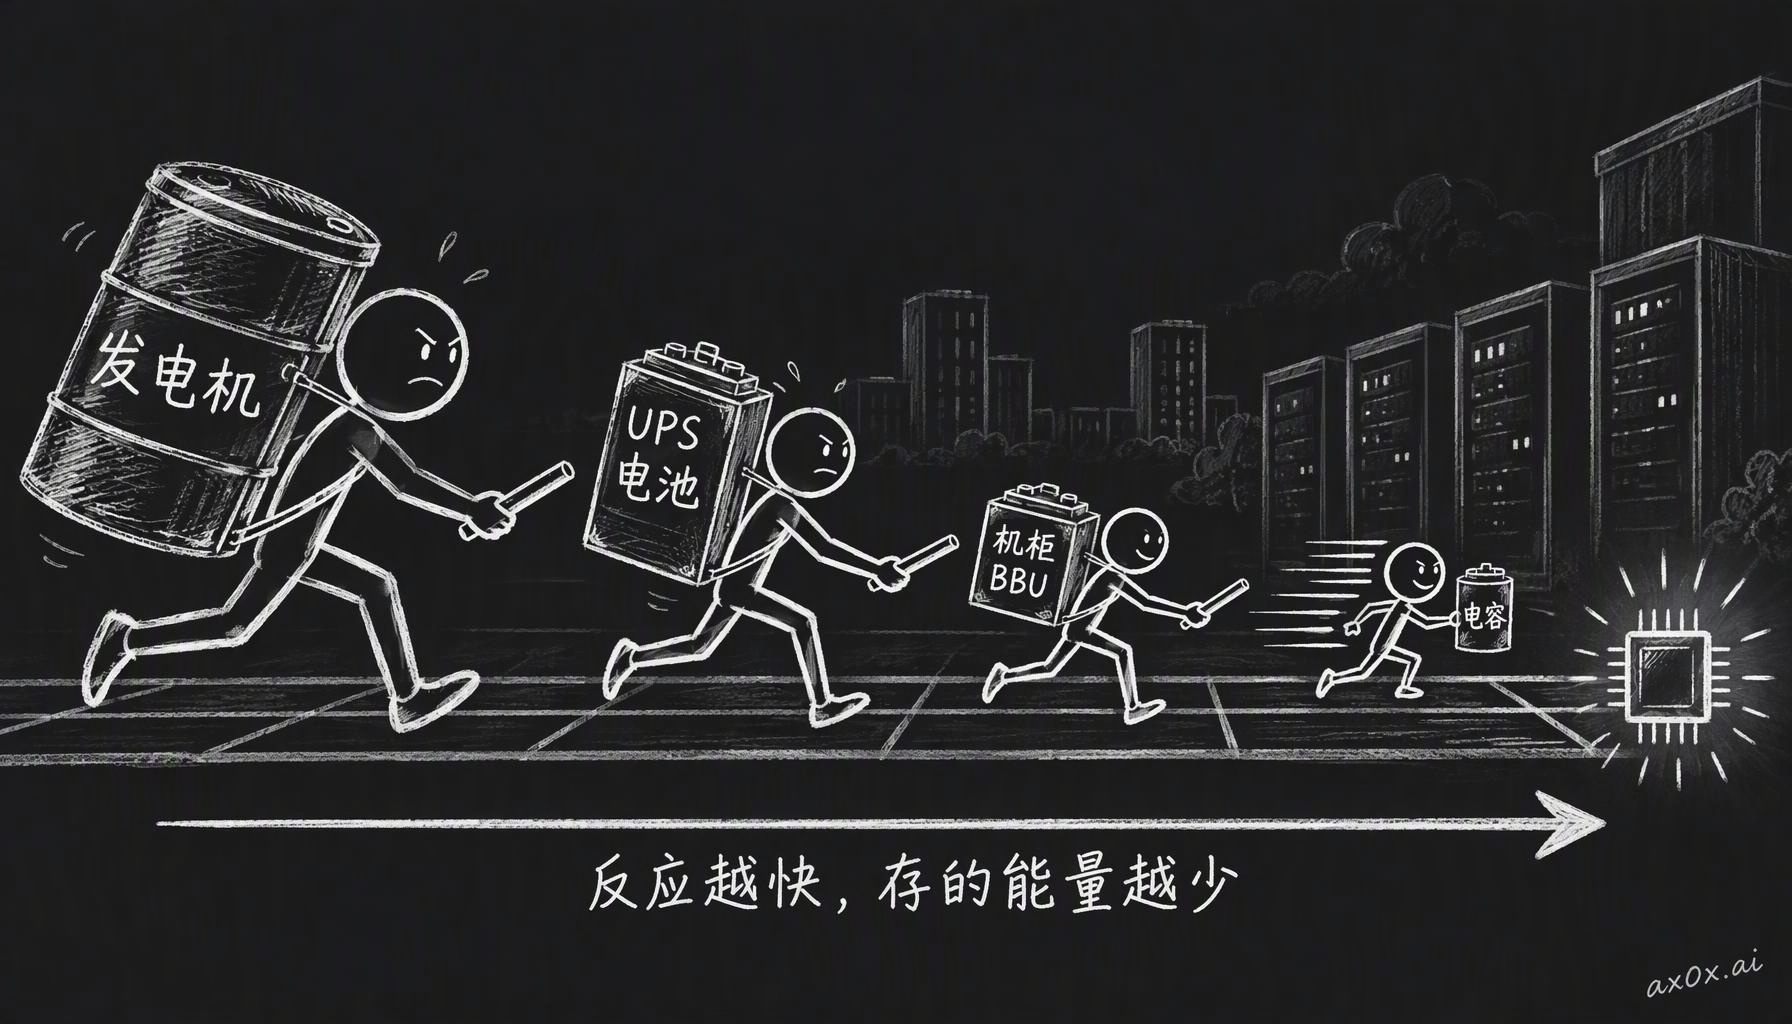 备用电源是一场接力:发电机能撑好几个小时但启动要几秒,UPS 电池能撑几分钟,机柜 BBU 在毫秒级接手,电容反应最快、存的能量也最少
先看灰区里的那台大 UPS。市面上最简单的备用电源叫离线式(offline)或后备式(standby)UPS。平时市电正常,交流电直接绕过电池送给设备。一旦断电,里面的转换开关才切到电池和逆变器那条路上。这个切换动作再快,也会留下几毫秒的断电空档。厂商标称切换时间一般在 2 到 12 毫秒,常见的是 4 到 8 毫秒。Kian 的说法是,家用电脑自己电源里的电容就能顶过这几毫秒,所以用这种 UPS 没问题,数据中心可接受不了这个空档。
大多数数据中心的灰区机房都用在线式双变换(online double-conversion)UPS。外面的交流电进门之后,哪怕电网稳得很,也先过一遍整流器(rectifier)变成直流电,流进中间的直流母线(DC link)。紧接着,直流电再过一遍逆变器(inverter),重新变回交流电送往机房。
上一篇刚算过,每次交直流转换都要掉几个百分点的效率。在线式 UPS 为什么要白白多做一次交流变直流、直流再变交流?答案就在中间那段直流母线上。UPS 的电池组直接挂在这根直流母线上。一旦外面的电网断了,整流器没电过来,直流母线上的电池立刻顺着原来的路径继续往逆变器供电。中间没有任何开关需要拨动,切换时间严格等于 0 毫秒。平时损耗掉的那点转换效率,买来的就是这 0 毫秒的无缝交接。
为了省下平时的损耗,现在很多双变换 UPS 也支持生态模式(eco mode),平时走旁路把效率提到 99% 左右,出事再切回来。不少超大规模云厂商干脆把电池从灰区挪进了机柜,比如 Google 自研的机柜锂电池和开放计算项目(OCP)ORv3 标准的机柜 BBU。微软在亚特兰大的 Fairwater 数据中心走得更远,直接给 GPU 集群砍掉了机房级 UPS,后面细聊。
一台真实的机房级 UPS 长什么样?Kian 在课上拿施耐德电气的 Easy UPS 三相模块化系列(Easy UPS 3-Phase Modular)做例子。打开柜门,里面插着一排 50 kW 的功率模块,模块里是整流器和逆变器,柜里另有静态旁路开关。单台机柜能塞 1 到 5 个模块,做成 50 到 250 kW 的容量。一台 250 kW 的柜子高约 2 米,宽 0.6 米,深 0.85 米。这还只是功率转换柜,存电的电池得另外装在独立的电池柜里,经过电池接口连过来。把 4 台 250 kW 机柜并联,总容量就是 1 MW。只用 750 kW 带负载,空出 1 台 250 kW 做备胎,就算配出了 N+1 架构。
电容只顶得住十几毫秒,后面得靠电池和发电机
把镜头拉近到那根 800 V 的直流母线上,看看断电头十几毫秒里,电容和电池是怎么交接的。电容存电的公式是电荷量等于电容乘以电压($Q = CV$)。Kian 算了一道教学题。假设直流母线上挂着容量 $C = 0.2\text{ F}$ 的大电容,平时电压充到 $V = 800\text{ V}$。里面一共存了 $0.2 \times 800 = 160\text{ C}$ 的电荷。1 库仑大约是 $6.24 \times 10^{18}$ 个电子,160 库仑就是大约 $10^{21}$ 个电子。
算能量的话,电容存的总能量是 $\frac{1}{2}CV^2$,代进去一共是 $64,000\text{ J}$,即 $64\text{ kJ}$。后面拖着 1 MW(每秒吃 $1,000\text{ kJ}$)的负载,64 kJ 听起来能撑 64 毫秒。实际上根本撑不到。电容一放电,电压就会往下掉。后面的逆变器和电源有最低电压门槛,假设掉到 $700\text{ V}$ 就要保护关机。电压掉到 $700\text{ V}$ 时,电容里还剩 $\frac{1}{2} \times 0.2 \times 700^2 = 49\text{ kJ}$。这 $49\text{ kJ}$ 锁在 700 V 底线以下,拿不出来用。能救急的只有 800 V 到 700 V 这段窗口里的能量,一共 $64 - 49 = 15\text{ kJ}$。喂给 1 MW 的负载,最多只能撑 $15\text{ kJ} / 1\text{ MW} = 15\text{ ms}$。
好在电池不用等 15 毫秒才出力。真实交接时,电网一断,电池就开始爬坡。假设电池用 10 毫秒把功率从 0 线性拉到 1 MW。这 10 毫秒里负载一共要吃 $10\text{ kJ}$。电池在线性爬坡中出了一半力,提供三角形面积那 $5\text{ kJ}$。剩下的 $5\text{ kJ}$ 缺口由电容补上。电容只掏了 $5\text{ kJ}$,还剩 $64 - 5 = 59\text{ kJ}$。这时候母线电压还有约 768 V。到第 10 毫秒,电池满功率顶上 1 MW,电压稳稳停在 768 V,离 700 V 红线还有很大余量。
等电源恢复,还得把电容亏掉的 $5\text{ kJ}$ 补回去。如果上游电源只出 1 MW,全被负载吃光,电容永远充不回去。假如上游能出 1.05 MW,多出 50 kW 拿去充电容,补齐 $5\text{ kJ}$ 要 $100\text{ ms}$。
电容把头 10 毫秒顶过去了,接下来 UPS 电池要一直撑到院子里的柴油发电机接棒。很多人以为大柴油发电机启动得热车好几分钟。其实美国消防协会有个规范(NFPA 110 Type 10),要求应急发电机从断电算起,大约 10 秒内就得启动,把电送上母线。只有多台大机组需要并联同步合闸时,才会多花几十秒。既然发电机 10 秒左右就能顶上,UPS 电池为什么还要按 5 到 10 分钟来配?Intel 的机房是按满载撑 5 分钟设计的,Cloudflare 用的那座波特兰机房配了约 10 分钟。这 5 到 10 分钟是留给意外的,防的是发电机第一把没打着火。
算电池容量时,铭牌数字还得打两次折。Kian 的算例是这样的。一套标称 1 MWh 的电池,假设为了保寿命只用 80% 的电(留 20% 底子),转换时再掉 5%,真正能送到手里的电只有 $1 \times 0.8 \times 0.95 = 0.76\text{ MWh}$。拿去带 6 MW 的负载,能撑 $0.76 / 6\text{ 小时} = 7.6\text{ 分钟}$。这里有个新手容易踩的坑。电池既要看存了多少电(MWh),也要看同一时刻最多能往外送多大功率(MW)。上面那套电池如果最大输出功率是 8 MW,带 6 MW 负载毫无压力。可要是最大输出功率只有 4 MW,哪怕肚子里电再多,面对 6 MW 负载也会留下 2 MW 缺口,机房当场跳闸。
如果把电池放大几十倍配上光伏,电池还能当主力电源用。Redwood Materials 在内华达州斯帕克斯(Sparks)的园区就建了这么一套微电网,2025 年 6 月投运。他们用 12 MW 太阳能板配 63 MWh 的退役电动车旧电池,给园区里 Crusoe 的模块化数据中心供电。初期负载约 1 MW。完全没太阳的话,63 MWh 按铭牌算能撑 63 小时,扣掉前面那两层折扣,实际能撑约 48 小时,差不多两天两夜。单靠微电网就能跑到 99.2% 的可用性,把外部电网当备用接进来后,可用性就提到了 99.9%(三个九)。
UPS 机柜里还有两条又救命又危险的通道。如果整流器或逆变器坏了,UPS 会触发静态旁路(static bypass),让市电绕过坏模块直接进机房。上门维修时则会合上维修旁路(maintenance bypass),把整台 UPS 物理隔离出来。一旦进了旁路模式,直流母线上的电池就被挡在外面了。如果逆变器坏了,UPS 正在走旁路,偏巧市电这时候又断了。电池的电得穿过那台坏掉的逆变器才送得出去,根本过不去。机房只能硬停电,一直等到发电机启动接上,差不多 10 秒。
修 UPS 还要防备直流电弧。拉掉外面的交流开关,机器里面照样带电,必须先断开电池、放空电容。而且 60 Hz 交流电每秒穿过零点 120 次(50 Hz 是 100 次),过零时电弧容易自己熄灭。直流电永远不跨过零点,一旦拉出电弧就会一直烧成高温等离子体。所以直流断路器必须专门做灭弧栅、磁吹装置和更大的开距,把电弧硬拉断。
训练功率锯齿与机柜里的缓冲垫
前面讲的是电网断了机房怎么顶。在 AI 训练机房里,还有个反过来的麻烦,几万张 GPU 会齐刷刷地往外拽电网。
第二篇提过一句,这里细说。大模型同步训练时,每个训练步(step)所有 GPU 先一起做前向和反向传播,这时候功耗全顶在热设计功耗(TDP,也就是散热系统设计能扛住的最高功率)附近。算完反向传播,所有卡必须停下计算,走一遍全归约(all-reduce)集合通信,把各自算出的梯度(gradients)汇总平均,再更新权重。通信这段时间里,计算单元闲下来,功耗哗啦一下掉到接近待机。通信一结束,几万张卡又几乎同时踩下油门,功耗冲回波峰。
这种全集群同起同落,画在监控图上就是一排深锯齿。2025 年 8 月,微软、OpenAI 和英伟达联合发了一篇讲训练功率稳定的论文(Power Stabilization for AI Training Datacenters,arXiv 2508.14318)。里面贴了一段 DGX H100 机柜跑真实训练的实测功率曲线,200 秒(约 3.3 分钟)里功率反复大起大落。Meta 在 2024 年的 Llama 3 论文里也记了同样的事。他们那座集群有约 2.4 万张 H100。几万张卡一起停下来的时候,不管是存检查点(checkpointing)、做集合通信,还是一起启停任务,整个数据中心的功率都会一下子上下摆几十兆瓦,快顶到电网能扛的极限。集群到了上百兆瓦,这种几十上百兆瓦的来回抽动,要是频率碰巧对上,可能会让电网里汽轮发电机组的转轴共振,或者让输电线路跟着振荡。
Kian 在课上用一组简化数字算过这种齐步走的账。假设一组机柜跑 60 秒周期的训练循环。前 30 秒计算,功率 120 kW。接着 15 秒交换梯度,掉到 40 kW。最后 15 秒存权重,功率 60 kW。60 秒平均功率是 85 kW。如果 4 组机柜跑同一个同步任务,步子完全一致,一起计算的那 30 秒里总功率会冲到 $120 \times 4 = 480\text{ kW}$。可平均下来只有 $85 \times 4 = 340\text{ kW}$。供电系统为了扛峰值,不得不按 480 kW 去配变压器。假如这 4 组机柜跑的是 4 个独立任务,把起跑时间依次错开 15 秒,任何时刻都刚好有 2 组计算($240\text{ kW}$)、1 组通信($40\text{ kW}$)、1 组存权重($60\text{ kW}$)。总功率变成一条 340 kW 的水平线,峰值凭空削掉 140 kW。Kian 紧接着补了一句,真实大模型训练里几万张卡跑的是同一个任务,算法决定了必须齐步走,没法靠错峰取巧。
拆不开同步任务,就得软硬兼施。微软、OpenAI 和英伟达在论文里验证了三条路。一是在通信低谷塞次要填充负载(Kian 也提过把推理和训练混布来削峰填谷)。二是在 GPU 固件里设最低功耗地板(power floor)和功率爬坡斜率限制(ramp-rate limits)。三是在机柜和园区里塞储能缓冲。不管走哪条路,设计供电系统都得拿真实任务测出来的功率曲线(power trace)去算账,光看平均功率不够。
机柜里的缓冲垫怎么干活?看单个机柜那 0.2 秒的交接账就明白了。假设机柜从通信切回计算,负载瞬间猛跳 $40\text{ kW}$。机柜电源模块(PSU)需要 0.2 秒才能线性爬坡加上这 $40\text{ kW}$。这 0.2 秒的三角形缺口里,少供的能量是 $\frac{1}{2} \times 40\text{ kW} \times 0.2\text{ s} = 4\text{ kJ}$。这 $4\text{ kJ}$ 的窟窿就由机柜 BBU 或超级电容顶上。按 OCP ORv3 规范,母线电压下掉时,BBU 必须在约 2 毫秒内接管母线,并能以 3 kW 功率供电 4 分钟。像台达(Delta)做的 ORv3 标准 BBU 模块,输出 48 V 直流、功率 3 kW,直接插进普通电源槽位。6 个槽位插满是 18 kW,按 N+1 留 1 个备份还有 15 kW 可用。不过这里要算两本账,4 kJ 的能量它存得下,可跳变那一瞬间缺的是 40 kW 的功率,15 kW 的电源框单靠自己顶不住。能量够了,功率也得够。
锯齿另一头更麻烦。GPU 停下来通信时,机柜负载瞬间猛砸 $40\text{ kW}$,PSU 同样要 0.2 秒才能收住手。多出来的这 $4\text{ kJ}$ 全涌到机柜里那根约 50 V 的直流母线上,没有电容或 BBU 吃进去,母线电压就会往上冲。而且电池放电快、充电慢。一台 ORv3 BBU 放电能到 3 kW,充电往往只有 250 W 左右。如果锯齿太密,电池来不及回血就会被榨干。英伟达在 2025 年年中推出的 GB300 NVL72 机柜里,干脆在 PSU 里塞了占一半体积的电解电容。算下来每张 GPU 摊到约 65 焦耳,整柜 72 张卡加起来约 $4.7\text{ kJ}$,跟前面算的那个 $4\text{ kJ}$ 缺口差不多大。再加上固件里的爬坡限制,和负载突然掉下来时故意让 GPU 空转耗电的功率燃烧器(power burner)。英伟达自己拿一次训练任务测过,GB300 对电网的峰值用电比 GB200 最多低 30%。
N+1 与 2N 冗余,单母线陷阱与微软的减法
有了储能设备,还要防备设备坏掉或停机保养。拿 50 kW 的 UPS 模块来算一笔 100 kW 机房负载的账,就能看懂 N、N+1、2N 和 2N+1。
最省钱的叫 N,买 2 个 50 kW 模块,正好顶住 100 kW,平时 100% 满载。坏 1 个,或者停 1 个做保养,机房就掉电。买 3 个 50 kW 模块(装机 150 kW)叫 N+1。它只能应付坏 1 个模块,或者保养 1 个模块,不能同时干。保养第 3 个模块时,剩下 2 个就退化成了裸奔的 N。买 4 个模块(装机 200 kW)并排挂一起叫 N+2,停 1 个保养还能再坏 1 个。
很多人看 N+2 用了 4 个模块,就以为它跟 2N 一样。其实只有在 N 刚好等于 2 的巧合下,两者的模块数才碰巧都是 4 个。要命的区别在于,N+1 和 N+2 往往把所有模块都接在同一根共享母线(shared output bus)上。这就是单母线陷阱。前面备胎再多,只要那根共享母线短路或者总开关跳闸,整间机房瞬间全黑。
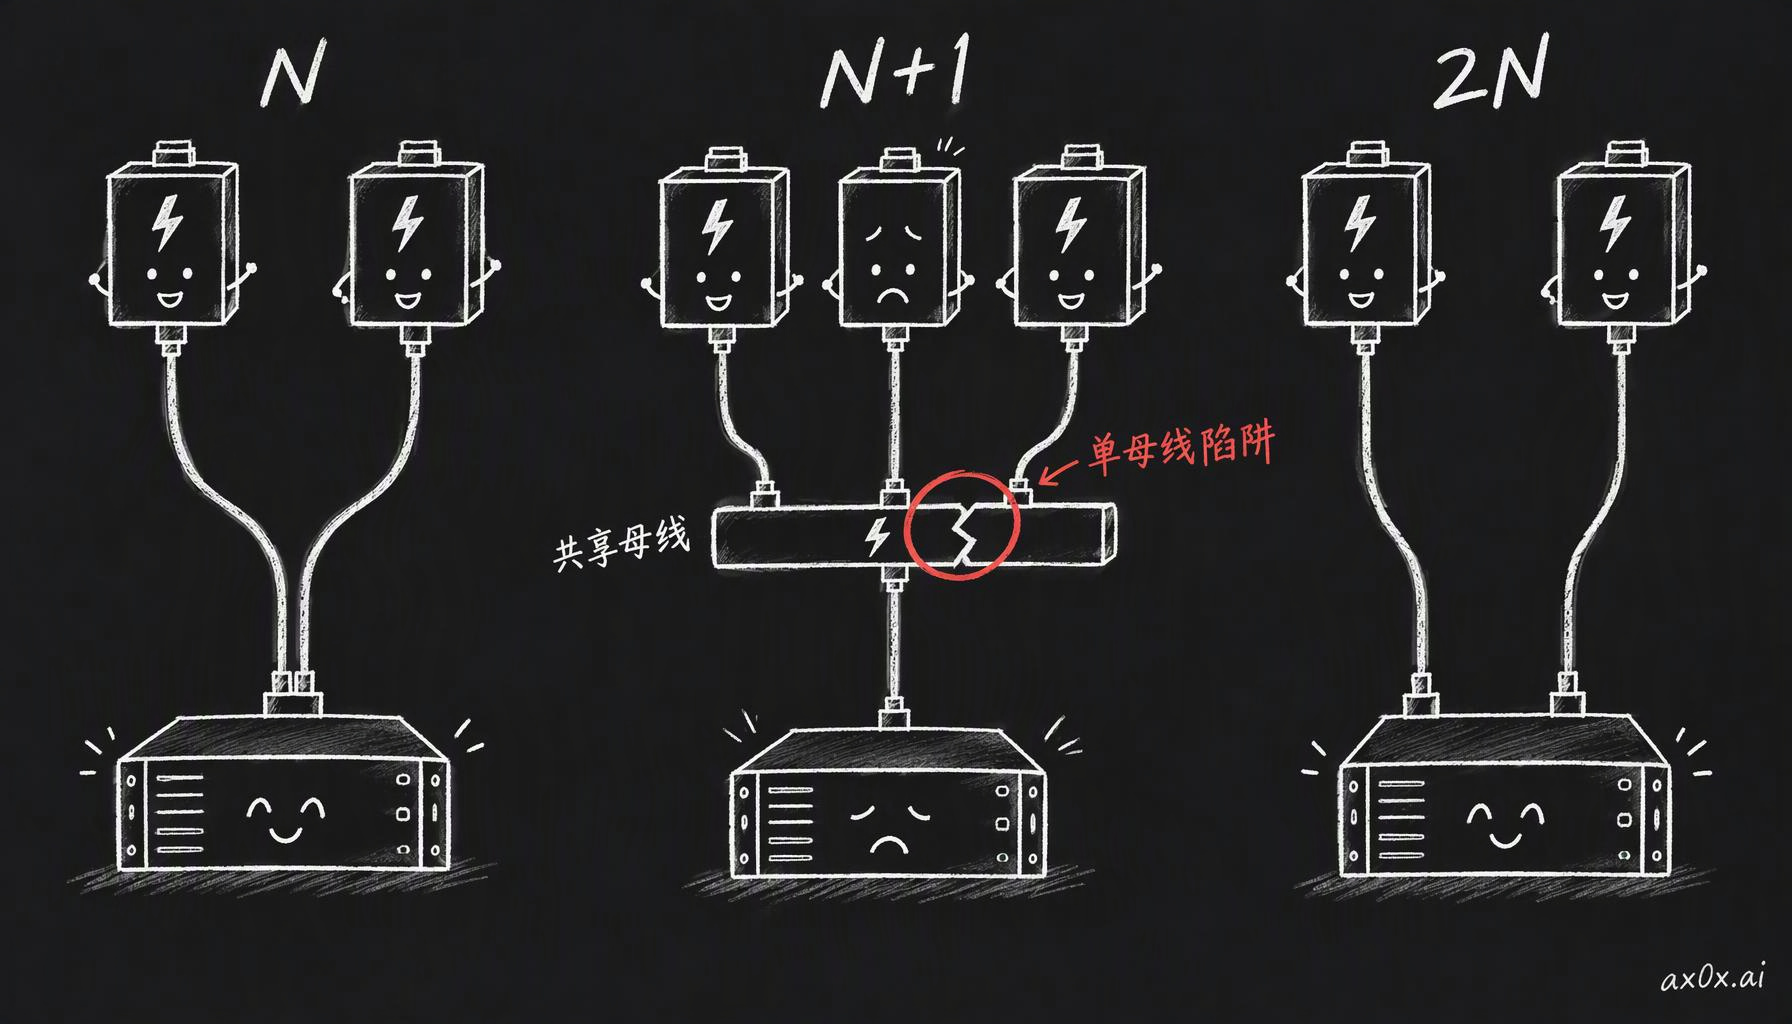 N、N+1、2N 数的是备用模块有几个,可要是所有模块都接在同一根共享母线上,备胎再多,这根母线一出事整间机房照样全黑
要躲开单母线陷阱,得上 2N。也就是从头到尾建 A、B 两套物理隔离的供电链路,各有自己的 100 kW UPS、配电柜和母线。服务器插双电源线,平时两路各出 50 kW。哪怕整条 A 路炸了,B 路瞬间接过全部 100 kW。在 2N 基础上给 A、B 两路各加 1 个 50 kW 备胎(每路 150 kW),就叫 2N+1。Kian 说 2N+1 基本就是现实工程里冗余设计的天花板了。
算得再好的冗余,日常运维里也常被三种失误废掉。第一是负载长胖吃掉冗余。原本 100 kW 负载配 3 个 50 kW 模块,是 N+1。后来换了新 GPU,负载涨到 150 kW,监控上还是一片绿,其实已经变成没有备胎的 N,坏 1 个模块就全跳闸。第二是开关越级跳闸(breaker coordination 失败)。A、B 两个大厅共用上游一个总断路器。A 厅短路时,A 厅门口的支路断路器本该跳开却没跳,故障电流就往上冲,把总断路器顶跳了,好端端的 B 厅也跟着断电。第三是忘了给控制电脑接 UPS。机柜接了 UPS 和发电机,水泵和冷机也接了发电机,偏偏管冷却阀门的控制电脑插在普通市电插座上。电网一闪,控制电脑关机,冷水断流,GPU 照样高温停机。
衡量机房有多抗造,行业里有两把尺子,等级(Tiers)和几个九(Nines)。Uptime Institute 定的 Tier I 到 Tier IV,看的是供电和制冷的线路怎么搭。Tier I 是单路供电。Tier II 加了冗余组件。Tier III 叫可并行维护(concurrently maintainable),计划内保养不用停机。Tier IV 叫容错(fault tolerant),随便炸掉一路设备业务也无感。这四个等级里,Uptime 都把现场的发电机组当成最靠得住的电源。2017 年哈维飓风淹了休斯顿,Equinix 在休斯顿的机房整场风暴里一直没停。
几个九看的是一年 8,760 小时里实际能用的时间占多少,或者合同里承诺了多少。99.9%(三个九)一年允许停机约 8 小时 46 分钟(8.76 小时)。99.99%(四个九)一年约 52.6 分钟。托管供电合同常见的 99.999%(五个九),一年只允许断电约 5.26 分钟。Tier 说的是图纸怎么画,几个九算的是一年实际停了多久。图纸画成 Tier IV,运维拉错一个闸照样会停电,停的这几分钟全记在几个九的账上。
反过来,如果外部电网极结实,机房里还能做减法。微软云与 AI 负责人 Scott Guthrie 在 2025 年 11 月 12 日的博客里透露,微软亚特兰大 Fairwater 数据中心给 GPU 集群砍掉了现场发电机、砍掉了机房级 UPS,连机柜双路供电也省了。微软给的理由是,亚特兰大这块地拿到了非常可靠的电网供电。按微软的说法,这样用三个九的成本,就能拿到四个九的可用性。
真实世界的打脸现场,Cloudflare 与 Meta 的教训
图纸画得再美,真断起电来照样处处是坑。2023 年底 Cloudflare 在俄勒冈州波特兰那次大断网,就是一连串的翻车。当时 Cloudflare 的控制平面(管配置、控制台和 API)在波特兰租了 3 个不同机房做高可用。2023 年 11 月 2 日,Flexential 在波特兰的那座核心机房因为一次接地故障断了市电。按剧本,UPS 电池能顶 10 分钟,院子里的 10 台发电机 10 秒左右就该启动接管。
结果同一次接地故障把 10 台发电机全弄跳闸了,得有人到现场一台台手动重启。本该撑 10 分钟的 UPS 电池,只撑了约 4 分钟就开始掉线。按 Cloudflare 事后报告的说法,机房的门禁系统没接备用电池,跟着停了,当晚值夜班的也只有保安和一个才入职一周的技术员。更要命的是,服务器虽然分在 3 个机房,最底层的数据库(ClickHouse)和消息队列(Kafka)只放在断电的这一个机房里。另外 2 个机房没断电,可连不上库,也跟着瘫了。团队当天就在灾备机房把控制平面的大部分功能拉了起来,可整场事故前后拖了约 40 小时才彻底收尾。事后 Cloudflare 搞了一轮叫 Code Orange 的整改,把只放在一个机房的依赖挨个拆掉,还专门演练了整座机房断电。四个多月后,2024 年 3 月 26 日,同一座波特兰机房又断电了。按 Cloudflare 的说法,这回是给 Flexential 所有机笼供电的 4 台配电盘同时出了故障。这回不用人插手,API 和控制台 7 分钟内就恢复了。
大模型训练集群也一样老出事。Meta 在 Llama 3 论文里公开过一组数。Llama 3 405B 在 16,384 张 H100 上预训练,Meta 截了其中 54 天来统计,任务一共中断了 466 次。计划内维护 47 次,意外崩溃 419 次,平均每 3 小时就断一次(约 78% 是 GPU 和显存等硬件故障)。就这么每 3 小时摔一跤,Meta 的有效训练时间还是保在 90% 以上,54 天里只有 3 次故障要人动手大修。平时升级维护,Meta 用一套叫维护列车(maintenance trains)的轮换办法,每次只停一块区域检修。停得太勤,任务老被打断;一次停太多,又有大片算力闲着,Meta 就在这两头之间挑一个合适的大小。
把这一路串起来看,再碰到云服务闪断、长任务报错,我觉得心态会平和不少。再看到哪家云服务挂了半天控制台,我觉得多半是某个没人想到的地方漏了底,就像当年 Cloudflare 把数据库只放在一个机房里。你自己租卡跑训练,隔半天就碰上节点掉线重跑,我觉得也不用怀疑人生。Meta 那 1.6 万张卡的集群也是平均每 3 小时断一次,有效训练时间照样保在了 90% 以上。电保住了,几万张卡之间怎么互相传梯度,就是下一篇要讲的事。
本系列整理自 freeCodeCamp 上 Kian(@neuralkian)的课程「Inside an AI Factory – Power, Cooling, and GPUs Explained」(课程原名 From Watts to Tokens,讲义在 kiankyars.github.io/gigawatt)。框架和大部分例子是 Kian 的,我按主题重新编排、核对了数字,理解有偏差的地方锅在我。文中提到的公司只是例子,不构成任何投资建议。