
电压降到 1 V,麻烦全在最后一寸
电从发电厂送进 AI 机房,到最后喂进 GPU 芯片,中间一直在做一件看似拧巴的事。电压被一路往下砍。它从高压输电线的 345 kV,一直砍到芯片核心的大约 1 V。按最简化的算术来看,电压足足降了 345,000 倍。
第一篇提过那条最基础的初中物理公式。功率等于电压乘电流,电线发热等于电流的平方乘电阻。送同样多的功率,电压往下砍多少倍,电流就得往上翻多少倍。
机房配电里几乎所有让人头疼的烂摊子,全都卡在这道电压往下掉、电流往上蹿的剪刀差里。现在英伟达、Google、微软这几家正带着一大批厂商推 800 V 直流进机柜。这其实就是把电网用了上百年的高电压、低电流老办法,搬进了机房和机柜里面。
从 345 kV 到 480 V 为什么要贴着机房才降压
咱们顺着电线,从园区大门口往里走。拿德州 Abilene 那座 Stargate 园区来说,电气承包商 Mortenson 公开过他们的施工数据。一期建的是 200 MW、138 kV 的变电站。到了二期,电网直接拉进了 345 kV 的高压交流电。
二期这座 1 GW 的新建变电站一共装了五台主变压器。第一台主变压器在 2025 年底通电,整座变电站在 2026 年初全部投运。整个园区规划的总容量大约是 1.2 GW。
高压电进站之后怎么往下走?按照美国大型园区的标准做法(也是 Kian 讲义里的路线),变电站会先按十比一的比例降压。它把 345 kV 降到 34.5 kV 的中压。Abilene 具体用的是不是 34.5 kV 和 480 V,没有公开资料,下面说的是美国大园区常见的走法。
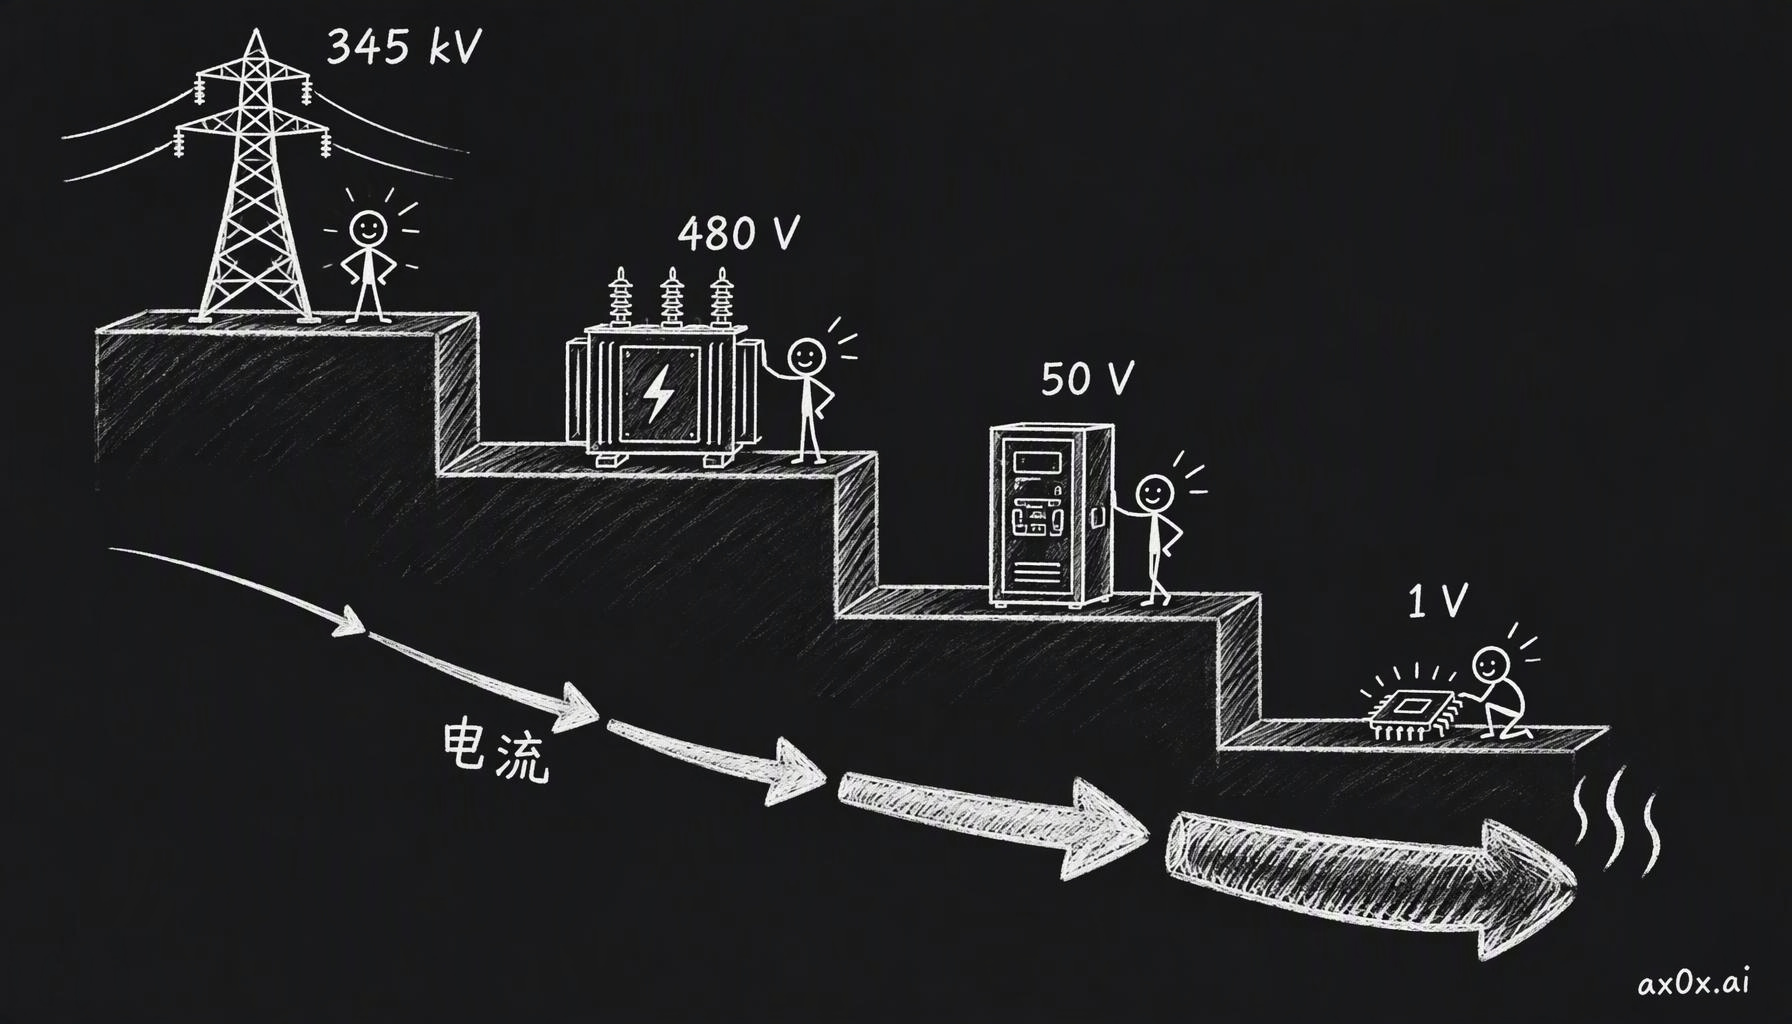 电压的台阶:电从 345 kV 进来,到芯片上只剩大约 1 V;每往下降一级,电流就涨一截,电线发热跟着电流的平方涨
电先顶着这个中压,顺着园区电缆分给每一栋机房大楼。到了每栋大楼跟前,楼边的变压器再把中压降成 480 V 的三相低压交流电,同时喂给里面的机柜和冷却水泵。
为什么要等到贴着机房大楼的墙根了,才肯把电压降到低压?算一笔电流账就明白了。在 480 V 三相电底下,光送 2 MW 的功率,电线上就得流过大约 2,400 A 的电流。
要是你在园区大门口一进门就降成低压,这股两千多安培的大电流就得在园区里跑几百米。那得铺多粗的铜缆?一路上又要白白烧掉多少热量?所以园区内部必须死守中压,把低压大电流的路程压缩到最短。
变压器自己不会稳压,它只是个按固定比例做除法的铁疙瘩。拿课上的算例说,初级线圈绕 80 圈、次级绕 20 圈,变比就是四比一。输入 480 V,输出就是 120 V。
要是外面的电网电压往上飘到了 504 V,输出也会跟着飘到 126 V。这时候电工就得去调干式或油浸式变压器上的分接开关(tap)。每档通常微调 2.5% 左右。把输入端改接到 84 圈的抽头上,输出就能稳回 120 V。
这一路上管分流和保护的铁柜子,叫中压开关柜(MV switchgear)。它里面装着低压控制室、中压母排、真空断路器、保护继电器和电流电压互感器。一旦互感器测出哪条支路短路过流,或者遭了雷击过压,继电器就会立刻下令让断路器跳开。这样才能保住下游昂贵的变压器、UPS 和机柜。
防雷用的氧化锌避雷器(surge arrester)平时电阻极大,遇到雷击高压瞬间变成良导体,把过压泄进大地。它必须紧贴着变压器安装,防止雷电打在避雷器和变压器之间。电工检修设备的时候,还得拉开物理隔离开关(disconnect),留出肉眼可见的空气间隙才算安全。
平时分期建设机房的时候,后面几期大厅的馈线(feeder)也会提前在开关柜里接好。只是先把断路器断开不带电,等新楼盖好一合闸就能跑。但是分级保护也有失灵的时候。要是 A 大厅的支路发生短路,管 A 大厅的断路器偏偏机械卡死没跳开,故障电流就会顺着共享母线一路往上顶。最后上一级的后备断路器只好跳闸。B 大厅明明好好的,因为挂在同一条母线上,也跟着一起断电。
除了电本身,现在建机房最卡脖子的环节之一,就是买不到这些变压器和开关柜。大型高压变压器的交货周期动不动就要 2 到 4 年,中压开关柜也得等上 1 年以上。为了不干等着排队,有些开发商干脆自己下场开厂造。
比如建 Abilene 园区的 Crusoe,直接在俄克拉荷马州的 Tulsa 开了工厂。他们自己造中压开关柜、低压配电盘和铜母排。第二座 Tulsa 工厂 2026 年 9 月中旬刚投产。按 Crusoe 自己的说法,行业里要等好几个月的配电设备,他们几天就能出货,光往 Abilene 工地就发了 2,500 多台配电盘。
另一家开发商 Compass Datacenters 走了预制化的路子。他们在 2024 年底和西门子签了五年最多 1,500 套的合同。双方把中压气体绝缘开关柜和变压器直接在工厂里集成到同一个预制撬块(skid)上,拉到工地插上就能跑。
三相电和母线槽里藏着哪些暗坑
电降到低压进了机房大厅,配电盘会分出三条支路。一条喂 IT 机柜,一条喂冷却系统,一条管照明和楼宇控制。工程师画的单线图上看着只有一根线,剥开看其实是五根物理导体。里面有三根相位互差 120 度的火线、一根零线(neutral),还有一根保命用的保护地线(protective earth)。
机柜的金属外壳必须死死接在保护地线上。万一哪根火线绝缘层磨破了皮碰着机柜外壳,故障大电流才能顺着这根低阻抗地线冲回去,顶跳断路器。要是不接地,整个铁柜子就会一直带电,谁碰谁触电。
这里有个初学者常犯迷糊的数字。为什么系统叫 480 V,可机柜里每个单相电源模块(PSU)看到的却是 277 V?因为交流电的电压时刻在按正弦波变化。两根火线之间的相位差了 120 度,算相量差的时候得乘一个根号三。
任意一根火线对零线的相电压是 277 V,乘以根号三正好等于两根火线之间的线电压 480 V。它根本不能按直流电那样直接翻倍算成 960 V。
机房里坚持用三相电喂机柜,是为了让总功率稳如泰山。单根交流电每秒钟要过零点上百次,过零那一下功率掉到零。把三根错开 120 度的火线凑到一块,只要三相负载是平衡的,这一相往下掉的时候另外两相正好往上顶。合在一起的瞬时总功率在任何时刻都是一条平直的线。所以在机柜的电源架里,每个架子插六个单相 PSU,正好每根火线分两个,把三相负载分得平平整整。
要是电工接线时没分匀,麻烦马上就来。拿课上的算例说,假设机柜配电单元(rack PDU)每相的电流上限是 60 A。手头有几个各吃 20 A 的 PSU 组。要是图省事把四组全挂在第一相上,这一相的电流就冲到了 80 A,当场过载跳闸。而另外两相才流着 20 A 在闲逛。明明总供电容量绰绰有余,偏相照样会把机柜干趴下。
从大厅的落地配电柜(floor PDU)往机柜送电,现在很多新机房不再把电缆铺在架空地板底下。大家改在机柜头顶挂一排排铜母线槽(overhead busway)。地板底下的空间可以留给冷却水管。头顶的母线槽每隔一段留几个插接箱(tap-off box),插上电线就能往下给机柜的 rack PDU 喂电,还能在每个插接箱上单独计量。但这里藏着一个容量陷阱。母线槽上的插口全插满的话,加起来的电流往往超过它源头(end feed)能扛的上限。
Kian 算过一笔母线槽的电流账。假设一条母线槽源头的供电上限是 250 A。下面挂的是 415 V、每台约 40 kW 的机柜,算下来每台机柜要吃大约 55.6 A 的电流。
你挂上四台机柜,总电流大约是 222.6 A,母线槽跑得稳稳当当。这时候你看到母线槽上还空着插口,顺手接上第五台机柜,总电流立马冲到约 278.3 A。比源头上限多出约 28 A,整条母线槽过载跳闸,挂在上面的 5 台机柜一起断电。
交流配电里还有一笔糊涂账叫功率因数(power factor)。机房里有变压器、风扇水泵电机这些带线圈的感性设备,还有各种电容。一部分能量会在磁场和电场里来回晃荡,顺着电线倒腾却不干实际的计算活。这股来回晃的能量叫无功功率(reactive power),它就像倒啤酒时浮在杯子顶上的那层泡沫。
Kian 在课上也用了啤酒泡沫这个比方,但泡沫的比例别按字面去算。有功和无功是直角三角形的两条直角边,视在功率是斜边,三个数不是简单相加的关系。泡沫也不是被浪费掉的电,它的麻烦在于逼着电线多扛电流。
功率因数掉下来,不会直接把电凭空蒸发掉。但它会逼着电线和变压器多扛电流,变相拉高电线上的发热。再看课上的一个算例,假设机房有 900 kW 的实际有功负载,接在 480 V、额定容量 1,000 kVA 的变压器上。如果功率因数是完美的 1,电流大约是 1,083 A,变压器只用了九成容量。
如果功率因数掉到 0.9,视在功率刚好顶满 1,000 kVA 的上限。要是功率因数再掉到 0.8,同样的负载就会索取约 1,353 A 的电流。
这时候视在功率冲到 1,125 kVA,直接把变压器干超载 12.5%。而一旦把配电改成直流,因为没有交变频率,直流侧就彻底没有功率因数这个烦恼了。当然前端把交流转成直流的整流器,还是得处理电网侧的功率因数和谐波。
机柜功率一路疯涨把最后几厘米逼到了极限
交流电进了机柜,电源架里的 PSU 把它转成大约 50 V 直流。到这一步,硬骨头才刚开始。因为这几年单个机柜吞掉的功率,涨得实在太离谱了。
Uptime Institute 2026 年的调查里,将近七成的运营商说,自家典型机柜的功率不到 10 kW。全行业平均也就 5 到 8 kW,很少有超过 15 到 20 kW 的。
Kian 聊起过一位老派超算教授的说法。放在几年前,行业里觉得单机柜 60 kW 就是散热和供电的极限上限了。可现在一台 AI 机柜,功耗早就是这个数的两倍多。
按联想公布的 GB300 NVL72 技术规格,整柜装了 18 个计算托盘加 9 个 NVLink 交换托盘。柜子里一共塞进 72 张 GPU 和 36 颗 Grace CPU。
这么一个柜子,典型热设计功耗(TDP)大约是 135 kW,高负载峰值能冲到大约 155 kW。为了兜住这个功耗,冗余配置下整柜塞了 8 个 33 kW 的电源架。
这 8 个电源架里一共插了 48 个 5.5 kW 的热插拔 PSU。整柜总装机供电能力高达 264 kW,差不多是典型功耗的两倍。
对比一下,开放计算标准(ORv3)里常见的 Advanced Energy 单相 PSU 一个才 3 kW,6 个凑成一个 18 kW 的电源架。GB300 一个 PSU 就有 5.5 kW,一个电源架 33 kW,差不多是它的两倍。
往后看更是吓人。英伟达最早按每颗 GPU 封装两颗计算裸片算,把下一代机柜叫过 Vera Rubin NVL144,后来又统一改回按封装颗数叫 NVL72。按供应链传出的估算,这一代机柜的功耗大概率要涨到约 190 到 230 kW。
再往后的 Rubin Ultra,也就是黄仁勋在 GTC 2025 上预告的 Kyber NVL576 机柜,单柜功耗直接奔着约 600 kW 去了。官方目标是在 2027 年下半年推出。
SemiAnalysis 在 2026 年 7 月初报道说,因为中背板 PCB 制造难度太高,Kyber 可能要推迟到 2028 年。但英伟达公开否认了延期,坚称路线图完好无损。
至于 2029 到 2030 年前后的 Feynman 时代,据媒体转述的一份美国银行(Bank of America)研报,单机柜功率会突破 1.5 MW。研报拿 10 到 15 kW 的 CPU 机柜来比,算下来差不多一百倍。到了那个量级,现在的单宽标准机柜大概率是塞不下了。
那时候的机柜,多半得像 AMD 装 72 张 MI450 或 MI455X 的 Helios 机柜那样。Helios 已经是按 Meta 的 Open Rack Wide 标准做的双倍宽(double-wide)大柜子。
功率这么猛,机柜里面每一级电压转换还要扒一层皮。Kian 在课上倒推过一笔机柜供电账。假设一个机柜里的处理器干活要吃 72 kW 的电。主板上的电压调节模块(VRM)转换效率按 92% 算,喂给 VRM 的电就得有 78.26 kW。
再加上内存、网卡、风扇这些辅助部件吃掉的 12 kW,机柜直流母排上就得提供 90.26 kW。最后电源架里的 PSU 把交流转成直流还要扣掉一层损耗,按 97% 效率算,机柜大门口实际得从机房吸走 93.05 kW 的交流电。芯片只要 72 kW,机柜门口就得喂 93 kW。多出来的 21 kW 里,12 kW 是内存、网卡、风扇要吃的,剩下约 9 kW 是 VRM 和 PSU 两道转换白白烧掉的。
为什么到了主板上,VRM 这一步转换会这么费劲?因为芯片里面的晶体管太娇贵,只能吃 1 V 左右的超低电压。当电压被压到 1 V 的时候,电流就变成了怪兽。
咱们算一下最后一寸的物理账。一颗吃 1 kW 功率的芯片,在 1 V 电压下,流进芯片的电流高达 1,000 A。假设从 VRM 到芯片核心这一小段铜箔走线的电阻只有区区 100 µΩ,这股大电流乘上去,光走线上的电压降就有 0.1 V。
为了保证芯片到手是 1.0 V,VRM 就得硬着头皮输出 1.1 V。而这短短一寸走线上白白烧掉的发热高达 100 W,整整吃掉了芯片一成的功耗。只有把走线电阻再砍十倍压到 10 µΩ,压降才能缩到 0.01 V,走线发热降到 10 W。
这笔账直接决定了主板上所有零件的排座次。为了把电阻压到微欧级,VRM 必须死死贴着 GPU 摆,把低压大电流走过的路程缩到最短。从机柜背后约 50 V 的铜母排进到计算托盘,一般有两种降压走法。第一种是直接把 51 V 一步降到 1 V,送 1 kW 功率在主板上只要流过约 20 A 电流。
第二种是分两步走。比如 Meta 在 2025 年 9 月公开的 Clemente 计算托盘 OCP 规范里,托盘从机柜母排取电,允许输入范围在 46 到 52 V 之间。
它先在电源板上把 48 V 降成 12 V 的中间母线,送 1 kW 功率对应约 83 A 电流。等电走到 GPU 跟前,再由 VRM 降到约 1 V。
而且上千安培的电流没法靠单路开关电路硬扛,不然剧烈的电流纹波会把芯片电压冲垮。所以 VRM 全做成多相交错并联的降压转换器(buck converter)。课上举例用四相各扛 250 A 错开相位轮流开关,真机上的相数还要多得多。电感线圈(choke)不让电流突变,几相错开以后纹波正好互相抵掉。剩下微秒级的毛刺,再靠紧贴芯片的电容抹平。所以你拆开托盘看 GPU,四周密密麻麻围了一整圈小方块电感。
在整张主板上,只有显存(HBM)能排在 VRM 前面、离 GPU 计算裸片更近。因为 HBM 要靠极短的引线保住超高的显存带宽和信号完整性,VRM 只能退居二线围在封装外面。
800 V 直流进机柜是怎么省铜省空间的
主板上的道理是电压能高就高,拖到最后一寸再降。顺着这个思路往回推,机柜背后的铜母排为什么要停在 50 V?
英伟达在 2025 年正式端出了 800 V 直流机房架构,目标直指 2027 年开始的兆瓦级机柜。按英伟达自己的测算,传统的 54 V 机柜内配电一旦过了大约 200 kW 就撞上了物理极限。
要是硬拿 54 V 去喂一台 1 MW 的机柜,光机柜母排就得用掉多达 200 公斤的铜。电源架也得占掉多达 64U 的位置,留给 GPU 的空间被挤得很小。
把送进机柜的电压拉到 800 V 直流,当场就能拿到两个大好处。第一个好处是少用铜线、少发热。Kian 在课上拿输送 100 kW 功率做过对比。如果用 480 V 三相交流电送这一百千瓦,三根火线每根要流过约 120.3 A 的电流。
如果换成 800 V 直流电,只需要正负两根带电导线,每根流过 125 A 的电流。要是把直流电压调到约 831 V,连每根线的电流都能做到跟交流完全一样。
你看,每根线上的电流差不多,但直流直接少了一根带电导线,带电导体数量少了三分之一。英伟达自己的说法是,跟 415 V 交流比,能省下约 45% 的铜,同样多的铜做成母线槽能多送 85% 的功率。
再算电线发热。假设每根导线的电阻都是 10 mΩ,三相交流电三根线一共烧掉 434 W。而 800 V 直流只有两根线发热,只烧掉 312.5 W,线路损耗直接砍掉了约 28%。
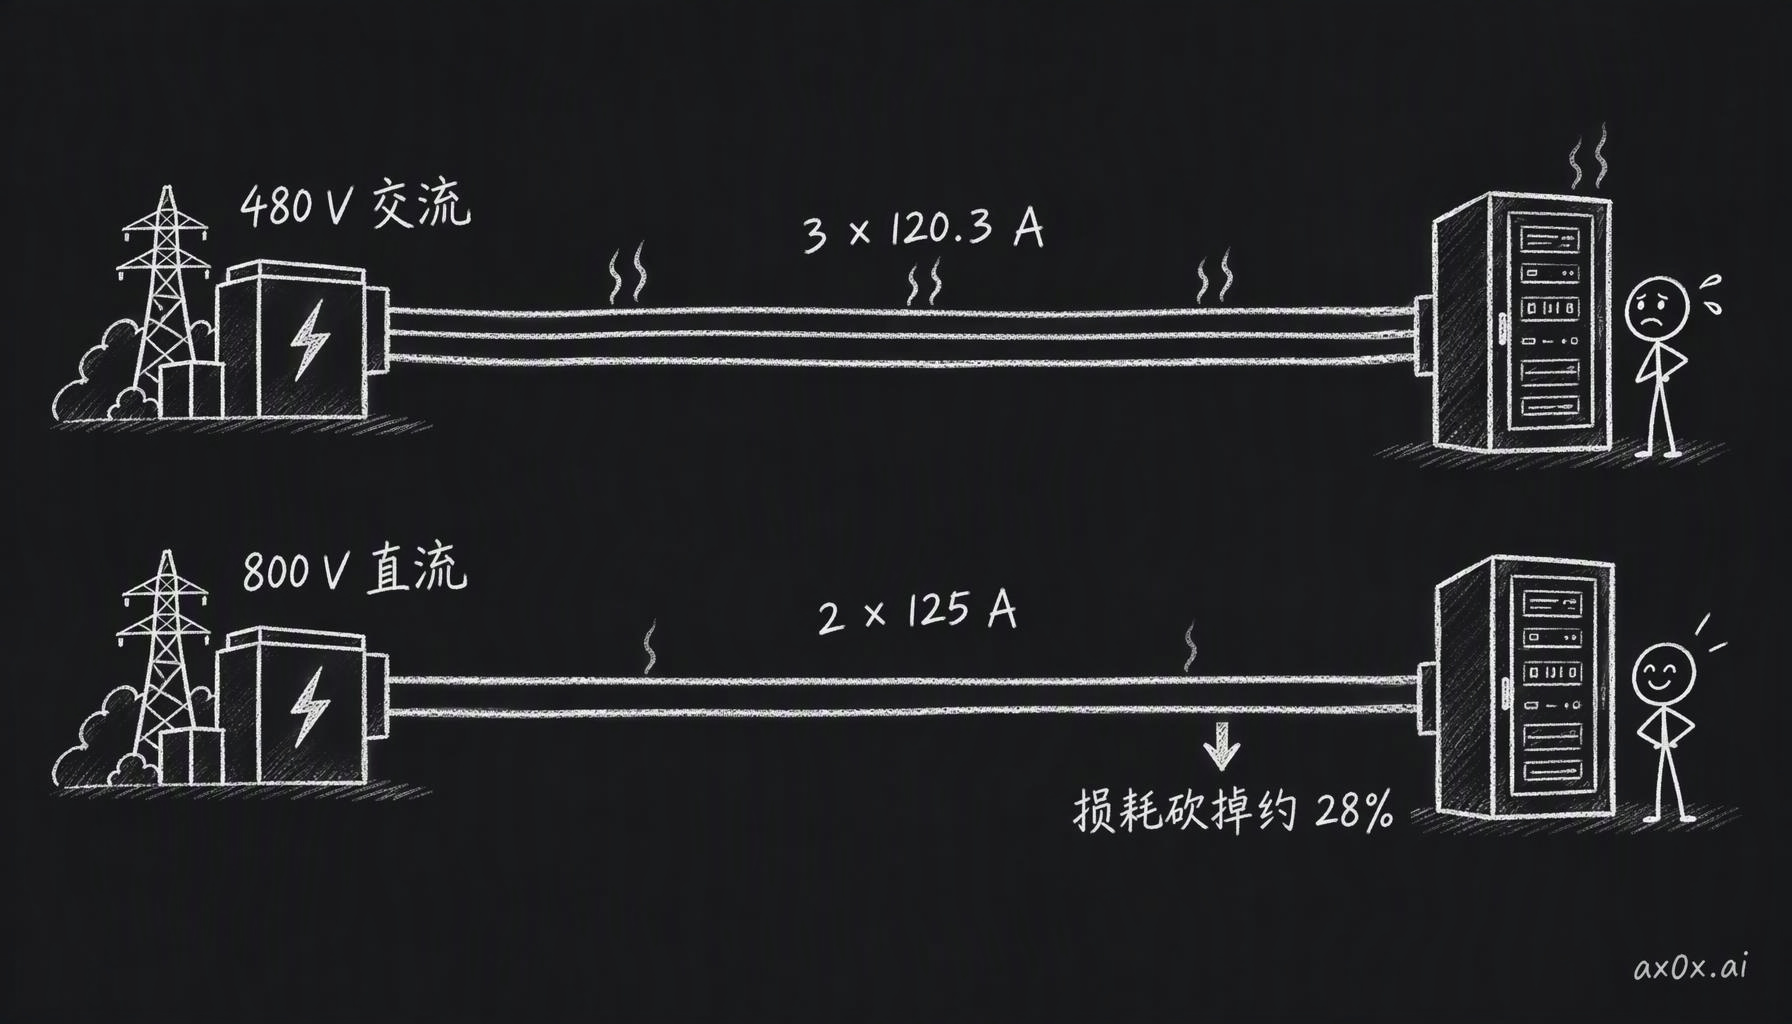 送 100 kW:480 V 三相交流电三根火线每根约 120.3 A,800 V 直流两根导线每根 125 A,直流的线路损耗砍掉约 28%
第二个好处是把宝贵的机柜空间还给 GPU。现在的 GB300 机柜里塞了多达八个电源架来把交流电转成直流电。一旦在机柜外面就把电转成 800 V 直流,机柜里的交流转直流电源架就可以挪走。
比如台达已经展示过 1U 厚就能供 90 kW 的高压转低压直流电源架。腾出来的空间全可以用来塞更多的计算托盘和交换机。英伟达还宣称,端到端的能效比 54 V 系统最高能提升 5%,维护成本最多能降 70%。
高压直流进到机柜门口之后,机柜里面还有一道选择题。第一条路是在机柜入口先统一降成 50 V,竖着的母排还跑 50 V。这样现有的计算托盘不用大改就能直接插上去用。第二条路是让竖向母排直接跑 800 V 高压,到了每个计算托盘里面再降压。后一条路把高电压保持到了最后一刻,电流最小、损耗最低,我觉得等托盘生态成熟之后大概率会往第二条路走。
整个行业往高压直流搬家,按英伟达的规范分成了三步走。第一步(Option A)叫伴随式电源柜(sidecar),计划在 2026 年三季度投产。机房大厅里还照旧走 415 V 或 480 V 的交流电,但在计算机柜旁边单放一个伴随电源柜,把交流电转成 800 V 直流喂给隔壁的 GPU 机柜。
Meta、微软和 Google 搞的 OCP Mt. Diablo v1.0 规范 2026 年 10 月生效,先用 ±400 V 直流的伴随柜过渡。后续的第二代版本才会原生上 800 V。
第二步(Option B)预计在 2027 年三季度投用,做法是建集中式直流电源中心,顺着 800 V 母线槽往机柜送电。第三步(Option C)预计在 2029 年前后(Vertiv 也预计在 2028 到 2029 年成为主流)。
那时候大楼配电室里直接放 4.8 MW 级的直流电源块,中压交流在这里就转成直流,再用直流送满整个数据大厅。到 2026 年 8 月,Google、微软和英伟达已经在 OCP 拉起了超过 80 家合作伙伴一起推进这套标准。
在现有的交流机房里改造加装伴随柜,还得算准原来的配电额度够不够用。Kian 算过一笔改造账。假设机房原本给两个机柜位留了 240 kW 的交流电额度。你放一台效率 96% 的伴随柜,带两台 120 kW 的直流机柜。240 kW 除以 96%,再加上伴随柜风扇这些 3 kW 的辅助功耗,实际要从机房吸走 253 kW 交流电。
这一下就直接超标了 13 kW。要想不跳闸,就得把每台直流机柜的功率压到 110 kW。这样算下来总共吃 232.17 kW,还能留出 7.83 kW 的安全余量。
高压直流的代价是电弧不会自己灭
既然直流配电这么香,为什么全行业磨蹭了十几年才敢往高压直流冲?其实早在 2012 年 5 月,ABB 和 Green Datacenter 就在瑞士苏黎世西区投运过一座 1 MW、380 V 的直流数据中心。
当时 ABB 报称能效比交流高 10%、建设成本低 15%。我觉得一直没大规模铺开,一个大原因是直流电压越高越难伺候,电弧和带电检修都比交流危险得多。
最头疼的物理难题,是直流电弧不会自己熄灭。交流电每秒钟有上百次过零点。当断路器拉开触头拉出电弧的时候,只要撑到下一个过零点,电流自然变成零,电弧就顺势灭掉了。可直流电是一条恒定的直线,永远没有自然过零点。一旦短路拉出 800 V 的直流电弧,那团高温等离子体就会一直烧下去。拿普通的交流断路器去切,触头很容易被电弧烧坏,甚至熔焊在一起。
更危险的是,就算你把机房外面的交流总闸拉掉了,直流母线上挂着的电池组、大容量电容和电感里还憋着满满的电能。就像关掉了水龙头总阀,水管里还憋着高压水一样。电路里的电流虽然是零,高电压却还顶在那儿。如果不先做彻底的放电隔离,上去检修的电工碰一下就会出大事。所以行业正在跟 UL、NFPA、IEEE 和 IEC 一起定新标准。保护设备也得换一套,固态断路器(solid-state breakers)几毫秒就能把电流强行切断,另外还有直流专用熔断器、电弧故障检测,和带安全互锁的接插件。
再往后看,到了第三步要把中压交流直接变成 800 V 直流。行业为这一步在押一个新设备,叫固态变压器(SST,solid-state transformer)。传统的铁芯变压器靠工频电磁感应降压,笨重得很,后面还得单配整流器。固态变压器直接用碳化硅(SiC)等高频功率半导体,把中压整流和高频隔离降压塞进同一个箱子里,体积小得多,还能灵活调压。微软、Google 和英伟达在 2026 年已经发了 OCP SST v0.3 规范,西门子和 Reinhausen 也宣布在合作研发能把最高 36 kV 交流直转 800 V 直流的固态变压器。
但 Kian 把固态变压器叫做高方差的赌注,因为这东西在数据中心里几乎没有实战履历。常被拿出来说的先例,是 ABB 给瑞士联邦铁路一台调车机车装的 1.2 MW 电力电子牵引变压器。它 2011 年装上车,2012 年 2 月开始跑,只是一个试点,算不上大规模商用。机房老板背着巨额的算力合同,很难把身家押在一个没怎么验证过的新设备上。所以我觉得短期内,大概率还是传统铁芯变压器加整流器占大头。
把这条从 345 kV 降到 1 V 的链条走完,你就能看清 AI 机房在供电上折腾的到底是什么了。外面升压是为了长途电线少发热,里面降压是因为晶体管只吃 1 V。中间的变压器、母线槽、PSU、VRM 和 800 V 直流,干的都是一件事,让大电流走的路越短越好。所以你要是看到云厂商的新一代算力迟迟不放量,或者新机房一拖就是一年,我觉得很多时候怪不到芯片厂头上。卡住进度的多半是一台要等好几年的大型变压器,或者是上千安培的电流怎么安全送进芯片最后那一寸。第五篇讲另一头的事。外面电网突然闪一下,或者几万张 GPU 训练时一起停、一起跑,功率一下抖几十兆瓦,机房得靠电容、电池和发电机一棒接一棒撑住。最快的一棒按毫秒算,发电机要 10 秒左右才接得上。
本系列整理自 freeCodeCamp 上 Kian(@neuralkian)的课程「Inside an AI Factory – Power, Cooling, and GPUs Explained」(课程原名 From Watts to Tokens,讲义在 kiankyars.github.io/gigawatt)。框架和大部分例子是 Kian 的,我按主题重新编排、核对了数字,理解有偏差的地方锅在我。文中提到的公司只是例子,不构成任何投资建议。