
opus 5.5 用 medium 还是 high,我拿自己的 repo 测了一下
起因
opus 5.5 今天出来了,我第一件事就是想定下来默认用哪一档 reasoning effort。opus 5.5 有五档:low、medium、high、xhigh、max。我之前 claude code 全局开的是 xhigh,给 opus 5.5 单独设的是 medium,所以其实就是在纠结 medium 和 high 选哪个。
网上能找到的大多是 benchmark 分数,可 benchmark 跟我每天让 agent 干的活不太一样。我现在基本不自己写代码了,改动几乎全是 agent 写的,我也不逐行 review,所以我在意的其实就两件事:
- 拿我自己的 repo、我平时真会交给它的那种任务去跑,两档的完成度差多少。
- 差出来的那一点,值不值得多花那些时间和 token。
所以干脆直接测。
怎么测的
思路是拿历史提交来 replay,有点像 SWE-bench 那一套,只不过题目全从我自己的 repo 里出。流程大概是这样:
- 挑题。我让 agent 去扫我 11 个 repo 最近几个月的提交历史。这些 repo 挺杂的,有 TS 的 side product,有 Rust 写的桌面工具和凭据管理工具,有 Python 的出版流水线,还有 Node 的 agent runtime。挑的时候看这几条:一个提交得同时改了源码和测试,测试放在单独的文件里,改动在几十到几百行之间,而且是 feature 或者 bug fix,不能是 refactor。最后挑出来 22 个。
- 验题。每个候选题都另开一个 agent 独立复现一遍。在父提交上把原提交的测试叠上去,必须 fail;切到原提交,必须 pass;再多跑两遍,看是不是 flaky。它还要检查任务描述公不公平,隐藏测试用到的每个函数名、签名、报错文案,任务描述里有没有写清楚,而且不管怎么写,都不能把实现泄露出去。有几道题是它改了措辞才放行的。
- 跑题。每道题 medium 和 high 各跑 2 次,一共 88 次。每次都开一个新的 git worktree,停在父提交上,依赖提前装好,两档拿到的任务描述一模一样。同一道题的 medium 和 high 同时开跑,这样两边碰到的机器负载是一样的。
- 判分。agent 跑完以后,把原提交的测试叠到它的改动上跑,这是硬指标。然后再跑一遍整个 test suite,看它有没有搞出新的失败。
- 盲评。同一道题同一轮跑出来的两份答案,打包成 A/B 交给一个 judge。它能看到任务、原提交的 diff、两份 diff、测试结果,还有 agent 自己写的收尾报告,但不知道哪份是哪一档。每一对评两次,第二次把 A/B 对调,抵消它对位置的偏好。一共评了 88 次。
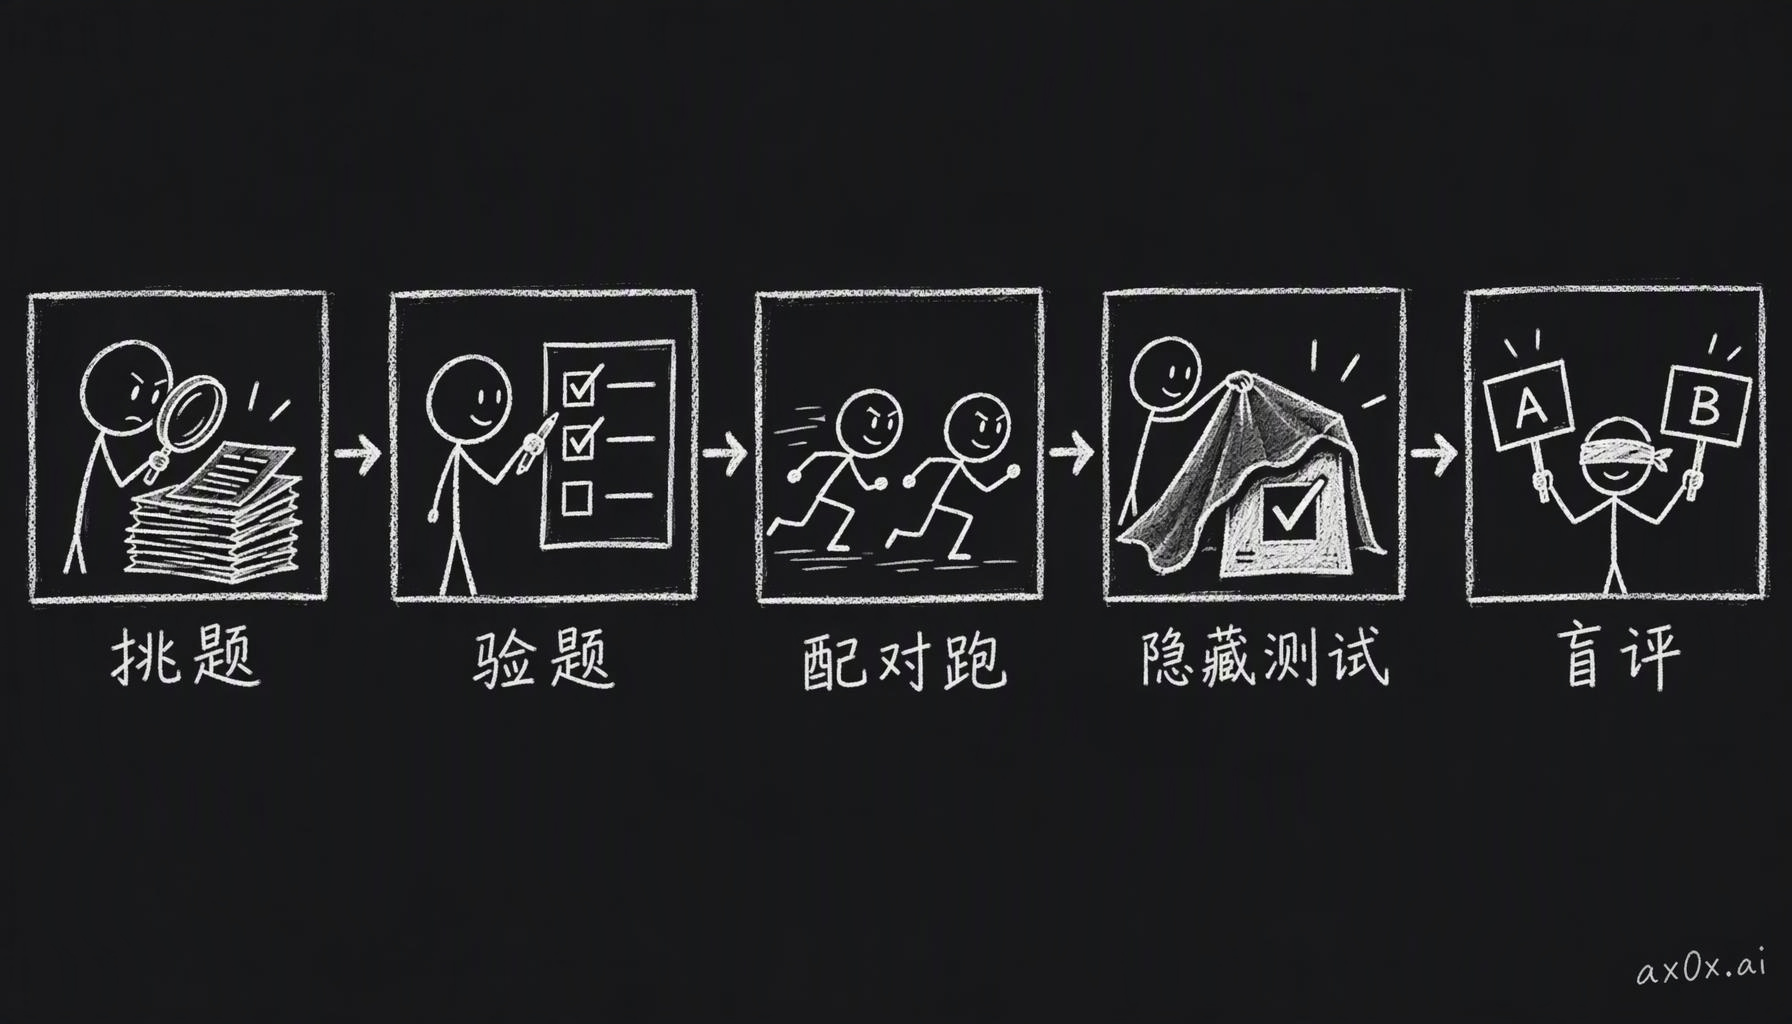 replay 测试流程:挑题、验题、配对跑、隐藏测试判分、盲评
时间和 token 都是从每个 agent 的 transcript 里直接算的,不靠它自己报。我还把所有 agent 跑过的命令扫了一遍,看有没有谁偷看 HEAD 之后的历史或者主 checkout,结果没有。
中间还出了个插曲。跑到一半,我本机的登录 token 被换了一次,旧 token 当场作废,12 秒之内 39 个 agent 全部 401 挂掉。workflow 里的子 agent 碰到 401 不会重试,直接算失败。反倒是当时正卡在 cargo build 这种长命令里的几个 agent 活了下来,因为那 12 秒里它们没发 API 请求。我是这么处理的,一对里只要有一边挂了,就整对作废重跑,worktree 也删了重建,这样两边的负载条件还是一样。最后的数据全部来自完整跑完的 44 对。
结果
先说最直接的,两档的完成度没有区别。88 次全都过了隐藏测试,也都没有搞出新的测试失败。full suite 里是有一些失败,我一个个对过,要么是原提交里本来就挂着的测试,要么是并发跑的时候机器太忙超时了,闲下来重跑就过。
差别在时间、token 和质量上:
| 指标 | medium | high |
|---|---|---|
| 隐藏测试通过 | 44/44 | 44/44 |
| 耗时中位数 | 140s | 234s |
| 耗时(配对几何平均) | 1× | 1.33×,44 对里 39 对 high 更慢 |
| 输出 token(配对几何平均) | 1× | 1.35×,44 对里 43 对 high 更多 |
| 按 token 估的成本 | 1× | 约 1.29× |
| 盲评胜场 | 7 | 16(另有 21 对打平) |
盲评那一行得展开讲讲,high 赢的地方挺有意思。judge 投给 high 的那些对,大部分都是抓到了测试查不出来的真 bug:
- 一个 dashboard 的柱状图。medium 版算柱高比例用的是压缩前的数据,画出来的却是压缩后的柱子,所以 90 天和全部时间这两张图会画出超过 100% 的柱子。测试没覆盖渲染,所以两边都是绿的。
- 一个定时衰减的逻辑。medium 版改了数据库里的状态,但没同步内存里的那份,后面再整体写回一次,就会把刚写进去的衰减标记冲掉。
- 一个迁移脚本加了「检查不通过就拒绝写入」。medium 版把检查放在改完两个文件之后,等它拒绝的时候,磁盘已经脏了一半。high 版两次都是先检查再动磁盘。
- 一个几何图元有两套光栅化实现。high 版两次都让浮点实现、整数实现和 SVG 描述的是同一块区域,任务要求的面积误差在各种角度下都守得住;medium 版到了小尺寸和 45 度的时候就守不住了。
- 还有两个是 medium 没照任务写明的语义来。一个是条件判断的顺序写偏了,一个是把 repo 里一条限制中文硬编码数量的检查弄坏了。
反过来,medium 赢的 7 对里只有一对是真 bug。high 改一个登出请求的时候,顺手把平台要求带的客户端 IP 头删了,放到真实环境里,登出会直接失败。其他几对 medium 能赢,是因为 high 多改了没让它改的东西,或者改完忘了更新因此过时的文档。
judge 的分项分数也是这样。完成度(8.90 对 8.72)和验证充不充分(8.89 对 8.62)high 高一点,不越界(8.76 对 8.28)medium 高一点。high 更爱顺手多干点活,这有好有坏,多干的大多是补测试、更新文档,但偶尔也会碰到不该碰的东西。
有一点得说清楚,16 比 7 这个差距还不到统计显著,符号检验 p 大概是 0.09,judge 偏好均值的置信区间也跨过了 0。所以只能说 high 有这个倾向。让我倒向 high 的其实是上面那几个具体的 bug,测试全绿,我自己又不会逐行去看,上线以后才会炸,都是这种。
对一下 Artificial Analysis 的数据
Artificial Analysis 今天也放了 opus 5.5 的评测,五档 effort 全测了。我把 Intelligence Index 和跑完整套评测花的 token 摘了出来:
| effort | Intelligence Index | 跑完评测的输出 token | 相对上一档的成本 |
|---|---|---|---|
| low | 42 | — | — |
| medium | 51 | 38M | — |
| high | 54 | 53M | 约 1.3× |
| xhigh | 56 | 100M | 约 1.9× |
| max | 58 | 260M | 约 2.6×(按 token 算) |
这组数据跟我自己测的挺对得上。他们那边 high 的 token 是 medium 的 1.39 倍,成本大概 1.33 倍;我这边是 1.35 倍和 1.29 倍,差不多一个数。分数上,medium 到 high 涨了 3 分,花 1.3 倍的钱,整条曲线上就这一步最划算。再往上,high 到 xhigh 涨 2 分,要花将近 2 倍;xhigh 到 max 再涨 2 分,token 又翻了 2.6 倍。
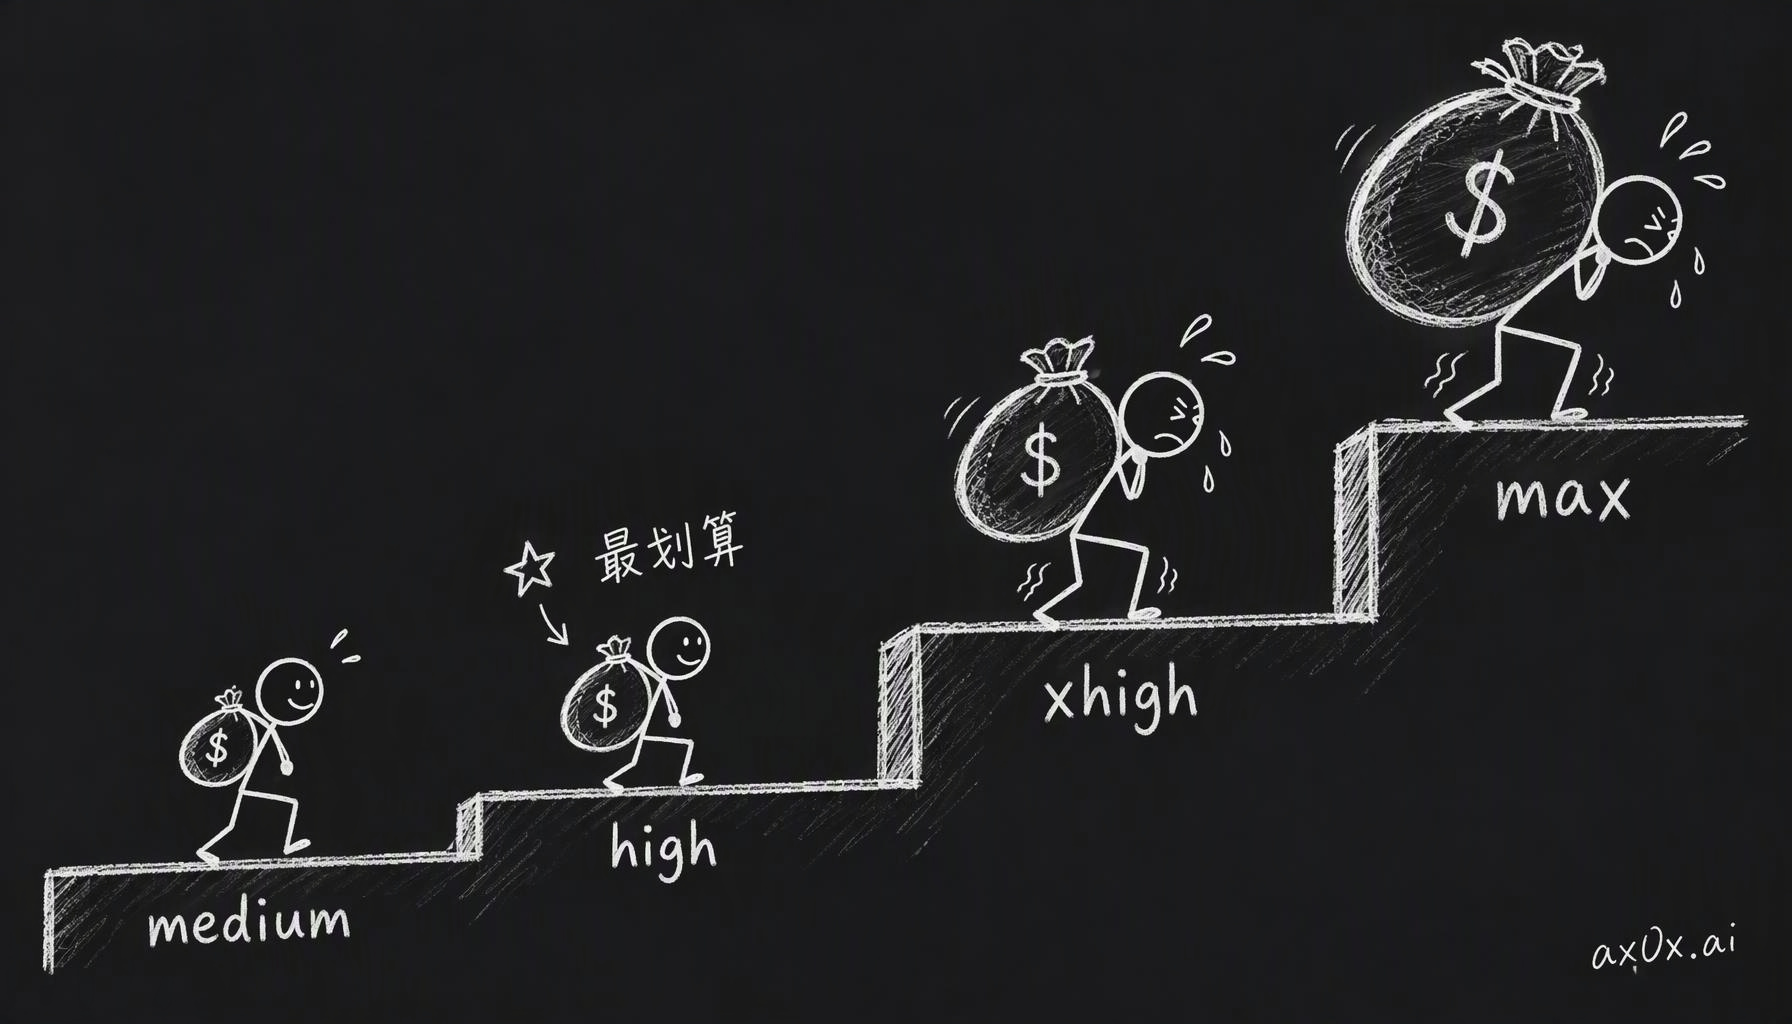 effort 阶梯:medium 到 high 这一步最划算,再往上成本翻倍
他们文章里还提到,opus 5.5 的 max、xhigh、high、medium 四档都在「分数对单题成本」的 Pareto frontier 上,在这个价位上,没有别的模型能比它又便宜又强。价格也比 opus 5 降了一截,cache read 尤其便宜,agent 要反复读大量 context,所以这点对 agent 很友好。
所以两边的数据对得上。medium 已经很强了,high 多花三成多的成本,能换来一点实打实的提升;再往上,多花的钱换来的提升就少得很快了。
最后怎么定的
默认改成了 opus 5.5 + high,理由就是上面那几个 bug。我的 workflow 里没有人工 review 这一步,能兜底的只有测试和 agent 自己的判断,测试查不出来的那类错,就只能指望模型多想一步。多花三成的时间和 token 换这个,我觉得值。
改配置的时候踩了个坑,顺便记一下。我把 settings.json 里的 effortLevel 改成了 high,新开一个 session 一看,实际跑的还是 xhigh。查了一圈,原来是 ultracode 搞的。只要 "ultracode": true,每个 session 都会被强制成 xhigh,settings 里的 effort 设成什么都不管用,交互模式和 claude -p 都是这样。想确认的话,可以看 transcript 里每条消息记的 effort 字段,或者直接看启动画面那行「with high effort」。所以想让 high 当默认,就得把 ultracode 关掉,要用的时候再单独开。另外 --effort 参数和 CLAUDE_CODE_EFFORT_LEVEL 环境变量都能直接覆盖,临时换档用这两个就行。
不同用法怎么选
上面是从我自己的场景得出来的,换一种用法,答案可能就不一样了。大概分这么几类:
- agent 自己跑到底、没人 review 的(跟我一样):用 high。两档完成度一样,但 high 能多抓住一些测试兜不住的问题,没人 review 的时候最怕的就是这种错。
- 结对编程、自己会看 diff 的:medium 就够了。它能省下大约四分之一的时间,越界也更少,它漏掉的那种问题,你 review 的时候大概率能看出来。少等的那些时间,用起来感觉差别挺明显。
- 额度比较紧的(Pro、订阅用量经常撞墙、或者按 API 大量调用):默认 medium,碰到难的任务再手动
--effort high。三成多的 token 差距,放到一个月的用量上还是不少的。 - 难题(算法、几何、并发、数据一致性、跟钱有关的路径),或者一跑好几个小时的长任务:可以开到 xhigh。按 AA 的数据,xhigh 还能再涨 2 分,但成本差不多翻倍,也就这种地方值得花。max 我只留给真卡住了的问题。
- 批量的机械活(grep、改名、格式化、简单的 subagent 任务):low 或者 medium,这种活多想也没什么用。
这次测试还有几个局限要说一下。第一,我挑的题任务描述都写得比较细,因为隐藏测试要求接口名对得上。这样一来,完成度可能被题目本身顶满了,两档拉不开,需求更模糊的时候差距可能会更大。第二,judge 本身也是 opus 5.5 high,理论上它可能有偏好。我用盲评和 A/B 对调去压这个问题,但没法完全排除。第三,我测的是 workflow 里的子 agent,不是交互式 session,xhigh 也没放进来一起测。样本是 44 对,看个方向够了,下定论还不够。
以后再有新模型出来,这套流程直接拿来用就行,挑题、验题、配对跑、盲评都是现成的,换个模型名再跑一遍。