
说话人分离,我试了四套方案才搞定
我有个一直在跑的小工具,把语音备忘录自动转成结构化笔记,录完几分钟,整理好的文稿就自己躺在那儿了。用了大半年,转写本身早就不是问题,现在随便一个模型转出来都够用。一直没搞定的是说话人分离,也就是 diarization,分清楚哪句话是谁说的。我有一段 28 分钟的录音,从头到尾就两个人在聊,转出来给我标了五个说话人。讲道理,这挺离谱的。
为这事我前后换了四套方案,Gemini 切块、Senko、豆包,最后落在火山的妙记上。这里把过程记一下。中间还踩了两个坑,跟 diarization 没关系,但卡了我很久,也一起记下来给后来人。
第一版:Gemini 切块
最早我用的是 Gemini。长音频有个坑,整个文件直接丢给它的话,超过十几分钟它就开始不老实,跳段、循环、自己编时间戳。所以得先切块,在静音的地方下刀,切成十来分钟一段,并行去转,让每一段都落在模型还清醒的长度里。
转写质量没问题,但切了块又冒出一个新问题。每一块是单独转的,说话人编号都从「说话人0」开始编。第一块的说话人0,到第二块可能就成了说话人1,块和块之间编号对不上。
我的补救办法是让相邻两块重叠 60 秒。重叠的这段里,同一句话在两块里各标了一个说话人,拿这个去投票,把两边的编号对上。大部分时候管用。但只要有一个缝合点投歪了,后面整条的编号全跟着错位,说话人数量就一路虚高。缝合点越多,出错的机会越多,反正这条路我后来是放弃了。
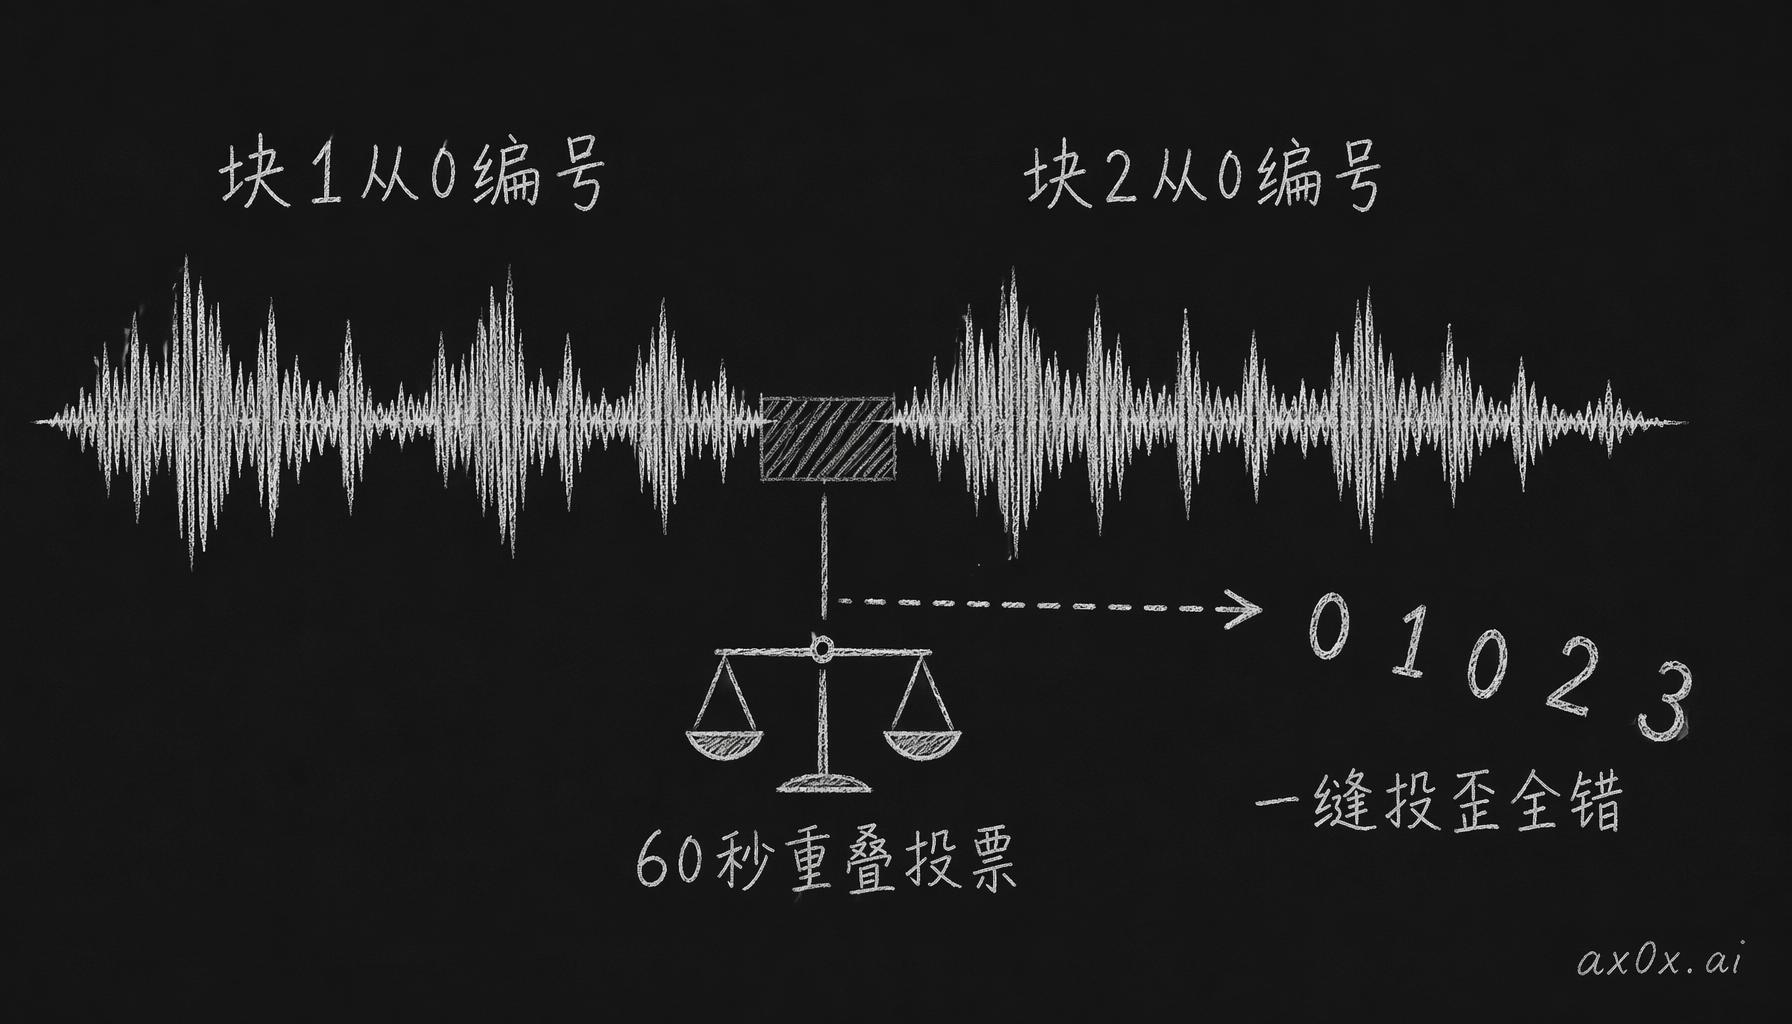 音频切块各自从0编号,靠重叠区投票缝合,一处投歪后面全部错位
第二版:Senko 全局分离
既然跨块缝合不靠谱,那就不缝了,整段音频一次做完 diarization。我接的是 Senko,它在苹果芯片上跑 CoreML,比 pyannote 那套快几十倍。它确实比缝合稳,至少编号从头到尾是一致的,不会转到一半换人。
但它有个改不掉的毛病,会把短短的插话当成新来的人。真实对话里全是「嗯」「对啊」「然后呢」这种搭话,一个人在讲,另一个人时不时应一声。Senko 经常把这种一两个字的应答判成第三个、第四个说话人。28 分钟那段它好歹判对了 2 人,换几段长一点的录音,数字立马又虚高上去了。
中间试了一下豆包
这中间我还去试了火山引擎的豆包,主要想看看国产模型转中英混说是不是更顺。转写质量确实让我挺惊喜,中文和中英混说都转得很干净,带标点,口语也顺。这本来就是我最早想解决的问题,它比 Gemini 那套解决得漂亮。
但说话人这边更崩。极速版把那段 28 分钟的录音判成 5 个人,2.0 判成 4 个,比 Senko 虚得还厉害。
到这儿我大概看明白了。通用模型顺手做的 diarization 普遍偏激进,宁可多切出几个人,也不肯合并。它分不清「嗯」是搭话还是新人,干脆全算成新人。
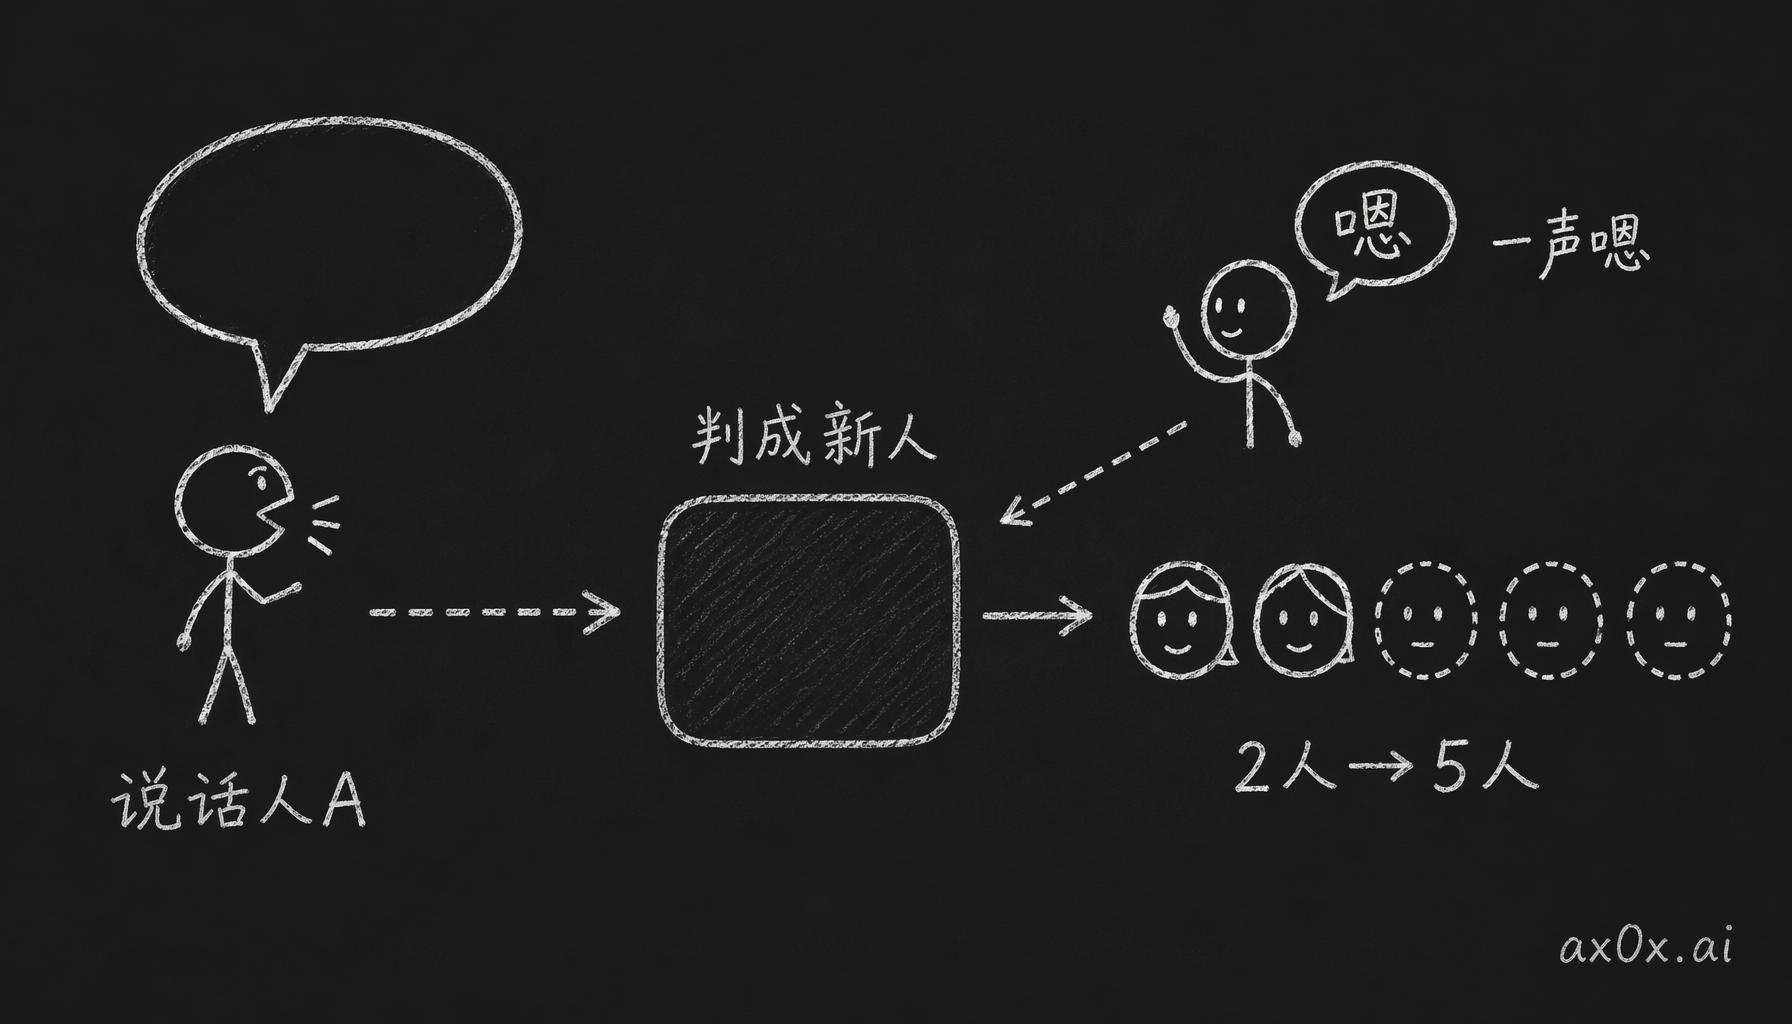 通用 ASR 把「嗯」这类搭话误判成新说话人,两个人被数成五个
坑一:火山有两套鉴权
试豆包的时候,卡了我大半天的其实不是模型,是鉴权。火山的语音服务有两套账号体系,老控制台给你一组 AppID + AccessToken,新控制台给你一个 x-api-key,两套能用的资源不一样。我一开始拿老的 AppID 去调 2.0 的接口,一直返回 resource not granted。配额明明有,就是不让用,怎么查都查不出问题。折腾半天才反应过来,2.0 和后面要讲的妙记,都得走新控制台的 x-api-key。换了鉴权头,立马就通了。
这一点文档里写得很隐蔽。如果你调火山的语音接口也碰到「资源没授权」,先看看是不是用错了鉴权方式,大概率就是这个原因。
最后落在妙记上
最后真正把问题解决的是火山的妙记(Lark Minutes ASR)。它和前面几套不一样的地方在于,diarization 是服务端做的,调一次接口,转写和说话人一起出来,客户端不用缝,也不用投票。
我拿 5 段真实录音做了对比,其中 4 段是两人对话:
| 录音 | 极速版 | 2.0 | 妙记 |
|---|---|---|---|
| 28min | 5 | 4 | 2 |
| 38min | 3 | 3 | 2 |
| 57min | 3 | 3 | 2 |
| 68min | 4 | 3 | 2 |
| 3.45h(剧集) | — | 10 | 3 |
四段两人对话,妙记每段都判的 2 人,另外两家每段都判多了。3.45 小时那段是一部多角色剧集的音频,别家要么文件传不上去,要么判出 10 个人,妙记一次就吃下来了,判了 3 个。3 个不一定全对,但比 10 个靠谱太多了。
所以我现在的做法是,diarization 别指望通用模型顺手帮你做,直接交给专门做这个的服务端模型。前面那些切块投票、全局分离,都是在给一个不擅长这事的模型打补丁。模型本身判不准,客户端再怎么折腾也就那样。
坑二:妙记要公网链接,跨境上传 34KB/s
妙记有个硬要求,它不收你直接上传的文件,只认一个公网能下载的 URL。所以本地录音得先传到对象存储上,再把链接给它。
我用的是火山自家的 TOS(对象存储),桶开在上海。妙记从上海取文件走的是境内链路,飞快。慢的是另一头,我从美国往上海传,单线程只有 34KB/s,一个 8 兆的文件传了将近四分钟。这速度显然没法用。
查了一下,跨境链路主要限的是单条连接的速度,带宽其实还有富余。所以解法很直接,就是并行分片上传,把一个文件切成几段同时传。换上以后,同样的文件 5 秒就传完了。
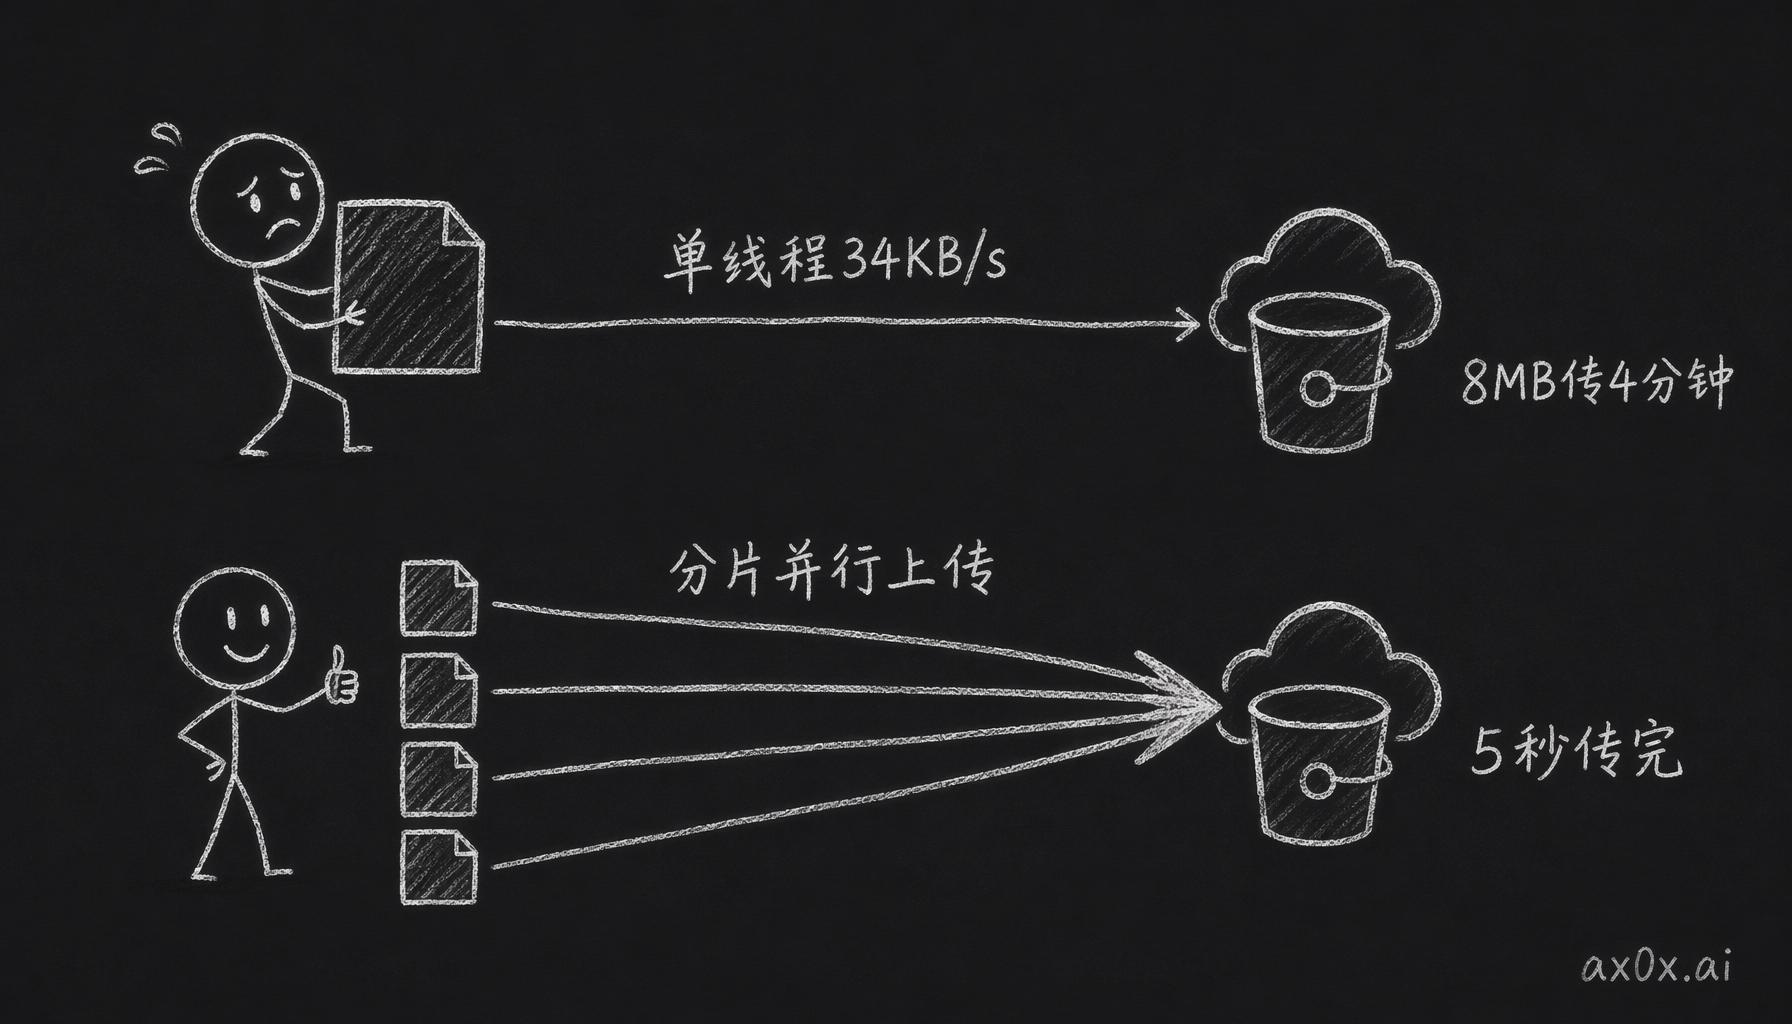 跨境单线程上传被限速到34KB/s,把文件切成多段并行传就能跑满带宽
整套换完以后,我那个转录器和对应的转写 skill,默认都走妙记了。录音丢进去,出来的文稿说话人也标对了,这事到这儿算是解决了。
如果你也在折腾会议录音的工具链,我之前还写过一篇开源方案横评,可以一起看。
