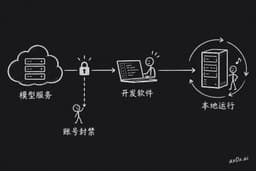
教育的瓶颈从谁来教搬到了想不想学
前几天我在一个 AI 社群里看到一场讨论,起因是一封聊「孩子为什么不肯学」的邮件。讨论不长,但我越想越觉得里面有东西,就顺手把动机科学、学习科学,还有 alignment 那边的证据都翻了一遍。串起来一看,是个挺完整的故事。但要把它讲明白,得先从教育本身说起。
往回看,教育其实一直是围着稀缺的东西转的。最早稀缺的是书,知识锁在少数几本抄本里,所以那时候的教育就是背,谁能把一本书装进脑子谁就有本事。后来印刷术让书变便宜了,书不稀缺了,稀缺的换成了老师。老师就那么多,学生那么多,只能批量教,于是有了教室、课表、四十个人一个班。整套学校就是这么来的,就是把稀缺的讲授批量发下去。现在 AI 把讲授的边际成本打到了零。一个全天在线、随叫随到、永远不烦、还能因材施教的老师,第一次人人都有了。这套学校服务了几百年的那个瓶颈,等于没了。
那学习应该爆发了吧?并没有。Khan Academy 免费摆了十几年,按它自己 2024 年的效能报告,只有 9% 左右的学生用到了建议的量。多伦多大学的团队做过一个一万多人的随机对照实验,三到六年级的孩子每周用满 35 分钟,数学成绩能涨 0.12 到 0.17 个标准差,效果是真的。可七八年级的学生平均每周只用 10 分钟,效果是零。工具白送,也没人用。所以只能说瓶颈没有消失,只是搬了家,从「谁来教」搬到了「人为什么想学」。
 教育瓶颈的三次迁移
学校那套设计,解的是一个已经不存在的问题
年级、课表、统一进度、期中期末考,这套东西在它出现的那个年代,每一样都是合理的解法。老师稀缺,就只能批量教,按年龄分班,按学期排进度,再用考试做质检。十九世纪普鲁士人把它定成了标准,全世界抄了两百年。
代价出在动机上。分数、排名、升学,都是挂在学习外面的奖励。外部奖励会杀伤兴趣,这是动机科学里被复现得最多的结论之一。1973 年斯坦福有个实验做得挺狠,找了一批本来就爱画画的幼儿园孩子,跟其中一组说「画完有奖状」。几周后到了自由活动时间,拿过奖状的孩子画画的时间,只剩没拿奖状的孩子的一半。后来有人把 128 个同类实验汇总起来做了元分析,方向是一致的,事先说好的、实打实的奖励,会系统性地削弱本来就有的兴趣。道理不复杂,人会从自己的行为倒推自己为什么这么做。既然画画是为了奖状,那奖状一撤,画画的理由也就跟着没了。
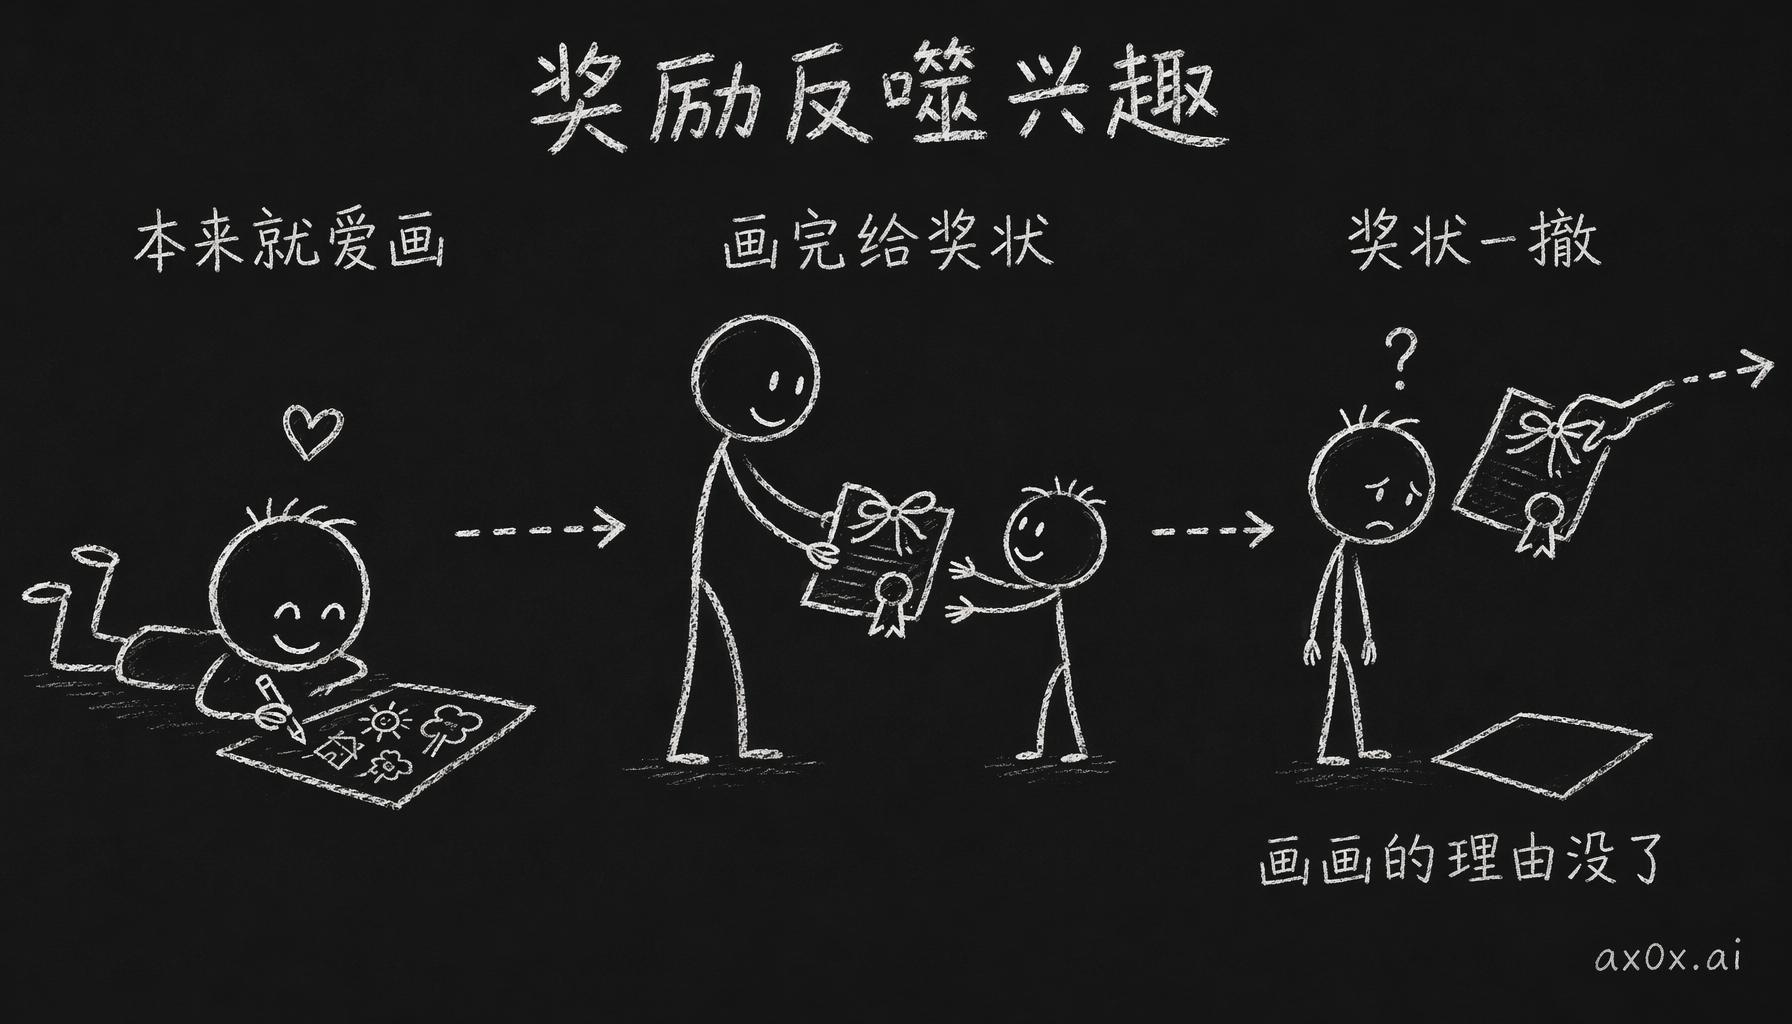 外部奖励反噬内在兴趣:孩子本来爱画画,给了奖状后再撤掉,画画的理由也跟着消失
所以学校现在的处境挺拧巴的。它一边在分发稀缺的讲授,一边又用外部奖惩磨着学生的动机。在旧瓶颈的年代,这笔账还算得过来,毕竟不上学连知识都摸不到。现在讲授不稀缺了,这套东西还在原地转,等于是一边损耗新的瓶颈,一边去解一个已经不存在的旧问题。这笔账现在算不过来了。
需求不是只能找现成的,是可以点出来的
回到那场讨论。一位做 AI 教育活动的朋友复盘了自己的经验。他直接跟人说「你们需要学 AI」,没人来;后来改成办 Hackathon、办 demo day、给大家向投资人演示的机会,人自然就来了。他得出的结论是,别在别人心里硬造渴望,要去找已经存在的需求。
他这个复盘我觉得挺值钱,实操上也全对。但「找已经存在的需求」这半句,我总觉得差了点什么。想来想去,只能说他把自己做成的事说小了。
「没需求就推不动」这个说法,动机科学里有个实验打得很准,是 2009 年发在 Science 上的一个随机对照。研究者让高中生在一个学期里定期写点东西,每次一两段,题目是「这周学的东西跟我的生活有什么关系」,对照组只写内容摘要。结果实验组的兴趣和成绩都涨了,而且原本最不看好自己的那些低动机学生,涨得反而最多。你想,如果兴趣真的只能找现成的,这个办法应该只对本来就有兴趣的人管用,结果正好反过来。兴趣研究的主流框架说得更直接,兴趣一开始是被环境触发的,叫情境兴趣,用不着你事先就有。兴趣是学出来的,是学习的结果,不是你进场之前就得先揣在兜里的东西。
所以那位朋友真正做成的事,不是找到了需求,是搭了个场,把还没点着的兴趣点着了。这个场靠两个引擎起作用,他只看到了一个。第一个是需求翻译,就是让人觉得「这东西能解决我手头的问题」。第二个他没提,是模仿。René Girard 这个思想家一辈子就讲一件事,人的欲望大多是从别人那里抄来的,我们想要一个东西,往往是因为我们敬佩的人想要它。demo day 上真正点火的,常常不是「AI 有用」这个说法,而是你看到一个跟自己差不多的同行做出了东西,站上了台,被一圈人围着问。
 二元需求与三角欲望
「以后用得上」是真话,孩子照样不买账
那场讨论的源头,是社群里的那封邮件。写邮件的人看着自己女儿学了三年编程,说大人最坑孩子的一句话,就是「这个先学着,以后总会用得上」。孩子能感受到的只有当下,看不到作品、看不到目标的时候,知识对她来说就是纯负担。他给女儿想的办法,是把「学 AI 编程」换成「做一个你能和朋友一起玩的网页游戏」。
这个观察真准。再往下拆一层,「以后用得上」多半是真话,只是对归对,孩子没法照着它走。
行为经济学把这件事描述得很精确。人对未来回报的折现是双曲线的,回报每往后推一步,现在看它的价值就跌一大截。发展心理学又补了一层,青少年折现的研究测出来,13 岁以下孩子的折现率显著比成年人陡。原因出在硬件上。管冲动和奖赏的边缘系统,青春期就早早成熟了;管长远打算的前额叶,要到成年才长好。所以就算孩子完全明白「以后有用」,那个回报在他的价值曲线上折完现,也差不多是零了。跟孩子讲「这个以后很重要」,等于在跟一条折现曲线辩论,从数学上就注定会输。
有意思的是,强化学习早就把这个问题和解法一起写清楚了。奖励太远、太稀疏,中间每一步都没有信号,这叫稀疏远端奖励,是 RL 里的经典死局。解法叫 reward shaping,就是在通往远端目标的路上,插一串当下就能拿到的小奖励。1999 年有个定理证明过,只要塑形奖励的形式取对,最优策略就不会变。你没有降低目标,也没有骗他,只是把梯度铺出来了,最后走到的还是同一个地方。
同一个远端目标,两种奖励地形:左边只有"十年后的深谷",小球在平地上不动;右边沿路铺了一串小坡,小球一路滚进同一个谷底。
「做一个能和朋友玩的网页游戏」就是教科书级的 reward shaping。那位父亲没跟女儿讲编程有多重要,只是让她这个愿望顺路经过了变量、循环和调试。今天写的代码今天就能跑,这周做的按钮这周朋友就能点。女儿觉得自己在做游戏,长出来的却是能力。目标没变,变的是回报的形状,或者说,是奖励在时间上怎么摆。
直接给答案的 AI,学生越用越差
到这一步,看起来都挺顺的。老师免费了,动机也知道怎么点了,剩下的不就是点火吗?讨论里也有人说,带着问题去问 AI,动机问题天生就解决了。这句话我只能同意一半,另一半是整场讨论里最危险的盲区。
2025 年 PNAS 上发过一个实验,我觉得值得贴在每个做 AI 教育的人墙上。宾夕法尼亚大学的团队在土耳其一所高中找了近千名学生,分三组做数学练习。一组用原味 ChatGPT,一组用加了护栏的版本,只给提示不给答案,还有一组不用 AI。原味组练习成绩涨了 48%,可撤掉 AI 去考闭卷,反而比从头到尾没用 AI 的学生低了 17%。护栏组练习涨了 127%,闭卷勉强追平了不用 AI 的对照组。
翻一翻聊天记录就知道为什么。原味组绝大多数学生根本不问思路,直接要答案,而 ChatGPT 给的答案只有一半左右是对的。练习分全是 AI 撑起来的,AI 一撤,成绩比从头到尾自己练的还差。
这个结果我一点都不意外。我自己整天用 AI 干活,太清楚那条能量最低的路径长什么样了。只能说在挑省劲的路这件事上,学生跟我没什么区别,谁都一样。
「带着问题问 AI」的另一面就在这里。它确实解决了动机,但「问 AI」这个动作,恰好也是绕过学习的动作。学习科学里有条挺反直觉的铁律,间隔重复、自我测试、先自己挣扎再看答案,这些做的时候觉得费劲、甚至觉得自己在退步的办法,才是把东西刻进长期记忆的工序。这个现象有个名字,叫合意困难。学东西越顺,留下来的反而越少。而 AI 恰好是人类发明过的最强的困难移除器。一个学生投入地、开开心心地把认知劳动外包给 AI,自己觉得学疯了,其实什么都没沉淀下来。动机满格反而烧得更快,因为他连停下来的理由都没有。
正面的证据也指向同一个开关。世界银行在尼日利亚做过一个六周的 AI 辅导实验,效果跑赢了发展中国家教育干预数据库里八成的项目。但它的提示词是专门设计成引导推理、不直接给答案的,课堂上还有老师盯着,防着学生偷懒。哈佛物理课上那个让学习增益翻倍的 AI 助教,也一样被做成了只引导、不代劳。所有这些实验的效果是正是负,最后都看一个变量,就是想出答案的那份认知劳动,还在不在学生自己身上。
 同一台 AI,两条回路
AI 时代的学习有两条回路。卡住的时候只给提示,压掉的是挫败感,保住的是动机;直接给答案,压掉的就是思考本身了。
按需学习,是已经会学习的人的红利
按需学习还有个更隐蔽的边界,它讲的其实是已经会学习的人怎么接着赢。社群里那位朋友举过自己的例子。他小时候觉得英语没用,后来出去玩、玩英文游戏,需求出现了,英语「自然就上来了」,高考前英语课都不上,照样考得不错。但这个故事还有另一半,他前面有九年课堂英语垫着底。需求点着的,是一个已经被系统训练过的存量。点火和建造是两件事,动机能把已有的能力激活,但从零到一的地基,它建不出来。
再往冷处想一层。纯靠需求驱动的学习,结构上就是贪婪搜索,只能顺着眼下感觉得到的梯度往上爬。一个没接触过微积分的人,永远不会「需要」微积分,因为微积分根本不在他感觉得到的方向上。你没法想要一个你想象不到的东西,这话有点绕,但就是这么回事。通识教育、强制暴露这些看起来违背「按需」的东西,干的正是这件事。它们在需求出现之前先把先验建好,让以后的需求有机会被表征出来。
这还会影响好处最后落到谁手里。2015 年 Science 上有一项研究,看了哈佛和 MIT 的 68 门免费网课,发现报名的人家庭社会经济地位显著高于美国平均。免费开放没有缩小差距,反而让本来就有自驱力、本来就会自学的人,又多吃了一轮红利。AI 正在重演这个剧本,只是鸿沟从「有没有工具」挪到了「会不会提问、能不能判断输出好不好」。我在《道升术降》里写过,AI 时代升值的是品味和判断。这里得补一句,品味也好,判断也好,没有一个是纯靠「按需」长出来的,都是长年被推着去接触、被推着去练出来的。
所以 push 和 pull 这两件事,我感觉不太像大家嘴上说的那种对立,pull 更像是 push 攒下来的红利。前面没人推过你,后面那个「需求一来,能力自然就上来了」的故事根本不会发生。孩子手里只有「即时偏好」这一个账户,「以后用得上」开的是「反思偏好」的支票,当场兑不了现。教育在这里做的,是社会先把更长的时间视野,借给还没长出它的人。
教育的成功,放在 alignment 里就是事故
我是做 AI 的,忍不住想把这整件事翻译成 alignment 的语言。大部分环节都翻得很顺,只有最顶上那层是反着的,这个反差我觉得特别有意思。先说顺的部分。说教之所以没用,是因为你没法把目标函数直接写进一个 agent,只能去设计环境,让目标自己长出来。应试刷分就是对代理指标的过拟合,是 Goodhart 定律的教科书案例。DeepMind 讲 specification gaming 的那篇官方文章里,举的日常例子就是学生为了分数去抄答案,而不是去学材料。
反着的那层在这里。AI alignment 在工程上要做的全部事情,是让 agent 稳稳地对齐一个外部给定的目标,防止它漂移,防止它改写自己的奖励函数。改写奖励函数这种情况叫 wireheading,是 alignment 要极力避免的事故。教育正好倒过来。一个学生长出了原本没有的兴趣,改写了自己想要什么,这恰恰就是教育成功的定义。同一个行为,在 alignment 那边是要拼命防住的事故,在教育这边却是大家最想看到的结果。
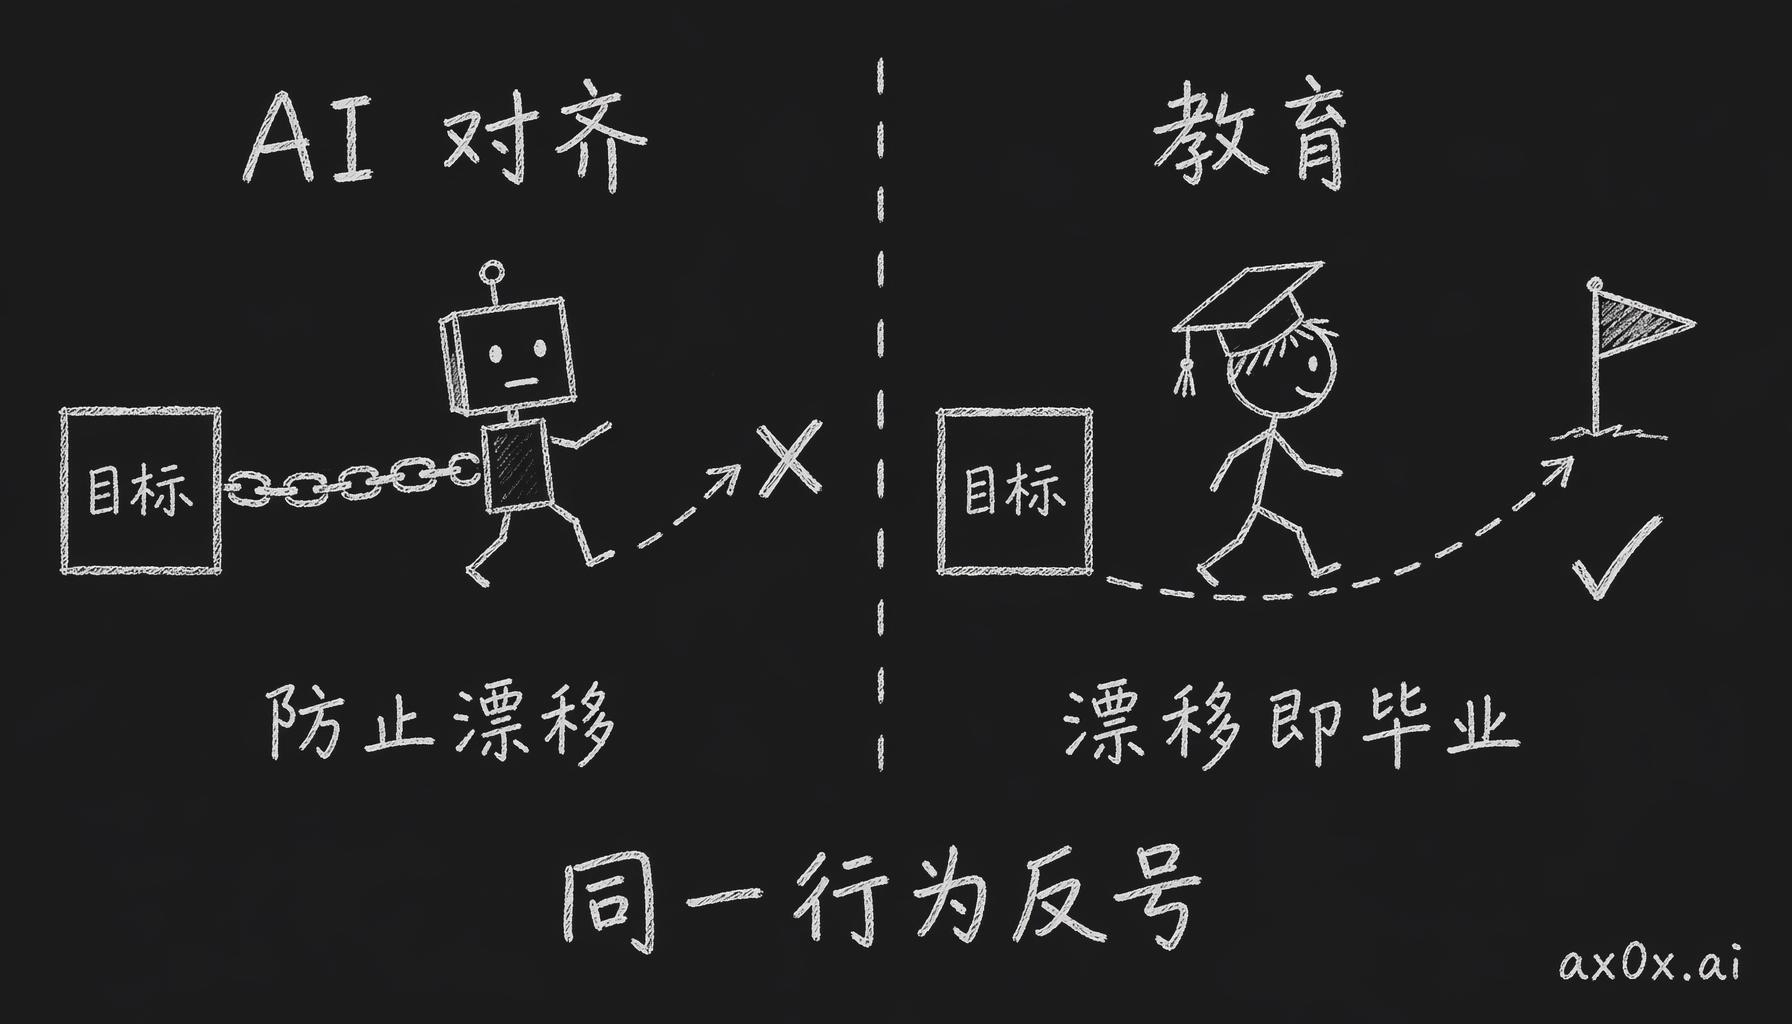 同一个行为在两边符号相反:AI 对齐拼命防止价值漂移,而教育恰恰把价值漂移当成成功
所以教育不是把人对齐到某个外部目标,那个叫驯化。教育干的事更像一场受控的价值漂移。先搭一个场,把兴趣点起来;再用护栏,保住那份不能外包的认知劳动;等哪天这个人开始自己给自己定目标了,设计者的活也就干完了。前面讲的其实就是这两层,先解决人想不想学,再保证学的动作没被偷偷外包掉。第一层现在有 AI 帮着搭场,第二层反而因为 AI 更难守了。哪层更难我说不好,感觉是第二层,因为它对着干的是那条能量最低的路径,也就是人天生就想走的那条。