
DCF 里每个数字,背后都是一个关于公司的故事
「AI 时代怎么投」课程 · 第 5 章 / 共 10 章
2016 年,Damodaran 在纽约大学的课上让两组学生分别给 Uber 估值。同一个 DCF 模型,同一套公开数据,一组估出来 280 亿美元,另一组估出来 620 亿,差了一倍多。而且两组都没算错,数学上都挑不出毛病。
差别出在故事上。第一组觉得 Uber 就是一家出租车公司,城市交通就这么大,利润率迟早会被压薄。第二组觉得 Uber 是一个物流平台,市场比出租车大得多,网络效应还能把用户锁住。两个故事都说得通,可灌进同一个 DCF 模型,出来的数字完全不一样。
大家好像都默认估值难在数学吧?数学那部分 agent 十秒就能搞定。真正难的是,每填一个数字,你都得先选好这家公司将来会是个什么样的故事。两组学生一个估 280 亿、一个估 620 亿,差就差在这儿,一组信的是出租车公司那个故事,一组信的是物流平台那个故事。
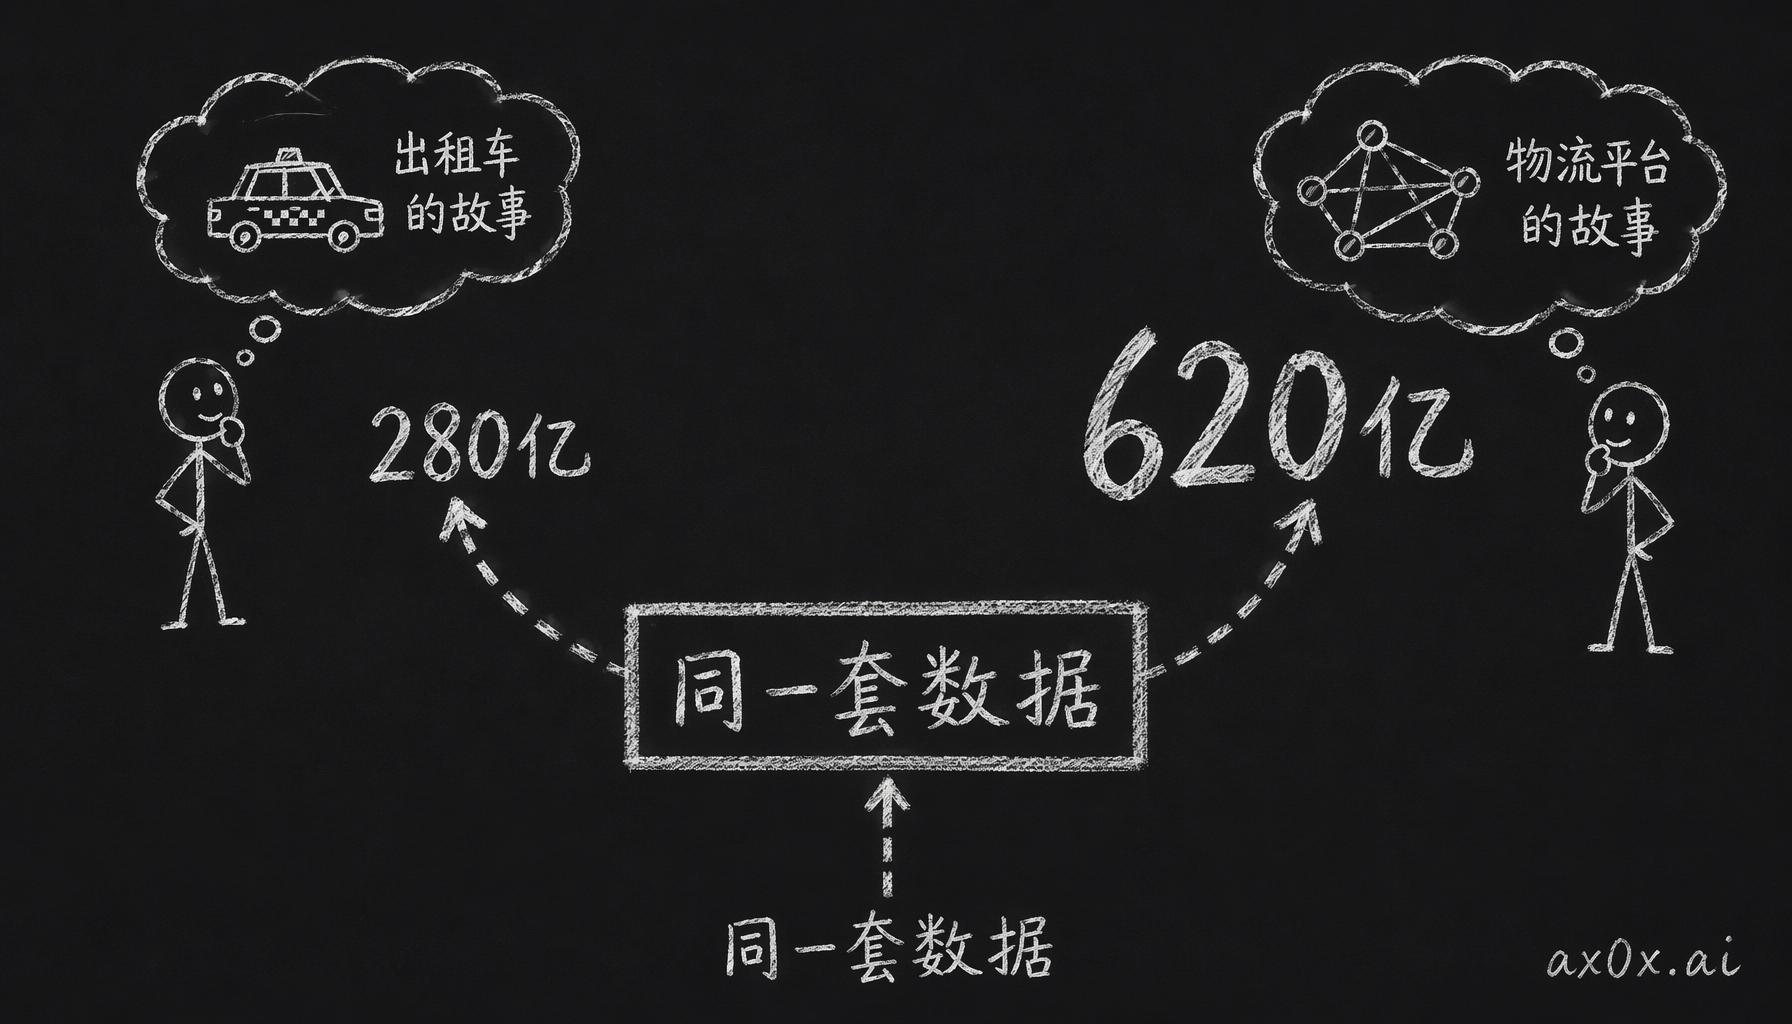 同一个 DCF、同一套数据,选不同的故事就会算出差一倍多的估值。
目录
1. 估值就三种办法,各回答一个问题
DCF 问的是,这家公司要是照我想的那个故事走下去,今天值多少钱?做法是把它未来每年的自由现金流折回今天。三种方法里它看得最深,但也最脆,随便哪个假设偏了,结果就跟着偏。
倍数法问的是,跟差不多的公司比,这家算贵还是便宜?市盈率、市销率都属于这一类。它最快,也最直观,但它默认了一件事,你找来比的那些「类似公司」得真的类似。
资产法问的是,公司要是今天关门清算,股东能拿回多少钱?这是最保守的一种,对轻资产公司基本没用。
Damodaran 说过,这三种方法看同一家公司,角度完全不同,但看的是同一件事。三个角度讲出来的故事要是大差不差,你可以放心一点;要是差得很远,就得回头看看差在哪了,多半是有个关键判断你自己还没想清楚。
2. DCF 要你做五个选择
DCF 的逻辑其实特别简单,一家公司值多少钱,就是把它未来所有的现金流都折回今天,再加起来。听着简单,可麻烦全藏在「未来所有现金流」和「折回今天」这两个词里。拆开来,你要做五个选择。
收入增速。 Uber 那个例子里 280 亿和 620 亿差出来的那一大截,主要就是这个数字拉开的,「出租车公司」是一个增速,「物流平台」是另一个增速。这个数没法直接算出来,因为它底下压着三个更基本的问题,市场有多大,你能吃下多少,这个速度能撑多久。
利润率。 你选哪条利润率走势,DCF 里的现金流就有多大。选这个,其实就是在判断竞争格局会怎么走。
资本开支和再投入。 同样是赚 10 亿,半导体公司和软件公司最后留在手里的自由现金流,可能差三倍。
折现率。 就是你要多高的回报,才肯担这份风险。它的影响是指数级的,大部分价值都压在远期的公司受影响最大,折现率动两个百分点,估值可能就动 30% 以上。
终值。 预测期结束以后,公司还值多少钱?大部分 DCF 里,终值要占总价值的 60% 到 80%。等于你估出来的数有六到八成,押在你对十年以后的假设上。
顺序上有个讲究,先把故事写出来,再去填数字,别反过来。这五个数字得讲同一个故事。比如你填了 40% 的收入增速,又填了 30% 的利润率,就等于在说这家公司不怎么花钱也能高速增长,绝大多数行业做不到。先写故事还有个好处,你先用一句话讲清楚「我认为这家公司是什么」,回头就能拿它查五个数字有没有互相打架。两个人估值对不上,去查计算大概率查不出什么,多半是俩人讲的故事本来就不一样。
3. 动一动假设,看你到底在赌什么
大部分人做完 DCF 就停了,挺可惜的,后面其实还有一步,就是动一动假设,看数字会动多少。有的假设你动两三个百分点,估值几乎不动;有的也是动两三个百分点,估值直接变 30%。最敏感的那个假设,就是你真正在赌的东西,只是你自己可能没意识到。
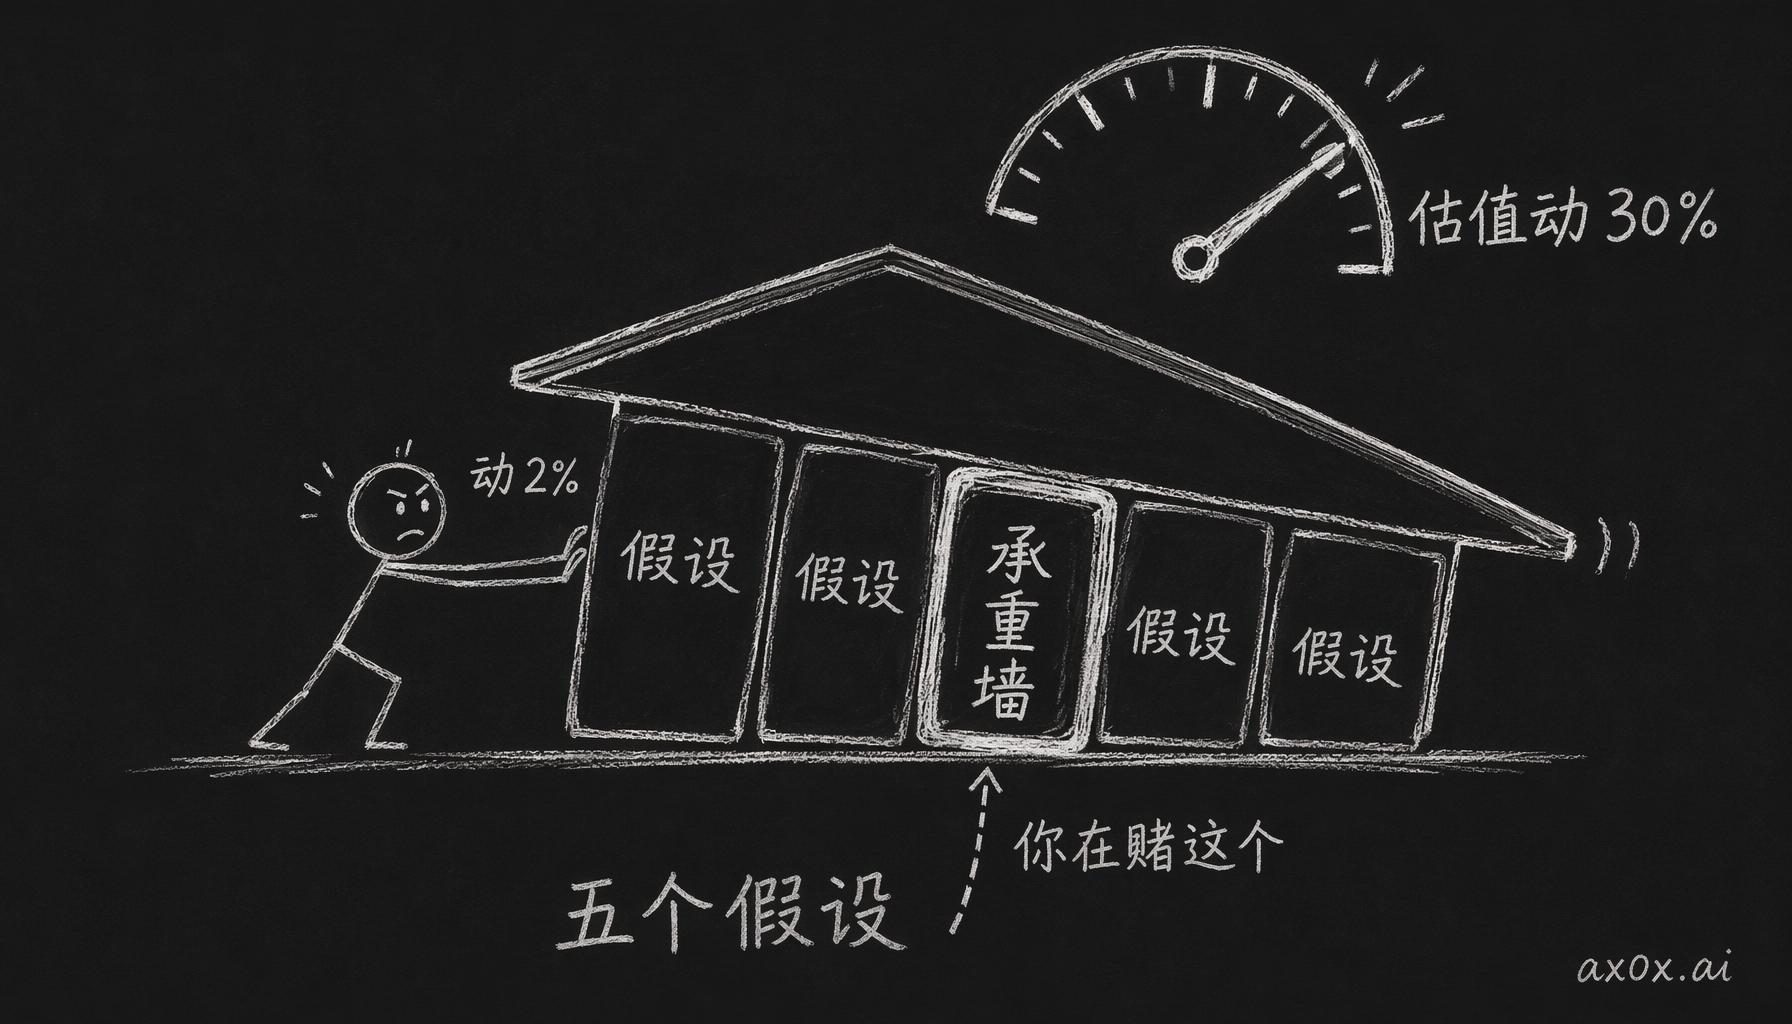 五个假设里总有一个最敏感——动一点估值就动 30%,那面承重墙才是你真正在赌的东西。
举个例子。你给一家云计算公司做 DCF,把终值增长率从 3% 降到 2%,估值掉了 25%。做的时候你心里想的可能是「它能不能保持 25% 的增速」,可敏感性分析一跑就看出来了,这个估值的大头其实押在「十年之后它还在持续增长」这个假设上。这俩根本不是一个问题啊。
再往下走一步,可以让几个相关的假设一起动。画一张二维表,横轴一个假设,纵轴一个假设,每个格子里填一个估值。然后看你觉得最可能的那几种组合落在哪一片,再看那一片的估值跟市价比起来怎么样。
敏感性分析还有个顺带的好处,它会直接告诉你接下来该研究什么。估值对终值最敏感,就去研究这家公司长期的竞争地位;对利润率最敏感,就去研究它的成本结构和竞争动态。
4. agent 做估值的四个坑
第一个坑是默认讲共识。agent 默认按市场共识来填假设,跑出来的自然就是一份共识估值。可市价本身就是共识啊,拿共识估值去跟市价比,等于循环论证。所以你得把自己的故事带进去,你跟共识不一样的地方,才可能藏着优势,当然也可能藏着错误。
第二个坑是永续增长率照抄默认值。agent 几乎一定会给你填 2% 到 3% 的永续增长率。但你给一家科技公司假设「永远增长」,其实就已经替它回答了一个很大的问题,它的高增长期到底什么时候结束。这个问题 agent 不会主动问你。
第三个坑是折现率上有盲区。agent 算折现率不会犯数学错误,但它可能把一家该按 14% 折现的公司按 10% 折了,因为它没见过的风险,标准公式根本看不见。
第四个坑是只会顺着历史往外推。agent 习惯拿过去的增长率一点点往上或往下调。行业拐点、竞争格局突变这种历史数据里找不到先例的事,它处理不了。
回头看这四个坑,毛病都出在一个地方。agent 分不清哪些是技术参数、哪些是叙事选择,碰到叙事选择也直接当参数填个值,它不知道这一步该停下来问人。所以下面这套流程的思路很直接,讲故事的部分留给人,算的部分交给 agent。
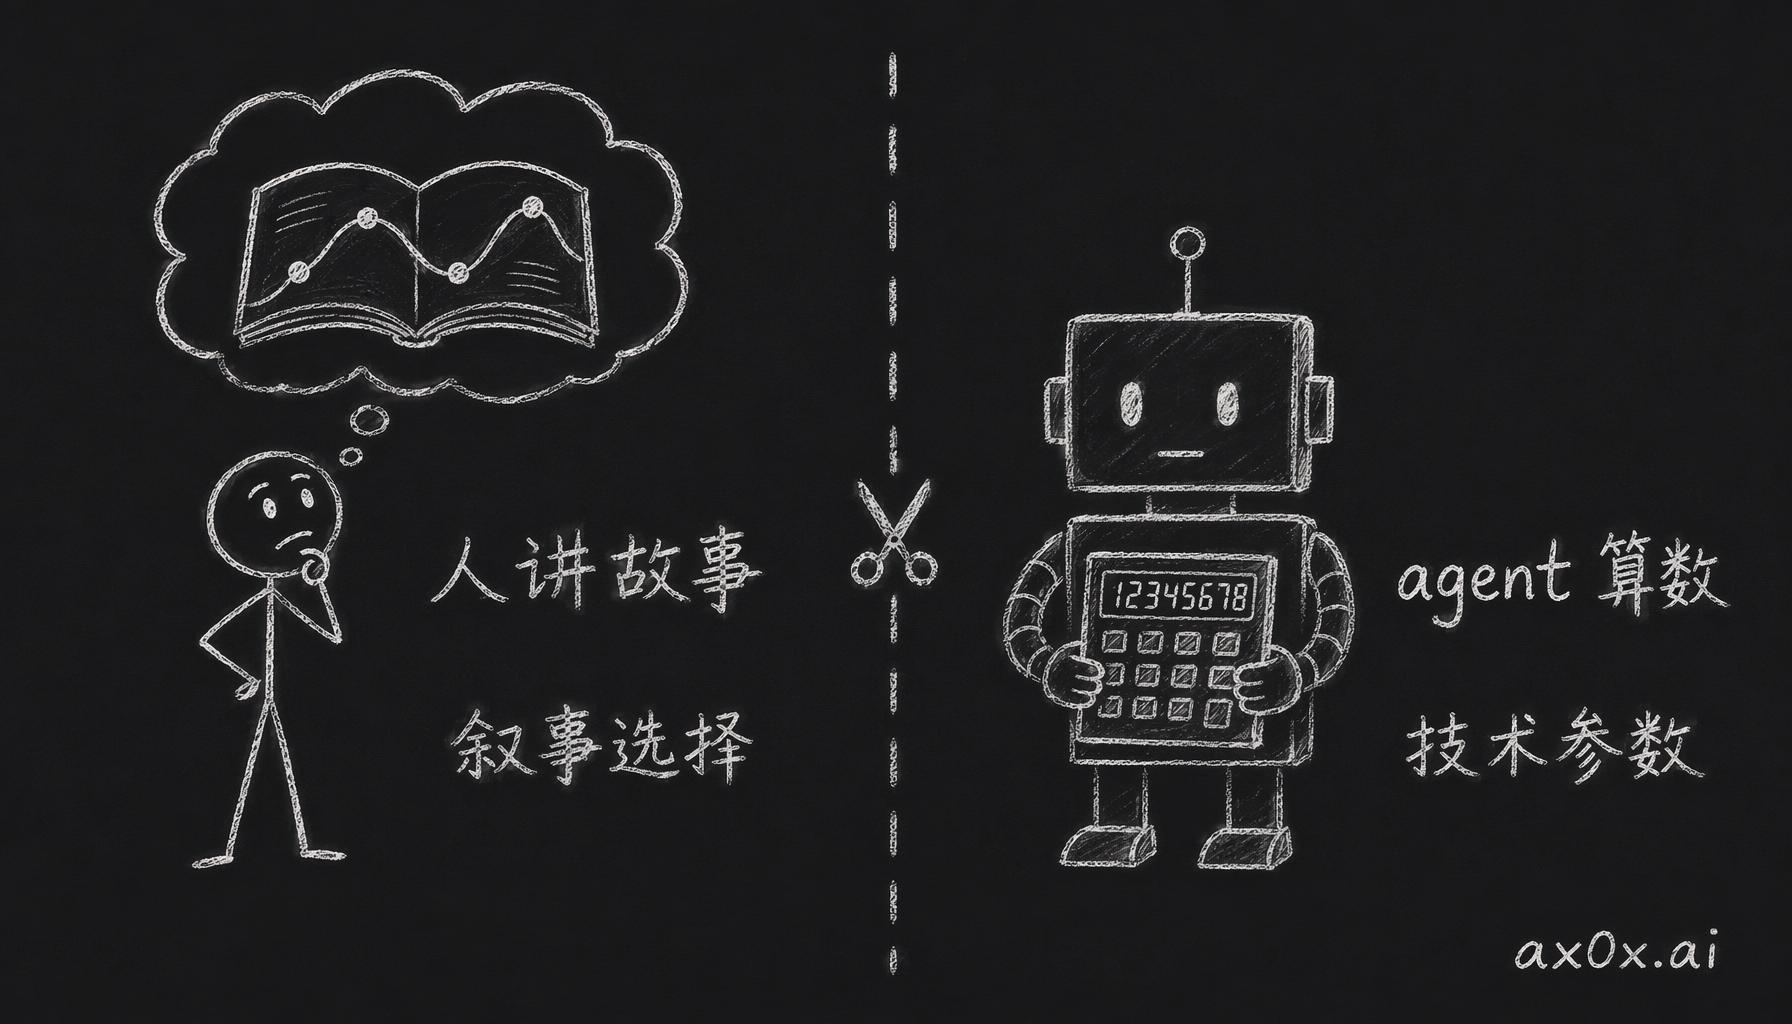 分工的关键在于分清叙事选择和技术参数——讲故事留给人,算数字交给 agent。
流程模板
第一步,写一段故事,讲这家公司将来会怎么样,三到五句就够。第二步,让 agent 按这个故事做 DCF。第三步,一个个审假设,看它们跟故事对不对得上。第四步,让 agent 做双变量敏感性分析。第五步,让 agent 用倍数法再做一个估值当参考。第六步,对比一下 DCF 和倍数法的结果。
Workshop · 改一个假设,看数字动多少
时间:60 到 90 分钟 产出:一份估值工作文档
第一步:选一家公司。用第 4 章 workshop 里分析过的那家就行。
第二步:写故事。三到五句,讲清楚你觉得这家公司未来五年会怎么样,这一步一个数字都不用。
第三步:让 agent 做 DCF 估值。让它把所有核心假设都列出来,每个假设为什么这么选,都得说清楚。
第四步:审假设。你不同意的假设,至少改掉一个,让 agent 重算,然后做双变量敏感性分析。
第五步:在文档里把三个空填上。「估值最敏感的假设是 __________。」「也就是说,我在赌 __________。」「要撑住这个赌注,我需要的证据是 __________。」
你亲手改一个假设,看着估值动了 30%,再看那串数字,感觉就跟以前不一样了。它们看着挺精确,其实每一个都是人选出来的。目标价这个数,agent 随时能给你重算一个。你自己填的那三个空就不一样了,你对哪个假设最敏感,你在赌什么,你还缺什么证据,这些 agent 替你填不了,得你自己来。
第 6 章讲风险:1998 年的 LTCM,所有模型都说安全,它是怎么崩掉的。